Введение
У студии теперь есть честная граница прогнозирования. Улучшит ли небольшая регрессионная модель оценку материалов по сравнению с ранней медианой посещаемости? Вы обучите короткий Pipeline, сравните оба метода на одних и тех же размеченных мастер-классах и сохраните настоящий сравнительный график и будущие прогнозы.
Нужны функции Python, выборка и объединения pandas, основы регрессии и обучения/теста Scikit-learn, начальный Matplotlib. Предыдущая пошаговая лабораторная объясняет семидневный срок и заполнение, обученное только на тренировочных данных. Здесь все файлы подготовлены независимо, включая готовое разделение по ID и дате; файлы предыдущей VM не нужны. Все данные — оригинальный синтетический учебный материал. 60 минут — оценка автора.
Обучить небольшой Pipeline на ранних мастер-классах
На этом шаге вы замените соблазнительную модель с послесобытийными данными повторно используемым семидневным прогнозом.
Начните в WebIDE → Terminal → New Terminal. cd меняет рабочий каталог этого терминала. Подготовленный исполняемый файл ./python запускает окружение курса; ./ выбирает запускатель из этого каталога, а не системный интерпретатор.
cd /home/labex/project/workshop-attendance
cat показывает файлы без изменений; несколько имён в аргументах отображают их последовательно.
cat season.json history.csv labels.csv future.csv
Каждая историческая строка — мастер-класс с ключом session_id. labels.csv связывает actual_attendance по этому ключу, в независимом порядке. Разрешены только числовые признаки booked_7d, снимок ровно за семь дней, и duration_minutes, продолжительность, уже объявленная к этому сроку. Пустые числовые ячейки означают пропуски; у каждого разрешённого признака есть непустое обучающее наблюдение. ID и даты нужны для связи и разделения, не для входа модели. final_bookings и scanned_entries появляются на мероприятии и раскрывают информацию, недоступную семью днями ранее.
Готовое разделение фиксирует обучение 1 апреля 2026 года в 00:00 UTC и резервирует исторические мероприятия с 12 апреля для оценки. Обучающие метки известны к концу дня каждого раннего события; последнее обучающее событие здесь — 8 марта. Первый отложенный прогноз происходит 5 апреля с собственным семидневным снимком мероприятия и уже зафиксированной моделью. Не утверждается, что вход 5 апреля был доступен 1 апреля. Поздние файлы снимков воспроизводят соответствующие поздние даты прогноза. В future.csv нет фактических меток: майские события получают прогнозы, не измеренные ошибки. В настроенном промежутке нет исторических строк. Скользящее переобучение и полностью пустые обучающие признаки не рассматриваются.
cat split.py
Обратите внимание на merge по ключу, разобранные календарные границы и сортировку по дате. Это готовое разделение предыдущего урока, предоставленное здесь для независимости. Сохраните его, все входы CSV/JSON, python, run.py, coursekit.py, show_results.py и файлы starter-*.py. Редактируйте только model.py, chart.py и свои результаты output/. Начальный model.py использует сканирования: идеальные на вид исторические результаты не исправят недопустимый выбор информации.
Pipeline соединяет предобработку и модель. Во время fit заполнитель изучает средние из переданных обучающих признаков, затем регрессия учится на заполненной обучающей матрице. Во время predict тот же заполнитель только преобразует поздние входы. Он никогда не переобучается на отложенных или будущих данных. LinearRegression оценивает свободный член и коэффициенты обычным методом наименьших квадратов; мы сохраняем небольшую модель, а не настраиваем множество вариантов.
Напишите две повторно используемые функции модели. FEATURES — ровно ['booked_7d', 'duration_minutes']. fit_model возвращает обученный оценщик и медиану обучающей цели. predict_events выбирает одинаковые разрешённые признаки для каждой входной таблицы. Заготовка evaluate будет завершена на следующем шаге; этап fit её не вызывает.
Символ оболочки > заменяет файл. <<'PY' начинает here-document в кавычках: вставьте до последней строки только с PY; оболочка сохранит включённый Python буквально. Можно отредактировать model.py в WebIDE Explorer и выбрать File → Save.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
Предпросмотр должен связать W-88 с исходным прогнозом около 32.718, фактической посещаемостью 46 и базой 24.5; для W-09 прогноз около 62.236, факт 74 и та же база. Результат регрессии может быть дробным, хотя фактическое число людей целое.
./python show_results.py fit
Это прогнозы до подсчёта ошибок. Они обучены без поздних меток. Изменение меток должно менять последующие ошибки, но не обученные прогнозы. Признак с изученным нулевым коэффициентом вправе не влиять; произвольное изменение входа не обязательно меняет прогноз.
Сравнить непрерывные ошибки на одной отложенной выборке
На этом шаге вы вычислите абсолютные ошибки из настоящих отложенных меток и сравните средние в людях.
Продолжайте в WebIDE, в /home/labex/project/workshop-attendance. Абсолютная ошибка — модуль actual - predicted. np.abs вычисляет его поэлементно; np.mean усредняет массив результата. Для честной базы вычитайте ту же раннюю целевую медиану из каждой из тех же фактических отложенных меток. Не сравнивайте разные наборы событий и не заменяйте факт прогнозом.
Для всех ошибок и MAE используйте исходные непрерывные прогнозы. Предварительное округление до показываемого числа людей меняет оценку. Вспомогательная программа форматирует консольный MAE до трёх знаков для чтения, но сохраняет неокруглённое число в JSON.
Замените model.py полной версией ниже. Она сохраняет обучение и прогнозирование и завершает пустую ранее evaluate. Функция возвращает массивы ошибок каждого события и их средние; вспомогательная программа сохраняет ID тех же отложенных строк при записи output/holdout.csv. Векторы ошибок следуют позиционному порядку переданных массивов фактов/прогнозов. Эквивалентные массивоподобные значения, включая pandas Series, принимаются в этом порядке; числовые метки индекса Series не являются ID мастер-классов.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
Ожидаемый консольный итог:
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
Для W-88 ошибка модели около 13.282 человека, базовая ошибка 21.5. Для W-09 — около 11.764 и 49.5. Неокруглённые средние — примерно 12.5230751656 и ровно 35.5 человека. База ранней разминки равнялась 18; обучающая медиана полного сезона — 24,5, поскольку используется другая ранняя выборка.
Здесь небольшая модель ошибается меньше на двух отложенных событиях. Это свидетельство о маленькой синтетической выборке, не доказательство будущей надёжности или причинного влияния бронирований. Если правильная модель имеет больший MAE, честный вывод — она не улучшила это сравнение. Оценивание никогда не требует победы над базой; постоянные или неинформативные признаки допустимы.
Подготовить график и будущие прогнозы без меток
На этом шаге вы сделаете отложенное сравнение читаемым и экспортируете будущие оценки без выдуманных фактических результатов.
Продолжайте в WebIDE, в /home/labex/project/workshop-attendance. График должен показывать по одному значению на отложенный ID для каждого ряда Actual, Model и Baseline, используя исходные значения в людях из таблицы сравнения. Подходят линии или точки; подписи и ID объясняют смысл. PNG должен быть читаемым, не меньше 600 на 300 пикселей и воспроизводить тот же видимый график при повторе на тех же данных. Стиль может отличаться. Проверяются действительно нарисованные значения и сохранённое изображение, а не декларация правильности графика. Все предметные точки должны находиться внутри видимых границ осей, обязательные ряды не могут быть скрыты или полностью прозрачны. Точки точно на границе разрешены; цвета и диапазоны могут отличаться.
Бэкенд Matplotlib Agg записывает изображение без окна рабочего стола. subplots создаёт фигуру и оси; plot рисует каждый ряд, связанный с ID. Маркеры ниже различают полые круги фактов, ромбы модели и пунктирные крестики базы даже при совпадении фактов с базой. tight_layout оставляет место для подписей, savefig записывает настоящий PNG, close освобождает фигуру.
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
Сначала потренируйтесь на безвредной опечатке. Следующая команда намеренно использует неверное имя этапа и завершается ошибкой аргумента; сохранённые результаты не меняются.
./python run.py delvier
Сообщение перечисляет допустимые варианты. Исправьте написание и выполните этап выдачи результатов. Если вместо этого файл не найден, используйте pwd и ls, вернитесь начальным cd и попробуйте правильное имя файла.
./python run.py deliver
./python show_results.py deliver
Программа чтения загружает сохранённые CSV/JSON и декодирует настоящий PNG; она никогда не дополняет результаты из входов. В Explorer WebIDE раскройте output и откройте comparison.png. Модель должна быть ниже обеих фактических точек, база остаётся на 24,5. Разные маркеры различают ряды с одинаковыми значениями. Смотрите holdout.csv рядом с изображением, связывая точки с ID и фактическими ошибками.
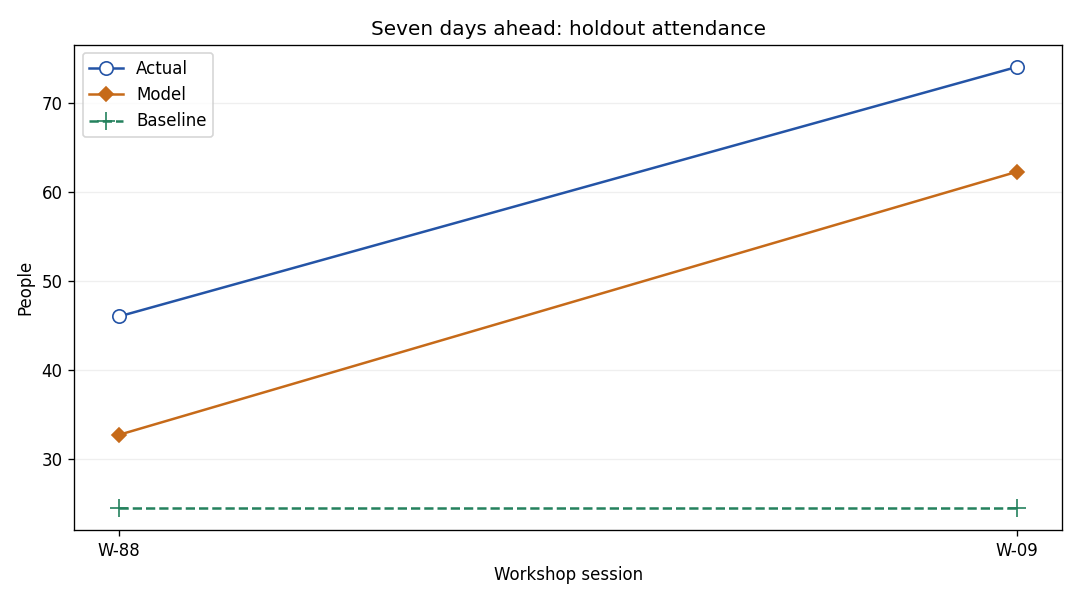
Пример предоставленных данных показывает факты 46 и 74 у W-88 и W-09, прогнозы около 32,718 и 62,236 и пунктирную базу 24,5. Вертикальный разрыв между фактом и прогнозом — абсолютная ошибка события. Стиль может отличаться; ID и исходные значения должны совпадать.
forecast.csv содержит только session_id, исходный model_prediction и display_people. Для F-6 прогноз около 19.119, показано 19; для F-101 около 25.245, показано 25. Только для отображения вспомогательная программа обрезает отрицательные оценки до нуля и округляет половины вверх через floor(max(raw, 0) + 0.5). Это практическое правило представления, не изменение оцениваемой модели. Исходный прогноз сохраняется, даже отрицательный или дробный.
Будущие факты и будущий MAE не создаются. Модель можно зафиксировать до появления позднего снимка: в семидневный срок каждого майского события повторно используйте существующую модель и сохранённые известные признаки этого события. Небольшие синтетические выборки, пропуски снимков и меняющееся поведение ограничивают выводы. Независимое задание изменит сезон и даты, сохранив процесс. Эквивалентные числовые реализации, порядок выходных строк и стили линий/точек принимаются с допуском 1e-8 и правильными связями по ID.
Резюме
Вы обучили небольшой Pipeline заполнения и регрессии на ранних мастер-классах, сравнили исходные отложенные ошибки с обучающей медианной базой и сохранили график с привязкой к ID. Вы также экспортировали будущие оценки, исключив неизвестные результаты из оценки качества. Меньший отложенный MAE может поддержать это ограниченное сравнение; худший результат столь же допустим, если вычислен честно.