



Введение
EARLY CRUMB готовится к субботней выдаче хлеба. Заказы, платежи и отмены записаны отдельно. У двух покупателей одинаковые имена, а один заказ может содержать несколько товаров. Полезный список для передачи начинается с правильного сопоставления записей, а не с догадок по именам.
В этой работе вы подготовите таблицы заказов и платежей, сопоставите каждый ID заказа со статусом оплаты и создадите список оплаченных ID. Отменами займёмся в следующей независимой работе. Достаточно базового знакомства с терминалом: табуляция, поля, сортировка и команды объясняются перед применением. Все люди и записи вымышлены.
Используйте Workstation для команд и Pickup Preview для готового интерфейса выдачи. Предпросмотр показывает исходные записи и образец этикетки. Он не вычисляет ответы и не создаёт ваши файлы.
Подготовьте таблицы для сопоставления
На этом шаге вы подготовите записи без заголовков и отсортированный список ID заказов, сохранив все товарные строки. Начните в Pickup Preview.
Разберитесь в передаче заказа
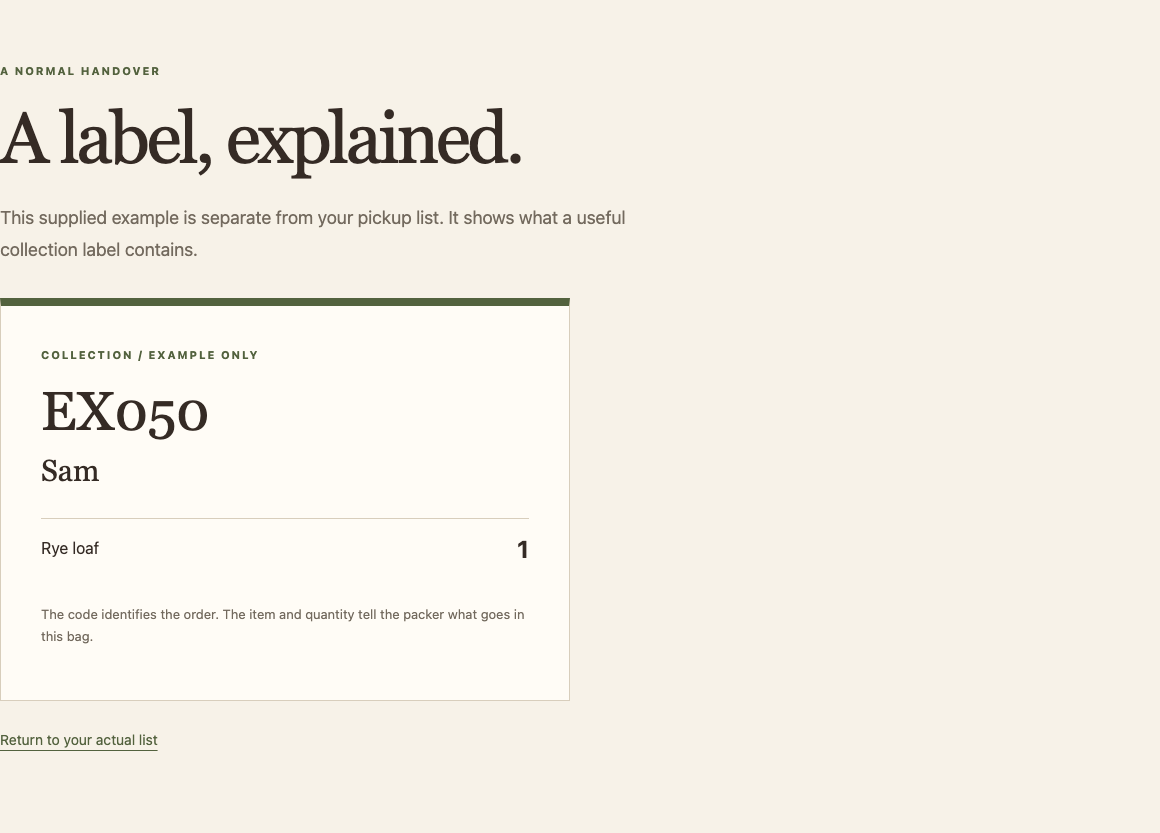
Откройте Sample label. EX050 принадлежит Sam и содержит один ржаной хлеб. Это отдельный пример, а не ваш готовый список выдачи. Код заказа обозначает один пакет; имя помогает покупателю узнать его; товар и количество подсказывают упаковщику, что положить внутрь.
Откройте Records. В справочнике товаров rye означает Rye loaf, а oat — Oat cookie. Найдите P101 в orders.tsv: Alex заказал два ржаных хлеба и одно овсяное печенье. P102 тоже принадлежит Alex, но это другой заказ со статусом unpaid. Сопоставление по имени связало бы пакет с неправильным заказом. Используйте order_id.
Прочитайте подготовленные файлы
Переключитесь в Workstation. Начальный каталог — /home/labex/project/pickup. pwd выводит текущий каталог, а ls перечисляет его содержимое:
pwd
/home/labex/project/pickup
ls
Вы должны увидеть source и work. Исходные записи остаются неизменными; work/ хранит промежуточные файлы, которые можно создавать заново. Путь вроде source/orders.tsv отсчитывается от этого каталога. Если вы вышли из него, вернитесь:
cd /home/labex/project/pickup
cat показывает содержимое файла. Прочитайте обе таблицы:
cat source/orders.tsv
cat source/payments.tsv
TSV означает значения, разделённые табуляцией. Каждая строка — запись, а табуляция разделяет поля. Первая строка содержит заголовки. У заказов четыре поля: ID заказа, покупатель, товар и количество. Один заказ может иметь несколько товарных строк. У платежей два поля: ID заказа и точный статус paid или unpaid. На заказ приходится не более одной платёжной строки. В подготовленном формате внутри значений нет табуляций и переводов строк.
P106 есть в заказах, но платёжной строки для него нет. Отсутствие сведений не означает оплату. При сопоставлении вы оставите это видимым.
Отделите заголовки от записей
tail -n +2 выводит строки начиная со второй. > сохраняет вывод в файл, заменяя назначение, если оно уже существует. Источник при этом не меняется. Никогда не указывайте один и тот же путь как источник и назначение с >: оболочка опустошит файл до того, как программа его прочитает.
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
Посмотрите товарные строки:
cat work/orders.rows
P101 и P105 встречаются по два раза, потому что содержат по два товара. Сохраните эти строки. Повторение ID заказа само по себе не означает дублирование данных.
Подготовьте ключи сопоставления
Ключ — поле для связи записей. cut -f1 выбирает первое поле, разделённое табуляцией. Канал | передаёт вывод следующей команде. sort -u сортирует строки и оставляет каждую одинаковую строку один раз. Здесь мы применяем его только к списку ID, а не к таблице товаров.
Сортировка и сопоставление должны использовать одинаковый порядок. LC_ALL=C задаёт предсказуемый побайтовый порядок, а export передаёт настройку следующим командам. Настройка действует в этом терминале; в новом задайте её снова.
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
В таблице платежей с двумя полями сортируйте по первому, сохраняя статус. TAB — переменная оболочки с одной табуляцией: printf '\t' выводит её, а $(...) захватывает вывод. Двойные кавычки в "$TAB" передают её как один аргумент-разделитель. -t задаёт разделитель полей, -k1,1 выбирает только первое поле как ключ сортировки.
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
Ожидаются P101–P105 по порядку, каждый с исходным статусом. Платёжной строки для P106 не появилось. Теперь готовы шесть разных ID заказов и все пять платёжных записей. Если заголовок или статус неправильны, заново создайте затронутый рабочий файл из источника; не подгоняйте источник под результат.
Сопоставьте каждый заказ со статусом оплаты
На этом шаге вы соедините два подготовленных входа, сохранив видимыми заказы без платежей. Начните в Workstation, в том же терминале, что на шаге 1.
Поймите смысл сопоставления
P101 должен получить paid, P102 — unpaid, а P106 — явное значение missing. Имена в сопоставлении не участвуют. Пока оплаченный заказ всё ещё может быть отменён: одного сопоставления платежей недостаточно для итогового списка выдачи.
join по умолчанию соединяет отсортированные входы по первому полю. Обычное внутреннее соединение пропускает ID без пары. Здесь нужно видеть и отсутствующие записи:
-t "$TAB"использует табуляцию, созданную на шаге 1.-a 1также включает записи первого входа без пары — из полного списка ID заказов.-e missingподставляет словоmissing, если поле вывода недоступно.-o 1.1,2.2выводит поле 1 входа 1 (ID заказа), затем поле 2 входа 2 (статус).1и2обозначают входные файлы, а не номера строк.
Выполните всю команду одной строкой. Она запишет результат из двух полей:
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
Промежутки выше обозначают табуляции, а не буквальные символы обратной косой черты и t. Должно быть шесть строк. P106 остался, потому что левый вход содержит все ID заказов, а -a 1 сохраняет ID без пары.
Прочитайте результат до фильтрации
P101 и P102 в источнике принадлежат Alex, но их статусы различаются. P103 тоже оплачен; позже отмена может исключить его. Для P106 нет платежа, поэтому missing не даёт ему незаметно исчезнуть из сравнения.
Если join сообщает, что вход не отсортирован, вернитесь к шагу 1 и заново создайте оба отсортированных входа с одинаковой настройкой LC_ALL=C. Не скрывайте предупреждение и не удаляйте неудобный заказ. Если подключились к терминалу заново, перед повтором восстановите каталог и обе настройки оболочки из шага 1.
Успешного завершения команды недостаточно: сравните эти три важные строки с исходными записями. Теперь у вас полное сопоставление платежей для следующего решения.
Выберите оплаченные заказы, сохранив их идентичность
На этом шаге вы создадите файл ID оплаченных заказов и увидите именно сохранённые данные. Начните в Workstation.
Сопоставляйте полный статус
И paid, и unpaid содержат буквы paid. Неточный текстовый поиск ошибочно включил бы P102. Нужны табуляция и полный статус в конце строки.
grep выбирает подходящие строки. В выражении $'\tpaid$' внешняя форма $'...' превращает \t в символ табуляции, а последний $ внутри выражения означает конец строки. Поэтому поле статуса должно быть ровно paid, а не концом unpaid. Затем cut -f1 оставляет только ID заказов. Вывод уже отсортирован, поскольку отсортирована исходная таблица сопоставления.
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 не оплачен, а у P106 платёж отсутствует, поэтому им здесь не место. Пока сохраните P103: файл представляет оплаченные заказы, а не окончательный набор для упаковки. Удаление до рассмотрения отмен смешало бы два решения и сделало промежуточный результат вводящим в заблуждение.
Прочитайте сохранённую выборку
Переключитесь в Pickup Preview. Выберите Payment IDs в навигации. Эта страница показывает paid-order-ids.txt, а не вычисляет ответ по платежам. Вы должны увидеть четыре только что сохранённых ID. Перейдите по Compare with source records и проверьте соответствующие платёжные строки.
В Pickup list готового предпросмотра всё ещё может быть сообщение об отсутствии списка для упаковки. Это ожидаемо: вы создали выборку платежей, а не итоговый список товаров. Следующая независимая работа использует эту выборку, чтобы исключить отмены и сохранить количество каждого подходящего товара.
Если файл пуст или содержит P102, проверьте work/payment-match.tsv и точный шаблон статуса, затем повторите фильтрацию. Этот результат можно исправить и пересоздать без изменения исходных записей.
Резюме
Вы подготовили записи с табуляцией, отсортировали их по общему ключу, соединили платежи с сохранением отсутствующих записей и выбрали точный статус оплаты. Вы отделили идентичность заказа от имени покупателя и товарных строк. Следующая независимая работа превратит эту выборку платежей в полезный список выдачи.


