Введение
Системе мониторинга работоспособности команды поддержки нужны два способа запускать одну и ту же небольшую проверку: после запроса пользователя и периодически, без запроса пользователя. Вы реализуете оба варианта, различите подтверждение приёма от завершения операции, проверите время жизни событий локально и проследите за реальным запланированным облачным вызовом.
Эта независимая виртуальная машина запускается в каталоге /home/labex/project/task-monitor. В ней установлены Node.js 22.22.0, локальная версия Wrangler 4.131.1, Miniflare 4.20260730.0 для изолированной проверки и синтетическая внутренняя фиктивная служба проверки работоспособности. Вы повторно используете ранее изученные навыки работы с привязками служб и авторизацией устройства; предыдущая виртуальная машина или ресурс не нужны. Используйте собственную учебную учётную запись. Домен, продукт хранения данных или платное расширение не требуются. Запросы и запланированные вызовы учитываются в обычном использовании учётной записи.
Оставьте один терминал открытым. Короткий интервал в одну минуту предназначен для одноразового тестирования. Перед завершением остановите потоки журналов, удалите оба Worker с действующей авторизацией, убедитесь, что они отсутствуют, и выполните выход из системы. Фоновая работа здесь ограничена по времени и не является устойчивой; не используйте этот механизм как обещание надёжной доставки через очередь.
Возврат до завершения фоновой работы
На этом шаге общедоступная конечная точка подтвердит получение небольшого запроса на проверку работоспособности, а предоставленная внутренняя служба выполнит асинхронную работу. Это независимая виртуальная машина; служба является новой фиктивной службой, а не ресурсом из предыдущей лабораторной работы.
cd /home/labex/project/task-monitor
node --version
npx wrangler --version
cat health/index.js
Фиктивная служба ждёт 250 миллисекунд и возвращает синтетический JSON. Она не выполняет внешние запросы и не сохраняет данные. Сгенерируйте уникальное базовое имя, затем настройте общедоступный Worker и его внутреннюю службу HEALTH. Это стандартные привязки служб, которые вы уже использовали ранее.
WORKER_NAME="labex-tasks-$(openssl rand -hex 6)"
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": []
  }
}
CONFIG
cat > health/wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME-health",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
CONFIG
cat > src/index.js <<'JS'
async function checkHealth(env, details) {
  const url = new URL('https://health.internal/health');
  url.searchParams.set('probe', details.probe);
  const response = await env.HEALTH.fetch(url, {signal: AbortSignal.timeout(3000)});
  if (!response.ok) throw new Error('health_service_unavailable');
  const data = await response.json();
  if (data.status !== 'ok' || data.service !== 'labex-health-fixture' || data.probe !== details.probe) {
    throw new Error('unexpected_health_response');
  }
  console.log(JSON.stringify({event: 'health_check', ...details, status: data.status, service: data.service}));
}

export default {
  async fetch(request, env, ctx) {
    const url = new URL(request.url);
    if (url.pathname === '/health' && request.method === 'GET') {
      return Response.json({status: 'ok'}, {headers: {'Cache-Control': 'no-store'}});
    }
    if (url.pathname !== '/checks') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'POST') {
      return Response.json({error: 'method_not_allowed'}, {status: 405, headers: {Allow: 'POST'}});
    }
    const probe = url.searchParams.get('probe') || '';
    if (!/^[a-z0-9-]{1,48}$/.test(probe)) {
      return Response.json({error: 'invalid_probe'}, {status: 400});
    }
    ctx.waitUntil(checkHealth(env, {source: 'request', probe}).catch(() => {
      console.error(JSON.stringify({event: 'health_check_failed', source: 'request', probe}));
    }));
    return Response.json({accepted: true, probe}, {status: 202, headers: {'Cache-Control': 'no-store'}});
  }
};
JS
checkHealth проверяет фактический ответ зависимости и выводит небольшой структурированный результат. Сигнал прерывания через три секунды ограничивает продолжительность запроса. Общедоступный обработчик передаёт промис в ctx.waitUntil и сразу возвращает HTTP 202. Код 202 подтверждает приём этой краткоживущей попытки, но не обещает устойчивую доставку. Обработчик catch записывает ошибку, не выводя необработанные исключения, запросы или учётные данные. Используйте только показанные здесь синтетические значения probe.
npx wrangler dev -c wrangler.jsonc -c health/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
Дождитесь приглашения командной строки, затем просмотрите журнал. Продолжайте, когда общедоступный сервер разработки будет готов на порту 8080. Если запуск ещё продолжается, немного подождите и снова прочитайте журнал.
cat dev.log
curl -i http://127.0.0.1:8080/health
curl -i -X POST "http://127.0.0.1:8080/checks?probe=manual-one"
cat dev.log
Маршрут проверки работоспособности, выполняемый на переднем плане, возвращает 200 и статус ok. Запрос POST возвращает 202 с полями accepted true и probe manual-one. После завершения работы зависимости в журнале появляются event health_check, source request, то же значение probe и status ok. Если вы прочитали журнал слишком быстро, через некоторое время прочитайте его снова. То, что ответ пришёл раньше последующей записи в журнале, является наблюдением, а не точным тестом производительности.
Выполните проверку, пока сервер работает. Изолированная среда выполнения удерживает собственную фиктивную службу проверки работоспособности за контролируемым шлюзом, требует получить ответ переднего плана до открытия этого шлюза, а затем ожидает завершения фоновой работы. Она также проверяет общедоступный маршрут проверки работоспособности и случаи отклонения метода или значения probe. Этот тест не обращается к Cloudflare.
Локальный вызов обработчика по расписанию
На этом шаге повторно используйте операцию проверки работоспособности из обработчика, вызываемого Cron Trigger. Перед изменением кода просмотрите и остановите фактически запущенное задание разработки. Если номер задания отличается от примера, подставьте текущий номер.
jobs
kill %1
cat > src/index.js <<'JS'
async function checkHealth(env, details) {
  const url = new URL('https://health.internal/health');
  url.searchParams.set('probe', details.probe);
  const response = await env.HEALTH.fetch(url, {signal: AbortSignal.timeout(3000)});
  if (!response.ok) throw new Error('health_service_unavailable');
  const data = await response.json();
  if (data.status !== 'ok' || data.service !== 'labex-health-fixture' || data.probe !== details.probe) {
    throw new Error('unexpected_health_response');
  }
  console.log(JSON.stringify({event: 'health_check', ...details, status: data.status, service: data.service}));
}

export default {
  async fetch(request, env, ctx) {
    const url = new URL(request.url);
    if (url.pathname === '/health' && request.method === 'GET') {
      return Response.json({status: 'ok'}, {headers: {'Cache-Control': 'no-store'}});
    }
    if (url.pathname !== '/checks') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'POST') {
      return Response.json({error: 'method_not_allowed'}, {status: 405, headers: {Allow: 'POST'}});
    }
    const probe = url.searchParams.get('probe') || '';
    if (!/^[a-z0-9-]{1,48}$/.test(probe)) {
      return Response.json({error: 'invalid_probe'}, {status: 400});
    }
    ctx.waitUntil(checkHealth(env, {source: 'request', probe}).catch(() => {
      console.error(JSON.stringify({event: 'health_check_failed', source: 'request', probe}));
    }));
    return Response.json({accepted: true, probe}, {status: 202, headers: {'Cache-Control': 'no-store'}});
  },
  async scheduled(controller, env) {
    await checkHealth(env, {
      source: 'scheduled',
      probe: `cron-${controller.scheduledTime}`,
      cron: controller.cron,
      scheduledTime: controller.scheduledTime
    });
  }
};
JS
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": [
      "* * * * *"
    ]
  }
}
CONFIG
Пятизначное выражение * * * * * означает запуск каждую минуту по UTC. Такой частый интервал намеренно используется только для короткого одноразового эксперимента. scheduled ожидает завершения операции проверки работоспособности, поэтому результат вызова отражает завершение операции; HTTP-ответ он не возвращает. В журнале записываются фактическое выражение cron и запланированное время запуска.
npx wrangler dev -c wrangler.jsonc -c health/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
Дождитесь приглашения командной строки, затем просмотрите журнал. Продолжайте, когда общедоступный сервер разработки будет готов на порту 8080. Если запуск ещё продолжается, немного подождите и снова прочитайте журнал.
cat dev.log
curl -i "http://127.0.0.1:8080/cdn-cgi/local/scheduled?cron=*+*+*+*+*&time=1700000000000&format=json"
cat dev.log
Локальный триггер должен вернуть результат выполнения ok, а в журнале приложения должны появиться source scheduled, cron * * * * * и scheduledTime 1700000000000. Это старое время является намеренно заданным синтетическим тестовым значением, а не свидетельством текущего облачного запуска. Выполните проверку, чтобы использовать другое контролируемое запланированное время и подтвердить вызов службы проверки работоспособности.
Для HTTP-вызовов waitUntil может продолжать работу не более 30 секунд после отправки ответа или отключения клиента. Это ограничение общее для фоновых промисов запроса. waitUntil не является устойчивой очередью и не гарантирует повторную попытку. Небольшая операция этой лабораторной работы с ограничением в три секунды подходит для такого сценария. Для работы, требующей надёжной доставки или повторных попыток, нужна подходящая архитектура очереди или рабочего процесса за пределами этой лабораторной работы. См. документацию по Context API и обработчику scheduled, где описаны разные сроки жизни вызовов.
Развёртывание и наблюдение за фоновой работой запроса
На этом шаге разверните оба новых Worker в собственной учебной учётной записи. Остановите фактически запущенное локальное задание и авторизуйте эту новую виртуальную машину с помощью знакомого процесса авторизации устройства.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Откройте показанную ссылку устройства в браузере, где выполнен вход, введите код, просмотрите запрошенные разрешения и выберите учебную учётную запись. Дождитесь сообщения об успешном завершении в терминале.
npx wrangler whoami --json
Подтвердите имя учётной записи, даже если в списке указана только одна учётная запись. Замените YOUR_ACCOUNT_ID в обеих конфигурациях ниже её фактическим идентификатором. Сохраните сгенерированные имена Worker и интервал в одну минуту. Для общедоступного Worker также включаются Workers Logs, поэтому его журналы вызовов и приложения доступны в разделе Observability панели управления. Это отдельный механизм, не связанный с активным соединением wrangler tail. Эта одноразовая лабораторная работа выводит только синтетические данные проверки работоспособности; никогда не записывайте в журнал учётные данные. См. документацию по Workers Logs.
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": [
      "* * * * *"
    ]
  },
  "observability": {
    "enabled": true
  },
  "account_id": "YOUR_ACCOUNT_ID"
}
CONFIG
cat > health/wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME-health",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false,
  "account_id": "YOUR_ACCOUNT_ID"
}
CONFIG
npx wrangler deploy -c health/wrangler.jsonc
npx wrangler deploy
Сначала разворачивается внутренняя служба проверки работоспособности, чтобы привязка общедоступного Worker могла разрешить её имя. Убедитесь, что в выводе развёртывания общедоступного Worker указано расписание: * * * * *. Скопируйте его фактический адрес workers.dev ниже.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
curl -i "$APP_URL/health"
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
Подождите несколько секунд, пока соединение tail инициализируется, затем отправьте одну синтетическую проверку.
sleep 5
curl -i -X POST "$APP_URL/checks?probe=remote-one"
cat events.log
Найдите событие POST и связанную с ним запись health_check, содержащую source request и probe remote-one. Если событие пока не отображается, проверьте tail-errors.log, немного подождите, отправьте запрос ещё раз и снова прочитайте events.log. Файл журнала от предыдущей лабораторной работы не является доказательством для этого развёртывания.
В панели управления откройте для этой учётной записи раздел Compute → Workers & Pages. Подтвердите оба точных имени, адрес общедоступного Worker и его привязку HEALTH к соответствующей внутренней службе. Выполните проверку: она подтверждает владение и метаданные конечной точки и привязки, затем открывает собственный короткий активный поток tail и отправляет новую проверку, чтобы подтвердить завершение фоновой работы. Проверяющая система не считает ваш events.log доказательством. Оставьте запущенное задание tail для следующего шага.
Наблюдение за реальным запуском Cron
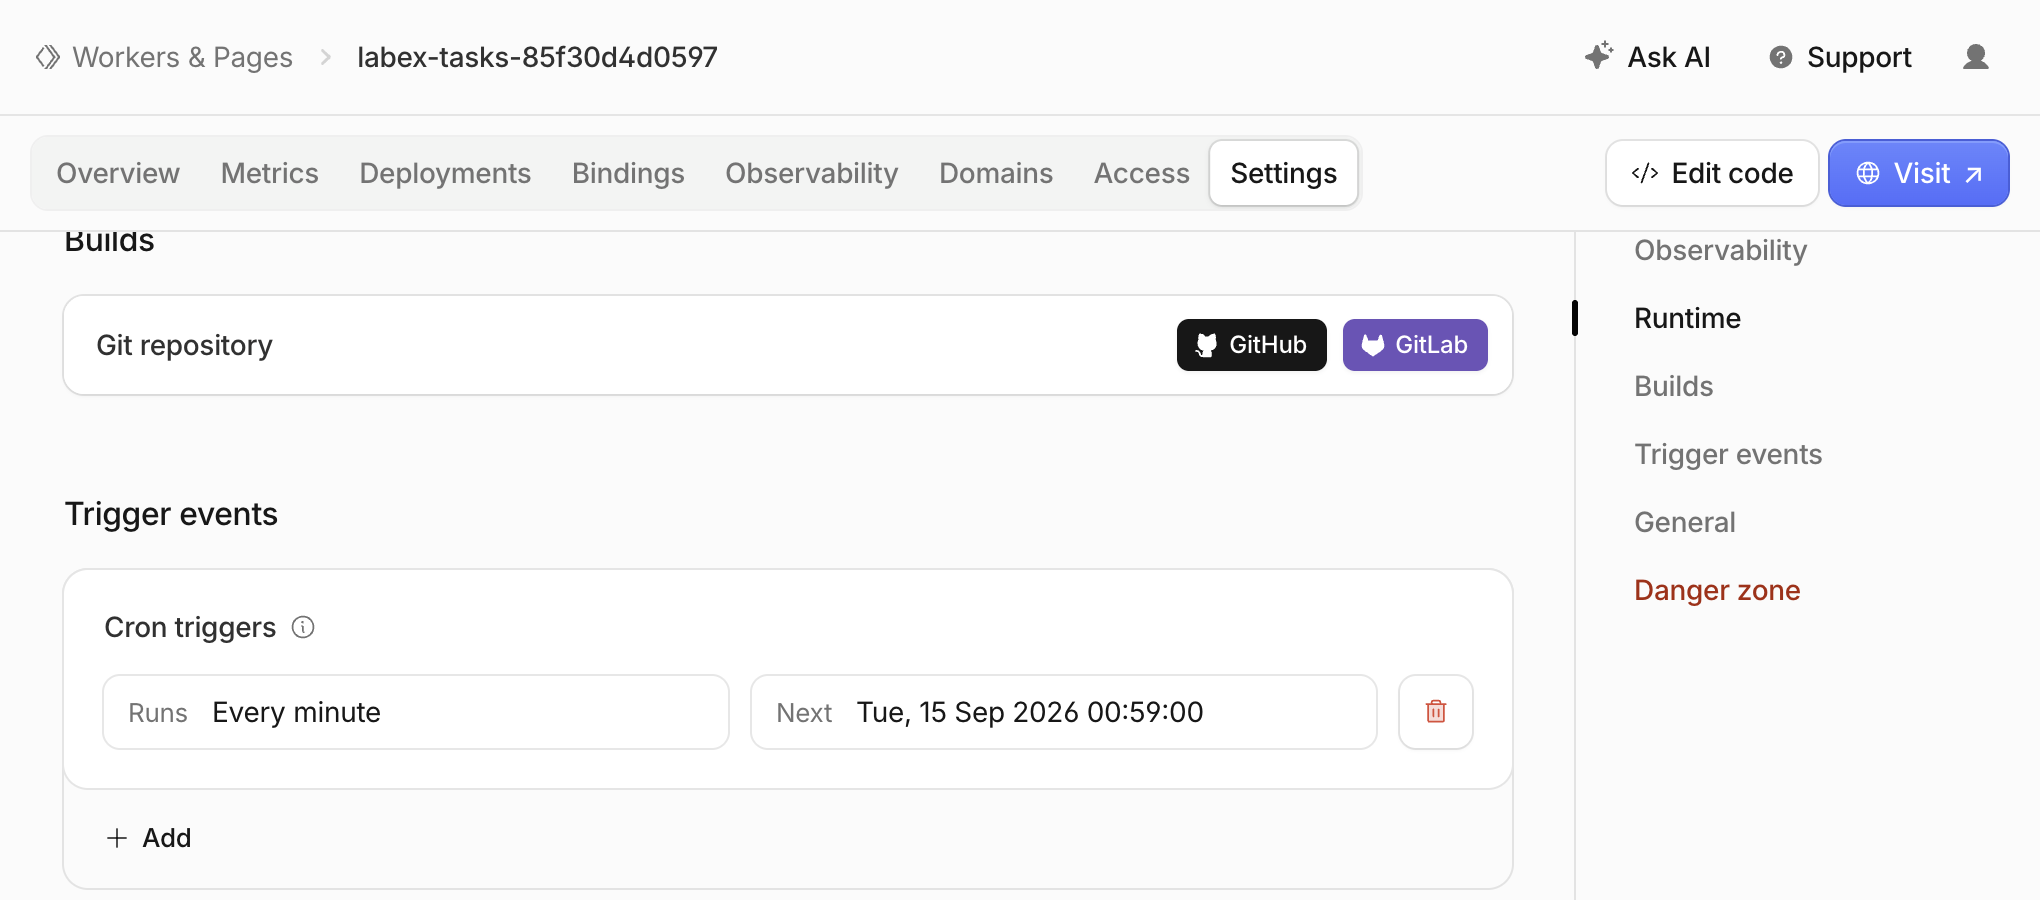
На этом шаге отделите конфигурацию развёртывания от факта выполнения. Откройте общедоступный Worker в панели управления и перейдите в Settings → Trigger events → Cron triggers. Убедитесь, что расписание отображается как Every minute. Значение Next time является прогнозом, а не подтверждённым выполнением. Одной настроенной конфигурации недостаточно, чтобы доказать запуск обработчика.
В примере ниже показан минимальный поддерживаемый интервал: * * * * *, то есть один раз в минуту. Сравните имя Worker с собственной конфигурацией. Имя и отображаемое время являются примерами; не добавляйте ещё один триггер в панели управления, если Wrangler уже настроил его.
Оставьте существующее соединение tail запущенным. Дождитесь реального запланированного события и просмотрите тот же файл журнала:
sleep 60
cat events.log
Найдите успешный запланированный вызов в читаемом выводе tail. Его можно определить по выражению cron и времени выполнения. В его записи health_check должны присутствовать source scheduled, cron * * * * *, status ok, service labex-health-fixture и scheduledTime. Значение probe начинается с cron-, за которым следует это scheduledTime. Независимая проверка отдельно сопоставляет структурированные метаданные события Cloudflare с журналом приложения. Событие POST, локальная синтетическая временная отметка или пустой журнал не подтверждают этот результат.
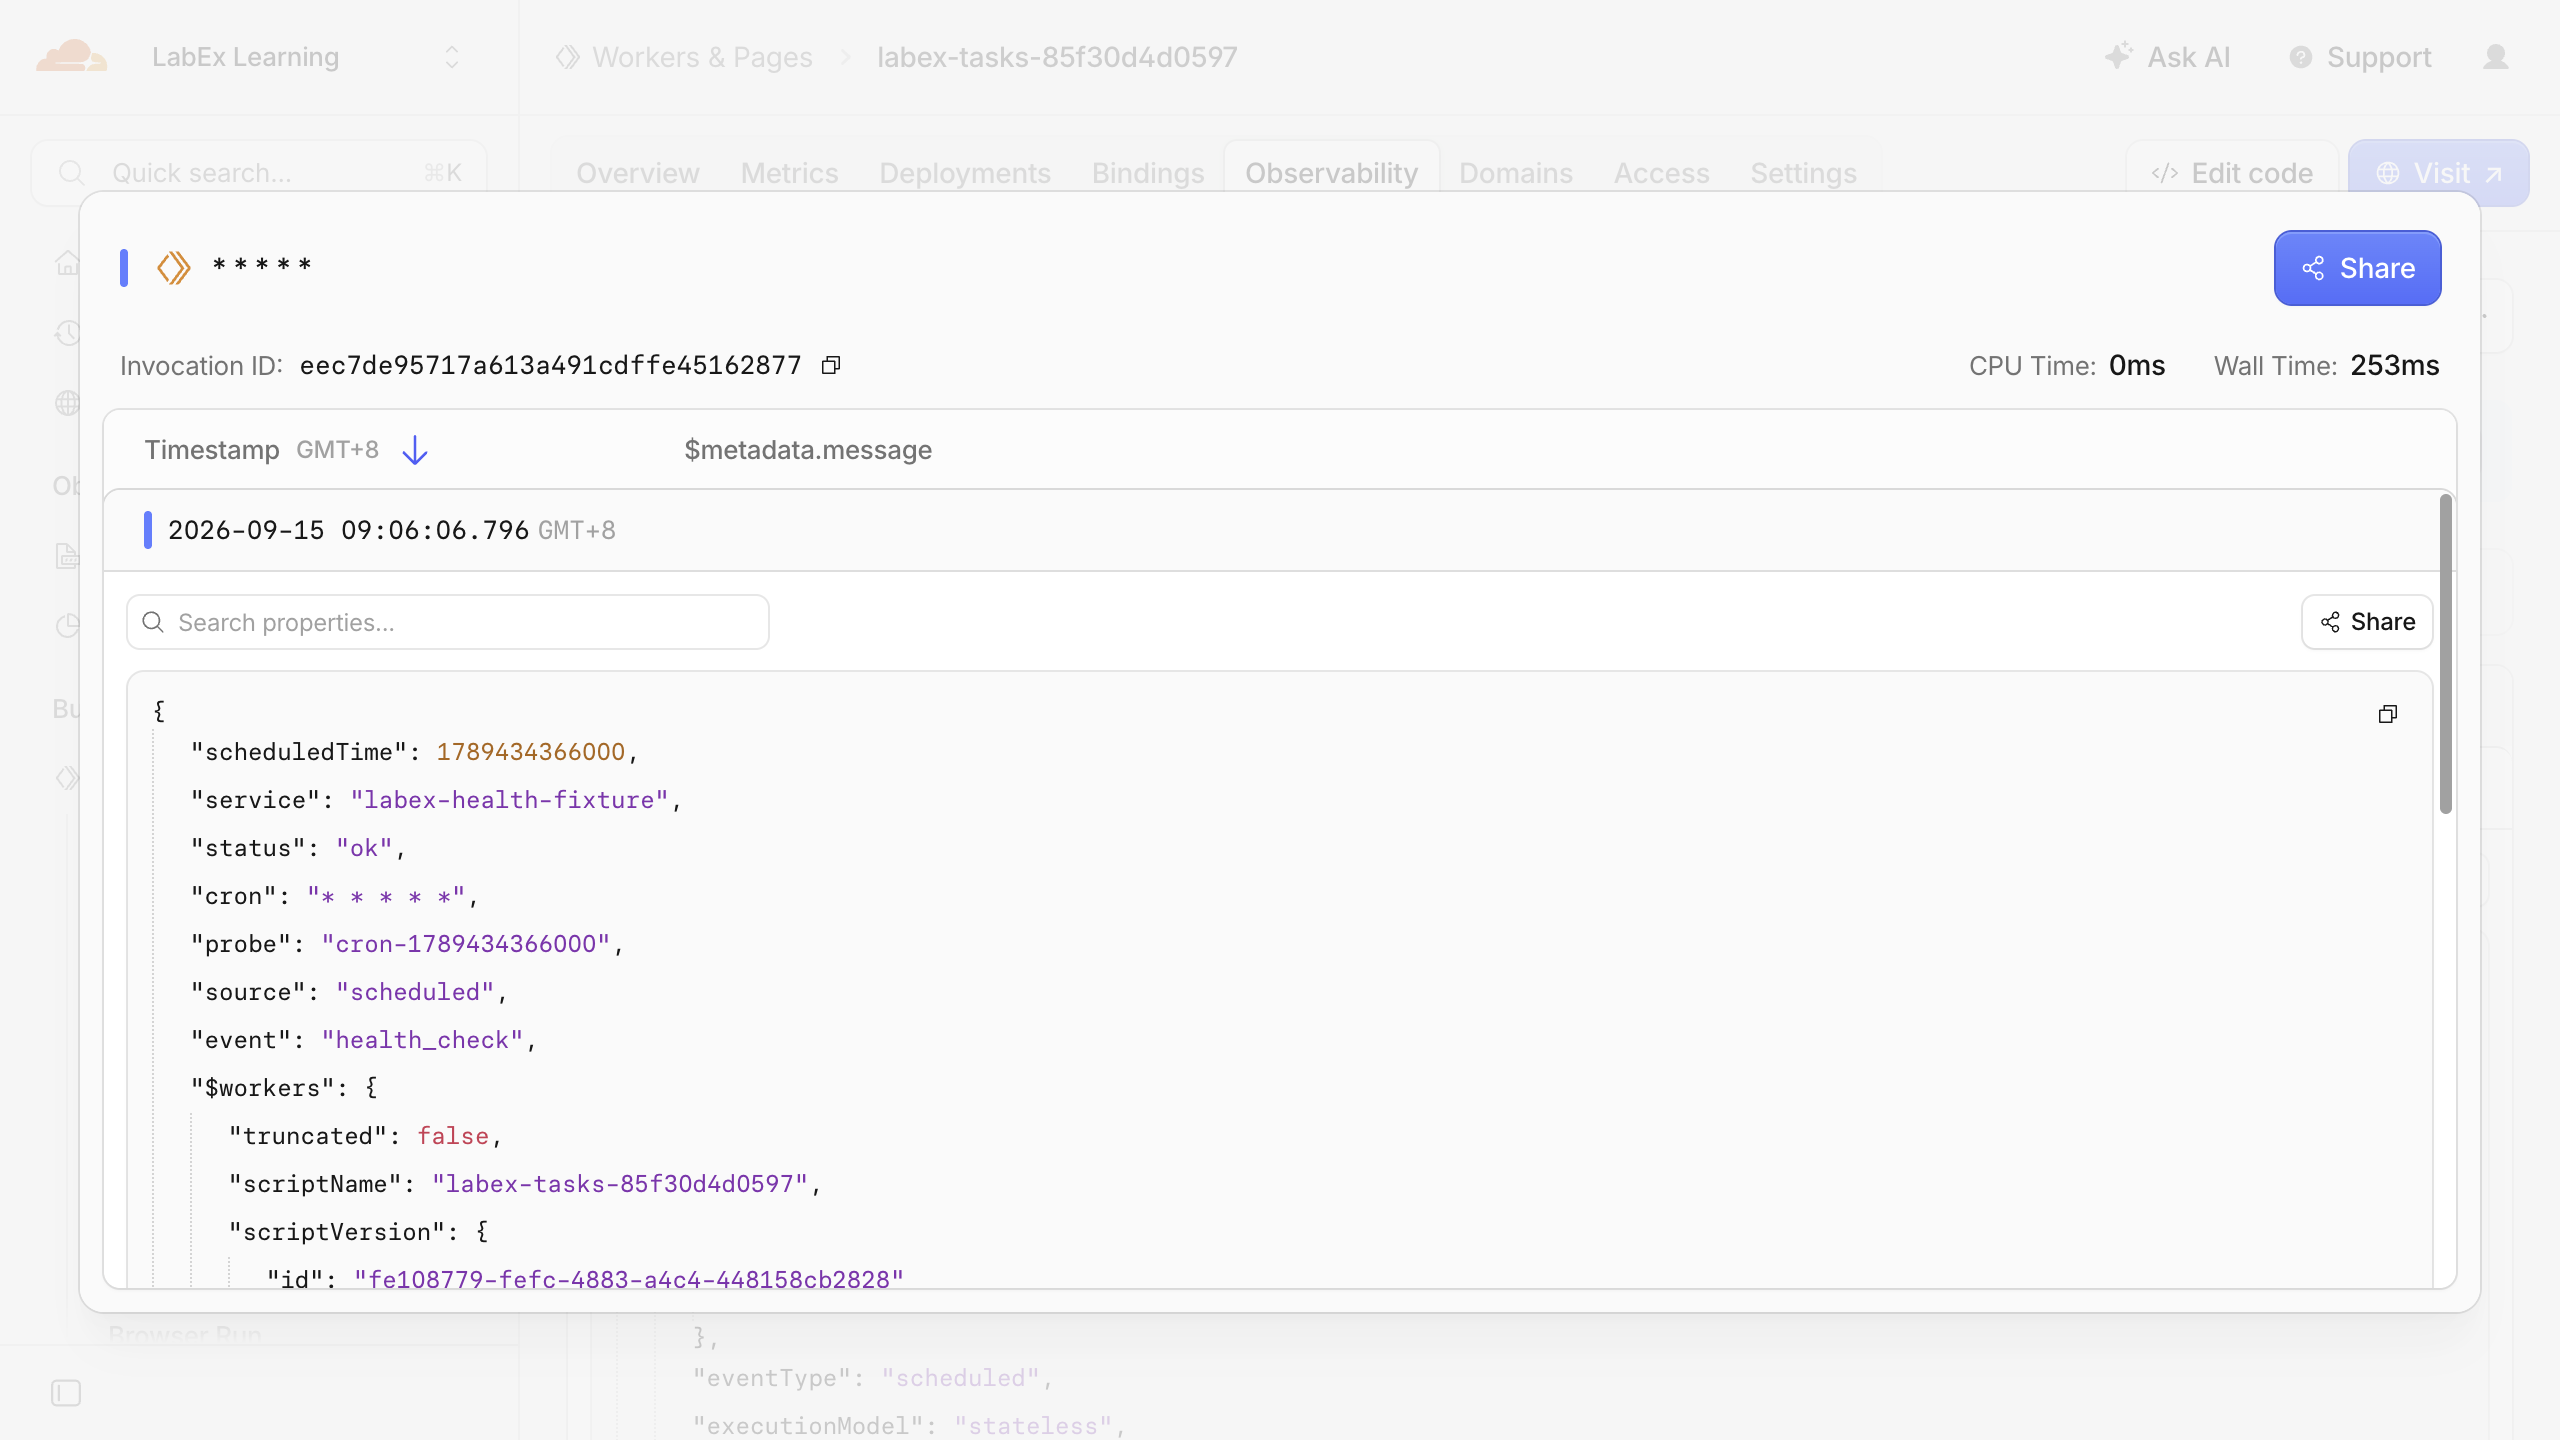
Чтобы связать этот вывод с браузером, откройте страницу Observability → Events того же Worker. Ожидая событие, используйте Live либо обновите сохранённый запрос событий, указав диапазон времени, включающий ваше развёртывание. В строках вызовов этого обработчика отображается * * * * *. Разверните одну строку, выберите View invocation, затем разверните связанную строку журнала приложения и просмотрите поля проверки работоспособности. В структурированном журнале приложения ячейка Message может быть пустой; разверните строку, а не считайте данные отсутствующими. Во время чтения можно приостановить отображение событий в реальном времени.
В этом реальном примере source имеет значение scheduled, status — ok, а service — labex-health-fixture. Значение probe в формате cron-... соответствует scheduledTime в журнале приложения, указанному в миллисекундах. Панель управления отображает видимую временную отметку в выбранном часовом поясе (здесь GMT+8), а расписание Cron использует UTC. Ваши имя, идентификатор вызова и время будут другими. Читайте эти поля вместе с результатом вызова; сам снимок экрана не является доказательством завершения.
Изменения Cron могут распространяться до 15 минут. Повторяйте ожидание в одну минуту и проверку, отсчитывая не более 17 минут с момента успешного развёртывания. Если поток пуст или остановился, проверьте tail-errors.log. Если за это время подходящее событие не появилось, остановитесь и проверьте конфигурацию, авторизацию и состояние триггера; не сообщайте об успехе. Это ограниченное учебное наблюдение, а не гарантия точной задержки выполнения. В документации Cron Triggers описаны распространение изменений и расписание по UTC. Сохранённые Workers Logs также могут появиться с небольшой задержкой; после ожидания приёма данных обновите запрос. Отдельная история Past Cron Events для нового Worker может отображать события до 30 минут. Пустая история не доказывает сбой; используйте описанное выше наблюдение в реальном времени в пределах ограничения этой лабораторной работы.
После наблюдения за выполнением выполните проверку. Она проверяет развёрнутое расписание и в течение 70 секунд отслеживает отдельный активный поток в поисках фактического запланированного события с результатом проверки работоспособности. Это охватывает полную минуту после установления соединения. Отсутствие события не даёт окончательного результата, поэтому проверьте состояние соединения и распространения изменений и повторите попытку в пределах того же интервала наблюдения. Проверяющая система не создаёт запланированное событие искусственно. Останавливайте собственное задание tail только после успешной проверки; используйте фактический номер задания.
jobs
kill %1
Своевременно завершите одноразовое расписание, выполнив следующий шаг. Не оставляйте учебное задание с интервалом в одну минуту запущенным без присмотра.
Удаление обоих Worker для тестирования расписания
На этом шаге удалите общедоступный Worker и его триггер, а затем внутреннюю фиктивную службу проверки работоспособности, сохраняя действующую авторизацию. Убедитесь, что обе конфигурации содержат точные имена из этой лабораторной работы и нужную учётную запись.
cat wrangler.jsonc
cat health/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c health/wrangler.jsonc
В каждом запросе подтверждения для соответствующего имени нажмите одну клавишу y. Не затрагивайте другие проекты, учётную запись и её субдомен. Закреплённая версия Wrangler может после удаления Worker вывести известное диагностическое сообщение об аутентификации при очистке устаревшего KV; ни это сообщение, ни неудачный сетевой запрос не доказывают удаление. Не расширяйте разрешения ради этой диагностики.
Обновите панель управления и выполните проверку. Успешная авторизованная инвентаризация Worker должна показать отсутствие обоих имён. Это подтверждает удаление развёрнутых ресурсов, но не мгновенное глобальное распространение каждого изменения планировщика. Один лишь выход из системы или закрытие виртуальной машины не выполняет эту очистку.
Отключение виртуальной машины лаборатории
На этом шаге перед отключением виртуальной машины убедитесь, что задание tail остановлено, а ресурсы удалены.
jobs
npx wrangler logout
npx wrangler whoami --json
Требуется явное значение loggedIn: false. Структурированная команда без авторизации может завершиться с ненулевым кодом; сетевая ошибка не является тем же результатом. Выполните проверку и завершите работу виртуальной машины. Вход в браузере можно оставить активным для последующих независимых лабораторных работ.
Итоги
Вы использовали waitUntil, чтобы ограниченная по времени проверка работоспособности завершилась после подтверждения операции на переднем плане, а затем повторно использовали эту операцию из обработчика по расписанию. Контролируемые локальные тесты разделили ответ и отложенную работу, а реальное облачное событие после развёртывания подтвердило выполнение по расписанию. Конфигурация, ручной вызов и наблюдение в реальном времени дали разные виды доказательств.
Вы проверили владение и привязки служб, сопоставили синтетические значения probe со структурированными журналами, учли ограничения времени жизни вызова и удалили одноразовое приложение с расписанием перед отключением. Для надёжной длительной доставки нужна архитектура, отличающаяся от этого кратковременного шаблона фоновой работы.