Introdução
A Northline Library ajuda leitores a descobrir livros, consultar disponibilidade e pré-visualizar uma reserva. Sua página inicial pode parecer saudável enquanto um leitor não consegue pesquisar. Sua tarefa é monitorar esse resultado do cliente e avisar a equipe somente quando a falha persistir.
Basta familiaridade básica com o terminal. Biblioteca, Prometheus (amostras e regras), Blackbox Exporter (sondagens HTTP reais), Alertmanager (entrega) e caixa local estão preparados. Você edita dois arquivos YAML curtos; não precisa programar, instalar ferramentas, ter e-mail ou enviar mensagens externas. Tudo funciona em uma instância de treinamento com livros fictícios e prévias de reserva somente de leitura.
Use Library para ações do leitor, Workstation para comandos e Monitoring para observações reais e webhooks recebidos. O site e os rótulos da interface continuam em inglês. Cada unidade começa de forma independente.
Monitorar a pesquisa do leitor
Nesta etapa, você escolherá uma sondagem do cliente. Comece em Library: use primeiro o serviço normal e depois escolha uma verificação do que o leitor realmente precisa.
Percorrer a jornada do leitor
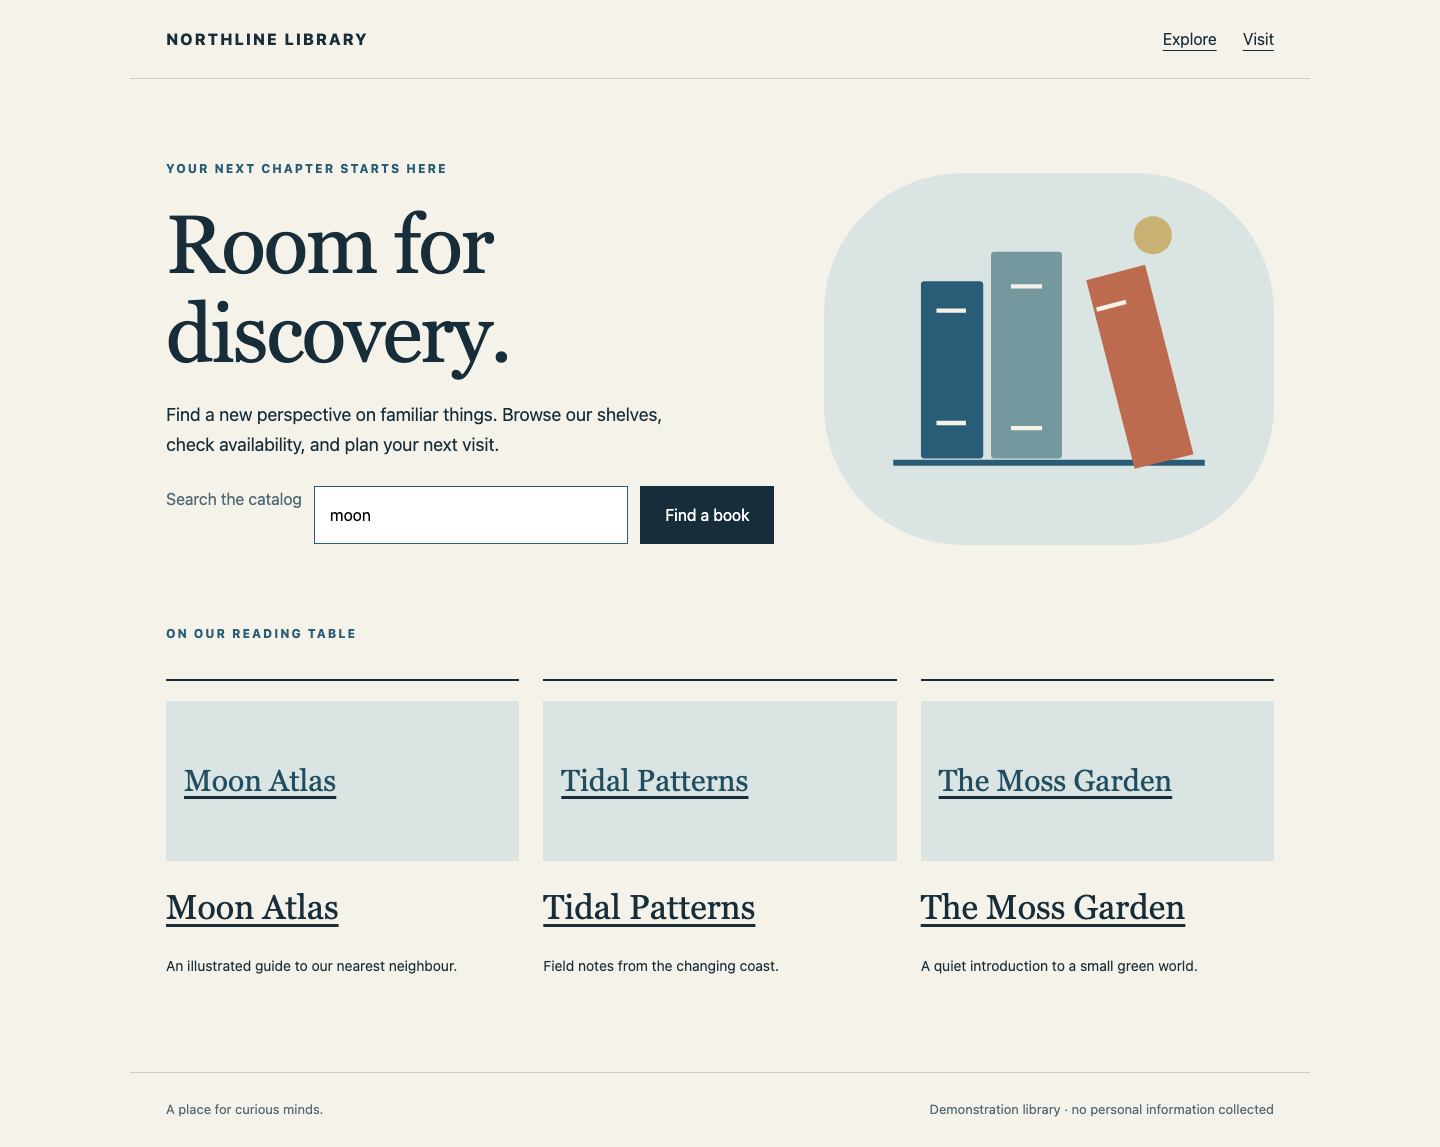
Deixe moon em Search the catalog e selecione Find a book. Os resultados devem incluir Moon Atlas, Available e a localização na estante. Abra Moon Atlas e depois Check reservation: a prévia somente de leitura mostra Ready to collect: Moon Atlas. Nenhuma reserva é criada. Selecione Back to book e depois NORTHLINE LIBRARY. Abra Visit, leia o horário e volte pelo link da marca.
Entender a sondagem
Mude para Workstation, já em /home/labex/project/library-watch. Um caminho identifica arquivo ou diretório; este caminho absoluto começa na raiz do sistema. pwd imprime sua localização, ls lista nomes e cat mostra um arquivo:
pwd
ls
cat prometheus.yml
Você encontra prometheus.yml, alerts.yml e watch.sh. Uma configuração descreve como um programa deve se comportar. YAML usa indentação com espaços, pares key: value e um hífen por item de lista. Preserve os espaços mostrados. Não é necessário editor: você substituirá a configuração pequena por um bloco completo.
HTTP é o protocolo de requisição e resposta do navegador. Uma URL inclui endereço, porta que identifica o serviço e caminho. Em Workstation, 127.0.0.1 significa esta instância. A porta 8081 serve a biblioteca; /search?q=moon pesquisa com o parâmetro q igual a moon. Mantenha a URL entre aspas nos comandos para o shell tratá-la como um argumento.
O job library preparado verifica apenas a página inicial. Um job é um grupo nomeado de alvos de coleta. O exportador na porta 9115 faz uma requisição real e retorna probe_success: 1 para sucesso e 0 para falha. Seu módulo search exige os conteúdos Moon Atlas e Available, além do status HTTP 200. Prometheus coleta esse resultado a cada 2 segundos. A métrica separada up informa apenas se conseguiu coletar do exportador; não prova que o leitor concluiu a tarefa.
Escolher o caminho do cliente
cat > prometheus.yml substitui o arquivo. <<'YAML' inicia um here-document literal: cole o bloco inteiro, incluindo o último YAML sozinho na linha. global define intervalos, rule_files indica regras e alerting conecta o serviço de entrega preparado. Preserve esses ajustes e mude módulo e alvo para a pesquisa. O rótulo journey: search identifica o escopo de negócio.
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload executa o utilitário fornecido: verifica a sintaxe antes de pedir ao Prometheus que recarregue. Não altera a biblioteca nem inventa observações.
bash watch.sh reload
Espere Configuration accepted. Após cerca de 4 segundos, mude para Monitoring. Business probes deve mostrar search: healthy. Se houver erro YAML, volte a Workstation, substitua pelo bloco completo e recarregue. Se as amostras estiverem unavailable, espere e tente novamente: indisponível nunca significa saudável. Não aponte o alvo para o próprio Monitoring.
Comparar acesso com sucesso
Mude para Workstation. fault search seconds 6 faz somente a pesquisa falhar por 6 segundos reais e depois restaura automaticamente. Não define estados de alerta. curl envia requisições HTTP; -sS oculta o progresso, mas mostra erros de conexão. Execute:
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
O corpo diz Search is taking a break. O servidor continua retornando HTTP 200 de propósito: uma verificação apenas do status perderia a falha do negócio. Mude imediatamente para Monitoring: em um intervalo de coleta, pesquisa deve virar failed e voltar a healthy após recuperar. Se perder a janela curta, repita os mesmos 6 segundos. Ainda não há alerta configurado. Espere healthy antes de verificar a etapa.
Alertar somente quando a falha persiste
Nesta etapa, você configurará um alerta do cliente que espera o suficiente para ignorar a falha breve observada. Comece em Workstation.
Ler a condição
Prometheus avalia regras a cada 2 segundos. probe_success{job="library",journey="search"} == 0 seleciona amostras de pesquisa com falha do job library. As chaves contêm filtros de rótulos; == 0 seleciona falha em vez de sucesso. Escolher apenas up monitoraria a coleta, não os leitores. Sem rótulos, serviços sem relação poderiam ser incluídos.
for: 20s exige que a condição permaneça ativa por 20 segundos. pending significa que existe, mas ainda espera; firing, que durou o suficiente; inactive, que está ausente. Os 20 segundos são curtos para o exercício, não uma recomendação universal de produção. Dados de sondagem ausentes aparecem como unavailable em Monitoring: não provam saúde nem constituem uma amostra de falha do negócio.
alert dá nome à regra. severity é um rótulo de roteamento e annotations.summary descreve o impacto ao cliente. Escreva a regra completa:
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
Espere Configuration accepted. Se a validação falhar, corrija espaços ou pontuação e recarregue. A última configuração válida continua ativa até a nova ser aceita.
Mude para Monitoring. Com pesquisa saudável, a regra deve mostrar CustomerJourneyFailed: inactive (20 seconds). A caixa local ainda deve estar vazia.
Provar que a falha breve permanece silenciosa
Mude para Workstation e repita a mesma falha curta:
bash watch.sh fault search seconds 6
Mude imediatamente para Monitoring. Pesquisa falha; a regra pode mostrar pending brevemente. Após recuperação automática, a sondagem e a regra voltam a healthy/inactive. A caixa permanece vazia. Permita cerca de 12 segundos para o ciclo. Se você já executou uma falha longa, os avisos antigos ficam: compare novos eventos em vez de apagar evidências.
Uma regra firing e uma notificação entregue são fatos diferentes. Alertmanager recebe alertas firing, agrupa, espera 1 segundo para um grupo novo e entrega à caixa webhook local. Coleta, avaliação e entrega acrescentam pequenos atrasos. Não remova for nem reduza todos os limites apenas porque o aviso não é imediato.
Receber a falha e sua recuperação
Nesta etapa, você provocará uma falha persistente e observará a entrega real. Comece em Workstation.
Observar uma falha persistente
A próxima falha dura 60 segundos reais, dando tempo de ver cada estado. Apenas a pesquisa falha; a página inicial continua funcionando.
bash watch.sh fault search seconds 60
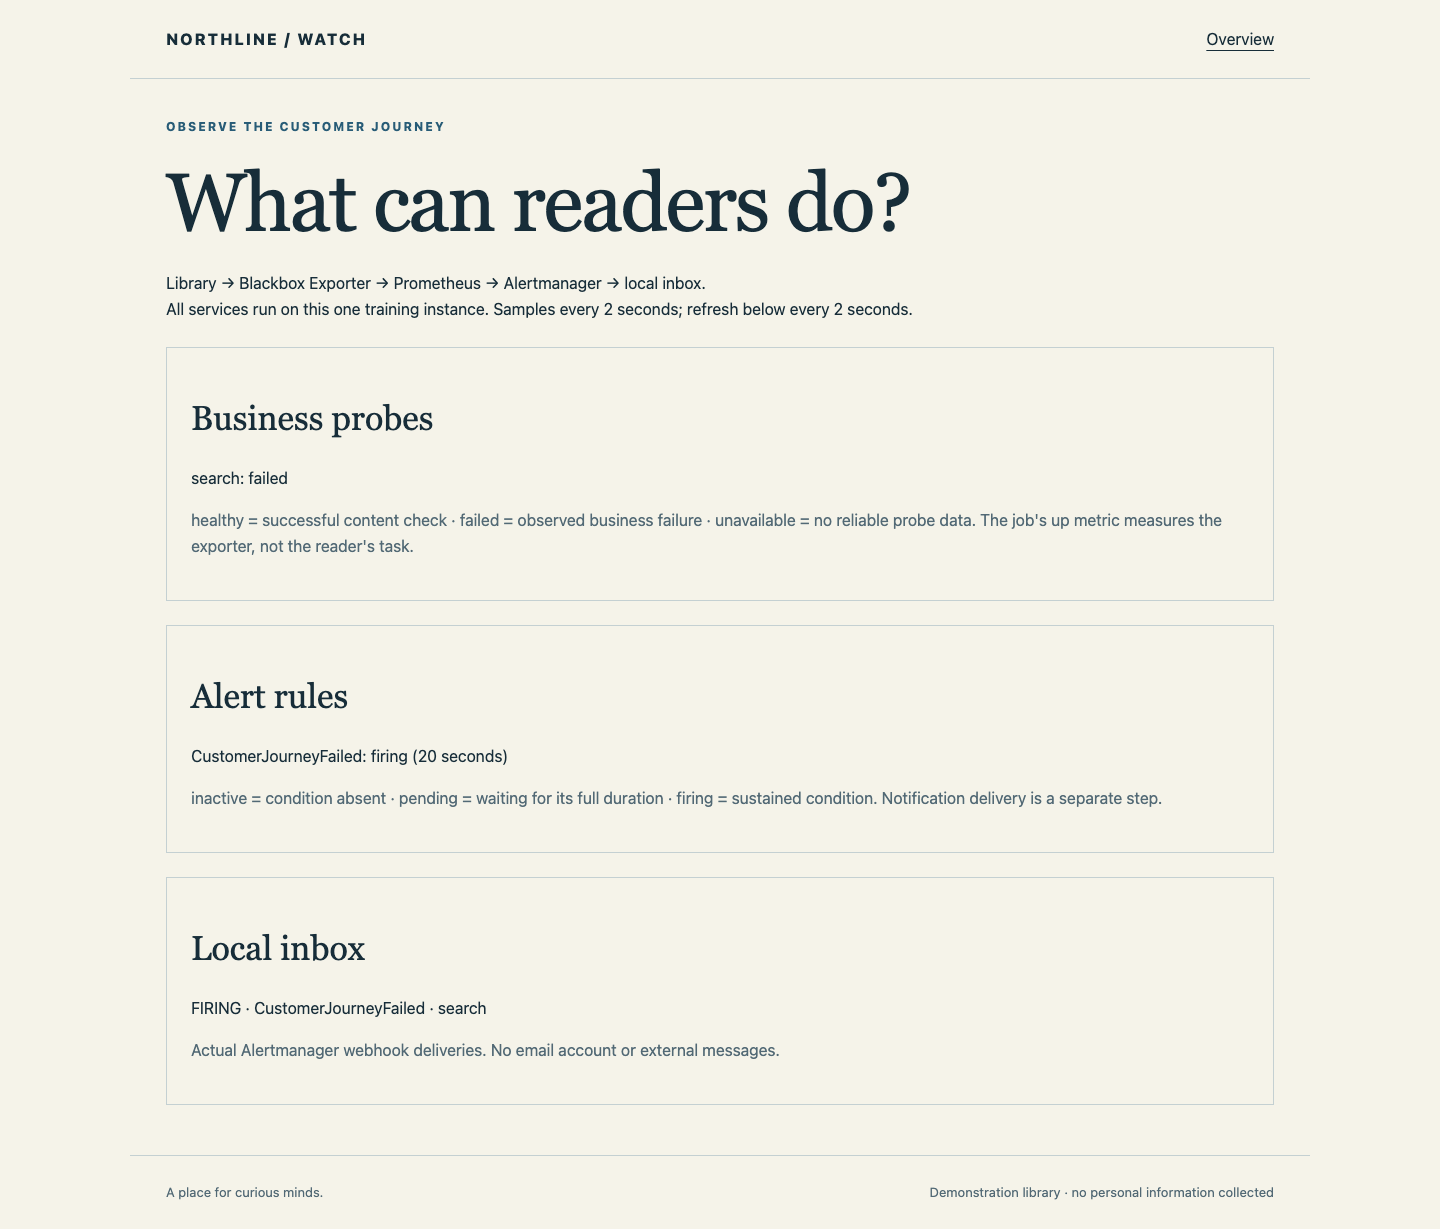
Mude para Library. Volte à página inicial pela marca: ela parece normal. Pesquise moon novamente. A mensagem prova que o leitor não consegue usar o catálogo. Mude para Monitoring. Pesquisa mostra failed e a regra começa pending. Cerca de 20 segundos após a primeira amostra com falha, vira firing; a caixa deve então adicionar FIRING · CustomerJourneyFailed · search. Permita até 35 segundos desde o início para coleta, avaliação e entrega. São observações reais, não uma animação de progresso.
Se a caixa continuar vazia após 35 segundos, mude para Workstation e use o comando de estado somente de leitura:
bash watch.sh status
Observe checks e alerts: unavailable significa coleta ausente; pending indica duração insuficiente; firing sem evento na caixa aponta para entrega. Releia a configuração e recarregue se a corrigir. Uma falha de 60 segundos expirada pode ser repetida. Não crie mensagens falsas nem pare o monitoramento.
Restaurar e confirmar a resolução
Mude para Workstation. Zero segundos restaura a pesquisa imediatamente, mesmo antes do vencimento automático:
bash watch.sh fault search seconds 0
Mude para Library e repita a busca moon a partir da página inicial. Moon Atlas e Available devem retornar. Abra novamente o livro e a prévia de reserva; Visit também deve continuar funcionando.
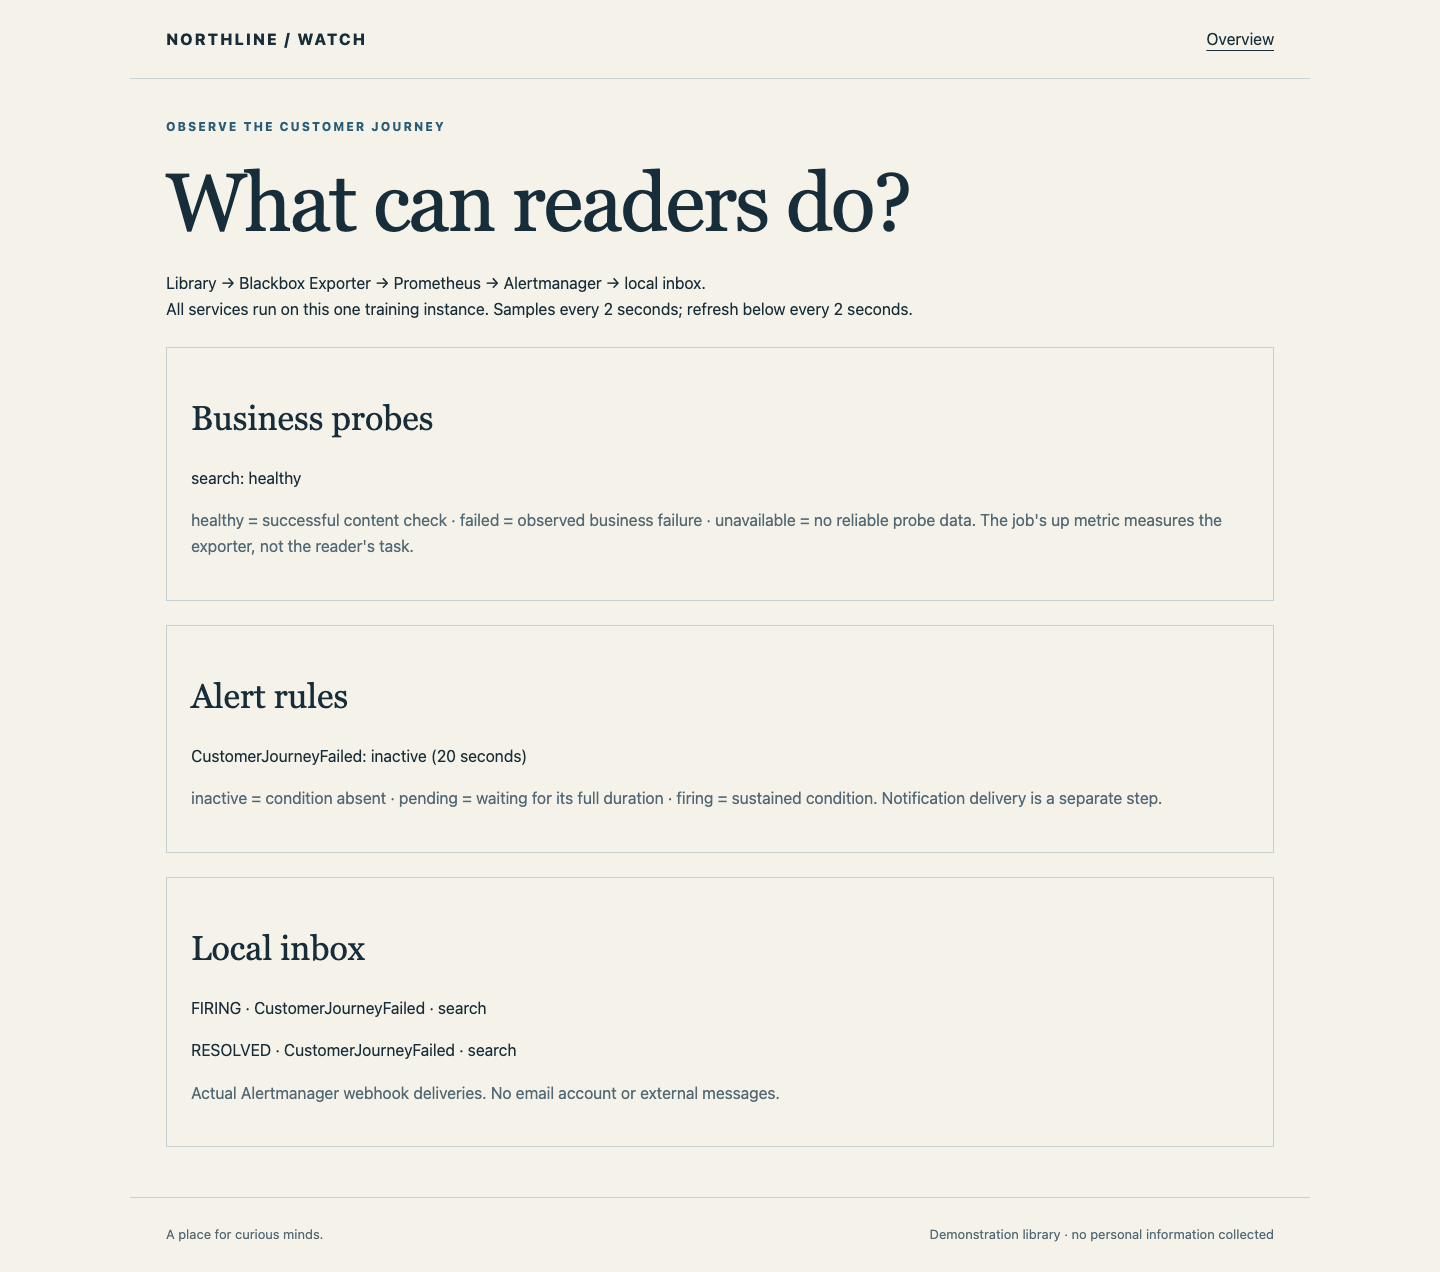
Mude para Monitoring. Em cerca de 10 segundos, pesquisa fica healthy, o alerta inactive e a caixa adiciona RESOLVED · CustomerJourneyFailed · search. O aviso firing original permanece. resolved significa que essa falha terminou, não que a biblioteca nunca falhará novamente.
A etapa verifica o par firing/resolved realmente entregue e a biblioteca utilizável agora. Também testa sua regra carregada com amostras isoladas de saúde, falha breve, falha persistente, recuperação, dados ausentes e falha sem relação. A avaliação não injeta falhas, restaura serviços nem muda sua configuração. Deixe a biblioteca saudável e a regra pronta para falhas futuras.
Resumo
Você escolheu uma pesquisa real do cliente e uma sondagem com verificação de conteúdo, delimitou o alerta com rótulos, ignorou uma falha breve e recebeu webhooks reais de falha e recuperação. Distinguiu exportador operacional de negócio utilizável e ausência de dados de sucesso. O desafio independente aplica os métodos à confirmação de reserva, excluindo outro serviço com falha.