Introdução
Um modelo de IA pode responder em texto, mas às vezes uma aplicação precisa de informações estruturadas antes de executar um trabalho útil. O tool calling permite que a aplicação descreva uma operação, como consultar um item do catálogo, e que o modelo proponha um nome de ferramenta e argumentos. O modelo não recebe permissão para executar código arbitrário. Ele produz dados que o seu Worker deve tratar como entrada não confiável.
Neste laboratório, você criará POST /catalog-help. Um modelo Llama hospedado na Cloudflare recebe uma pergunta curta, como “O SKU KB-101 está em estoque?”, e pode propor a ferramenta somente leitura lookup_catalog_item. O seu Worker aceita exatamente uma ferramenta conhecida, valida um objeto de argumentos exato no formato { sku } e só então lê um pequeno catálogo sintético. Ferramentas desconhecidas, campos ausentes ou extras, SKUs malformados e múltiplas chamadas nunca chegam ao executor.
Você usará o traditional function calling para manter visível o limite de segurança: a inferência propõe, a validação decide e o código da aplicação executa. O resultado retornado fica limitado a alguns campos públicos de uma fixture. Nada neste exercício concede acesso de escrita, chama um serviço externo ou permite que o modelo escolha código executável.
Este é o quinto laboratório do curso. Se você entrou diretamente, conclua primeiro Conectar o LabEx à sua conta da Cloudflare para aprender a usar o terminal da VM, autorizar o Wrangler, confirmar sua conta de aprendizagem e configurar o ID da conta.
O modelo selecionado, @cf/meta/llama-3.3-70b-instruct-fp8-fast, oferece suporte a function calling e está disponível pela alocação padrão do Workers AI. Atualmente, o Workers Free inclui 10.000 Neurons por dia. Este laboratório envia apenas uma solicitação curta ao vivo localmente e outra após a implantação, portanto o Workers Paid não é necessário enquanto a alocação gratuita estiver disponível. A inferência local ainda alcança a Cloudflare e consome o uso da conta; pare, em vez de tentar repetidamente, se o modelo ou a alocação não estiverem disponíveis.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/tool-call-guard. Ela também fornece fixtures determinísticas do modelo e verificações independentes. A configuração não autoriza o Wrangler, não cria o código-fonte do Worker, não invoca um modelo, não faz a implantação nem cria um recurso na nuvem.
Autorizar a VM e configurar o Worker de tool calling
Nesta etapa, você autorizará esta VM nova e configurará um Worker descartável. Talvez o seu navegador já esteja conectado ao Cloudflare Dashboard, mas o Wrangler dentro de uma VM nova ainda precisa da própria autorização limitada.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/tool-call-guard
npx wrangler --version
O resultado esperado é 4.132.0. Solicite apenas as permissões necessárias para um Worker conectado à IA. O Wrangler 4.132.0 também verifica dependências do KV durante a exclusão, portanto o processo de limpeza precisa da permissão do KV, embora este laboratório não crie dados no KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra o link exibido, informe o código atual, confira a conta e as permissões e autorize sua conta de aprendizagem. Nunca envie o código, a senha ou o token para outra pessoa. Depois, consulte os dados estruturados de identidade:
npx wrangler whoami --json
Confirme loggedIn: true. Em seguida, gere um nome exclusivo para que a limpeza possa atingir apenas o Worker deste laboratório:
RUN="labex-c07-a05-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
O here-document abaixo grava uma configuração JSON comum. Substitua YOUR_ACCOUNT_ID pelo ID real da conta de aprendizagem desejada:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
O binding AI fornece ao código um identificador seguro env.AI, sem colocar uma chave de API do modelo no código-fonte. remote: true significa que o desenvolvimento local ainda chama o modelo associado à conta, em vez de simular a inferência offline.
Entender o limite da ferramenta
Nesta etapa, você conectará o binding da plataforma ao limite que a sua aplicação precisa impor.
Gere os tipos de ambiente a partir de wrangler.jsonc e depois inspecione a interface gerada:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Procure AI: Ai. Uma descrição de ferramenta é um conjunto de dados estruturados enviado ao modelo: um nome, uma finalidade em linguagem simples e um schema para os possíveis argumentos. Ela ajuda o modelo a propor uma chamada, mas não é autorização nem código executável.
Este laboratório permite uma ferramenta somente leitura, lookup_catalog_item, com um argumento como { "sku": "KB-101" }. Depois da inferência, a aplicação exige exatamente uma chamada proposta e o nome permitido exato. Em seguida, exige que arguments seja um objeto contendo apenas sku, verifica o formato curto de SKU público do laboratório e passa o valor validado somente para a função fixa de leitura da aplicação.
Inspecione as fixtures de rejeição fornecidas:
grep -nE 'unknown tools|missing, extra|zero or multiple' test/worker.test.mjs
As fixtures são respostas falsas deliberadas do modelo. Elas comprovam o limite de segurança sem consumir Neurons nem depender de que um modelo ao vivo produza uma chamada malformada.
Criar a ferramenta de catálogo validada
Nesta etapa, você descreverá a ferramenta para o modelo, validará a proposta do modelo e executará apenas a função de catálogo somente leitura da aplicação.
Crie o entrypoint do Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const TOOL_NAME = "lookup_catalog_item";
const MAX_QUESTION = 240;
const SKU_PATTERN = /^[A-Z]{2}-[0-9]{3}$/;
const CATALOG = [
  { sku: "KB-101", name: "Compact Keyboard", priceUsd: 49, inStock: true },
  { sku: "MS-205", name: "Wireless Mouse", priceUsd: 29, inStock: false }
];

const TOOLS = [{
  name: TOOL_NAME,
  description: "Read one public catalog item by the exact SKU stated in the user's question.",
  parameters: {
    type: "object",
    properties: { sku: { type: "string", description: "An exact catalog SKU such as KB-101" } },
    required: ["sku"]
  }
}];

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuestion(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) return { error: json({ error: "invalid_question" }, 400) };
  if (question.length > MAX_QUESTION) return { error: json({ error: "question_too_large" }, 413) };
  return { question };
}

export function validateToolSelection(toolCalls) {
  if (!Array.isArray(toolCalls) || toolCalls.length !== 1) throw new Error("exactly one tool call is required");
  const call = toolCalls[0];
  if (!call || call.name !== TOOL_NAME) throw new Error("unknown tool");
  const args = call.arguments;
  if (!args || typeof args !== "object" || Array.isArray(args)) throw new Error("arguments must be an object");
  if (Object.keys(args).length !== 1 || !Object.hasOwn(args, "sku")) throw new Error("unexpected arguments");
  if (typeof args.sku !== "string" || !SKU_PATTERN.test(args.sku)) throw new Error("invalid sku");
  return { name: TOOL_NAME, arguments: { sku: args.sku } };
}

export function executeCatalogTool(argumentsValue) {
  const item = CATALOG.find((candidate) => candidate.sku === argumentsValue.sku);
  return item ? { ...item, found: true } : { sku: argumentsValue.sku, found: false };
}

export async function handleCatalogHelp(request, env, execute = executeCatalogTool) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let inference;
  try {
    inference = await env.AI.run(MODEL, {
      messages: [
        { role: "system", content: "Use exactly one provided read-only tool. Copy only the exact SKU from the user. Do not answer from memory." },
        { role: "user", content: parsed.question }
      ],
      tools: TOOLS,
      max_tokens: 128,
      temperature: 0
    });
  } catch {
    console.error(JSON.stringify({ event: "tool_inference_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let selected;
  try { selected = validateToolSelection(inference?.tool_calls); }
  catch {
    console.error(JSON.stringify({ event: "tool_call_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_tool_call", requestId }, 502);
  }
  const result = execute(selected.arguments);
  console.log(JSON.stringify({ event: "tool_call_executed", requestId, model: MODEL, tool: selected.name, found: result.found }));
  return json({ model: MODEL, tool: selected.name, arguments: selected.arguments, result, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/catalog-help") return handleCatalogHelp(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
Observe a ordem: env.AI.run() retorna dados, validateToolSelection() os restringe a um único formato permitido e só então executeCatalogTool() é executada. O modelo nunca fornece JavaScript, escolhe uma URL ou obtém acesso a uma operação de escrita. Os logs registram metadados do ciclo de vida, mas omitem a pergunta do usuário e o resultado do catálogo.
Execute os cinco testes determinísticos e peça ao Wrangler para criar o bundle sem fazer a implantação:
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
Os testes devem informar cinco aprovações. A execução de simulação deve listar env.AI como um binding de IA. Juntos, esses resultados comprovam que o código de validação e a configuração do Worker estão compatíveis antes que uma chamada real ao modelo consuma uso.
Exercitar uma seleção de ferramenta ao vivo
Nesta etapa, você executará o Worker localmente enquanto o binding de IA realiza uma inferência remota real. Apenas a consulta ao catálogo é executada localmente; o modelo continua sendo executado na Cloudflare.
Inicie o Wrangler em segundo plano e aguarde a rota de verificação que não usa IA. & cria um processo em segundo plano, $! é o ID desse processo e o loop limitado para de esperar assim que /health funcionar:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
Envie uma pergunta curta contendo um SKU sintético exato:
curl --silent --show-error http://127.0.0.1:8787/catalog-help \
  --header 'Content-Type: application/json' \
  --data '{"question":"Is SKU KB-101 in stock and what does it cost?"}'
O resultado esperado contém o modelo Llama exato, tool: "lookup_catalog_item", argumentos contendo apenas KB-101 e a fixture limitada de Compact Keyboard. O texto gerado não é avaliado, porque a aplicação consome a proposta estruturada da ferramenta em vez de texto livre.
Rejeite uma pergunta vazia antes da inferência:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/catalog-help \
  --header 'Content-Type: application/json' --data '{"question":""}'
O resultado esperado é {"error":"invalid_question"} com HTTP 400. Isso comprova que a validação comum da solicitação ocorre antes do uso do modelo.
Fazer a implantação e inspecionar as evidências da ferramenta
Nesta etapa, você fará a implantação do mesmo endpoint e relacionará o comportamento em execução às evidências visíveis na Cloudflare.
Pare apenas o processo de desenvolvimento salvo, aguarde a saída dele e faça a implantação:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Salve a URL exata exibida pelo Wrangler e envie uma pergunta pública:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/catalog-help" \
  --header 'Content-Type: application/json' \
  --data '{"question":"Is SKU KB-101 in stock and what does it cost?"}'
Confirme que o resultado público usa o modelo exato e a ferramenta permitida, retorna apenas o argumento de SKU validado e contém os mesmos campos limitados da fixture somente leitura.
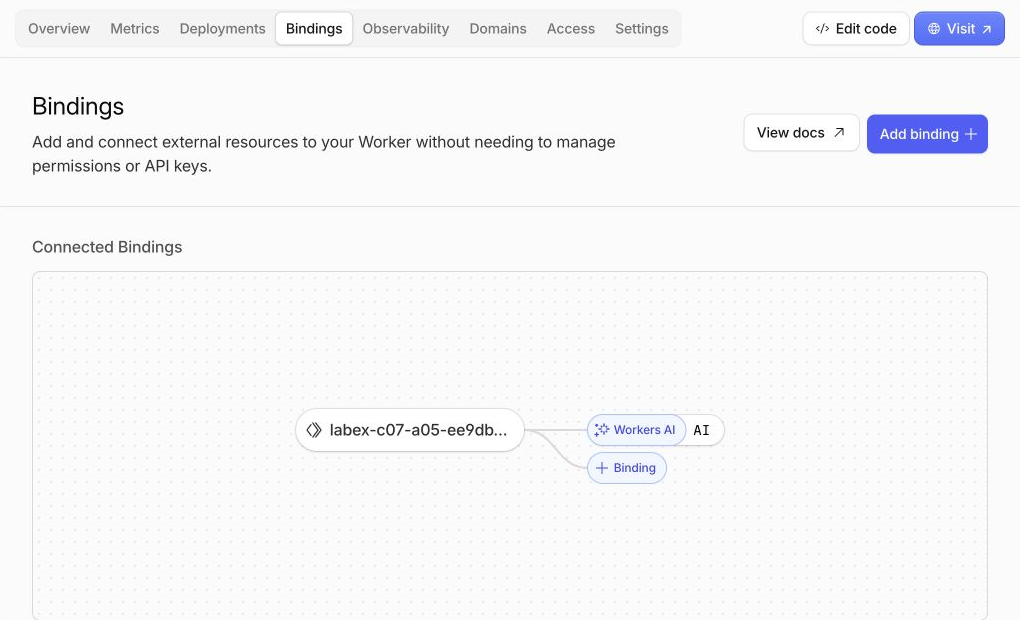
Abra Workers & Pages → seu Worker labex-c07-a05-... → Bindings. Um binding é a conexão nomeada que disponibiliza um serviço da Cloudflare para o código do Worker. Confirme uma conexão Workers AI com o nome AI; esse nome permite que o programa chame env.AI.run(...).
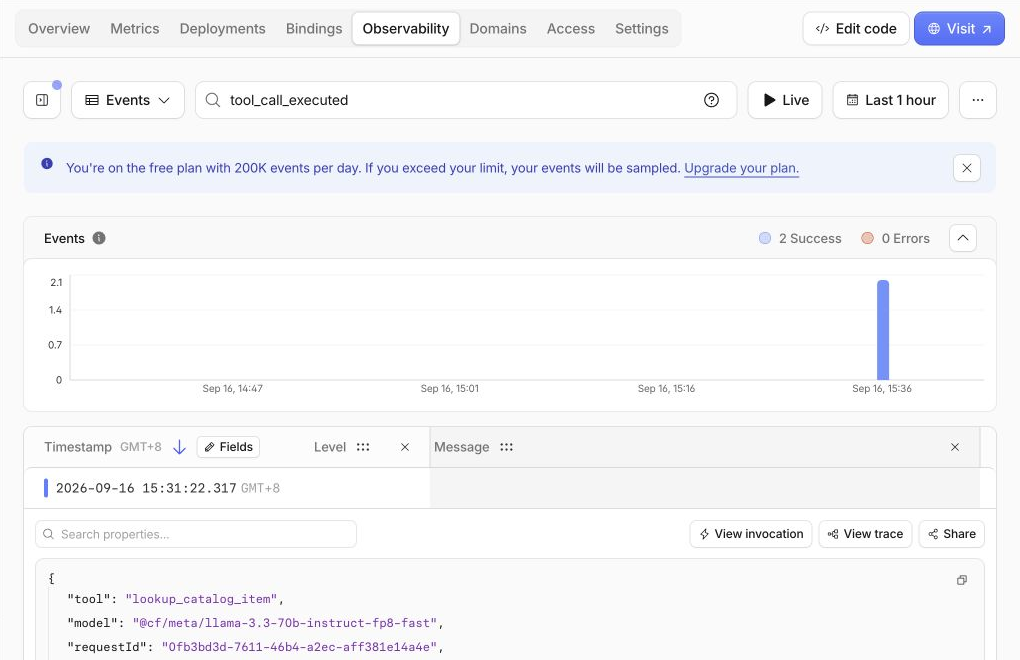
Depois, abra Observability. Esta página reúne registros de invocação e logs da aplicação. O exemplo abaixo mostra quatro eventos bem-sucedidos e nenhum erro depois da solicitação pública e das verificações independentes. A sua contagem pode ser diferente, porque cada solicitação pode contribuir com um registro de invocação e um evento da aplicação, e a entrega no Dashboard pode atrasar.
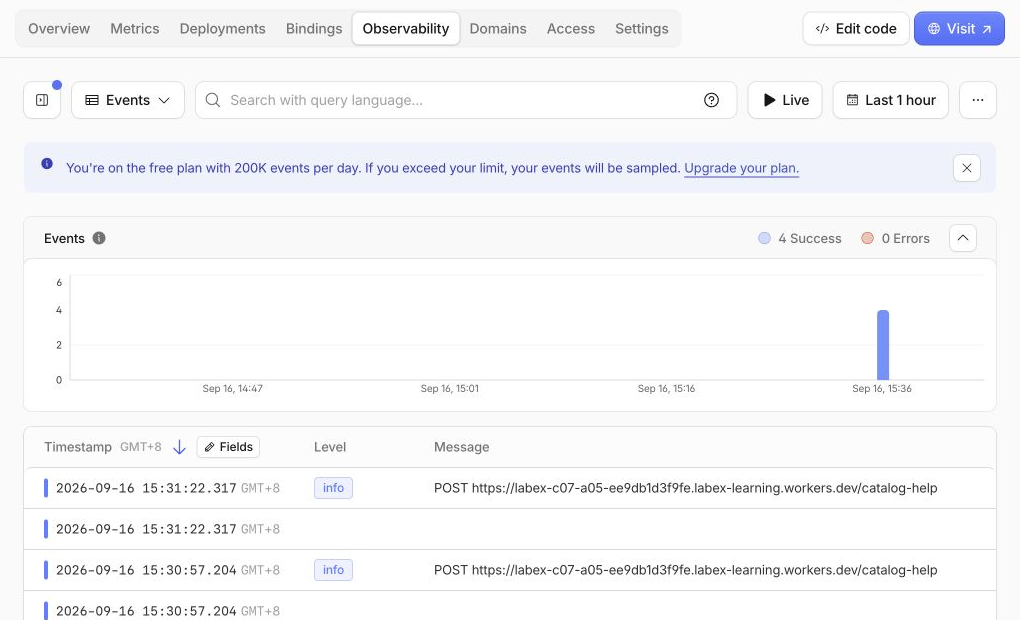
O aviso azul do plano Free nesta página se refere à cota de eventos do Workers Logs, não à inferência de IA. No campo de pesquisa, informe tool_call_executed e expanda uma linha correspondente. O exemplo em destaque mostra duas correspondências bem-sucedidas e os campos deliberadamente limitados no início do evento: lookup_catalog_item, o modelo Llama exato e um ID de solicitação. O evento completo também contém event: "tool_call_executed" e found: true, mas não registra a pergunta do usuário, a resposta bruta do modelo nem o registro retornado do catálogo.
Por fim, abra AI → Workers AI e mantenha a aba Neurons selecionada. Um Neuron é a unidade da Cloudflare para computação do Workers AI. A conta usada no exemplo consumiu 342.34/10k Neurons naquele dia; a linha do Llama mostra 341.57, enquanto um exercício anterior de embeddings aparece separadamente. Esses são exemplos compartilhados de uma conta, não um custo garantido para uma única solicitação. Encontre a linha exata do Llama na sua conta e confirme que o total de hoje continua dentro da alocação de 10k do Workers Free.
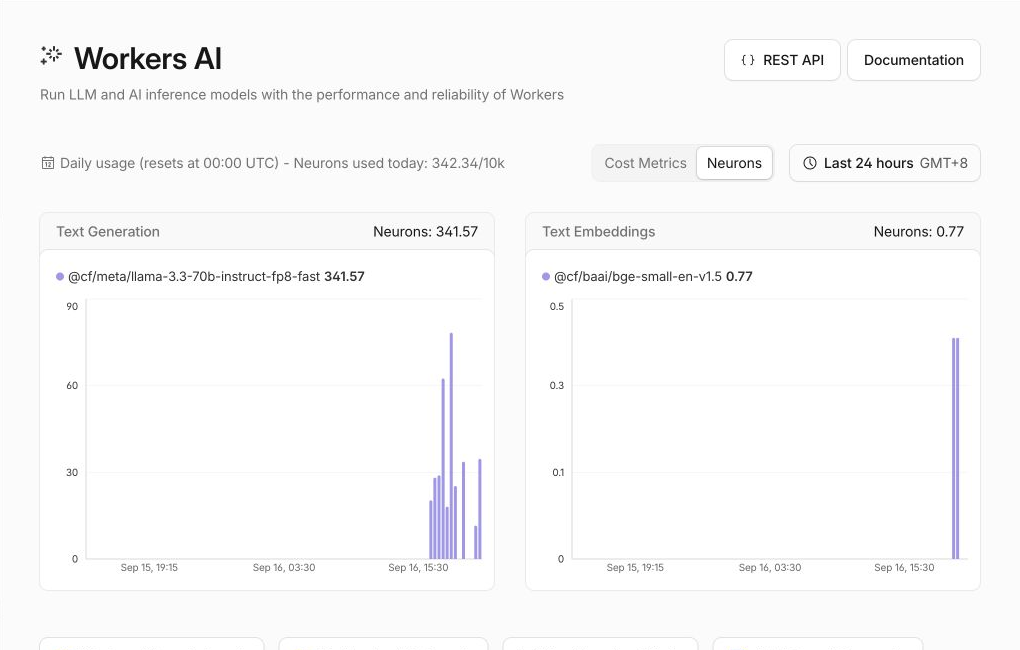
As páginas do Dashboard ajudam você a relacionar configuração, tráfego e uso ao resultado da linha de comando. Não repita a inferência apenas para forçar a atualização de um gráfico. A resposta JSON e a verificação independente continuam sendo a fonte de verdade, porque os gráficos e logs podem aparecer mais tarde.
Remover o Worker e sair da conta
Nesta etapa, você removerá o endpoint público descartável e depois removerá a autorização desta VM. O uso do Workers AI permanece no histórico da conta; excluir o Worker não apaga o registro de uso.
Exclua exatamente o Worker nomeado em wrangler.jsonc:
npx wrangler delete
Confirme somente quando o Wrangler mostrar o nome exclusivo deste laboratório, labex-c07-a05-.... Exija Successfully deleted e depois execute a verificação independente de ausência na nuvem enquanto a autorização ainda estiver disponível:
python3 .labex/verify.py deleted
Somente depois que o comando informar PASS: deleted, saia da conta e inspecione o estado estruturado:
npx wrangler logout
npx wrangler whoami --json
Exija loggedIn: false. Fechar uma aba do navegador ou excluir o código-fonte local não comprovaria que o Worker público foi removido.
Resumo
Você separou a seleção do modelo da autoridade da aplicação. O Workers AI propôs uma consulta de catálogo estruturada, o seu Worker validou o nome exato da ferramenta e o objeto de argumentos e, somente depois, o código fixo de leitura foi executado. Fixtures determinísticas comprovaram que ferramentas desconhecidas, argumentos malformados e múltiplas chamadas não podem executar ações, enquanto a inferência ao vivo demonstrou a troca real com o modelo. Você também inspecionou evidências com limites de privacidade e removeu o Worker descartável e a autorização da VM.