Introdução
Um endpoint de IA depende de mais do que seu JavaScript. Um aluno pode enviar uma entrada inválida, o modelo selecionado pode rejeitar uma solicitação, uma conta pode atingir uma cota ou um limite de taxa, a capacidade pode ficar temporariamente indisponível ou o próprio código da aplicação pode falhar. Cada situação exige uma resposta diferente. Tratar todas elas como “a IA falhou” dificulta a operação da aplicação e pode incentivar novas tentativas desnecessárias.
Neste laboratório, você criará POST /draft-reply. Um modelo Llama hospedado na Cloudflare redigirá uma resposta curta de suporte. Seu Worker rejeitará entradas inválidas antes da inferência, reconhecerá erros documentados do modelo e de limites, repetirá uma falha temporária no máximo uma vez, validará a resposta do modelo e relatará separadamente um defeito da aplicação. Uma nova tentativa limitada significa que o número máximo de tentativas adicionais é definido antecipadamente; o processo não pode continuar em loop até esgotar a alocação gratuita da conta.
Você comprovará a maioria dos caminhos de falha com fixtures determinísticos. Uma fixture é um substituto controlado que retorna um resultado ou erro escolhido, permitindo testar o comportamento de cota e indisponibilidade sem consumir cota deliberadamente nem provocar uma indisponibilidade real. Apenas uma solicitação local curta e uma solicitação após a implantação usarão o modelo ativo.
Este é o sexto laboratório guiado do curso. Se você entrou diretamente, conclua primeiro Conectar o LabEx à sua conta da Cloudflare para aprender a usar o terminal da VM, autorizar o Wrangler, confirmar sua conta de aprendizagem e configurar o ID da conta.
O modelo selecionado, @cf/meta/llama-3.3-70b-instruct-fp8-fast, está disponível pela alocação padrão do Workers AI. Atualmente, o Workers Free inclui 10.000 Neurons por dia. Este laboratório não exige o Workers Paid enquanto houver alocação gratuita disponível. O exercício visível e a verificação independente fazem uma solicitação curta e saudável localmente e outra após a implantação. A inferência local ainda acessa a Cloudflare e consome o uso da conta; portanto, não repita uma falha ativa várias vezes.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/resilient-ai-reply. Ela também fornece fixtures determinísticas e verificações independentes. A configuração não autoriza o Wrangler, não cria o código-fonte do Worker, não invoca um modelo, não faz a implantação nem cria um recurso na nuvem.
Autorizar a VM e configurar o Worker resiliente
Nesta etapa, você autorizará esta VM nova e configurará um Worker descartável. Fazer login no navegador da Cloudflare não autoriza automaticamente o Wrangler dentro de uma VM nova do LabEx.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
Execute o fluxo de autorização por dispositivo:
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
Abra no navegador a URL de autorização exibida, confirme a conta de aprendizagem correta e aprove os acessos listados. O escopo de compatibilidade com KV é necessário para esta versão do Wrangler durante a exclusão de um Worker; este laboratório não cria nem altera dados do KV.
Confirme a autorização usando uma saída estruturada:
npx wrangler whoami --json
Verifique se "loggedIn": true está presente, confirme o nome da conta e copie o ID real dessa conta para a próxima configuração. Gere um nome exclusivo e crie wrangler.jsonc:
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
O binding AI fornece ao código do Worker uma interface env.AI associada à conta. remote: true também significa que as solicitações locais do Wrangler usarão o serviço real do Workers AI e serão contabilizadas na alocação compartilhada.
Separar as categorias de falha
Nesta etapa, você transformará várias causas de falha muito diferentes em um pequeno contrato público antes de escrever o código de recuperação.
Um status HTTP informa ao cliente que tipo de resultado ocorreu. Ele não deve expor mensagens brutas do provedor, detalhes da conta nem stack traces. Este laboratório usa cinco limites:
400 invalid_request: a entrada do aluno está ausente ou fora do tamanho permitido; portanto, a inferência nem começa.502 model_incompatibleouincompatible_model_response: o modelo selecionado ou o formato retornado não corresponde ao contrato da aplicação. Repetir a mesma solicitação não corrigirá a incompatibilidade.503 model_quota_exhaustedoumodel_rate_limited: o limite da conta ou do modelo indica que é preciso parar. Uma nova tentativa automática imediata consumiria outra solicitação e aumentaria a carga.503 model_temporarily_unavailable: um timeout ou uma falha temporária de capacidade ocorreu duas vezes. A resposta incluiRetry-Afterpara que o cliente possa esperar antes de fazer uma solicitação posterior.500 application_failure: a inferência do modelo retornou dados utilizáveis, mas a própria etapa de formatação da aplicação falhou.
A Cloudflare documenta o código interno 3036 para uma alocação gratuita diária esgotada, 3040 para capacidade temporariamente indisponível, 3007 para timeout e 5035 para um modelo que exige o Workers Paid. A aplicação mapeia sinais conhecidos para erros públicos estáveis e registra apenas a categoria, o número de tentativas e o ID de rastreamento.
Gere as declarações TypeScript e inspecione o binding do AI:
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
A declaração gerada comprova que env.AI está disponível para o Worker. Ela não comprova que uma chamada ao modelo terá sucesso; autorização, cota, compatibilidade do modelo e integridade do serviço são condições verificadas em tempo de execução.
Criar uma recuperação limitada
Nesta etapa, você implementará a classificação, o limite de uma nova tentativa e limites separados para a resposta do modelo e para a aplicação.
Crie o ponto de entrada do Worker:
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
O loop de novas tentativas permite duas tentativas no total: a chamada inicial e uma chamada adicional apenas para uma categoria temporária conhecida. Falhas de cota, limite de taxa e compatibilidade são interrompidas imediatamente. Observe também que a chamada ao modelo, a validação da resposta e a formatação da aplicação são separadas. Isso permite que os operadores diferenciem um problema do provedor de um defeito da aplicação.
A resposta pública nunca inclui a exceção bruta. Os logs omitem a mensagem de suporte e a resposta gerada; eles mantêm apenas os metadados do ciclo de vida necessários para investigar a categoria da falha.
Comprovar a matriz de falhas sem consumir cota
Nesta etapa, você exercitará cada categoria de falha com fixtures controladas antes de fazer qualquer solicitação ao modelo ativo.
Execute a suíte determinística:
node --test test/worker.test.mjs
Os nove casos usam fixtures em vez de inferência ativa. Confirme que uma entrada inválida resulta em zero chamadas ao modelo, que erros de cota e limite de taxa fazem uma chamada, que uma falha temporária de capacidade faz no máximo duas chamadas, que uma saída malformada se torna uma falha de compatibilidade e que um defeito de formatação se torna uma falha da aplicação.
Agora faça o bundle do Worker exato:
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
A execução de teste verifica se o Wrangler consegue gerar o bundle do módulo e deve listar o binding AI. Ela não faz a implantação nem chama o modelo.
Exercitar uma inferência saudável e inspecionar as evidências
Nesta etapa, você fará uma solicitação saudável local e outra após a implantação. Depois, relacionará os resultados às evidências somente para leitura no Dashboard da Cloudflare.
Inicie o Wrangler local em segundo plano e aguarde a rota de verificação que não usa IA. O loop limitado impede uma espera infinita:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
A resposta deve conter um reply não vazio, o modelo exato, um ID de rastreamento e attempts igual a 1 no caso saudável usual. O valor 2 significa que uma falha temporária foi recuperada dentro do limite.
Execute a verificação local independente, interrompa o processo salvo e faça a implantação:
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Copie a URL exata de workers.dev exibida na saída da implantação e teste o endpoint público:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
A mensagem vazia deve retornar HTTP 400 antes da inferência. Isso comprova a proteção da entrada sem consumir outra solicitação ao modelo.
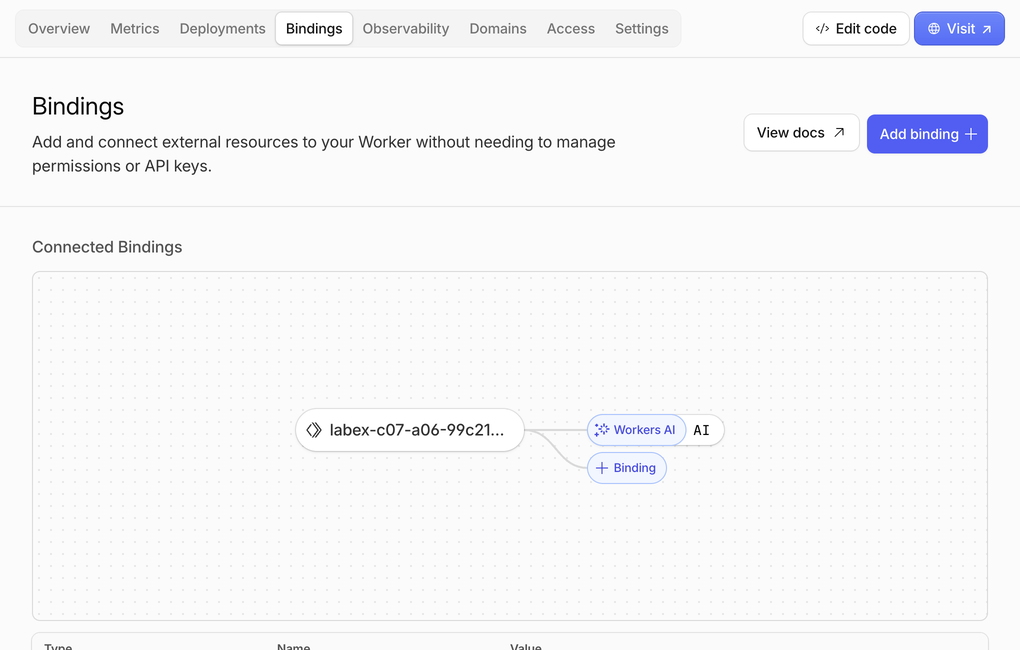
Abra Workers & Pages, selecione o nome exato do Worker e inspecione Bindings. Um binding é a conexão nomeada que permite ao código do Worker acessar outro serviço da Cloudflare sem armazenar uma chave de API. Confirme uma conexão Workers AI chamada AI; o nome de Worker mostrado no exemplo abaixo pertence à execução de teste, enquanto o seu terá um sufixo aleatório diferente.
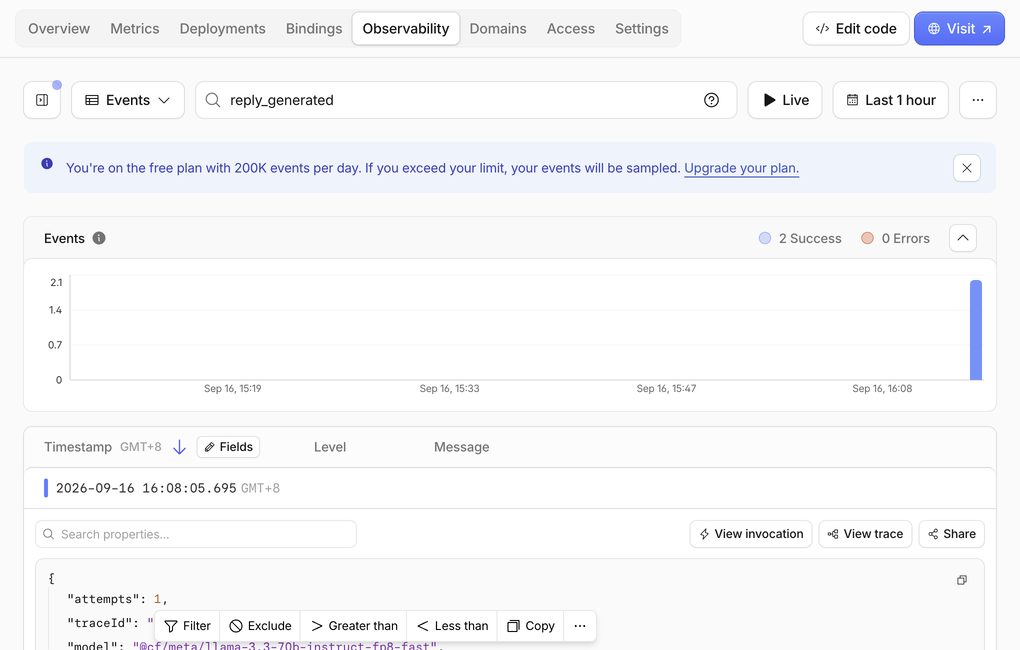
Em seguida, abra Observability. A execução de exemplo produziu seis eventos bem-sucedidos e nenhum erro. As contagens podem ser diferentes porque uma solicitação pode criar tanto um registro de invocação quanto um log da aplicação, e os logs salvos podem chegar depois da resposta.
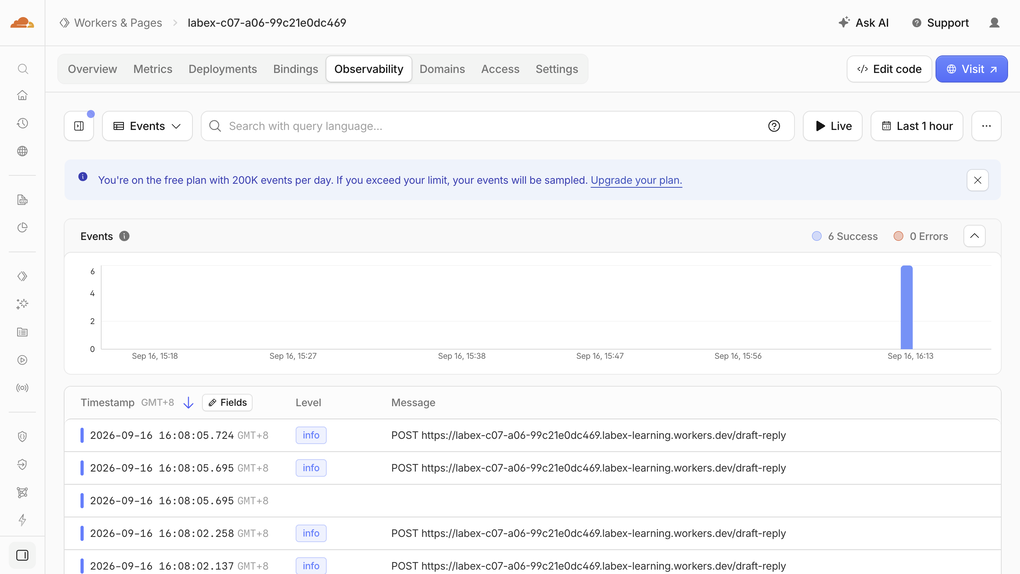
O aviso azul do plano Free exibido aqui descreve a Workers Logs event allowance, não o uso de inferência do AI. Pesquise por reply_generated e expanda um resultado. O exemplo ampliado mostra duas correspondências bem-sucedidas e os campos deliberadamente limitados da aplicação: uma tentativa, um ID de rastreamento e o modelo exato. O evento completo também contém event: "reply_generated", mas a aplicação não registra a mensagem de suporte, a resposta gerada nem o erro bruto do provedor.
Por fim, abra AI > Workers AI e mantenha a aba Neurons selecionada. Um Neuron é a unidade da Cloudflare para computação de IA. A conta compartilhada de exemplo mostrou 428.59/10k Neurons usados naquele dia, sendo 427.82 atribuídos ao modelo Llama e 0.77 a um laboratório anterior de embeddings. Esses totais incluem outros exercícios do curso e podem ser atualizados com atraso; eles não representam o custo de uma única solicitação.
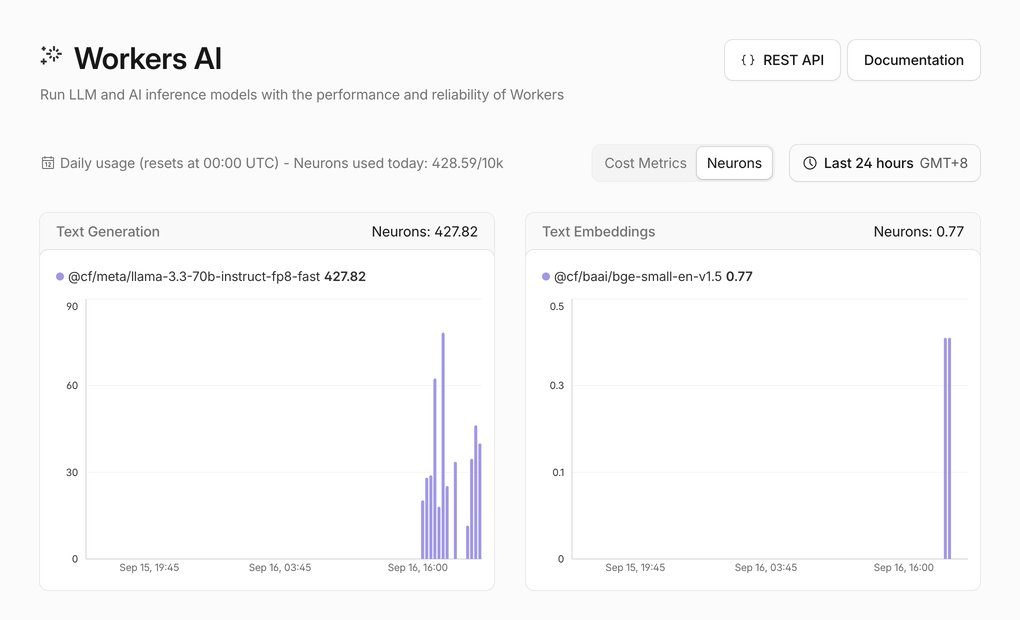
Confirme apenas que o uso continua dentro da alocação diária disponível. As visualizações do Dashboard ajudam a relacionar configuração, tráfego e uso ao resultado da linha de comando, mas a resposta em tempo de execução e as verificações independentes continuam sendo as fontes de autoridade. Não repita a inferência apenas para fazer um gráfico mudar.
Remover o Worker e sair da conta
Nesta etapa, você removerá o endpoint descartável enquanto a autorização ainda estiver disponível e, depois, removerá essa autorização da VM.
Exclua apenas o Worker descartável cujo nome está registrado em wrangler.jsonc:
npx wrangler delete --force
Confirme a ausência autenticada enquanto o Wrangler ainda estiver autorizado:
./.labex/verify.py deleted
Agora remova a autorização armazenada nesta VM:
npx wrangler logout
npx wrangler whoami --json
Verifique se "loggedIn": false está presente e execute a verificação final:
./.labex/verify.py logout
Excluir um Worker remove o recurso na nuvem; sair da conta remove a autorização desta VM. Essas são ações de limpeza separadas.
Resumo
Você criou um endpoint do Workers AI que:
- rejeita entradas inválidas antes da inferência;
- mantém distintas as falhas de compatibilidade, cota, limite de taxa, falhas temporárias e falhas da aplicação;
- repete uma falha temporária conhecida no máximo uma vez;
- valida a saída do modelo antes da formatação da aplicação;
- retorna erros públicos estáveis sem expor detalhes brutos do provedor;
- registra metadados do ciclo de vida com privacidade limitada;
- comprova o comportamento das falhas com fixtures determinísticas em vez de desperdiçar cota;
- confirma uma inferência saudável local e após a implantação no Workers Free; e
- exclui o Worker descartável e sai da conta na VM.
O hábito operacional importante não é “repetir toda falha de IA”. É identificar o limite correto, repetir apenas uma condição realmente temporária dentro de um limite fixo e fornecer ao cliente uma resposta útil.