Introdução
Uma pesquisa por palavras-chave procura as mesmas palavras. Uma pesquisa semântica tenta encontrar textos com o mesmo significado. Por exemplo, “Não consigo entrar” deve ficar próximo de um artigo sobre redefinição de senha, mesmo que as frases não compartilhem todas as palavras.
Um modelo de embedding transforma texto em um vetor: uma lista ordenada de números que representa características aprendidas pelo modelo a partir da linguagem. Textos com significados relacionados geralmente apontam em direções semelhantes. Este laboratório compara essas direções usando a similaridade de cosseno, um cálculo que retorna uma pontuação maior para vetores mais alinhados. Uma pontuação só é útil para comparar vetores produzidos com o mesmo modelo, a mesma quantidade de dimensões e a mesma opção de pooling; ela não representa uma porcentagem universal de verdade.
Você criará POST /search. O Worker gera embeddings para uma consulta e para três pequenos artigos de ajuda usando o @cf/baai/bge-small-en-v1.5, hospedado pela Cloudflare. O modelo produz 384 números por texto. Sua aplicação valida cada vetor antes de compará-lo, rejeita valores incompatíveis ou não finitos e retorna os IDs dos artigos classificados, sem expor os próprios vetores.
Este é o quarto laboratório do curso. Se você entrou diretamente, primeiro conclua Conectar o LabEx à sua conta da Cloudflare para aprender a usar o terminal da VM, autorizar o Wrangler, confirmar sua conta de aprendizagem e configurar o ID da conta.
As contas Workers Free recebem atualmente uma alocação diária compartilhada de 10.000 Neurons. Este modelo custa cerca de 1.841 Neurons por milhão de tokens de entrada, e este laboratório usa apenas algumas frases sintéticas curtas; portanto, o Workers Paid não é necessário enquanto houver alocação gratuita disponível. A inferência local ainda acessa a Cloudflare e consome o uso da conta. Pare em vez de repetir a tentativa várias vezes se o modelo ou a alocação estiverem indisponíveis.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/search-embeddings. Ela também fornece testes determinísticos e verificações independentes. A configuração não autoriza o Wrangler, não chama um modelo, não implanta um Worker nem cria um recurso na nuvem.
Autorizar a VM e configurar o Worker de embeddings
Nesta etapa, você autorizará esta VM recém-criada e configurará um Worker descartável. O login no Dashboard pertence ao seu navegador; o Wrangler nesta VM ainda precisa de uma autorização própria e limitada.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/search-embeddings
npx wrangler --version
O resultado esperado é 4.132.0. Solicite as permissões restritas usadas nos laboratórios anteriores do Workers AI. A permissão de KV dá suporte à verificação de dependência de limpeza do Wrangler 4.132.0; este laboratório não cria dados no KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra o link exibido, informe o código atual, confira a conta e as permissões e autorize sua conta de aprendizagem. Em seguida, examine os dados estruturados de identidade:
npx wrangler whoami --json
Confirme loggedIn: true e gere um nome exclusivo para o Worker:
RUN="labex-c07-a04-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Substitua YOUR_ACCOUNT_ID pelo ID real da conta pretendida:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
env.AI é um binding em processo, não uma chave de API do modelo no código-fonte. remote: true significa que o desenvolvimento local ainda chama o modelo associado à conta.
Entender o contrato do vetor
Nesta etapa, você relacionará a configuração do modelo aos números que a aplicação precisa validar.
Gere os tipos do ambiente e confirme o binding da plataforma:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Procure AI: Ai. O modelo BGE Small selecionado retorna um vetor de 384 dimensões para cada texto de entrada. Dimensão significa quantidade de posições; portanto, um lote com quatro textos deve ter o formato [4, 384]. Cada posição precisa ser um número finito: não pode ser NaN, infinito positivo ou infinito negativo.
Este laboratório solicita explicitamente o pooling cls. Pooling é a forma como o modelo condensa as informações no nível dos tokens em um único vetor. Vetores criados com pooling cls e mean não são compatíveis, mesmo quando ambos têm 384 posições; por isso, a aplicação registra essa escolha junto com o modelo e as dimensões.
Examine os fixtures determinísticos fornecidos:
grep -nE 'incompatible|non-finite|cosine similarity' test/worker.test.mjs
Esses fixtures tornam os testes de falha repetíveis sem gastar Neurons. Eles também evitam verificar uma pontuação exata de similaridade em tempo real, que pode mudar de acordo com o comportamento do modelo.
Criar o endpoint de similaridade validado
Nesta etapa, você implementará a solicitação de embeddings, a validação dos vetores e a comparação local por similaridade de cosseno. O Worker retorna IDs de documentos e pontuações, não os 1.536 números brutos dos quatro vetores.
Crie o ponto de entrada:
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const DIMENSIONS = 384;
const POOLING = "cls";
const MAX_QUERY = 300;
const DOCUMENTS = [
  { id: "password-reset", text: "Reset a forgotten password and regain account access." },
  { id: "upload-pdf", text: "Troubleshoot a PDF document that will not upload." },
  { id: "billing-receipt", text: "Download a receipt for a completed payment." }
];

export function validateEmbeddingBatch(result, expectedCount) {
  if (!Array.isArray(result?.shape) || result.shape[0] !== expectedCount || result.shape[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding shape");
  }
  if (!Array.isArray(result.data) || result.data.length !== expectedCount) {
    throw new Error("incompatible embedding count");
  }
  for (const vector of result.data) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return result.data;
}

export function cosineSimilarity(left, right) {
  if (left.length !== right.length || left.length === 0) throw new Error("incompatible vectors");
  let dot = 0, leftNorm = 0, rightNorm = 0;
  for (let index = 0; index < left.length; index += 1) {
    dot += left[index] * right[index];
    leftNorm += left[index] ** 2;
    rightNorm += right[index] ** 2;
  }
  if (leftNorm === 0 || rightNorm === 0) throw new Error("zero-length direction");
  return dot / (Math.sqrt(leftNorm) * Math.sqrt(rightNorm));
}

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuery(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const query = typeof body?.query === "string" ? body.query.trim() : "";
  if (!query) return { error: json({ error: "invalid_query" }, 400) };
  if (query.length > MAX_QUERY) return { error: json({ error: "query_too_large" }, 413) };
  return { query };
}

async function search(request, env) {
  const parsed = await readQuery(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let result;
  try {
    result = await env.AI.run(MODEL, { text: [parsed.query, ...DOCUMENTS.map((item) => item.text)], pooling: POOLING });
  } catch {
    console.error(JSON.stringify({ event: "embedding_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let vectors;
  try { vectors = validateEmbeddingBatch(result, DOCUMENTS.length + 1); }
  catch {
    console.error(JSON.stringify({ event: "embedding_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_embeddings", requestId }, 502);
  }
  const [queryVector, ...documentVectors] = vectors;
  const matches = DOCUMENTS.map((document, index) => ({ id: document.id, score: cosineSimilarity(queryVector, documentVectors[index]) }))
    .sort((left, right) => right.score - left.score);
  console.log(JSON.stringify({ event: "embedding_compared", requestId, model: MODEL, dimensions: DIMENSIONS, count: vectors.length, pooling: POOLING }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, matches, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/search") return search(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
A validação é executada antes da similaridade. Ela evita truncamentos silenciosos, comparações sem sentido entre dimensões diferentes e pontuações NaN. Os logs mantêm os metadados do ciclo de vida, mas omitem a consulta, o texto dos artigos e os vetores.
Execute os cinco testes determinísticos e depois gere o bundle sem fazer a implantação:
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
Os testes comprovam a matemática local e o comportamento de rejeição. A execução simulada comprova que o Worker e a configuração do binding são agrupados corretamente.
Executar um lote real de embeddings
Nesta etapa, você executará o handler localmente enquanto o binding de IA realiza uma solicitação remota real de embeddings.
Inicie o Wrangler em segundo plano e aguarde a rota de saúde que não usa IA:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
Envie uma consulta sintética curta:
curl --silent --show-error http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
A resposta esperada contém model, dimensions: 384, pooling: "cls", três IDs classificados e pontuações finitas. Não exija pontuações exatas. A ordenação é uma evidência baseada nesta consulta, não uma garantia permanente do modelo.
Rejeite uma consulta vazia antes da inferência:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' --data '{"query":""}'
O resultado esperado é {"error":"invalid_query"} e HTTP 400.
Implantar e examinar as evidências dos embeddings
Nesta etapa, você implantará o mesmo endpoint e relacionará as evidências de execução ao Cloudflare Dashboard.
Pare somente o processo de desenvolvimento salvo e faça a implantação:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Salve a URL exata exibida pelo Wrangler e envie uma consulta pública:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/search" \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
Confirme que a resposta registra o modelo, 384 dimensões e o pooling cls, e classifica exatamente os três IDs fornecidos com pontuações finitas.
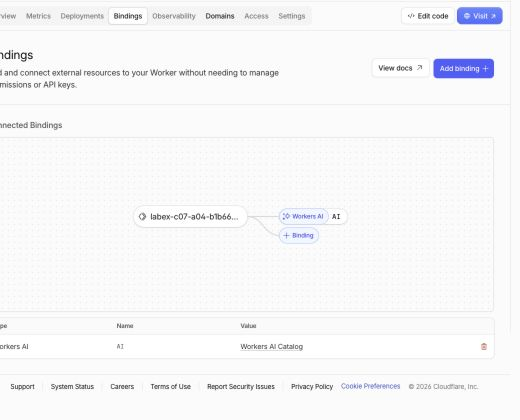
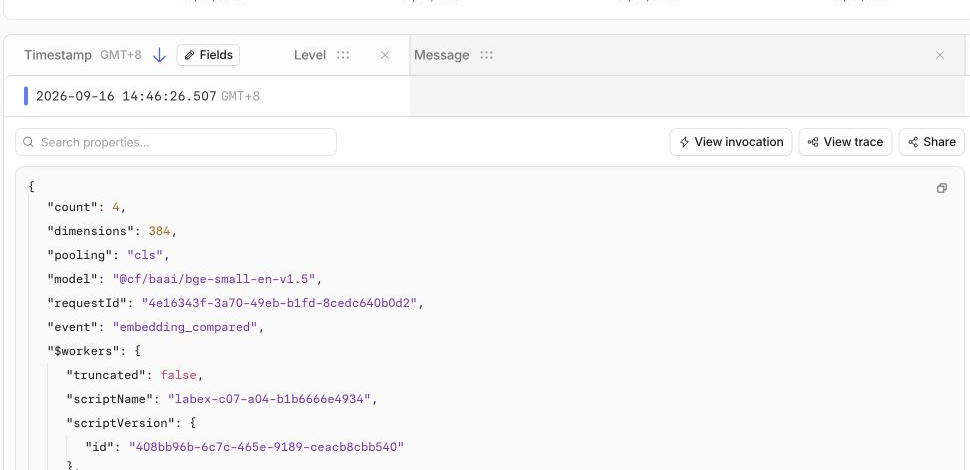
Abra Workers & Pages → Overview → seu Worker labex-c07-a04-.... Em Bindings, examine o binding AI. Em Observability → Logs, pesquise embedding_compared e expanda o evento. Confirme o modelo exato, dimensions: 384, count: 4, pooling: cls e um ID de solicitação. A consulta, os documentos e os vetores devem estar ausentes.
A página Bindings torna a conexão visível: o Worker tem um binding do Workers AI chamado AI. Um binding é o identificador seguro usado pelo seu código como env.AI; você não cola uma chave de API no arquivo-fonte.
A visão geral de Observability mostra solicitações /search bem-sucedidas e nenhum erro nesta execução descartável. Seus totais exatos podem ser diferentes, pois cada solicitação de teste se torna um evento.
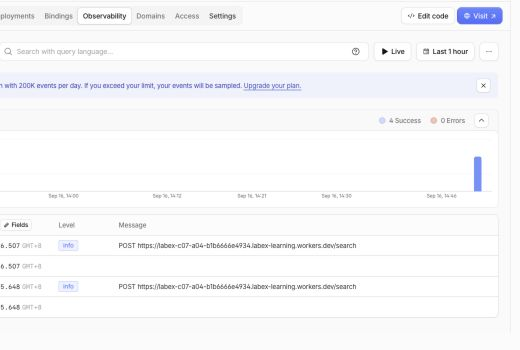
Expanda um evento embedding_compared. Este exemplo focado registra apenas fatos operacionais úteis: quatro textos foram comparados, cada vetor tinha 384 dimensões, foi usado o pooling cls e o modelo era @cf/baai/bge-small-en-v1.5. Ele deliberadamente não registra a consulta do aluno, o texto dos documentos nem centenas de números dos vetores.
Depois, abra Workers AI. Encontre o modelo BGE Small no uso de hoje e confirme que a execução limitada continua dentro da alocação gratuita compartilhada de 10.000 Neurons. A atualização do Dashboard pode atrasar; aguarde brevemente em vez de repetir a inferência para forçar a atualização do gráfico.
Na conta Free testada, o modelo de embeddings usou apenas 0.29 Neurons, enquanto o uso total foi de 295.6 / 10k. O total maior inclui outros testes do curso realizados no mesmo dia; portanto, trate esses números como exemplo, não como resultado obrigatório. O ponto de verificação importante é que a linha BGE Small apareça e que seu total diário permaneça abaixo da alocação Free.
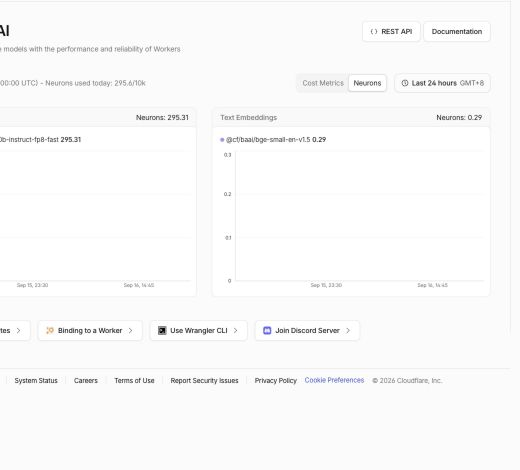
Os gráficos do Dashboard são um ponto de verificação visual útil, mas a resposta JSON e o script de verificação independente continuam sendo as evidências oficiais de que o Worker implantado funciona corretamente.
Remover o Worker e sair da conta
Nesta etapa, você removerá o endpoint descartável e depois removerá a autorização desta VM. O uso do Workers AI faz parte do histórico da conta; portanto, excluir o Worker não apaga o registro de uso.
Exclua o Worker exato definido em wrangler.jsonc:
npx wrangler delete
Confirme somente quando o Wrangler mostrar o nome exclusivo labex-c07-a04-... deste laboratório. Exija a mensagem Successfully deleted e execute a verificação independente de ausência na nuvem enquanto ainda estiver autorizado:
python3 .labex/verify.py deleted
Somente depois que o comando informar PASS: deleted, saia da conta e examine o estado estruturado:
npx wrangler logout
npx wrangler whoami --json
Exija loggedIn: false. Uma aba do navegador fechada ou a ausência de um arquivo local não comprovaria a limpeza na nuvem.
Resumo
Você gerou embeddings de 384 dimensões com um modelo hospedado pela Cloudflare, registrou as escolhas de compatibilidade, validou cada vetor, comparou a direção semântica usando a similaridade de cosseno e rejeitou dados incompatíveis antes da classificação. Você também verificou o binding ativo e os logs com privacidade limitada e, em seguida, removeu o Worker descartável e a autorização da VM.