Introdução
Normalmente, uma aplicação segue regras escritas diretamente no código. A inferência de inteligência artificial (AI) adiciona um tipo diferente de operação: sua aplicação envia uma entrada para um modelo treinado, e o modelo gera um resultado. A instrução e o contexto enviados ao modelo são chamados de prompt. O texto gerado pode variar entre as solicitações. Por isso, uma aplicação confiável controla a entrada e verifica o resultado, em vez de esperar uma frase exatamente igual.
O Cloudflare Workers AI permite que um Worker execute modelos de AI compatíveis por meio da plataforma da Cloudflare. Um Worker é um código de aplicação que responde a solicitações na rede da Cloudflare. Um binding de AI é a conexão configurada que disponibiliza o Workers AI para esse código como env.AI; assim, não é necessário colocar uma chave de API separada de outro provedor no projeto.
Neste laboratório, uma aplicação de suporte precisa de um resumo curto de um ticket antes que um agente abra a descrição completa. Você configurará um binding de AI, implementará um endpoint POST /summaries, rejeitará entradas inadequadas antes de consumir inferência, testará o mesmo Worker localmente, fará a implantação e inspecionará a atividade real do Worker e da AI no Cloudflare Dashboard. O laboratório usa @cf/meta/llama-3.3-70b-instruct-fp8-fast, um modelo hospedado pela Cloudflare e disponível na alocação gratuita padrão do Workers AI. O texto da resposta não é avaliado; o contrato da aplicação é.
Antes de iniciar este curso, conclua Connect LabEx to Your Cloudflare Account. Esse laboratório ensina a usar o terminal da VM do LabEx, a autorização do dispositivo, a confirmação da conta e o salvamento do ID real da conta. Você também deve saber como um pequeno Worker JavaScript processa uma solicitação HTTP. Não é necessário conhecimento de aprendizado de máquina.
Atualmente, o Workers AI fornece às contas Workers Free uma alocação diária compartilhada de 10.000 Neurons, a unidade da Cloudflare para computação de modelos. Este laboratório mantém os prompts e a saída pequenos e não exige um plano pago, mas outras atividades na mesma conta usam a mesma alocação. Consulte a página do modelo Llama 3.3 e os preços do Workers AI atuais antes de começar. Se a alocação diária já tiver sido usada, a inferência falhará até que o limite seja redefinido; não faça chamadas repetidas para contornar esse limite. O desenvolvimento local do Workers AI também usa o modelo na nuvem e conta para a alocação — não é uma simulação offline.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/ticket-summary. Ela também fornece testes determinísticos que imitam a resposta da AI sem fazer chamadas ao modelo. A configuração não faz login, altera o plano, implanta nada nem executa inferência. Mantenha esta VM aberta até que o Worker descartável seja excluído e o logout seja confirmado.
Autorizar a VM e selecionar uma conta
Nesta etapa, você conectará esta VM nova do LabEx à sua conta de aprendizado da Cloudflare e criará uma configuração exclusiva de Worker. Uma sessão do navegador no Dashboard não autoriza automaticamente os comandos do terminal na VM.
Entre no projeto preparado e confirme a versão fixada do Wrangler:
cd /home/labex/project/ticket-summary
npx wrangler --version
O resultado esperado é 4.132.0. Inicie a autorização do dispositivo usando apenas as permissões necessárias para este laboratório. workers_scripts:write permite implantar, ler e excluir o Worker descartável. ai:write permite que o Worker invoque o Workers AI. O Wrangler 4.132.0 também verifica referências a bindings do KV ao excluir um Worker. Por isso, workers_kv:write permite concluir essa verificação de limpeza, embora este laboratório não crie nenhum namespace do KV. O acesso de leitura à conta e ao usuário permite confirmar a conta correta.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra no navegador o link exibido, informe o código atual do dispositivo, confira as permissões e selecione sua conta de aprendizado. O Background Access também pode aparecer, pois o Wrangler precisa continuar funcionando depois do fluxo no navegador. Autorize somente depois que a conta e a lista de permissões corresponderem a este laboratório. Em seguida, volte ao terminal e aguarde a confirmação de sucesso.
npx wrangler whoami --json
Confirme loggedIn: true e leia name e id da conta que você pretende usar, mesmo que apenas uma conta seja exibida. O nome ajuda a evitar o uso da conta errada; o ID é o valor estável que o Wrangler salva na configuração.
Gere um nome exclusivo para o Worker. openssl rand -hex 6 cria 12 caracteres hexadecimais aleatórios, e $(...) insere esses caracteres na variável do shell.
RUN="labex-c07-a01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Copie o ID da conta selecionada para a configuração abaixo, substituindo YOUR_ACCOUNT_ID. Um here-document grava em wrangler.jsonc as linhas entre os dois marcadores JSON. O marcador sem aspas permite a expansão de $RUN, enquanto a barra invertida mantém a chave $schema literal.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
compatibility_date fixa o comportamento do runtime testado por este laboratório. observability mantém os registros de invocação e da aplicação para a verificação posterior no Dashboard. Gravar o arquivo não implanta um Worker nem faz uma chamada ao modelo.
Inspecionar o binding do Workers AI
Nesta etapa, você transformará a configuração em uma descrição tipada do ambiente do Worker e conectará o nome do binding ao código que escreverá a seguir.
Um binding é uma capacidade nomeada fornecida pelo runtime do Workers. O nome AI em wrangler.jsonc significa que o Worker usará env.AI para executar modelos. Não há token de API no código-fonte: a Cloudflare conecta o Worker implantado à conta selecionada. A configuração remote: true é importante durante wrangler dev, pois a inferência do modelo sempre acontece na Cloudflare, mesmo quando o próprio manipulador da solicitação é executado nesta VM.
Gere a descrição dos tipos do ambiente a partir da configuração do projeto:
npx wrangler types
O Wrangler cria worker-configuration.d.ts. Procure a entrada Env gerada em vez de ler o arquivo inteiro:
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
A saída inclui um binding de AI semelhante a:
interface __BaseEnv_Env {
    AI: Ai;
}
O Wrangler coloca os bindings gerados em uma interface base e depois a estende com Env. A linha AI: Ai é a verificação de consistência útil: se você alterar o nome do binding na configuração e esquecer de atualizar o código, a implantação poderá ser concluída, mas falhará em runtime. Gere novamente os tipos sempre que os bindings forem alterados. Uma simulação completa de implantação validará mais tarde essa configuração e o bundle do Worker em conjunto.
Criar um endpoint de resumo com limites
Nesta etapa, você implementará o limite da solicitação e a chamada ao modelo. Um modelo de linguagem é bom em gerar uma explicação compacta, mas não deve decidir se uma solicitação arbitrária é segura para processar. O código comum da aplicação deve rejeitar o tipo de conteúdo incorreto, JSON malformado, detalhes ausentes e entradas grandes demais antes da inferência.
O endpoint enviará duas mensagens ao modelo. Uma mensagem do sistema define o papel do modelo e a restrição da resposta. Uma mensagem do usuário contém o ticket sintético. Os modelos leem e geram tokens, pequenos fragmentos de texto que podem ser uma palavra, parte de uma palavra ou pontuação. max_tokens limita a saída gerada, enquanto a aplicação limita separadamente o número de caracteres recebidos. Esses são controles diferentes: um limita o que você envia, e o outro limita o que o modelo pode gerar. temperature controla o grau de variação que o modelo pode usar; o valor baixo utilizado aqui favorece um resumo estável, sem prometer um texto idêntico.
Crie o entrypoint do Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_DETAILS = 2000;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readTicket(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 4096) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const subject = typeof body?.subject === "string" ? body.subject.trim() : "";
  const details = typeof body?.details === "string" ? body.details.trim() : "";
  if (!details) {
    return { error: json({ error: "invalid_ticket" }, 400) };
  }
  if (subject.length > 120 || details.length > MAX_DETAILS) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }
  return { ticket: { subject, details } };
}

async function summarize(request, env) {
  const requestId = crypto.randomUUID();
  const parsed = await readTicket(request);
  if (parsed.error) return parsed.error;

  try {
    const result = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Summarize this support ticket in one plain sentence. Do not invent facts."
        },
        {
          role: "user",
          content: `Subject: ${parsed.ticket.subject || "(none)"}\nDetails: ${parsed.ticket.details}`
        }
      ],
      max_tokens: 120,
      temperature: 0.2
    });

    const summary = result.response?.trim();
    if (!summary) throw new Error("empty model response");

    console.log(JSON.stringify({
      event: "ticket_summarized",
      requestId,
      model: MODEL,
      inputCharacters: parsed.ticket.details.length,
      totalTokens: result.usage?.total_tokens ?? null
    }));

    return json({ summary, model: MODEL, requestId });
  } catch (error) {
    console.error(JSON.stringify({
      event: "ticket_summary_failed",
      requestId,
      model: MODEL,
      reason: error instanceof Error ? error.message : "unknown"
    }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/summaries") {
      return summarize(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Cada solicitação recebe um ID de solicitação aleatório que aparece tanto na resposta quanto no log. Assim, é possível rastrear uma solicitação sem registrar o ticket. O código registra esse ID, o modelo escolhido e as contagens, mas não o texto do ticket. Isso torna a observabilidade — os registros que ajudam você a entender o que o Worker fez — útil sem copiar o conteúdo do cliente para os dados de monitoramento. O código também valida a string response retornada por este modelo específico, em vez de presumir que todos os modelos do Workers AI retornam o mesmo objeto.
Execute os testes determinísticos fornecidos. Eles substituem env.AI por um pequeno fixture, portanto não consomem uso do modelo:
node --test test/worker.test.mjs
Espere quatro testes aprovados. Em seguida, peça ao Wrangler para criar o bundle do Worker sem implantá-lo:
npx wrangler deploy --dry-run
Os testes comprovam os contratos de entrada e saída usando dados controlados do modelo. A simulação comprova que o Wrangler consegue criar o bundle do Worker real. Nenhuma das duas verificações comprova que o modelo está disponível no momento ou que esta conta ainda tem alocação gratuita diária; você verificará isso a seguir com uma solicitação real.
Executar uma inferência local
Nesta etapa, você executará o manipulador de solicitações a partir da VM, enquanto o binding AI chama o modelo real hospedado pela Cloudflare. Isso é chamado de desenvolvimento local, mas somente o processo do Worker é local; a inferência é remota e contabilizada.
Inicie o Wrangler na porta 8787 em segundo plano. > salva os logs em um arquivo, 2>&1 envia os erros para o mesmo arquivo e & devolve o prompt do terminal enquanto o servidor continua em execução. Salvar $! registra o ID do processo para a limpeza posterior.
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Aguarde até que a rota de verificação responda:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
A resposta de verificação deve ser {"status":"ok"} e não chama o modelo. Agora envie um ticket sintético pequeno. --data transforma a solicitação em POST, enquanto o cabeçalho informa ao Worker que ele deve analisar JSON.
curl --silent --show-error http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Invoice upload fails","details":"After signing in, the customer selects a PDF invoice. The upload stops before completion and no confirmation appears."}' | jq
Espere um summary não vazio, o ID exato do modelo e um requestId específico desta execução. Sua frase pode ser diferente deste exemplo:
{
  "summary": "The customer cannot complete a PDF invoice upload after signing in.",
  "model": "@cf/meta/llama-3.3-70b-instruct-fp8-fast",
  "requestId": "..."
}
Comprove que uma entrada inválida é rejeitada pelo código comum antes da inferência:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"details":""}'
Espere {"error":"invalid_ticket"} e HTTP 400. A aplicação não envia essa solicitação ao modelo. Se a solicitação válida retornar model_unavailable, inspecione .labex/dev.log; alocação gratuita esgotada, capacidade do modelo ou erro de autorização não comprovam que o contrato do endpoint foi aprovado.
Implantar e inspecionar o Worker de AI
Nesta etapa, você interromperá o processo local, implantará o mesmo código na Cloudflare e relacionará as evidências da linha de comando ao estado visível no Dashboard.
Interrompa somente o processo de desenvolvimento salvo e aguarde seu encerramento:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Implante o Worker:
npx wrangler deploy
O Wrangler exibirá a URL pública workers.dev. Salve exatamente essa URL, substituindo o valor de exemplo abaixo:
WORKER_URL="https://YOUR_WORKER_URL"
Envie um novo ticket sintético ao endpoint implantado:
curl --silent --show-error "$WORKER_URL/summaries" \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Password reset loop","details":"The customer opens the reset email, chooses a new password, and returns to the sign-in page, but the old password remains active."}' | jq
A frase gerada pode ser diferente, mas model deve identificar o Llama 3.3 e requestId deve estar presente. Isso comprova que o Worker público alcançou seu binding de AI configurado.
Abra o Cloudflare Dashboard e acesse Workers & Pages → Overview → seu Worker labex-c07-a01-... → Settings → Bindings. Localize o binding do Workers AI chamado AI. Essa é a conexão visível entre wrangler.jsonc e env.AI no código.
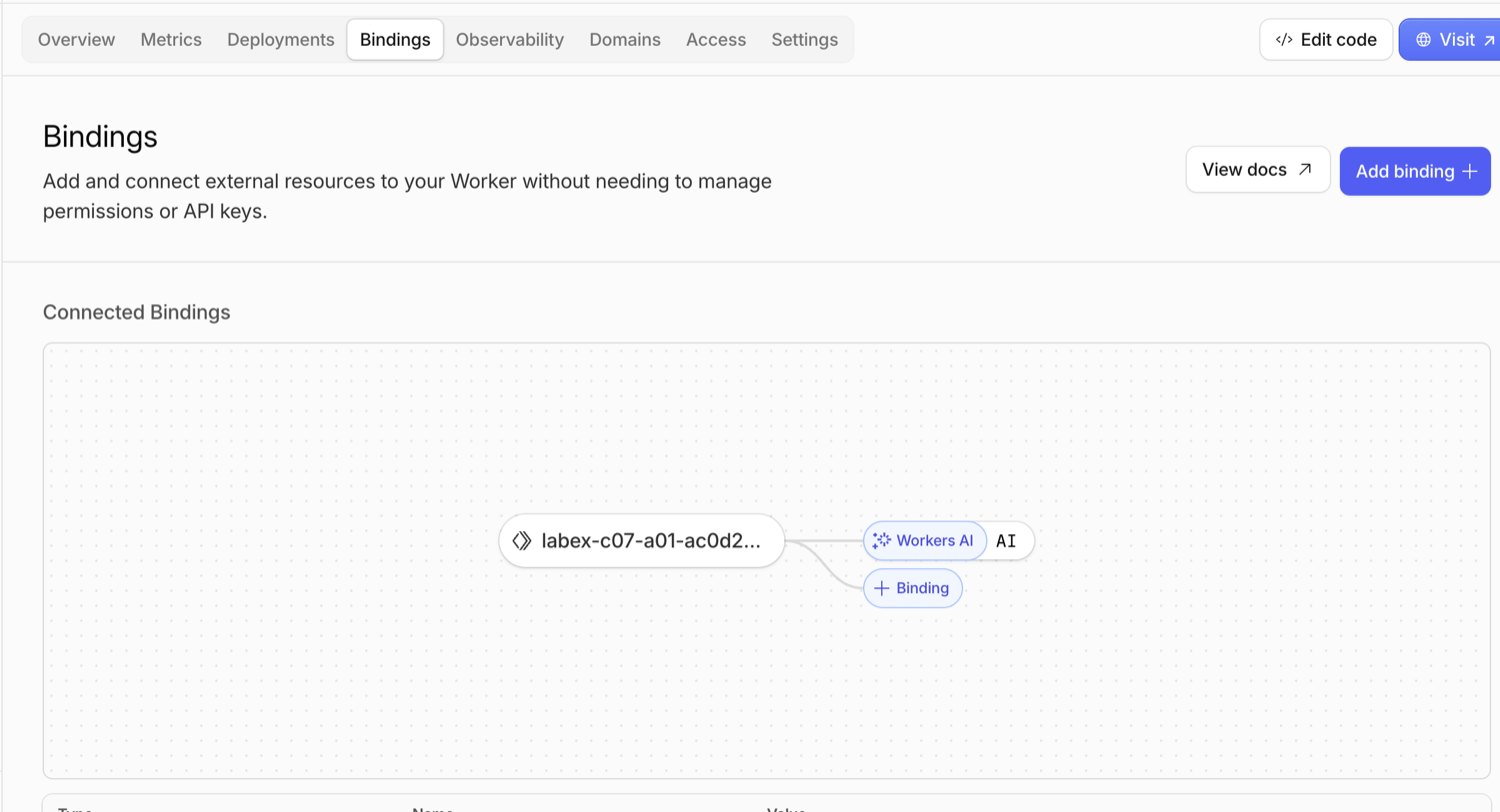
O exemplo mostra o nome do binding AI, que corresponde ao nome usado por env.AI. O nome do seu Worker descartável será diferente.
Em seguida, abra Observability → Logs para o mesmo Worker. Localize uma invocação bem-sucedida recente e expanda o log estruturado ticket_summarized. Compare o ID da solicitação com o ID retornado pela resposta implantada. O log deve mostrar o modelo e as contagens sem mostrar o texto do ticket. Se os logs salvos ainda não tiverem chegado, use Real-time logs, envie outra solicitação sintética pequena e inspecione essa invocação.
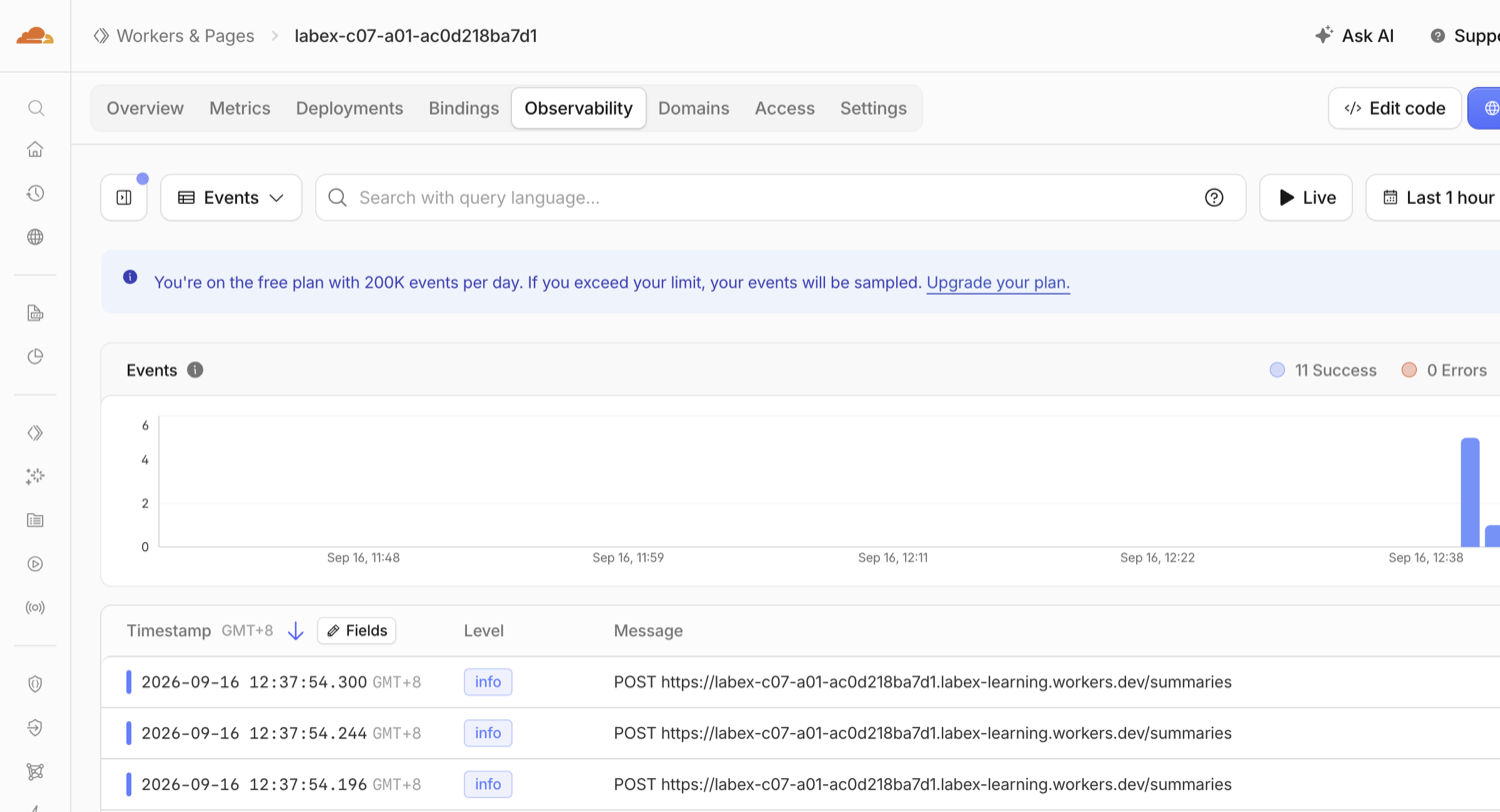
A visão geral confirma primeiro que as solicitações chegaram ao Worker sem erros. Ao abrir uma solicitação, você verá o evento estruturado da aplicação:
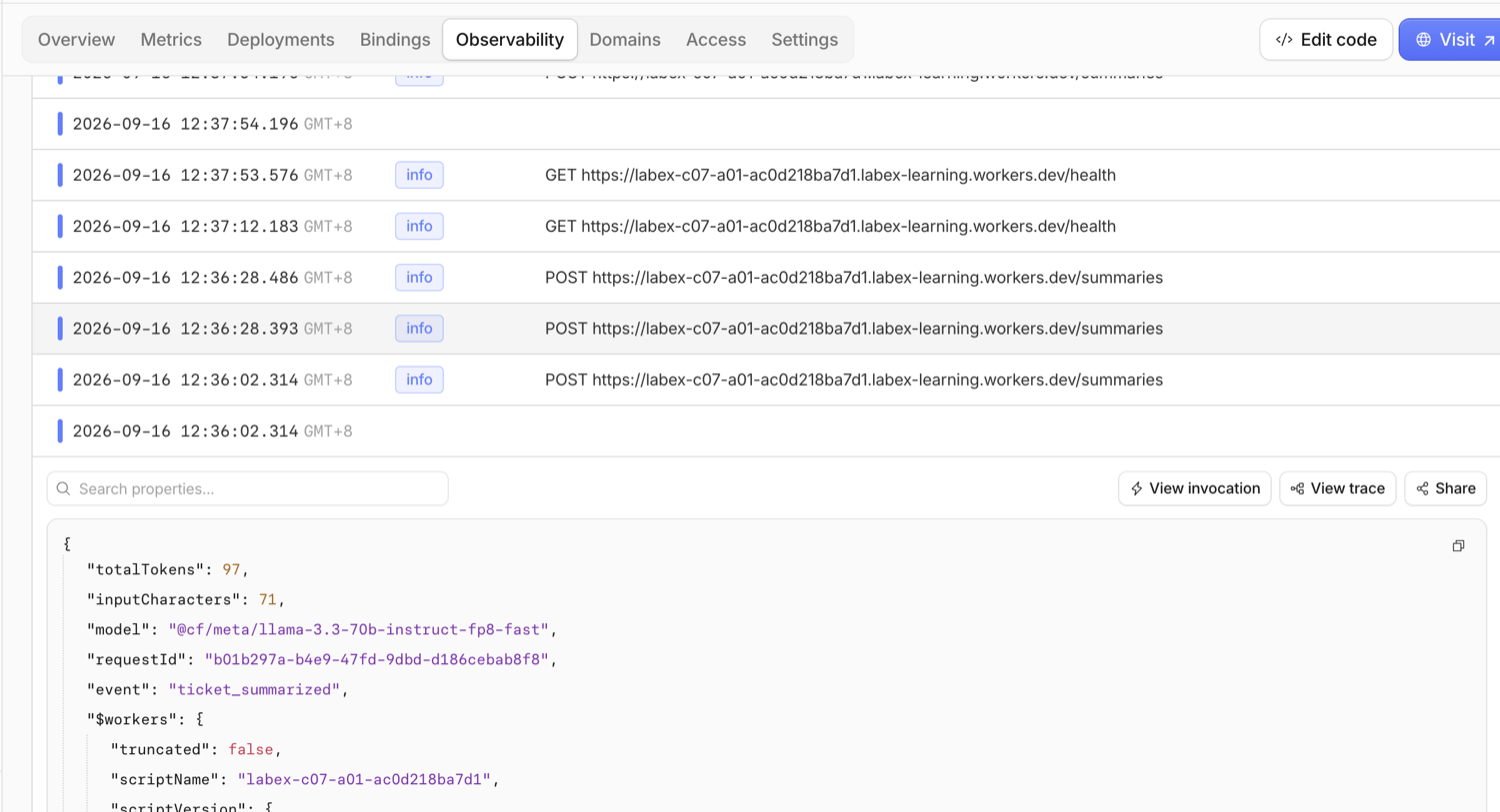
Observe que o log contém fatos operacionais, como o modelo, a contagem de tokens e o ID da solicitação, mas não contém o assunto nem os detalhes do ticket de suporte. Esse é o limite de privacidade criado pelo código de logging que você escreveu.
Por fim, abra Workers AI na navegação da Developer Platform e inspecione a visão de uso. Procure atividades recentes do modelo ou uso de Neurons associado a este teste com limites. Os dados de uso podem chegar depois da solicitação; um gráfico vazio imediatamente após a execução não é conclusivo e não deve ser “corrigido” gerando chamadas repetidas de inferência.
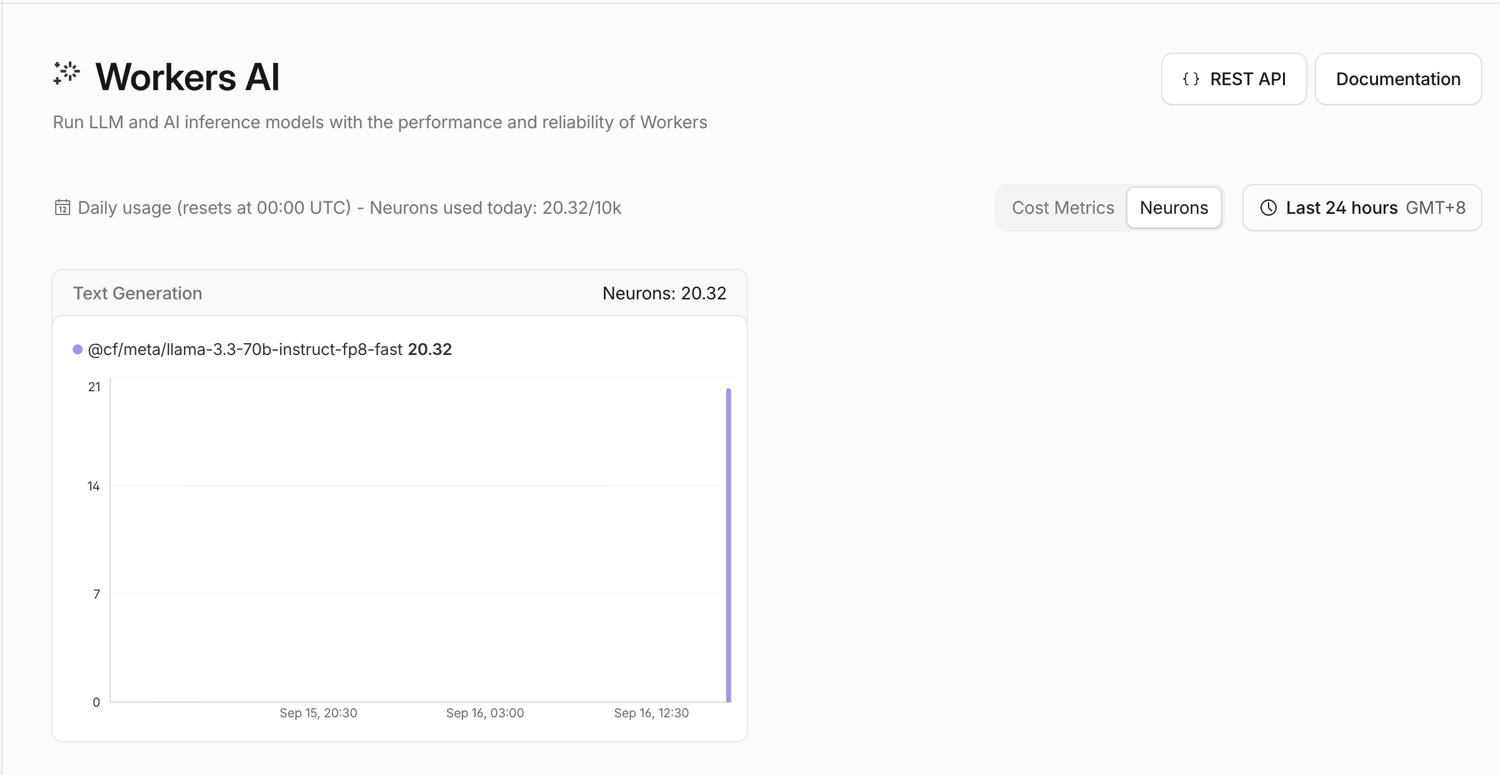
Aqui, 20.32/10k significa que esta execução de aceitação consumiu apenas uma pequena parte da alocação diária Free dessa conta. O total inclui qualquer outra atividade do Workers AI na sua conta de aprendizado, portanto não será igual ao da captura de tela.
As capturas de tela do Dashboard neste laboratório mostram valores de exemplo de uma execução de aceitação descartável. O nome do seu Worker, o ID da solicitação, os horários, as contagens de tokens e os totais de uso serão diferentes.
Remover o Worker e fazer logout
Nesta etapa, você removerá a aplicação descartável da nuvem e depois revogará a sessão do Wrangler nesta VM. Excluir o Worker interrompe seu endpoint público. Isso não altera seu plano do Workers nem apaga os registros de uso no nível da conta.
Exclua o Worker nomeado em wrangler.jsonc:
npx wrangler delete
Confirme a exclusão quando o Wrangler exibir o nome exclusivo deste laboratório. Não exclua nenhuma outra aplicação. No Dashboard, volte a Workers & Pages → Overview e confirme que o Worker exato labex-c07-a01-... não está mais presente. Logs históricos ou dados de uso podem permanecer depois que o script for excluído.
O Wrangler verifica se outro Worker depende deste antes de concluir. Por isso, o login anterior incluiu acesso de limpeza do KV, embora sua aplicação não tenha usado KV; uma exclusão bem-sucedida deve retornar ao prompt sem erro de autenticação.
Execute a verificação da exclusão enquanto a VM ainda estiver autorizada:
python3 .labex/verify.py deleted
Somente depois que o comando informar PASS: deleted, remova a autorização armazenada:
npx wrangler logout
npx wrangler whoami --json
A saída final deve informar loggedIn: false. Um erro de rede não comprova que o logout foi concluído.
Resumo
Você conectou um Worker a um modelo hospedado pela Cloudflare por meio de um binding de AI, limitou a entrada e a saída gerada, testou o comportamento determinístico antes de consumir o uso do modelo, executou inferência real localmente e após a implantação e relacionou a resposta às evidências de binding, logs e uso no Dashboard. Você também removeu o Worker descartável e desconectou a VM nova com segurança.