Introdução
A comparação das pessoas designadas à oficina dá à página B uma taxa de inscrição maior. A designação aleatória, por si só, pode produzir grupos aparentemente diferentes mesmo que a página não mude o resultado de ninguém? Uma pequena troca manual torna a pergunta concreta antes de gerar uma distribuição de diferenças realmente aleatórias.
Este ambiente independente já contém as funções corretas de resultados por pessoa e comparação de taxas ensinadas anteriormente, além dos próprios dados originais. Você deve conhecer essas ideias, funções Python, arrays NumPy básicos e os fundamentos de Matplotlib. Não precisa de arquivos de uma VM anterior nem de conhecimentos de inferência estatística. Você salvará 399 redesignações exploratórias e seu gráfico real; aqui não calculará um valor p nem escolherá um vencedor. Todos os registros são exemplos didáticos sintéticos originais. Os 55 minutos são uma estimativa do autor que inclui leitura e correções comuns.
Troque pessoas sem mudar os tamanhos dos grupos
Nesta etapa, você calculará uma diferença com seis pessoas, trocará duas associações a grupos e verá por que a comparação pode mudar.
No WebIDE, abra Terminal → New Terminal e entre no diretório desta unidade:
cd /home/labex/project/signup-experiment
cat lê arquivos sem modificá-los. Releia os cartões do exemplo e as duas funções preparadas:
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
Os seis cartões têm resultados binários [1, 0, 0] em A e [1, 1, 0] em B. Cada 1 ou 0 pertence a uma pessoa designada; eventos repetidos não são observações extras. A tem 1/3 de inscritos, B tem 2/3 e B−A é aproximadamente +33.33 pontos percentuais.
Imagine trocar a associação da segunda pessoa de A (resultado 0) com a primeira de B (resultado 1). A passa a [1, 1, 0], B a [0, 1, 0] e a diferença fica perto de −33.33 pontos percentuais. Cada grupo ainda tem três pessoas e continuam existindo três resultados positivos no total. Você mudou a designação, não os resultados individuais nem o tamanho da amostra.
Escreva a função de diferença. np.mean calcula a média dos valores binários de um array NumPy. Subtrair a média de A da média de B e depois multiplicar por 100 dá pontos percentuais. O esboço de sample_null será completado depois; definir uma função não a executa.
O > do shell substitui o arquivo. O here-document entre aspas <<'PY' copia o bloco completo até o PY final sem expansão do shell. Você também pode salvar o mesmo conteúdo com File → Save no WebIDE.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
A etapa contrast do executor fornece os cartões originais e exatamente a troca descrita, chama sua função duas vezes e salva os dois resultados reais:
python3 run.py contrast
O leitor mostra o resultado salvo sem reconstruí-lo:
python3 show_results.py contrast
Espere original_pp perto de +33.33 e swapped_pp perto de −33.33. Nenhum prevê o que aconteceria com uma pessoa real em outra página. Eles mostram como a composição dos grupos pode mudar a comparação enquanto os mesmos seis resultados permanecem fixos.
Você pode editar resample.py e depois plot.py, ou acrescentar arquivos auxiliares Python comuns ao lado. Preserve os CSVs originais, configurações, dicionário, executor e leitor. Se o diretório estiver errado, use pwd e ls, depois repita o cd acima. Copie novamente um bloco completo para corrigir um erro de edição; o setup recusa sobrescrever um diretório de trabalho existente.
Gere redesignações reais
Nesta etapa, você embaralhará repetidamente os resultados completos dos visitantes em grupos dos tamanhos originais e salvará cada diferença obtida.
Continue no mesmo terminal WebIDE, em /home/labex/project/signup-experiment. A amostra fixa completa tem 12 pessoas designadas, seis por grupo. A função preparada usa as janelas completas de sete dias. Leia as entradas reais completas se quiser localizar novamente as pessoas de fronteira e sem eventos:
cat assignments.csv
cat events.csv
Sob a hipótese nula de ausência de efeito usada neste exercício, a página designada não muda o resultado binário de ninguém. Redesignar esses resultados individuais fixos entre os dois grupos mostra, portanto, a variação esperada apenas da alocação. Essa hipótese depende do desenho de experimento aleatorizado representado pelos registros sintéticos. Embaralhar um log observacional arbitrário de um site não criaria um experimento aleatorizado.
np.concatenate([a, b]) reúne os dois arrays. np.random.default_rng(seed) cria um gerador pseudoaleatório com estado inicial reproduzível. Seu método permutation devolve uma cópia embaralhada, mantendo intacto o original reunido. A fatia shuffled[:len(a)] pega a primeira parte do tamanho de A; shuffled[len(a):] pega a parte restante do tamanho de B. Cada pessoa é usada uma vez por sorteio e ambos os tamanhos são preservados. Não embaralhe as linhas brutas de eventos repetidos.
Substitua o arquivo pelas duas funções completas. O laço for realiza a quantidade de sorteios solicitada; append mantém cada diferença calculada. Devolver um array preserva a amostra inteira, em vez de apenas a média ou um sorteio favorável.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
O executor chama essas funções na amostra completa por pessoa e salva os tamanhos reais dos grupos, a diferença observada e 399 diferenças embaralhadas. --seed fornece o estado inicial reproduzível; os dois hífens indicam uma opção nomeada do comando.
python3 run.py sample --seed 17
python3 show_results.py sample
Os dados completos ainda têm 1 de 6 inscritos em A e 5 de 6 em B, uma diferença observada próxima de +66.67 pontos percentuais. null_count deve ser 399. O leitor mostra apenas os oito primeiros sorteios como null_preview para limitar a exibição; o array completo está salvo em output/sample.json.
Gere uma segunda amostra comum para entender por que uma semente não é uma resposta obrigatória de referência:
python3 run.py sample --seed 42
python3 show_results.py sample
Isso substitui a amostra salva pela execução real com semente 42. A sequência geralmente muda, enquanto os resultados individuais originais, os tamanhos dos grupos e a comparação observada permanecem iguais. Reutilizar a mesma semente deve reproduzir a mesma sequência. Qualquer semente não negativa reproduzível e implementação equivalente de sorteios independentes são permitidas; não se exige a sequência do autor. Não repita continuamente para achar uma amostra que pareça favorecer uma página. A análise exata posterior usa todas as alocações, não a amostra exploratória mais bonita.
Toda estatística embaralhada fica entre −100 e +100 pontos percentuais, embora nem todo número do intervalo seja atingível. Para o exemplo de seis pessoas, as 20 alocações distintas de três contra três dão contagens 1, 9, 9, 1 nas diferenças −100, −100/3, +100/3, +100. A amostra completa de 12 pessoas tem 924 alocações: suas contagens são 1, 36, 225, 400, 225, 36, 1 em −100, −200/3, −100/3, 0, +100/3, +200/3, +100. O próximo laboratório faz o cálculo exato em vez de pedir que você memorize essas contagens.
Para esta tarefa exploratória de treinamento, a frequência amostral de cada diferença atingível pode se afastar da frequência exata de referência em até 0.15 de diferença absoluta de proporção. Por exemplo, 0.40 e 0.46 diferem em 0.06. É uma tolerância de aceitação didática deliberadamente ampla, não um intervalo de confiança, limiar de significância, garantia comercial ou critério para escolher sementes. Ela aceita amostras comuns e métodos independentes sem exigir arrays idênticos. Em um exemplo legítimo inteiramente nulo, toda diferença redesignada é zero; uma dispersão não nula não é obrigatória.
O contrato vale para os arrays binários fornecidos e as mesmas variações limitadas do curso: pelo menos duas pessoas em cada grupo e no máximo 14 no total. As verificações usam entradas e sementes isoladas, incluindo outros tamanhos, diferenças negativas e nulas e resultados degenerados. Nunca substituem a amostra existente. Nenhum valor p amostral é solicitado ou avaliado.
Trace as diferenças de alocação salvas
Nesta etapa, você exibirá a contagem amostral real de cada diferença e marcará a posição da comparação observada inalterada.
Continue no mesmo terminal WebIDE, em /home/labex/project/signup-experiment. np.unique(..., return_counts=True) devolve as diferenças salvas distintas e suas contagens. Este é um gráfico de contagens discretas: o eixo vertical informa quantas das 399 redesignações produziram cada diferença. Não é um intervalo de confiança do efeito.
A função gráfica recebe o resultado salvo e um caminho de saída. Para manter a leitura, o PNG deve ter pelo menos 500 × 250 pixels. figsize=(9, 4.5) define o tamanho em polegadas. DPI (dots per inch, pontos por polegada) determina a resolução raster salva: 140 pixels por polegada dão aproximadamente 9 × 140 por 4.5 × 140, ou 1260 × 630 pixels. subplots do Matplotlib cria a figura e os eixos. bar desenha contagens e axvline marca a diferença observada sem fingir que ela é outra contagem de alocações. Uma etiqueta e uma legenda visível identificam a marca. Limites horizontais fixos de −110 a +110 deixam espaço para toda diferença possível de taxas binárias, mesmo se um extremo não aparecer nesta amostra finita. O eixo vertical começa em zero; tight_layout reserva espaço para os rótulos antes de savefig gravar um PNG real.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Leia a amostra já salva e desenhe-a com sua função:
python3 run.py plot-sample
No explorador de arquivos do WebIDE, expanda signup-experiment/output e abra sample.png. Leia os dois rótulos dos eixos. A maioria das contagens deve se concentrar perto de uma diferença nula; a marca vermelha observada continua perto de +66.67 pontos percentuais. Um valor ausente da amostra tem contagem zero, não representa uma pessoa omitida. Os 399 sorteios e as 12 pessoas originais continuam representados nos dados salvos.
A imagem de referência abaixo usa o exemplo NumPy com semente 42 recém-executado. Outro amostrador ou semente permitido pode mudar as alturas das barras; seu arquivo deve mostrar seus próprios sorteios reais.
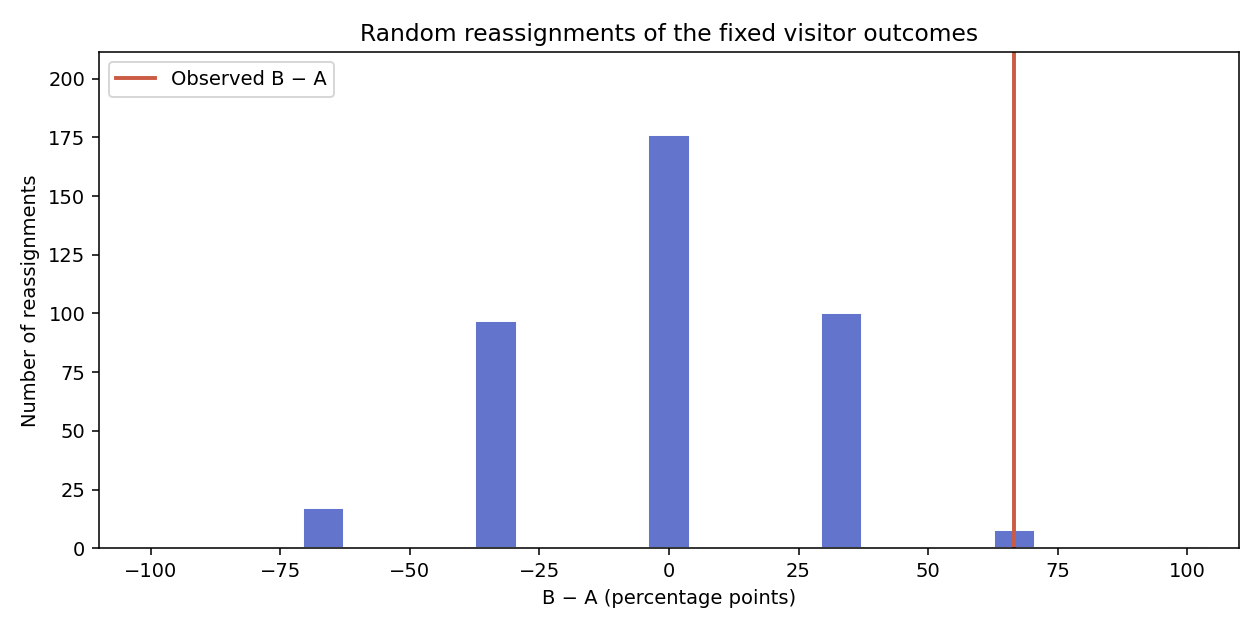
O PNG salvo deve ser reproduzível com a função gráfica atual e a amostra salva. Você pode usar barras legíveis, uma linha de contagens ou pontos nos valores reais das diferenças, com uma linha ou ponto visível rotulado Observed na diferença observada. Mantenha todas as diferenças possíveis e a marca observada dentro dos eixos exibidos, preserve a base zero de contagens e rotule ambos os eixos. Ocultar uma marca, cortar dados, copiar uma imagem alheia ou mostrar densidade com rótulo de contagem não completa a tarefa.
Se o PNG estiver ausente, primeiro confirme que python3 show_results.py sample consegue ler uma amostra salva, depois repita o comando gráfico. O leitor não gera arquivos ausentes. No próximo laboratório, você comparará uma distribuição exata de alocações com o resultado observado e aprenderá o que essas evidências dizem ou não dizem.
Resumo
Você trocou manualmente duas associações, gerou 399 redesignações reais com tamanhos fixos de grupos e traçou as diferenças salvas junto à comparação observada. Uma semente reproduzível permite repetir uma execução; não escolhe uma resposta ou página vencedora. Agora você tem a intuição necessária para ler as evidências exatas do próximo laboratório.