Introdução
Um gráfico exploratório de redesignações mostra como resultados individuais fixos podem produzir comparações diferentes entre grupos. Este laboratório continua a análise: conta cada alocação distinta da pequena amostra fixa, define com precisão um valor p bilateral e registra o que os dados sustentam.
As funções corretas por pessoa e de comparação já estão preparadas neste ambiente independente. Você deve conhecer as janelas individuais, diferenças em pontos percentuais e redesignações com tamanhos fixos dos laboratórios anteriores, além das bases de Python, NumPy e Matplotlib. Não precisa de arquivos de uma VM anterior nem de conhecimento prévio de valores p. Estes dados didáticos sintéticos originais não são um experimento comercial real; nem uma grande diferença observada nem um pequeno valor p garantem um resultado em produção. Os 55 minutos são uma estimativa do autor que inclui leitura e correções comuns.
Conte cada alocação distinta
Nesta etapa, você substituirá uma amostra aleatória finita pela distribuição completa de alocações e calculará seu valor p bilateral explicitamente definido.
Comece no WebIDE, abra Terminal → New Terminal e entre no diretório de trabalho:
cd /home/labex/project/signup-experiment
Leia as definições de origem e as configurações antes de ver o resultado do teste:
cat data-dictionary.md
cat config.json
A análise usa uma única amostra fixa com acompanhamento completo e um único resultado binário de inscrição por pessoa. A interpretação posterior usa alpha = 0.05, já escolhido. Alfa é um limiar convencional de comparação para este exercício, não uma probabilidade de 95% de a página funcionar. Ele não foi escolhido depois de buscar um resultado favorável. Não mude dados, instante de análise, limiar ou população após ver a comparação.
Sob a hipótese nula de ausência de efeito da página, o resultado de cada pessoa não mudaria conforme a página designada. O desenho aleatorizado representado permite então redistribuir esses resultados fixos, preservando os dois tamanhos de grupo. Essa inferência não se aplica automaticamente a um log observacional arbitrário não aleatório.
Uma distribuição exata de alocações inclui cada maneira distinta de distribuir as pessoas entre os dois grupos. A ordem dentro de um grupo não cria outra alocação para uma estatística baseada em médias. math.comb(n, k) do Python conta maneiras de escolher k pessoas entre n. Aqui, escolher as seis de A entre 12 também determina as seis de B.
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
Há 924 alocações neste experimento e no máximo 3432 em qualquer exemplo fornecido pelo curso. A enumeração exata é prática nesse tamanho deliberadamente pequeno; o método não promete enumerar amostras arbitrariamente grandes de produção.
Para a estatística B−A em pontos percentuais, este curso segue a convenção precisa two-sided do SciPy:
Primeiro, encontre a proporção de diferenças exatas menores ou iguais à observada. Separadamente, encontre a proporção de diferenças maiores ou iguais à observada. Dobre a menor dessas duas proporções e limite o resultado a 1.
Valores iguais pertencem às duas caudas respectivas. Este é um valor p bilateral definido; as definições não são universais. Contar abs(null) >= abs(observed) nem sempre é equivalente em uma distribuição discreta assimétrica. Por exemplo, um grupo A com duas pessoas e nenhuma inscrição e um grupo B com cinco pessoas e duas inscrições têm +40 pontos observados. Suas 21 alocações dão −100 uma vez, −30 dez vezes e +40 dez vezes. O valor p definido é 2 * 10 / 21 = 20/21; a proporção da cauda absoluta seria 11/21. Nem o agrupamento nem a definição podem ser alterados silenciosamente para obter um número menor.
Use a interface preparada permutation_test do SciPy. permutation_type="independent" redistribui observações entre grupos independentes, preservando seus tamanhos; não trata os visitantes como medições pareadas. vectorized=False significa que a estatística recebe arrays unidimensionais comuns. n_resamples=np.inf solicita toda a distribuição finita, em vez de 399 sorteios aleatórios. alternative="two-sided" seleciona a convenção acima. Não é necessária semente aleatória para esta enumeração exata.
A seleção DataFrame .loc[mask, "signed_up"] seleciona a coluna para as pessoas correspondentes; .to_numpy() transforma seus valores em um array NumPy unidimensional. A função interna statistic usa a mesma fórmula de diferença do laboratório anterior e está inteiramente definida aqui, portanto esta unidade não depende de resample.py de outra VM.
result.statistic, result.pvalue e result.null_distribution são as quantidades realmente calculadas. Preserve os valores não arredondados; .tolist() transforma o array em uma lista compatível com JSON, sem remover diferenças repetidas de alocações distintas.
O > do shell substitui um arquivo; o here-document entre aspas <<'PY' copia o bloco completo até o PY final sem expansão do shell. Você também pode editar no WebIDE e usar File → Save.
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
A etapa distribution do executor chama sua análise e salva os resultados reais sem ainda exigir uma função de interpretação:
python3 run.py distribution
O leitor exibe os dados existentes e omite o array longo apenas na exibição do terminal:
python3 show_results.py exact
Espere 12 pessoas, uma inscrição entre as seis de A e cinco entre as seis de B, diferença observada próxima de +66.67 pontos, null_count de 924 e p perto de 0.08009. A distribuição completa permanece em output/analysis.json. O campo de interpretação será acrescentado na próxima etapa.
Você pode editar inference.py e plot.py ou acrescentar auxiliares Python comuns ao lado. Preserve os CSVs originais, configurações, dicionário, executor e leitor. Os outcomes.py e compare.py preparados implementam funções já ensinadas; equivalentes são aceitos se os contratos públicos DataFrame/objeto e resultados válidos permanecerem intactos. Verificações isoladas cobrem outros tamanhos limitados, direções opostas, diferenças nulas e resultados inteiramente nulos. Um valor p fixo ou uma distribuição fixa não é uma análise reutilizável.
Para um erro comum de caminho ou nome, use pwd e ls, repita o cd inicial e copie novamente o bloco completo. O setup não é uma ferramenta de recuperação de edição: recusa deliberadamente sobrescrever um diretório existente.
Separe evidência de certeza
Nesta etapa, você acrescentará uma regra transparente de interpretação que pode indicar qualquer direção ou evidência insuficiente.
Continue no mesmo terminal WebIDE, em /home/labex/project/signup-experiment. Um valor p descreve uma comparação sob a hipótese nula e o desenho de alocação escolhidos. Não é a probabilidade de a hipótese nula ser verdadeira, nem a probabilidade de não existir efeito da página, nem uma garantia sobre a próxima oficina.
Aqui, os cerca de +66.67 pontos observados parecem grandes, mas o valor p exato é aproximadamente 0.08009. Com esta pequena amostra fixa e alfa 0.05 pré-selecionado, o exercício relata evidência inconclusiva. Isso não prova que as páginas sejam idênticas. Significa que esse teste e essa amostra não fornecem o nível escolhido de evidência contra a hipótese nula.
Use estes rótulos explícitos de saída:
evidence_for_bquando p <= alpha e a diferença for positiva;evidence_for_aquando p <= alpha e a diferença for negativa;inconclusivenos demais casos, incluindo diferença nula.
A igualdade ao limiar pertence ao ramo de evidência: p == alpha satisfaz <=. Não arredonde p antes da comparação. São rótulos de uma análise limitada, não uma decisão comercial automática de implantação. Outro experimento válido pode apoiar A ou nenhuma página; nenhum rótulo é obrigado a favorecer B.
O >> do shell acrescenta ao arquivo existente em vez de substituí-lo. O bloco completo seguinte adiciona conclude abaixo de analyze; cole-o uma vez. Ao editar no WebIDE, acrescente a função ao final e salve. O and do Python exige ambas as condições antes de um ramo devolver seu rótulo.
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
Execute novamente a análise exata pela etapa de interpretação. Isso substitui deliberadamente o arquivo por uma análise atual completa que também contém o rótulo:
python3 run.py exact
python3 show_results.py exact
Para a amostra completa, o resultado deve dizer inconclusive. A diferença observada, o p bruto e as 924 diferenças de alocação permanecem iguais. Não remova pessoas, escolha uma data, altere os grupos reais ou substitua por uma amostra aleatória exploratória para obter um rótulo preferido. Todo o acompanhamento obrigatório de sete dias já terminou; mudar a regra de parada ou adicionar dados está fora deste exercício.
Salve uma visão legível das evidências exatas
Nesta etapa, você traçará toda a distribuição de alocações salva e identificará a comparação observada sem ocultar o contexto.
Continue no mesmo terminal WebIDE, em /home/labex/project/signup-experiment. Este gráfico usa a distribuição exata de result["analysis"], não a amostra exploratória de outra unidade. np.unique(..., return_counts=True) conta quantas alocações distintas produzem cada diferença; as alturas devem somar 924 nos dados atuais. Valores repetidos são significativos e não devem ser removidos da distribuição subjacente.
Algumas contagens exatas das caudas têm apenas uma alocação. Marcadores visíveis mantêm essas pequenas contagens legíveis acima da base zero. A linha de conexão ajuda a seguir os pontos discretos; não significa que toda diferença entre eles seja atingível.
A coordenada horizontal é a diferença B−A em pontos percentuais, e a vertical é a contagem de alocações. A marca visível Observed localiza a comparação real. Um p arredondado no título é apenas conveniência de exibição; o número salvo e a interpretação usam o valor não arredondado. Toda a faixa possível de diferenças e a base zero continuam visíveis, incluindo zeros legítimos e valores extremos.
Salve um PNG com pelo menos 500 × 250 pixels. Como no laboratório anterior, uma figura de 9 × 4.5 polegadas a DPI 140 tem aproximadamente 1260 × 630 pixels; a resolução permite eixos e marcadores de pequenas contagens legíveis.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Gere o PNG a partir da análise realmente salva:
python3 run.py plot-exact
No explorador de arquivos do WebIDE, expanda signup-experiment/output e abra evidence.png. Localize a distribuição em torno de zero e a marca observada perto de +66.67. Leia output/analysis.json pelo leitor ao lado: 12 pessoas, os dois denominadores designados, diferença bruta, p exato, alfa e inconclusive formam as evidências em conjunto. Um gráfico sozinho não prova uma análise correta.
A referência abaixo é o gráfico realmente salvo com estes dados guiados e o código fornecido. Os pontos incluem as pequenas contagens nas duas caudas; a linha apenas conecta diferenças atingíveis. Leia junto com o resultado numérico salvo.
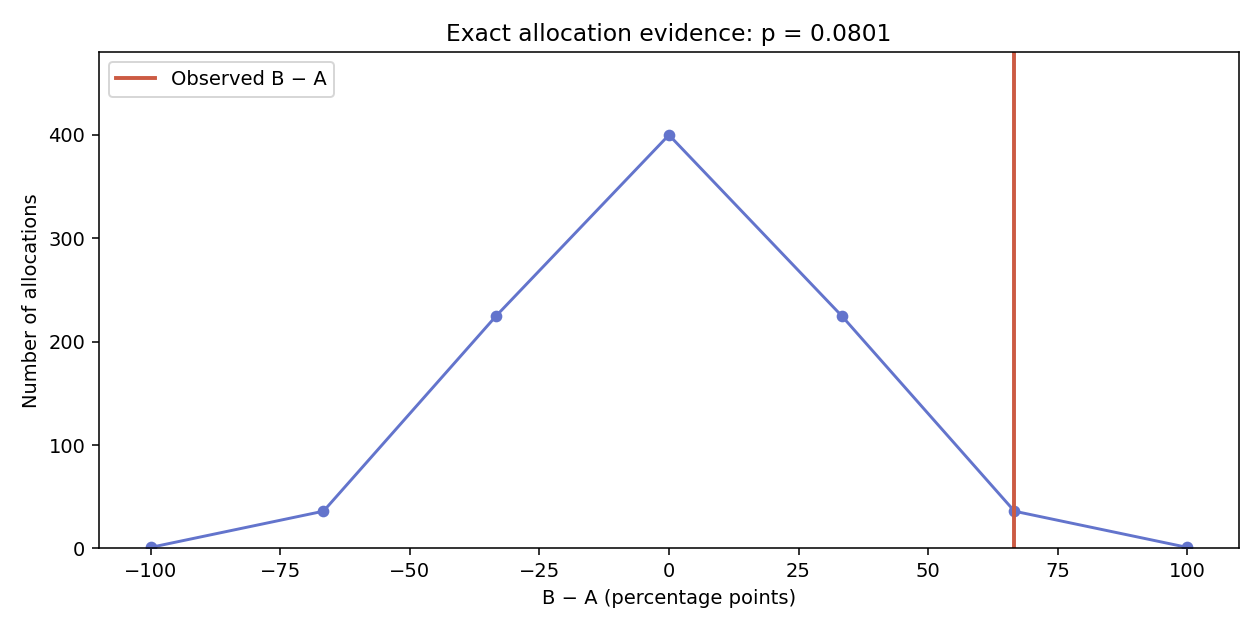
Você pode usar barras legíveis, uma linha de contagens ou pontos nos valores reais das diferenças. A comparação observada exige uma linha ou ponto visível rotulado Observed, e ambos os eixos precisam de rótulos significativos. Mantenha visíveis todos os valores possíveis, a observação e a base zero. O PNG deve ser decodificável e reproduzível a partir dos dados reais salvos e da função atual; traços invisíveis, marcas fora dos eixos, gráficos cortados e imagens alheias não passam. Se o PNG faltar, primeiro confirme o resultado exato salvo com python3 show_results.py exact, depois repita o comando gráfico; o leitor não o repara.
Você analisou uma amostra sintética de experimento aleatorizado sob uma hipótese e convenção declaradas. Não mediu um resultado comercial real, não provou que as páginas sejam idênticas nem estabeleceu que um efeito observado persistirá em produção.
Resumo
Você enumerou uma distribuição exata limitada, usou um valor p bilateral com caudas inclusivas, aplicou um limiar pré-selecionado sem arredondar e salvou o gráfico real. Uma grande diferença pode continuar inconclusiva em uma pequena amostra; um resultado inconclusivo não prova igualdade das páginas. O desafio independente transfere o mesmo processo para outra alocação e outro histórico de eventos.