Introdução
Uma editora da Commonlight precisa de um catálogo de fotos utilizável, começando por uma pequena amostra de uma página. Você fará solicitações HTTP reais para obter JSON, selecionará registros pelos campos e salvará um CSV. A Commonlight é uma API local de demonstração original: os registros e créditos são fictícios, e as imagens de exemplo são ilustrações sintéticas, não fotografias documentais nem conteúdo de um serviço externo de fotos.
Você precisa conhecer funções Python, coleções (como listas e dicionários), laços, exceções e saída básica em arquivos. HTTP, URLs, JSON e CSV são apresentados aqui. No WebIDE, escolha Terminal → New Terminal (em telas estreitas, o menu Terminal pode estar em More). Execute todos os comandos de terminal ali. Use Web 8080 para o site preparado. Edite apenas client.py e storage.py; use a biblioteca padrão e funções auxiliares definidas nesses arquivos, sem módulos ou recursos auxiliares adicionais. Entregue os CSVs como arquivos regulares reais no espaço de trabalho, não links simbólicos; mantenha catalog.py e /opt/commonlight inalterados. Os 40 minutos de leitura e prática são uma estimativa do autor, não um tempo medido com iniciantes.
Solicitar e compreender uma página do catálogo
Nesta etapa, relacione três registros da API a três cartões visíveis e depois implemente a função de solicitação. Alterne para Web 8080. A prévia Harbor walks contém Morning, market, Blue hour e Window light. Ela informa explicitamente que mostra uma página, não a coleção inteira. As imagens fornecem contexto; este curso exporta metadados em vez de baixar imagens.
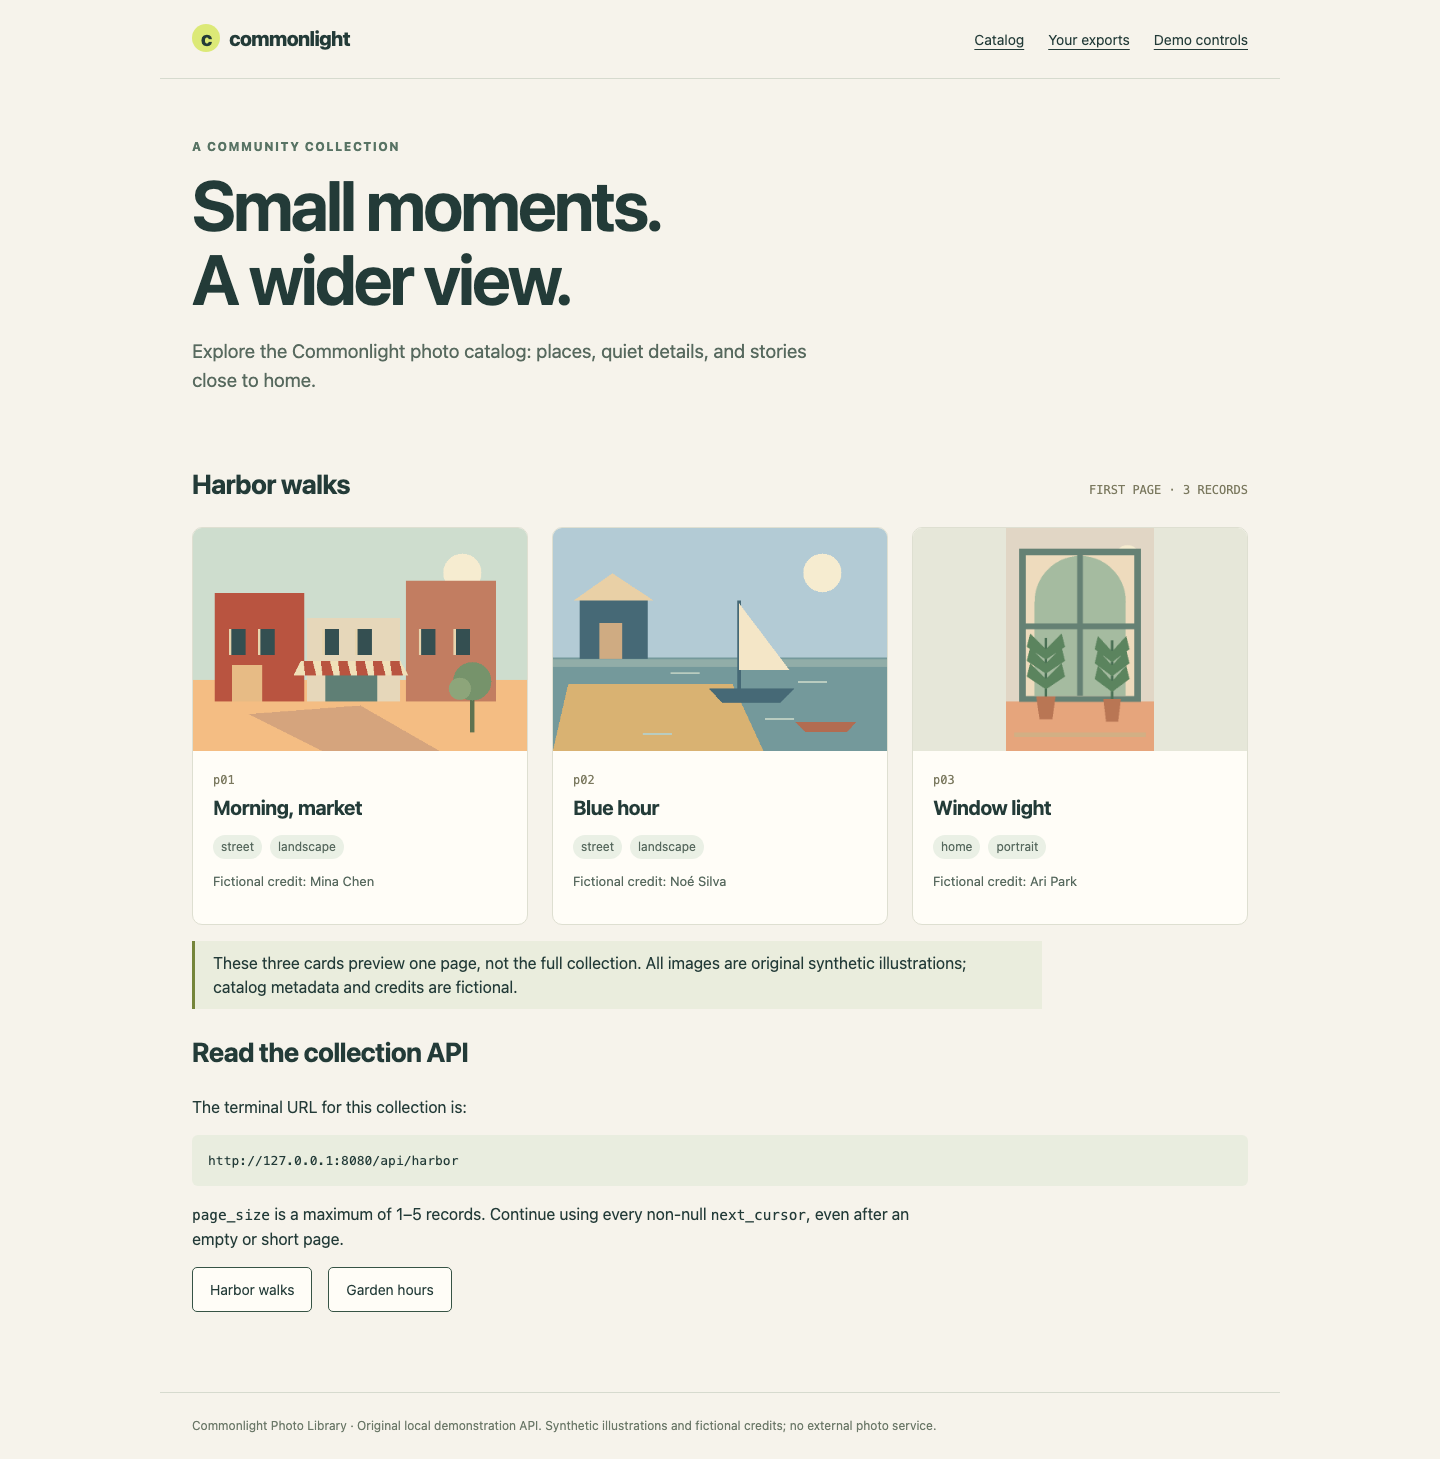
Relacione os IDs abaixo das ilustrações à resposta que você vai solicitar.
Volte ao WebIDE e ao terminal. cd muda o diretório de trabalho; python3 executa Python. Use exatamente este caminho:
cd /home/labex/project
HTTP é o protocolo de solicitação e resposta usado por esta API local. Uma URL identifica o endereço: http é o protocolo, 127.0.0.1 é este próprio ambiente, 8080 é a porta do serviço e /api/harbor seleciona uma coleção. Depois de ?, a consulta page_size=3 pede no máximo três registros. Esse endereço é usado no terminal; Web 8080 abre o endereço de navegador fornecido pela plataforma para o mesmo serviço.
O here-document a seguir executa um pequeno programa Python. <<'PY' passa as linhas literais até o delimitador final PY à entrada padrão do Python; copie as duas linhas delimitadoras. urlopen envia uma solicitação HTTP real. timeout=3 limita operações bloqueantes, como conexão ou espera em um socket, não a duração de qualquer tarefa completa. with fecha a resposta depois do uso. JSON é texto estruturado; json.load decodifica a resposta em dados Python.
python3 - <<'PY'
import json
from urllib.request import urlopen
with urlopen('http://127.0.0.1:8080/api/harbor?page_size=3', timeout=3) as response:
    print('HTTP status:', response.status)
    page = json.load(response)
for photo in page['items']:
    print(photo['photo_id'], photo['title'])
print('More pages:', page['next_cursor'] is not None)
PY
HTTP status: 200
p01 Morning, market
p02 Blue hour
p03 Window light
More pages: True
O status 200 significa que a solicitação foi bem-sucedida. O objeto JSON externo vira um dicionário. Seu valor items é uma lista de dicionários de registros, não a resposta inteira. O null de JSON vira None em Python. Aqui, next_cursor ainda é uma string, portanto existem outras páginas. Esta unidade exporta uma página de propósito; a próxima completa o percurso.
Cada registro tem photo_id, title, category, orientation e credit. Um ID estável identifica o registro; o título é um rótulo de exibição que fotos diferentes podem compartilhar. O contrato preparado pode ser lido em /opt/commonlight/api-contract.md. cat mostra um arquivo de texto:
cat /opt/commonlight/api-contract.md
Adicione funções reutilizáveis de solicitação e seleção. urlencode codifica um dicionário como string de consulta. Um cursor é um token opaco de continuação: copie-o exatamente, sem adivinhar números nem interpretar seus caracteres. O argumento opcional cursor=None faz a primeira solicitação omitir esse parâmetro. Páginas posteriores podem conter caracteres como +, / e =, que precisam ser codificados. Mantenha a URL e o tamanho de página durante o mesmo percurso.
A seleção compara categoria e orientação exatamente, diferenciando maiúsculas de minúsculas. Sem correspondências, uma lista vazia é válida. Na compreensão de lista, for photo in photos visita cada registro; if mantém apenas os que atendem ao filtro; and exige que ambas as comparações sejam verdadeiras. O resultado é uma lista nova, sem modificar os registros recebidos.
O próximo bloco usa cat com > para substituir client.py pelo texto literal de Python. Execute o bloco inteiro, incluindo o último PY. Você também pode abrir o arquivo no WebIDE, substituir o conteúdo e salvar com Ctrl+S (Cmd+S no macOS). Este bloco altera somente esse arquivo.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    return request_page(endpoint, page_size)['items']
PY
A interface de comando preparada chama essas funções. Por enquanto, collect é explicitamente uma implementação inicial de uma página. A autoverificação testa a solicitação contra outra fonte HTTP local real, então a função precisa usar a URL recebida em vez de uma resposta fixa do catálogo. A verificação não cria seu CSV por você.
Se um comando disser que não consegue abrir um arquivo Python, mostre o diretório atual com pwd e os nomes dos arquivos com ls, volte a /home/labex/project usando o cd anterior, corrija o nome e tente novamente. Não é necessário reiniciar a VM do zero.
Filtrar uma página e salvar um CSV real
Nesta etapa, selecione as fotos de rua horizontais da primeira página e abra um CSV com os valores reais de seus campos. CSV significa valores separados por vírgulas, mas uma vírgula dentro de um título pertence a um único campo. Um gravador CSV adequado coloca esse campo entre aspas; concatenar strings ou dividir em toda vírgula quebra essa relação. UTF-8 preserva nomes como Noé e textos não latinos. newline='' deixa o módulo csv gerenciar as terminações de linha do CSV.
FIELDS define os cinco nomes de cabeçalho. Cada um aparece uma vez; soluções equivalentes podem mudar a ordem dos registros e das colunas. DictWriter associa cada valor do dicionário à coluna nomeada. writeheader escreve o cabeçalho e writerows escreve os registros selecionados, incluindo um arquivo só com cabeçalho quando a seleção está vazia. O arquivo é aberto com w, substituindo seu conteúdo. Esta primeira unidade salva uma amostra de página; a publicação segura de uma exportação completa de várias páginas vem a seguir.
No terminal do WebIDE, substitua apenas storage.py:
cat > storage.py <<'PY'
"""Single-page CSV writer; safe publication is taught in the second guided lab."""
import csv

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    with open(output, 'w', encoding='utf-8', newline='') as stream:
        writer = csv.DictWriter(stream, fieldnames=FIELDS)
        writer.writeheader()
        writer.writerows(photos)
PY
O catalog.py preparado recebe cinco argumentos posicionais: URL da coleção, categoria, orientação, tamanho máximo de página e nome do arquivo de saída. --first-page seleciona explicitamente o modo de amostra. street e landscape são os dois filtros exatos. As aspas do shell mantêm uma URL ou nome com caracteres especiais como um único argumento.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Saved 2 photos to page.csv
Leia o resultado com DictReader, que reconstrói os campos entre aspas. Isso lê o arquivo realmente salvo, não a API:
python3 - <<'PY'
import csv
with open('page.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'], '|', photo['credit'])
PY
p01 | Morning, market | Mina Chen
p02 | Blue hour | Noé Silva
p03 não aparece porque é uma imagem vertical da categoria home. A vírgula do primeiro título e o crédito com acento continuam ligados aos registros corretos.
Agora observe uma recusa HTTP intencional. A API permite tamanhos de página de 1–5, portanto 9 retorna 400, não uma coleção vazia obtida com sucesso. Execute este bloco; o primeiro comando deve falhar. $? é o status de saída do comando imediatamente anterior, e printf o mostra antes que outro comando o substitua.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 9 rejected.csv --first-page
printf 'Exit status: %s\n' "$?"
HTTP request refused: 400. No complete export published.
Exit status: 1
HTTPError representa essa recusa HTTP; uma falha de conexão é informada separadamente como Connection failed. Nenhuma delas é um resultado válido sem correspondências. O comando preparado captura a exceção para explicá-la e termina com status diferente de zero. Para recuperar, volte a um tamanho permitido; não altere o serviço:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Alterne para Web 8080, escolha Your exports e depois page.csv. A tabela deve exibir os dois registros reais acima. Escolha Download CSV e abra o arquivo baixado como texto ou com um leitor CSV. O download contém os bytes do arquivo salvo; a página não busca registros ausentes na fonte. Volte a Catalog pela navegação da página, depois ao WebIDE para a autoverificação. Você criou uma amostra reutilizável de uma página, e o token de continuação não nulo ainda indica que ela não é o catálogo completo.
Resumo
Você enviou solicitações HTTP reais, separou o envelope de uma página JSON de seus registros, selecionou valores exatos e escreveu um CSV UTF-8 com aspas corretas. Recusa HTTP, falha de conexão e resultado vazio válido têm significados diferentes. A amostra de dois registros é útil; a próxima unidade segue os cursores restantes para completar a exportação.