Introdução
Uma prévia de três cartões ajuda a explorar, mas a editora precisa de todos os registros correspondentes. Complete o cliente desta mesma API local de demonstração para seguir os tokens de continuação, preservar identidades entre páginas e publicar um CSV somente após o sucesso do lote inteiro. Uma página vazia ou curta ainda pode ter páginas seguintes.
Esta unidade começa de forma independente com as funções de solicitação e seleção do primeiro laboratório guiado. Você precisa dele ou de conhecimentos equivalentes de HTTP/JSON/CSV. No WebIDE, use Terminal → New Terminal; use Web 8080 para a fonte, as exportações salvas e os controles públicos Demo controls. Edite apenas client.py e storage.py; use a biblioteca padrão e funções auxiliares internas, sem módulos ou recursos adicionais. Entregue CSVs como arquivos regulares reais no espaço de trabalho, não links simbólicos. Preserve catalog.py, /opt/commonlight, as ilustrações sintéticas e os registros fictícios de origem. O autor estima 55 minutos de leitura e prática; não é uma duração medida com iniciantes.
Seguir o protocolo até o fim
Nesta etapa, colete todas as páginas, inclusive uma vazia e outra curta, mantendo cada ID uma única vez. No terminal do WebIDE, entre no espaço de trabalho preparado de forma independente:
cd /home/labex/project
A função de solicitação já trata JSON, valores de cursor codificados e um limite de três segundos para operações bloqueantes. Examine as regras preparadas com cat:
cat client.py
O collect atual retorna somente uma página. Um page_size de 3 significa no máximo três registros, não que cada página deva conter três. Preveja esta pequena sequência: primeiro três registros, depois nenhum mas outro cursor, depois um registro com mais um cursor. A página vazia não acrescenta dados, mas não prova o término. Execute a sequência usando apenas os cursores retornados:
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
Somente next_cursor is None encerra um lote com sucesso. Não pare porque items está vazio, uma página é curta ou um número presumido de páginas foi alcançado.
O mesmo ID de foto pode reaparecer em páginas diferentes com valores idênticos. Um dicionário indexado por photo_id preserva a relação entre a identidade e todos os seus campos. setdefault(key, value) insere o valor apenas quando a chave não existe. Assim fica uma cópia; um título repetido não é um ID duplicado. Revisões conflitantes estão fora deste contrato de demonstração. Os dois IDs distintos chamados Blue hour devem permanecer.
Um conjunto registra valores únicos. set() cria um conjunto vazio, cursor in seen_cursors pergunta se um token já está presente e seen_cursors.add(cursor) registra um novo. Esse conjunto lembra os tokens de continuação já vistos. Depois de verificar o término null legítimo, rejeite um token repetido em vez de entrar em um laço infinito ou considerar um ciclo como conclusão. raise ValueError interrompe a coleta antes que o comando salve um resultado incompleto. Os catálogos normais preparados são finitos; não há um limite fixo de páginas nem repetição ou retomada automáticas.
Substitua client.py pelo módulo completo abaixo. Como antes, > substitui o arquivo e o here-document entre aspas mantém o conteúdo literal. A solicitação e o filtro não mudam; a parte nova é collect.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
Execute a coleta completa. Omita --first-page, pois essa opção produz intencionalmente apenas uma amostra.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
Examine as identidades salvas em vez de confiar somente em uma quantidade:
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
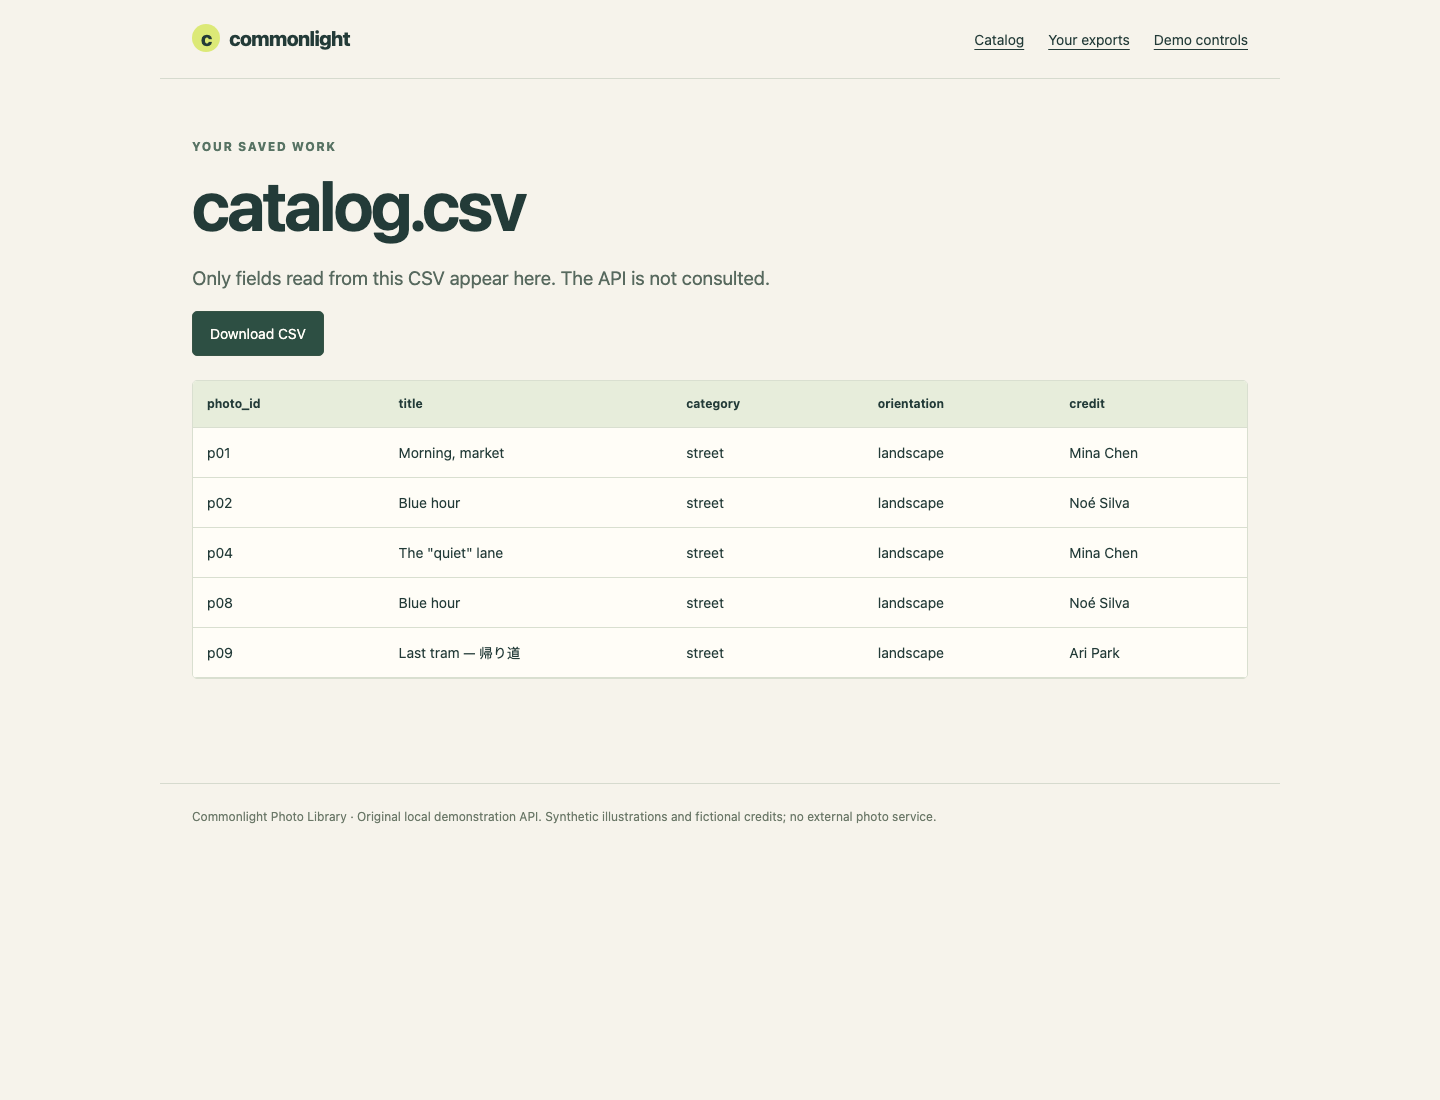
O registro final p09 está presente, p02 aparece uma vez e p08 mantém o mesmo título com outro ID. Examine os mesmos valores em Web 8080 → Your exports → catalog.csv. A tabela lê apenas seu CSV; um arquivo incompleto continuará incompleto ali. Volte ao WebIDE para a autoverificação. Se usou um nome ou diretório errado, recupere com pwd, ls e o cd anterior antes de tentar novamente.
Publicar somente uma exportação completa
Nesta etapa, proteja a última exportação correta quando uma solicitação posterior, um ciclo de protocolo ou uma escrita falhar. A coleta já termina antes do salvamento. O gravador também precisa de uma fronteira de sucesso completo: abrir o caminho final com w pode truncar um bom arquivo antes de a nova escrita terminar.
Path(output) transforma o nome fornecido em um objeto de caminho. .parent é o diretório que o contém e .name é o nome final. NamedTemporaryFile cria um nome novo e único em vez de se apropriar de um vizinho previsível como catalog.csv.tmp. dir=output.parent mantém o temporário no diretório de destino para que a substituição ocorra no mesmo sistema de arquivos. delete=False preserva o arquivo após fechá-lo para permitir a substituição; stream.name fornece o nome alocado, armazenado como Path. O bloco finally executa tanto após o sucesso quanto após uma exceção. exists() verifica se o caminho temporário permanece; unlink() remove apenas esse arquivo recém-criado se ainda existir. Após uma substituição bem-sucedida, o caminho temporário desapareceu e nada é removido. A exceção continua até a interface de comandos e provoca uma saída diferente de zero. Path.replace publica o arquivo pronto depois que o bloco with o fecha. Uma substituição POSIX bem-sucedida é atômica, mas não garante durabilidade após falta de energia, transação entre vários arquivos nem coordenação de gravadores concorrentes. Um vizinho .tmp existente e não relacionado nunca deve ser sobrescrito ou removido.
No terminal do WebIDE, substitua storage.py. Os cinco campos CSV devem aparecer exatamente uma vez no cabeçalho; implementações equivalentes podem usar outras formas válidas de aspas e outra ordem de linhas ou colunas.
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
Execute um lote normal antes de simular problemas. sha256sum imprime uma impressão digital do conteúdo e o nome do arquivo. Memorize-a ou deixe a saída visível: o próximo lote com falha deve mantê-la. Uma escrita que falha também deve preservar o último arquivo completo; a verificação testa isso em um ambiente isolado sem mudar seu espaço de trabalho.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
Alterne para Web 8080. Escolha Demo controls, depois Enable middle-page failure. Confirme Middle-page failure ON.
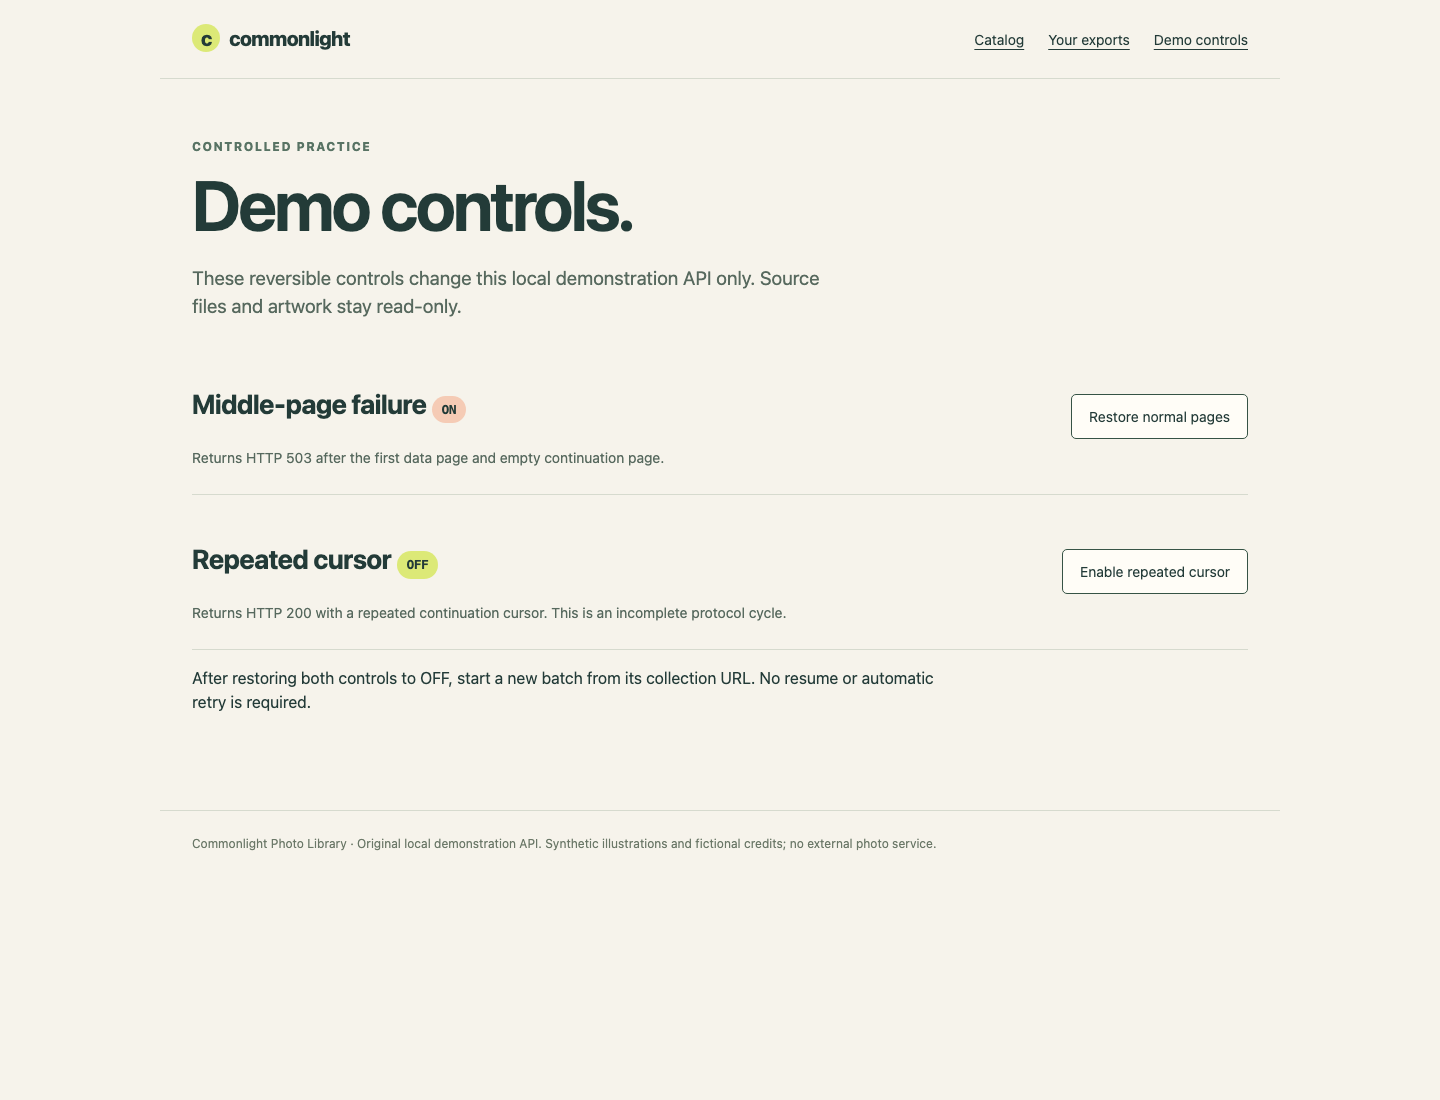
Use o cartão correspondente à falha ativada. Essa alteração reversível é expressamente permitida e afeta somente a memória da API de demonstração; os arquivos de origem continuam somente para leitura. Volte ao WebIDE e execute esta falha intencional. printf captura imediatamente $?:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
Aqui, HTTP 503 significa que a API de demonstração recusou uma solicitação de página intermediária. Não é uma falha de conexão nem um resultado vazio bem-sucedido. A impressão digital deve coincidir com a anterior, e a exportação antiga de cinco linhas deve continuar visível. Uma saída diferente de zero não basta se o programa já danificou o arquivo.
Em Web 8080 → Demo controls, escolha Restore normal pages para a falha intermediária e confirme OFF. Volte ao WebIDE e comece um novo lote finito pela URL da coleção; não reutilize um cursor antigo:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Em seguida, abra Web 8080 → Demo controls e escolha Enable repeated cursor. Confirme Repeated cursor ON e o controle de falha em OFF. Volte ao WebIDE:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
Essas respostas têm HTTP 200, mas o cursor repetido é erro de protocolo, não conclusão. A proteção pelo conjunto impede um laço infinito e a publicação. Em Web 8080 → Demo controls, escolha Restore normal pages no cartão Repeated cursor e confirme OFF; os dois controles devem estar agora em OFF. Volte ao WebIDE, repita o comando correto e tente um filtro válido sem correspondências usando outro nome de saída:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
O segundo resultado é bem-sucedido e contém só o cabeçalho; ele difere dos dois erros anteriores. Em Web 8080 → Your exports, abra empty.csv para ver os cinco cabeçalhos sem linhas de dados, depois abra catalog.csv e escolha Download CSV. O arquivo real salvo com cinco registros é sua entrega. Volte ao WebIDE para a autoverificação. Mantenha o programa e os arquivos preparados: a verificação lê o resultado real e executa cópias inalteradas em testes HTTP reais isolados, incluindo outras URLs, filtros, tamanhos e falhas de escrita.
Resumo
Você seguiu tokens opacos até o término null explícito, preservou identidades distintas apesar dos títulos repetidos e rejeitou um ciclo de protocolo. Publicou um CSV UTF-8 completo por meio de um temporário único e conservou o resultado correto anterior após as falhas. O mesmo programa pode aceitar outra coleção e seleção fornecidas.