Introdução
O estúdio agora tem uma fronteira honesta de previsão. Um pequeno modelo de regressão melhora a estimativa de materiais em relação à mediana anterior de presença? Você ajustará um Pipeline curto, comparará os dois métodos nas mesmas oficinas rotuladas e salvará uma imagem real de comparação com previsões futuras.
Você precisa de funções Python, seleção e junções pandas, conceitos básicos de regressão e treino/teste Scikit-learn e Matplotlib introdutório. O Guided Lab anterior explica o prazo de sete dias e a imputação aprendida apenas no treino. Este laboratório prepara todos os arquivos de forma independente, inclusive a divisão concluída por ID/data; arquivos da VM anterior não são necessários. Todos os dados são material sintético original para ensino. Os 60 minutos são uma estimativa do autor.
Ajustar um Pipeline pequeno nas oficinas anteriores
Nesta etapa, você substituirá um modelo tentador baseado no pós-evento por um preditor reutilizável de sete dias.
Comece em WebIDE → Terminal → New Terminal. cd muda o diretório de trabalho deste terminal. O executável preparado ./python inicia o ambiente do curso; ./ escolhe o inicializador deste diretório em vez do interpretador do sistema.
cd /home/labex/project/workshop-attendance
cat exibe arquivos sem editá-los; vários argumentos de nomes exibem os arquivos em sequência.
cat season.json history.csv labels.csv future.csv
Cada linha histórica é uma oficina identificada por session_id. labels.csv associa actual_attendance por essa chave, em ordem independente. As únicas características numéricas permitidas são booked_7d, retrato salvo exatamente sete dias antes, e duration_minutes, já anunciada naquele prazo. Células numéricas vazias indicam informação ausente; cada característica permitida tem uma observação de treino não vazia. IDs e datas servem para associar e separar, não como entradas do modelo. final_bookings e scanned_entries acontecem no evento e vazam informações indisponíveis sete dias antes.
A divisão pronta congela o treino em 1º de abril de 2026 às 00:00 UTC e reserva eventos históricos a partir de 12 de abril para avaliar. Os rótulos de treino são conhecidos até o fim do dia de cada evento anterior; o último evento de treino aqui é 8 de março. A primeira previsão reservada ocorre em 5 de abril, usando o retrato de sete dias daquele evento com o modelo já congelado. Não se afirma que a entrada de 5 de abril estava disponível no dia 1º. Os arquivos posteriores reproduzem as respectivas datas futuras de previsão. future.csv não tem rótulos reais; seus eventos de maio recebem previsões, não erros medidos. Não há linhas históricas no intervalo configurado. O curso não aborda reajustes contínuos nem características de treino inteiramente vazias.
cat split.py
Observe seu merge por chave, limites interpretados como datas e ordenação cronológica. É a divisão concluída na lição anterior, fornecida aqui para independência. Preserve-a, todas as entradas CSV/JSON, python, run.py, coursekit.py, show_results.py e os arquivos starter-*.py. Edite apenas model.py, chart.py e seus artefatos output/. O model.py fornecido começa com um modelo por leituras de entrada: resultados históricos aparentemente perfeitos não corrigiriam essa escolha inválida de informação.
Um Pipeline encadeia pré-processamento e modelo. Durante fit, o imputador aprende médias das características de treino recebidas e a regressão aprende da matriz preenchida. Durante predict, o mesmo imputador apenas transforma as entradas posteriores. Nunca se ajusta novamente no conjunto reservado ou futuro. LinearRegression ajusta intercepto e coeficientes por mínimos quadrados ordinários; mantemos esse modelo pequeno em vez de ajustar muitas alternativas.
Escreva as duas funções reutilizáveis do modelo. FEATURES é exatamente ['booked_7d', 'duration_minutes']. fit_model retorna o estimador ajustado e a mediana do alvo de treino. predict_events seleciona as mesmas características permitidas para toda tabela. A função provisória evaluate será completada na próxima etapa; a fase fit não a chama.
O > do shell substitui o arquivo. <<'PY' começa um here-document entre aspas: cole até a última linha contendo somente PY; o shell salva o Python literalmente. Como alternativa, edite model.py no WebIDE Explorer e escolha File → Save.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
A prévia salva deve associar W-88 a previsão bruta próxima de 32.718, presença real 46 e referência 24.5; W-09 deve ter previsão próxima de 62.236, real 74 e a mesma referência. Uma saída de regressão pode ser fracionária mesmo quando uma oficina real recebe um número inteiro de pessoas.
./python show_results.py fit
São previsões anteriores ao resumo de erros, ajustadas sem os rótulos posteriores. Alterar esses rótulos deve mudar os erros finais, não as previsões ajustadas. Uma característica com coeficiente aprendido zero pode legitimamente não influenciar; alterar uma entrada arbitrária não necessariamente muda uma previsão.
Comparar erros contínuos no mesmo conjunto reservado
Nesta etapa, você calculará erros absolutos de rótulos reais reservados e comparará as médias em pessoas.
Continue no WebIDE, em /home/labex/project/workshop-attendance. Um erro absoluto é a magnitude de actual - predicted. np.abs calcula elemento por elemento; np.mean faz a média do array resultante. Para uma referência justa, subtraia a mesma mediana anterior do alvo de cada um dos mesmos rótulos reais reservados. Nunca compare conjuntos diferentes nem substitua um resultado real por uma previsão.
Use as previsões contínuas brutas para todos os erros e MAEs. Arredondar primeiro para a contagem exibida muda a avaliação. O programa auxiliar formata o MAE no console com três casas decimais para leitura, mas salva o valor numérico não arredondado em JSON.
Substitua model.py pela versão completa abaixo. Ela mantém ajuste e previsão e completa a função antes vazia evaluate. Essa função retorna arrays de erro por evento e suas médias; o programa auxiliar preserva os IDs das mesmas linhas reservadas ao escrever output/holdout.csv. Os vetores seguem a ordem de posições dos arrays reais/preditos recebidos. Valores equivalentes semelhantes a arrays, incluindo Series pandas, são aceitos nessa ordem; seus rótulos numéricos de índice não são IDs de oficinas.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
Resumo esperado no console:
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
Para W-88, o erro do modelo é cerca de 13.282 pessoas, e o da referência é 21.5. Para W-09, são aproximadamente 11.764 e 49.5. As médias sem arredondar são aproximadamente 12.5230751656 e exatamente 35.5 pessoas. A referência do aquecimento era 18; a mediana de treino da temporada é 24,5 porque usa outra amostra anterior.
Aqui o modelo pequeno tem erro menor nesses dois eventos reservados. Isso é evidência sobre este pequeno conjunto sintético, não prova de confiabilidade futura nem de efeito causado por reservas. Se um modelo correto tiver MAE maior, a conclusão honesta é que não melhorou essa comparação. A avaliação nunca exige vencer a referência; características constantes ou sem informação são legítimas.
Entregar o gráfico e as previsões sem rótulos
Nesta etapa, você tornará a comparação reservada legível e exportará estimativas futuras sem inventar resultados reais.
Continue no WebIDE, em /home/labex/project/workshop-attendance. O gráfico deve mostrar um valor por ID reservado para cada série Actual, Model e Baseline, usando valores brutos em pessoas da tabela comparativa. Linhas ou dispersão servem; rótulos e IDs esclarecem o sentido. O PNG deve ser legível, ter pelo menos 600 por 300 pixels e reproduzir o mesmo gráfico visível ao repetir com os mesmos dados. O estilo pode variar. A avaliação verifica valores realmente desenhados e a imagem salva, não um manifesto que declare o gráfico correto. Todos os pontos do negócio devem ficar dentro dos limites visíveis dos eixos, e nenhuma série obrigatória pode estar oculta ou totalmente transparente. Pontos exatamente no limite são permitidos; cores e intervalos podem diferir.
O backend Agg do Matplotlib escreve imagem sem abrir janela de desktop. subplots cria figura e eixos; plot desenha cada série associada por ID. Os marcadores abaixo distinguem círculos reais vazados, losangos do modelo e cruzes tracejadas da referência, mesmo quando real e referência se sobrepõem. tight_layout reserva espaço para rótulos, savefig escreve o PNG real e close libera a figura.
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
Primeiro pratique um erro de digitação inofensivo. O próximo comando usa intencionalmente um nome inválido de etapa e termina com erro de argumento; não modifica seus resultados salvos.
./python run.py delvier
A mensagem lista as opções permitidas. Corrija a grafia e execute a etapa de entrega. Se aparecer arquivo não encontrado, use pwd e ls, volte com o cd inicial e tente o nome correto.
./python run.py deliver
./python show_results.py deliver
O leitor carrega CSV/JSON salvos e decodifica o PNG real; nunca preenche resultados a partir das entradas. No Explorer do WebIDE, expanda output e abra comparison.png. O modelo deve ficar abaixo dos dois pontos reais; a referência permanece em 24,5. Marcadores diferentes distinguem séries com valores iguais. Inspecione holdout.csv junto à imagem para associar cada ponto a seu ID e erro real.
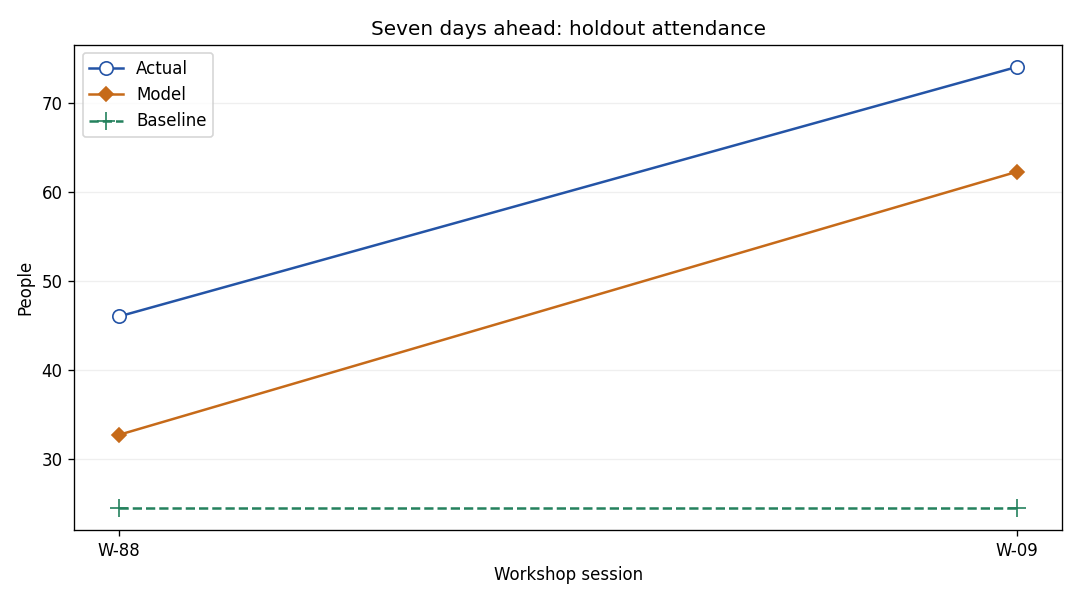
O exemplo fornecido mostra presenças reais 46 e 74 em W-88 e W-09, previsões próximas de 32,718 e 62,236 e referência tracejada em 24,5. A distância vertical do ponto real à previsão representa o erro absoluto do evento. Seu estilo pode diferir; IDs e valores subjacentes devem concordar.
forecast.csv contém somente session_id, model_prediction bruto e display_people. F-6 tem previsão próxima de 19.119 e contagem exibida 19; F-101, próxima de 25.245 e contagem 25. Apenas para exibir, o programa auxiliar limita estimativas negativas a zero e arredonda metades para cima usando floor(max(raw, 0) + 0.5). É uma regra prática de apresentação, não uma alteração do modelo avaliado. A previsão bruta permanece mesmo negativa ou fracionária.
Não se fabricam contagens reais futuras nem MAE futuro. Um modelo pode ser congelado antes de chegar um retrato posterior: no prazo de sete dias de cada evento de maio, reutilize o modelo existente e as características conhecidas salvas daquele evento. Amostras sintéticas pequenas, retratos ausentes e mudança de comportamento limitam as conclusões. O Challenge independente muda temporada e datas, mantendo o fluxo. Implementações numéricas equivalentes, ordens de saída e estilos de linhas/dispersão são aceitos com tolerância 1e-8 e relações corretas por ID.
Resumo
Você treinou um Pipeline pequeno de imputação e regressão nas oficinas anteriores, comparou seus erros reservados brutos com uma referência de mediana de treino e salvou um gráfico associado por ID. Também exportou estimativas futuras sem incluir resultados desconhecidos na avaliação. Um MAE reservado menor pode sustentar essa comparação limitada; um resultado pior é igualmente válido quando calculado honestamente.