



Introdução
A EARLY CRUMB está preparando a retirada de pães de sábado. Pedidos, pagamentos e cancelamentos são registrados separadamente. Dois clientes têm o mesmo nome, e um pedido pode conter vários produtos. Uma boa entrega começa ao relacionar os registros certos, em vez de adivinhar pelos nomes.
Neste laboratório, você preparará as tabelas de pedidos e pagamentos, relacionará cada ID de pedido ao seu status de pagamento e criará a lista de IDs pagos. Os cancelamentos serão tratados no próximo laboratório independente. Basta ter familiaridade básica com o terminal: tabulações, campos, ordenação e comandos são explicados antes do uso. Todas as pessoas e todos os registros são fictícios.
Use Workstation para os comandos e Pickup Preview para o balcão de retirada já preparado. A visualização mostra os registros de origem e uma etiqueta de exemplo. Ela não calcula suas respostas nem cria seus arquivos.
Prepare tabelas que possam ser relacionadas
Nesta etapa, você preparará registros sem cabeçalho e uma lista ordenada de IDs de pedidos sem perder nenhuma linha de produto. Comece em Pickup Preview.
Entenda a entrega
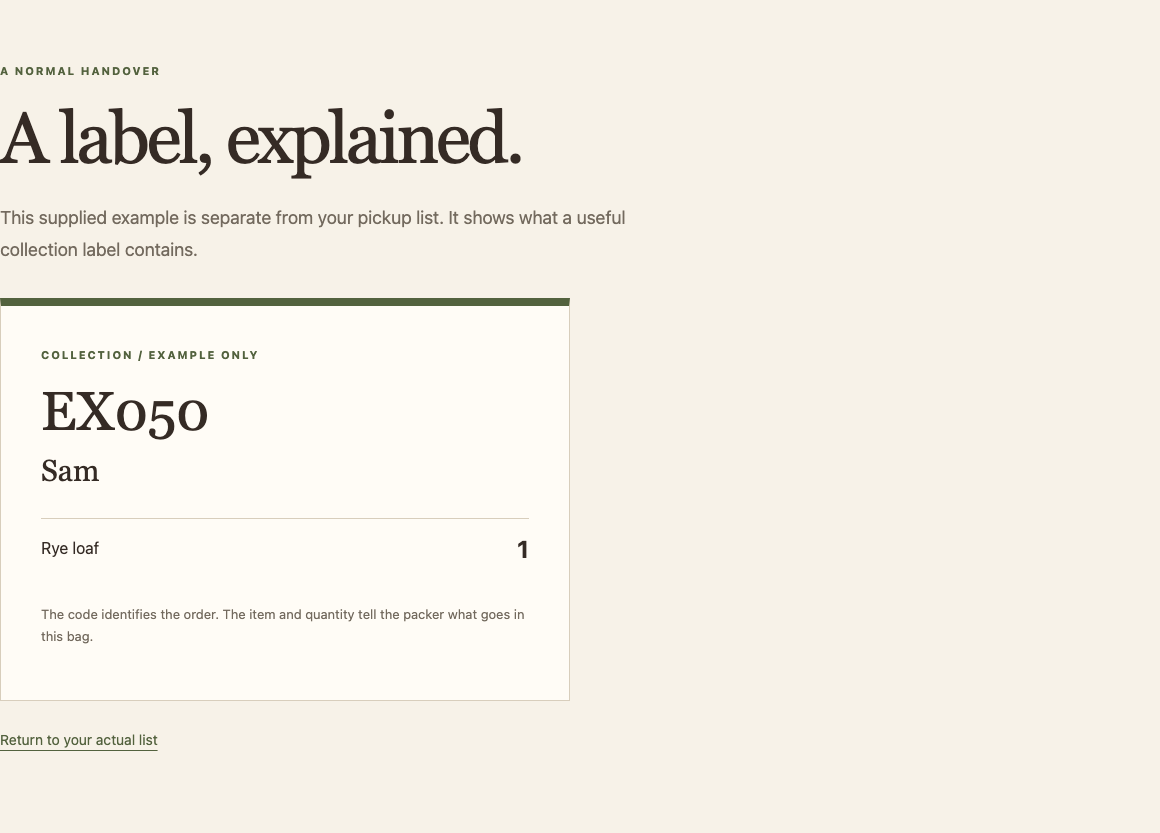
Abra Sample label. EX050 pertence a Sam e contém um pão de centeio. É um exemplo separado, não a sua lista de retirada concluída. Um código de pedido identifica uma sacola; o nome ajuda o cliente a reconhecê-la; cada produto e sua quantidade dizem a quem embala o que colocar dentro.
Abra Records. Na legenda de produtos, rye significa Rye loaf e oat significa Oat cookie. Localize P101 em orders.tsv: Alex pediu dois pães de centeio e um biscoito de aveia. P102 também é de Alex, mas é outro pedido e seu pagamento está unpaid. Relacionar pelo nome atribuiria a sacola ao pedido errado. Use order_id.
Leia os arquivos preparados
Mude para Workstation. O diretório inicial é /home/labex/project/pickup. pwd mostra o diretório atual; ls lista seu conteúdo:
pwd
/home/labex/project/pickup
ls
Você deve ver source e work. Os registros de origem permanecem intactos; work/ guarda arquivos intermediários que podem ser recriados. Um caminho como source/orders.tsv é relativo a esse diretório. Se sair dele, volte com:
cd /home/labex/project/pickup
cat mostra um arquivo. Leia as duas tabelas:
cat source/orders.tsv
cat source/payments.tsv
TSV significa valores separados por tabulações. Cada linha é um registro; uma tabulação separa os campos. A primeira linha é o cabeçalho. Nos pedidos, os quatro campos são ID do pedido, cliente, produto e quantidade. Um pedido pode ter várias linhas de produtos. Os pagamentos têm dois campos: ID do pedido e o status exato paid ou unpaid. Há no máximo uma linha de pagamento por pedido. O formato preparado não contém tabulações nem quebras de linha dentro de um valor.
P106 aparece nos pedidos, mas não tem linha de pagamento. Informação ausente não significa pagamento realizado. Você manterá essa ausência visível ao relacionar os dados.
Separe cabeçalhos de registros
tail -n +2 mostra da segunda linha em diante. > salva a saída em um arquivo, substituindo o destino se ele já existir. Isso não altera a origem. Nunca use o mesmo caminho como origem e destino com >: o shell esvaziaria o arquivo antes que o programa o lesse.
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
Inspecione as linhas de produtos:
cat work/orders.rows
P101 e P105 aparecem duas vezes porque cada um tem dois produtos. Mantenha essas linhas. Repetir um ID de pedido não significa automaticamente que os dados estão duplicados.
Prepare as chaves de relacionamento
Uma chave é o campo usado para relacionar registros. cut -f1 seleciona o primeiro campo separado por tabulação. Um pipe | envia a saída ao próximo comando. sort -u ordena as linhas e mantém cada linha idêntica uma única vez. Aqui, ele é aplicado apenas à lista de IDs, não à tabela de produtos.
A ordenação e o relacionamento precisam usar a mesma ordem. LC_ALL=C escolhe uma ordem previsível por bytes, e export permite que os comandos seguintes a utilizem. Essa configuração pertence a este terminal; defina-a novamente se abrir outro.
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
Na tabela de pagamentos com dois campos, ordene pelo primeiro mantendo o status. TAB é uma variável do shell que contém uma tabulação: printf '\t' a imprime, e $(...) captura essa saída. As aspas duplas em "$TAB" a passam como um único argumento separador. -t define o separador de campos; -k1,1 escolhe somente o primeiro campo como chave de ordenação.
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
Espere P101 a P105 em ordem, cada um com seu status original. P106 não ganhou uma linha de pagamento. Agora há seis IDs distintos de pedidos e todos os cinco registros de pagamento prontos para relacionar. Se houver cabeçalho ou status incorreto, recrie apenas o arquivo de trabalho afetado a partir da origem; não edite a origem para fazê-la caber no resultado.
Relacione cada pedido ao status do pagamento
Nesta etapa, você unirá as duas entradas preparadas e manterá visíveis os pedidos sem pagamento. Comece em Workstation, no mesmo terminal da etapa 1.
Saiba o que o relacionamento deve significar
P101 deve ser associado a paid, P102 a unpaid e P106 a um valor explícito missing. Os nomes não participam do relacionamento. Neste momento, um pedido pago ainda pode estar cancelado; relacionar pagamentos, por si só, não determina a lista final de retirada.
join relaciona entradas ordenadas pelo primeiro campo por padrão. Uma junção interna comum omite IDs sem correspondência. Aqui também precisamos enxergar esses registros ausentes:
-t "$TAB"usa a tabulação criada na etapa 1.-a 1inclui também registros sem correspondência da primeira entrada, a lista completa de IDs de pedidos.-e missingfornece a palavramissingquando um campo de saída não está disponível.-o 1.1,2.2mostra o campo 1 da entrada 1 (ID do pedido), seguido do campo 2 da entrada 2 (status).1e2indicam arquivos de entrada, não números de linhas.
Execute o comando inteiro em uma linha. Ele grava um resultado com dois campos:
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
Os espaços acima representam tabulações, não os caracteres literais barra invertida e t. Você deve ver seis linhas. P106 continua presente porque a entrada da esquerda contém todos os IDs de pedidos e -a 1 mantém os IDs sem correspondência.
Leia o resultado antes de filtrá-lo
P101 e P102 são de Alex na origem, mas têm status diferentes. P103 também está pago; um cancelamento poderá excluí-lo depois. P106 não tem registro de pagamento, então missing impede seu desaparecimento silencioso da comparação.
Se join informar que uma entrada não está ordenada, volte à etapa 1 e recrie as duas entradas ordenadas usando a mesma configuração LC_ALL=C. Não esconda o aviso nem remova um pedido inconveniente. Se tiver reconectado o terminal, restaure o diretório e as duas configurações do shell da etapa 1 antes de tentar novamente.
Executar um comando com sucesso não basta: compare essas três linhas importantes com os registros de origem. Agora você tem um relacionamento completo dos pagamentos para apoiar a próxima decisão.
Selecione pedidos pagos sem perder sua identidade
Nesta etapa, você criará o arquivo de IDs de pedidos pagos e verá exatamente o que salvou. Comece em Workstation.
Compare o status completo
Tanto paid quanto unpaid contêm as letras paid. Uma busca de texto imprecisa incluiria P102 incorretamente. Precisamos de uma tabulação seguida do status completo no final da linha.
grep seleciona linhas correspondentes. Na expressão $'\tpaid$', a parte externa $'...' transforma \t em uma tabulação; o último $ dentro da expressão significa o fim da linha. Assim, o campo de status precisa ser exatamente paid, e não o final de unpaid. Depois, cut -f1 mantém somente os IDs dos pedidos. A saída já está ordenada porque a tabela relacionada está ordenada.
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 não foi pago e P106 está sem pagamento, portanto nenhum deles pertence a esta lista. Mantenha P103 nesta etapa: o arquivo representa pedidos pagos, não o conjunto final de pedidos a embalar. Removê-lo antes de considerar os cancelamentos misturaria duas decisões e tornaria o resultado intermediário enganoso.
Leia a seleção salva
Mude para Pickup Preview. Selecione Payment IDs na navegação. Essa página mostra paid-order-ids.txt; ela não calcula uma resposta sobre pagamentos. Você deve ver os quatro IDs que acabou de salvar. Siga Compare with source records e confira as linhas de pagamento correspondentes.
A página Pickup list da visualização preparada ainda pode dizer que não há lista para embalar. Isso é esperado: você criou uma seleção de pagamentos, não a lista final de produtos. O próximo laboratório independente usa essa seleção para excluir cancelamentos e preservar a quantidade de cada produto elegível.
Se o arquivo estiver vazio ou incluir P102, inspecione work/payment-match.tsv e o padrão exato do status; depois execute o filtro novamente. Você pode corrigir e recriar esse resultado sem alterar nenhum registro de origem.
Resumo
Você preparou registros separados por tabulação, ordenou por uma chave comum, relacionou pagamentos mantendo registros ausentes e selecionou o status exato de pagamento. Separou a identidade do pedido dos nomes de clientes e das linhas de produtos. O próximo laboratório independente transforma essa seleção de pagamentos em uma entrega útil para a retirada.


