Introdução
O Meridian Museum ajuda visitantes a encontrar objetos por material e história. Sua página inicial pode responder antes que a pesquisa na coleção esteja utilizável. Cada novo contêiner de pesquisa importa doze registros fornecidos para um índice de palavras em memória. A alimentação tem intervalos deliberados para permitir observar o carregamento; cada contêiner substituto constrói seu próprio índice desde o início.
Você manterá os Pods em carregamento fora do Service dos visitantes, dará tempo suficiente à inicialização e atualizará o importador enquanto as réplicas existentes continuam fornecendo resultados corretos. É necessário saber usar o terminal e conhecer imagens e contêineres em execução. Objetos Kubernetes, patches YAML e configurações de probes são apresentados aqui. O cluster, a imagem do museu em cache e o site completo estão preparados; nenhuma instalação, conta externa ou programação de aplicativo é necessária.
Use Museum para o percurso do visitante e Workstation para os comandos. Trabalhe apenas no namespace meridian e no espaço de trabalho fornecido. Este é um cluster de aprendizagem com um único nó, sem demonstrar alta disponibilidade nem garantir ausência de falhas nas requisições. Cada laboratório começa de forma independente.
Enviar visitantes apenas a Pods capazes de pesquisar
Você distinguirá um processo em execução de um índice de pesquisa utilizável e adicionará readiness para a tarefa real do visitante. Comece em Museum.
Experimentar o percurso normal do visitante
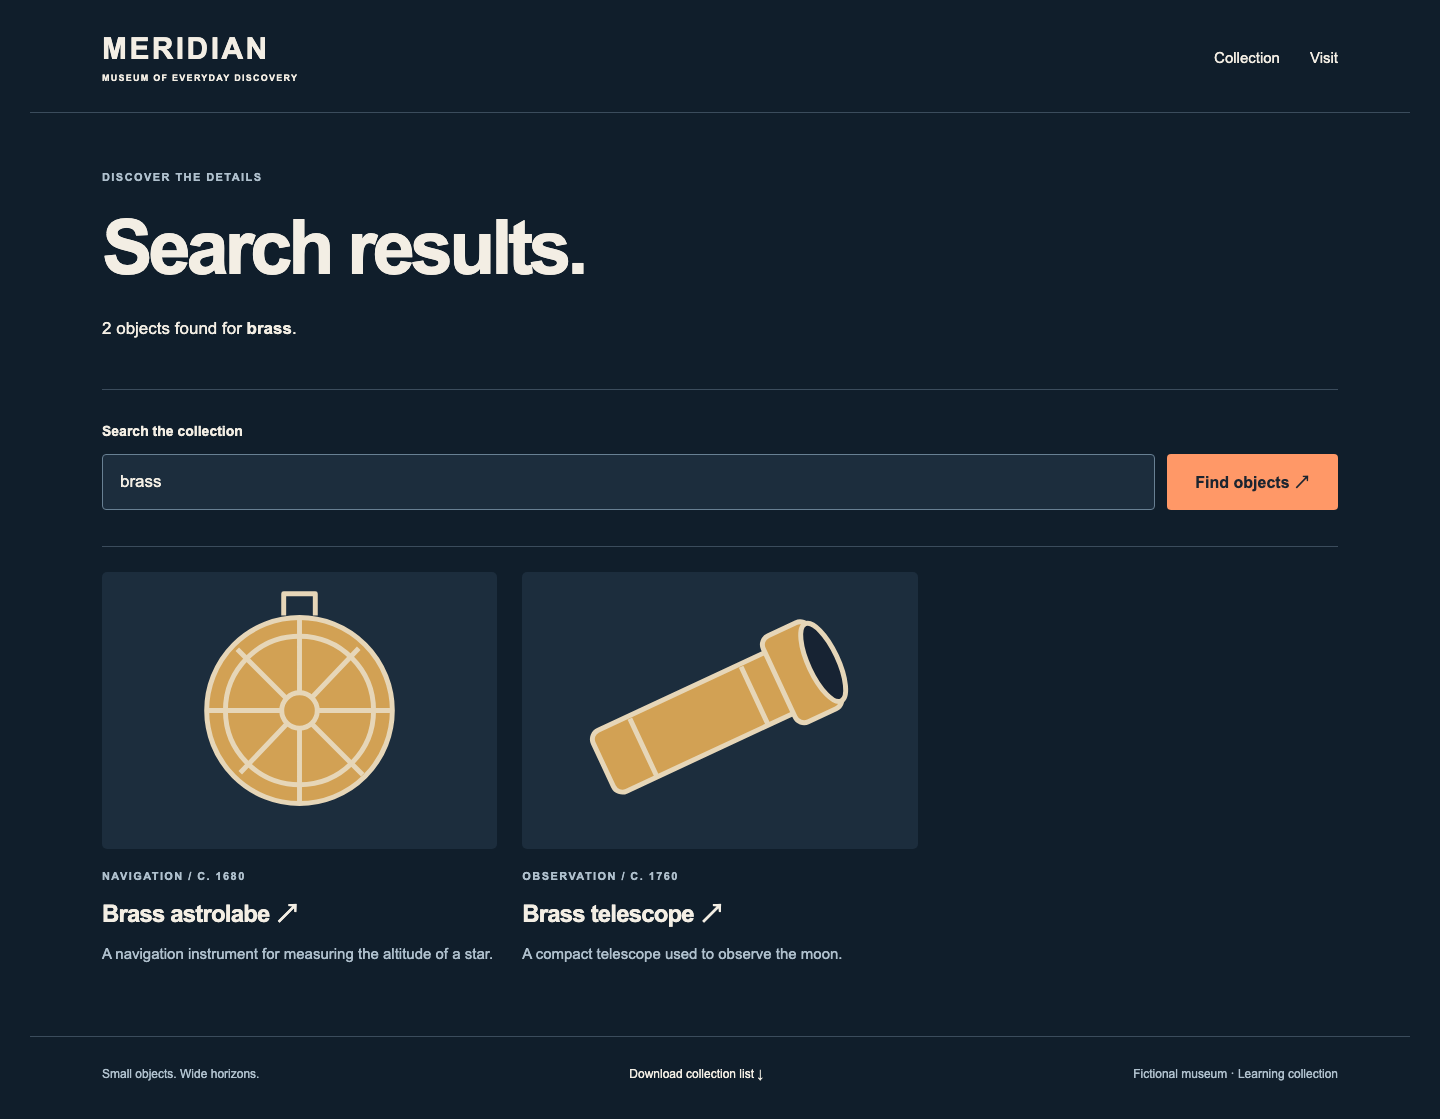
Digite brass em Search the collection e selecione Find objects ↗. Os resultados devem incluir Brass astrolabe e Brass telescope, com 2 objects found. Abra Brass astrolabe: aparecem a história, a ilustração e a localização Gallery 1. Selecione See it at the museum ↗, leia os horários e a entrada sem degraus e selecione Download collection list ↓. Abra o CSV baixado: ele lista doze objetos, incluindo os dois instrumentos de latão. Use MERIDIAN para voltar ao início. Essas funções devem sobreviver às alterações.
Conhecer os três objetos Kubernetes
Mude para Workstation. pwd mostra o diretório atual e ls lista os arquivos:
pwd
ls
O diretório é /home/labex/project/museum. Um Pod executa o contêiner do museu. Um Deployment mantém dois Pods de réplica e os substitui quando seu modelo de contêiner muda. Um Service oferece um endereço estável e encaminha aos Pods selecionados que estão prontos. Rótulos conectam esses objetos: o Service seleciona Pods com app: search. Um namespace agrupa os objetos deste curso; todos os comandos abaixo indicam meridian explicitamente.
kubectl solicita ao cluster a leitura ou alteração de objetos. get os lista; -n escolhe o namespace. cat mostra um arquivo de texto para você ler o candidato preparado:
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML usa key: value, espaços para indentação e - para itens de lista. Em spec.template, o contêiner usa a imagem em cache meridian-museum:1. imagePullPolicy: Never exige a imagem preparada sem download de registro. IMPORT_INTERVAL: "2" deixa dois segundos entre registros: doze registros levam cerca de 24 segundos. As réplicas iniciais dos visitantes usavam um intervalo curto para você experimentar primeiro a pesquisa normal.
A atualização gradual preparada mantém replicas: 2, permite um candidato extra (maxSurge: 1) e não permite réplicas existentes indisponíveis (maxUnavailable: 0). Isso depende de readiness honesta: sem probe, um processo em execução pode ser elegível antes de a pesquisa funcionar. Preserve essas configurações, imagens, rótulos e o Service.
Observar tráfego prematuro neste Service de treinamento
O navegador usa HTTP, um protocolo de requisição e resposta. O status 200 significa sucesso; 503 indica que o servidor está temporariamente incapaz de atender àquela requisição. Uma página inicial funcional não comprova que outra requisição, como pesquisa, terá sucesso.
Este museu não tem clientes reais. Você demonstrará deliberadamente a atualização insegura antes de melhorá-la. cp copia o candidato para seu arquivo editável search.yaml. apply -f envia o YAML do arquivo; o modelo de Pod alterado inicia uma atualização. python3 executa o observador fornecido, somente de leitura; --seconds 30 amostra o verdadeiro Service dos visitantes durante 30 segundos. Ele verifica os dois objetos de latão na resposta. Execute a atualização e o observador juntos:
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
Espere algumas linhas HTTP=503 correct_search=false enquanto os novos contêineres desprotegidos carregam. A quantidade varia. A página inicial continua funcionando; a resposta de pesquisa 503 informa explicitamente que a coleção está sendo preparada. É uma resposta real de um Pod em carregamento, não uma animação predefinida de sucesso ou falha.
rollout status aguarda a atualização deste Deployment; --timeout limita essa espera:
kubectl rollout status deployment/search -n meridian --timeout=90s
Ele pode informar sucesso mesmo que nenhuma probe de readiness tenha protegido o período anterior de carregamento. Espere os resultados normais de brass antes de continuar. Se aparecer erro de conexão em vez de status HTTP, leia a tabela de Pods e tente novamente; servidor ausente e servidor respondendo 503 são situações diferentes.
Adicionar uma verificação de prontidão do negócio
Uma probe de readiness verifica se este Pod deve receber tráfego do Service. Uma falha retira sua elegibilidade, sem reiniciar o contêiner. Nesta imagem, /health/process sempre informa sobre o processo HTTP, enquanto /ready/search retorna 200 somente quando todos os doze registros estão indexados e a pesquisa brass conhecida funciona. A página inicial também retorna 200 durante a importação, portanto nem ela nem o endpoint do processo são adequados.
patch altera campos selecionados. --patch-file lê seu arquivo; --type=strategic mescla o contêiner chamado search, preservando as demais configurações. A probe envia HTTP à porta nomeada http deste Pod, verifica a cada dois segundos e o marca como não pronto após uma falha. Escreva o pequeno patch abaixo. cat > readiness.yaml substitui esse arquivo. <<'YAML' inicia um here-document literal: cole o bloco inteiro, incluindo o YAML final sozinho na linha. Preserve os espaços:
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
As pesquisas corretas devem continuar pelas réplicas existentes enquanto a nova réplica importa os registros.
Um EndpointSlice registra os endereços reais dos Pods do Service e sua prontidão. -l filtra pelo rótulo de nome do serviço; -o jsonpath seleciona somente endereço e ready da resposta estruturada. A expressão fornecida percorre os registros de endpoints e imprime esses campos; ela apenas lê o estado. Inspecione os Pods e os endereços do Service:
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
Durante a importação, você pode ver um novo Pod 0/1 Running e um endereço com ready=false. Os endpoints prontos existentes continuam atendendo às pesquisas. Quando termina o carregamento, o candidato fica pronto e a substituição continua. Se perder esse breve estado intermediário, as próximas etapas oferecem uma janela maior.
Termine com exatamente dois Pods 1/1 Running. Um Pod antigo Terminating pode permanecer brevemente após o sucesso do rollout; espere e repita get pods até ele sair. Em Museum, repita a pesquisa brass e o detalhe do astrolábio. Se houver erro YAML, corrija o patch e reaplique. Se houver erro no caminho da probe, substitua apenas o caminho no mesmo patch e reaplique. Não apague outros namespaces nem encurte o importador para esconder um erro.
Dar tempo suficiente para o importador iniciar
Você distinguirá a espera por prontidão de uma falha de inicialização e definirá um orçamento a partir da importação real. Comece em Workstation.
Uma probe de startup limita quanto tempo um novo contêiner pode levar para inicializar. Até que tenha sucesso, o Kubernetes suspende as verificações de readiness. Quando as falhas de startup atingem o limiar, o kubelet reinicia o contêiner. Essa probe é opcional; adicionar uma curta demais pode impedir que uma aplicação funcional fique pronta. Ela não substitui readiness depois de a inicialização ter sucesso.
Observar um orçamento insuficiente
startup-short.yaml é um exemplo de treinamento fornecido. Uma falha de startup solicita um reinício, mas o encerramento pode atrasar o aumento do contador visível. A próxima espera do cliente dura 60 segundos para você observar essa diferença. Leia o exemplo antes de aplicar:
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
Espera-se que o comando de rollout falhe com error: timed out waiting for the condition. Seu status de saída real é diferente de zero. Continue neste terminal interativo. O exemplo verifica a cada dois segundos e permite apenas duas falhas, aproximadamente quatro segundos de inicialização. Isso não comporta a importação de 24 segundos.
Leia as evidências atuais. logs mostra a saída da aplicação; --prefix identifica cada Pod e --tail=4 limita cada log às quatro últimas linhas. Um seletor solicita todos os Pods de pesquisa. get events lê observações do cluster; --field-selector reason=Unhealthy restringe a verificações de saúde que falharam:
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
O novo Pod permanece não pronto e seu RESTARTS deve aumentar. Ele pode mostrar CrashLoopBackOff, indicando que o Kubernetes está adiando outra tentativa de reinício. Se a tabela ainda mostrar zero apesar das falhas registradas, espere e repita get pods antes de mudar o orçamento: a tabela é uma observação momentânea, e encerrar leva tempo. Cada reinício descarta o índice em memória daquele contêiner; seu substituto importa os registros novamente.
Uma linha tardia index_complete de um contêiner cuja probe já falhou não cancela seu reinício pendente nem o torna um backend pronto do Service. Leia o contador de reinícios junto aos eventos de falha de startup. Os Pods mais antigos permanecem 1/1 e continuam servindo seus índices completos.
Em Museum, pesquise brass. Os resultados corretos continuam chegando pelo Service a partir das réplicas prontas existentes. A atualização travada não foi revertida automaticamente: o Deployment ainda solicita o candidato defeituoso. Não confunda o serviço antigo preservado com uma atualização concluída.
Calcular e aplicar um orçamento útil
Mude para Workstation. Doze registros a dois segundos precisam de aproximadamente 24 segundos. Use aqui 60 segundos, que também comportam a próxima importação de 36 segundos e uma margem didática de 12 segundos. periodSeconds × failureThreshold é uma aproximação de planejamento, não uma garantia de prazo; escalonamento, timeouts das probes e carga real acrescentam variação. Em produção, meça a inicialização e escolha uma margem deliberada.
Use o mesmo método de arquivo de patch. Mantenha o verdadeiro caminho do negócio e a porta nomeada:
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
Isso cria Pods substitutos com startup corrigido. Cada um deve terminar de carregar sem reiniciar; a tabela final deve ter dois Pods 1/1 Running com RESTARTS 0. Espere que os Pods antigos em encerramento saiam e repita a tabela se necessário. Readiness continua controlando o tráfego após startup ter sucesso.
Se a atualização continuar travada, leia os mesmos logs e eventos, compare caminho e orçamento no arquivo, corrija e reaplique. Apagar Pods não corrige o modelo do Deployment: eles seriam recriados com as mesmas configurações defeituosas. Distinga o orçamento de probe de 60 segundos de --timeout=120s, que limita somente quanto o cliente espera pelo rollout.
Manter a pesquisa disponível numa atualização mais lenta
Você aplicará uma importação mais lenta e usará respostas do Service junto aos endpoints prontos para avaliar a atualização. Comece em Workstation.
kubectl set env altera uma variável de ambiente no modelo de contêiner do Deployment. Isso inicia Pods substitutos; não altera o ambiente dos contêineres já em execução. Defina o intervalo em três segundos. Doze registros agora levam cerca de 36 segundos, ainda dentro do orçamento de 60 segundos:
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
O novo Pod deve estar 0/1 Running durante a importação. Os endereços prontos existentes continuam fornecendo resultados brass corretos. O observador usa o mesmo Service NodePort que Museum alcança; nunca seleciona um Pod saudável específico. Na execução observada, as requisições protegidas permaneceram corretas. Uma amostra finita não promete ausência de falhas sob todas as condições reais de rede, aplicação ou cluster.
Espere a atualização completa e inspecione o estado final:
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
Após a saída de todos os Pods antigos Terminating, deve haver exatamente dois Pods atuais prontos sem reinícios, e seus dois endereços devem mostrar ready=true. Uma réplica antiga saudável é útil durante a importação, mas o rollout final precisa realmente convergir à nova revisão.
Verificar todo o serviço dos visitantes
Em Museum, use MERIDIAN para voltar ao início e pesquise brass novamente. Ambos os instrumentos devem aparecer; abra o telescópio e siga o link de visita. Pesquise volcano: a página deve informar que nenhum objeto foi encontrado sem falhar. Abra Collection, veja um objeto que não seja de latão e baixe a lista em Visit. Confirme os doze objetos e a preservação das ilustrações e da navegação.
Mude para Workstation. curl solicita uma URL; -sS oculta o progresso mas mostra erros de conexão. 127.0.0.1 significa esta instância de treinamento, e a porta 30081 pertence ao verdadeiro Service do museu. Aspas mantêm a URL de consulta como um único argumento do shell:
curl -sS 'http://127.0.0.1:30081/search?q=brass'
Leia os dois títulos corretos no HTML, não apenas um código de sucesso HTTP. Se uma verificação ocorrer enquanto Pods antigos ainda encerram, espere e tente novamente; não remova probes nem reduza o tempo de importação. Preserve cluster, imagem fornecida, Service e doze registros de origem. Seu resultado combina uma verificação honesta de prontidão do negócio, tempo suficiente de startup e uma atualização concluída que preserva a experiência do museu.
Resumo
Você conectou readiness a um índice real da coleção, observou como uma probe de startup insuficiente falhou e reiniciou o candidato e calculou um tempo útil de inicialização. Atualizou o importador com intervalos enquanto as réplicas prontas existentes atendiam às pesquisas, depois verificou os Pods atuais, os endpoints do Service e todo o percurso do visitante. Processo em execução, backend pronto e atualização concluída são fatos distintos; este exercício com um único nó não demonstra alta disponibilidade de produção nem ausência de falhas.