Introdução
O Field Notes tem uma galeria parcialmente preparada. Um grupo recebeu um HTTP 503 temporário de sua fonte, enquanto os outros grupos terminaram. Você manterá essas evidências de falha, executará um novo Job com uma pequena margem para novas tentativas e entregará a coleção completa sem regravar os JPEGs já corretos.
Esta VM independente inclui suas próprias vinte fotografias de origem, armazenamento compartilhado, site, Job com falha e saídas parciais. Você não precisa de arquivos da VM anterior. Conclua primeiro Crie a Galeria em Lotes ou esteja à vontade com seu Job indexado, cópia e edição de YAML, inspeção de Pods e fluxo de download. A duração de 40 minutos é uma estimativa do autor.
Use Workspace para os comandos e Gallery para o site. Preserve os arquivos fornecidos, as imagens de origem e de referência, o processador, o plano, os serviços, a PVC, o Job first-try original e seus Pods e logs.
Recupere o Grupo de Fotos que Falhou
Nesta etapa, relacione a galeria incompleta ao índice nativo que falhou antes de escolher uma política de recuperação.
Abra Gallery, selecione Open the gallery e confirme 14 of 20 images available. O primeiro, o terceiro e o quarto grupos terminaram; as seis fotografias do grupo 1 estão ausentes. Abra Reference na navegação da página para ver o exemplo normal fornecido e depois mude para Workspace.
O terminal começa em /home/labex/project/photo-gallery. Use pwd para confirmar; se necessário, retorne com cd /home/labex/project/photo-gallery. Leia o mapeamento dos grupos e as instruções da equipe:
cat inputs/groups.txt
cat inputs/brief.txt
Há quatro grupos numerados a partir de zero. O índice 1 contém de photo-07 a photo-12. Inspecione a tentativa retida:
kubectl describe job first-try -n photo-workshop
Procure Completion Mode: Indexed, Completed Indexes: 0,2,3, um Pod com falha em Pods Statuses e o aviso FailedIndexes em Events. Os índices concluídos e a tabela de Pods abaixo identificam o grupo ausente. Leia sua política no arquivo de origem fornecido:
cat starter/first-try.yaml
backoffLimitPerIndex: 0 não permite substituição após uma falha em um índice. backoffLimit: 6 é um orçamento global de falhas separado: ele não substitui uma margem por índice igual a zero. activeDeadlineSeconds: 180 é o limite de tempo de vida ativo. O Job permanece com falha embora vários índices tenham sido concluídos com sucesso.
Liste seus Pods reais e as labels de seus índices:
kubectl get pods -n photo-workshop -l batch.kubernetes.io/job-name=first-try -L batch.kubernetes.io/job-completion-index
Leia os logs de todos eles:
kubectl logs -n photo-workshop job/first-try --all-pods=true --prefix=true
O Pod do índice 1 informa Source returned HTTP 503 e termina; os outros grupos informam suas fotografias concluídas. HTTP 503 significa que a fonte respondeu, mas estava temporariamente indisponível. Isso é diferente de um Pod ausente, uma falha de conexão ou um JPEG ilegível.
Copie o nome completo do Pod do índice 1 da tabela para o comando a seguir, substituindo POD_NAME em vez de digitar o marcador literalmente:
kubectl describe pod POD_NAME -n photo-workshop
Seu contêiner encerrado mostra Exit Code: 42. Essa é a resposta deliberada do worker fornecido ao erro HTTP da fonte, não um código geral de erro HTTP do Kubernetes. O cenário produz um 503 real na primeira requisição do índice 1 de cada novo Job. O próximo Pod substituto desse mesmo índice consegue ler a fonte com sucesso. Este é um exercício controlado de falha temporária, não uma afirmação de que toda resposta 503 em produção permite uma nova tentativa com segurança.
Mantenha o Job com falha, seus Pods e logs e os quatorze JPEGs corretos existentes. O processador grava um JPEG idêntico somente quando necessário; os bytes de imagem já correspondentes e seus metadados de arquivo são mantidos. Os comprovantes por Pod e os registros do índice de imagens podem ser atualizados para identificar a nova tentativa bem-sucedida.
Permita um Número Finito de Novas Tentativas por Índice
Agora crie um novo Job com uma nova tentativa permitida por índice. Não tente transformar o Job que já falhou em uma nova execução.
Em Workspace, em /home/labex/project/photo-gallery, copie o rascunho de recuperação fornecido:
cp starter/recovery-job.yaml gallery-job.yaml
Como no laboratório anterior, cp mantém a origem intacta. Se a origem não puder ser encontrada, confirme pwd, retorne ao espaço de trabalho e repita a cópia exata. Leia o rascunho:
cat gallery-job.yaml
Ele já solicita todos os quatro índices com paralelismo 2, mas tem o nome provisório gallery-draft e nenhuma nova tentativa por índice. Use sed -i para substituir cada valor literal em seu arquivo copiado; as aspas simples protegem as expressões de substituição da interpretação do shell:
sed -i 's/name: gallery-draft/name: gallery-retry/' gallery-job.yaml
sed -i 's/backoffLimitPerIndex: 0/backoffLimitPerIndex: 1/' gallery-job.yaml
Leia o arquivo novamente:
cat gallery-job.yaml
Confirme name: gallery-retry, completions: 4, parallelism: 2 e backoffLimitPerIndex: 1. Mantenha backoffLimit: 6, activeDeadlineSeconds: 180 e todas as configurações fornecidas de processador, montagem, identidade e recursos. Esta tarefa aceita uma ou duas novas tentativas por índice, mas uma pequena margem finita é suficiente. Remover o prazo ou permitir tentativas ilimitadas ocultaria um problema persistente.
Um novo Job tem uma nova identidade Kubernetes. Ele pode processar grupos que já tiveram sucesso antes; o worker fornecido lida com essa execução repetida sem regravar JPEGs correspondentes. Não deduza processamento exatamente uma vez a partir de um Job bem-sucedido. Preservar o Job anterior com falha também mantém visível o motivo desta recuperação. Se uma edição não encontrou correspondência, copie novamente e corrija o rascunho antes de aplicá-lo. Se você já criou um Job final inadequado, mantenha suas evidências e prepare outro nome novo no arquivo salvo, em vez de alterar um modelo de Pod imutável ou excluir first-try.
Aplique o novo Job salvo:
kubectl apply -n photo-workshop -f gallery-job.yaml
Espere por sua conclusão bem-sucedida:
kubectl wait -n photo-workshop --for=condition=Complete job/gallery-retry --timeout=180s
Inspecione seus índices e sua política:
kubectl describe job gallery-retry -n photo-workshop
Espere Completed Indexes: 0-3. O comando wait anterior já confirmou a condição nativa Complete. Liste os Pods reais:
kubectl get pods -n photo-workshop -l batch.kubernetes.io/job-name=gallery-retry -L batch.kubernetes.io/job-completion-index
O índice 1 agora tem um Pod com falha e um Pod substituto diferente concluído para o mesmo índice. O Pod com falha é uma evidência esperada deste teste controlado. Leia sua saída:
kubectl logs -n photo-workshop job/gallery-retry --all-pods=true --prefix=true
Você deve ver o HTTP 503 real e depois o processamento bem-sucedido em seu substituto. Os outros grupos informam Kept para os JPEGs que já correspondiam. Se o tempo de espera se esgotar, inspecione os logs do novo Job e dos Pods; não apague a falha anterior, não reinicialize a preparação nem aumente os limites de novas tentativas às cegas. O paralelismo solicitado é uma configuração de concorrência desejada, não uma garantia absoluta de processos durante a substituição.
Entregue a Coleção Recuperada
Nesta etapa, comprove que a nova tentativa produziu a galeria completa e utilizável e salve seus downloads atuais.
Mude para Gallery, selecione Gallery na navegação da página e atualize. Confirme 20 of 20 images available. Abra Black-and-white blossoms (photo-07), a primeira fotografia do grupo recuperado, e compare-a com sua própria fonte. Selecione Download thumbnail e Back to gallery. Abra também Blue and yellow flowers (photo-20), do último grupo curto.
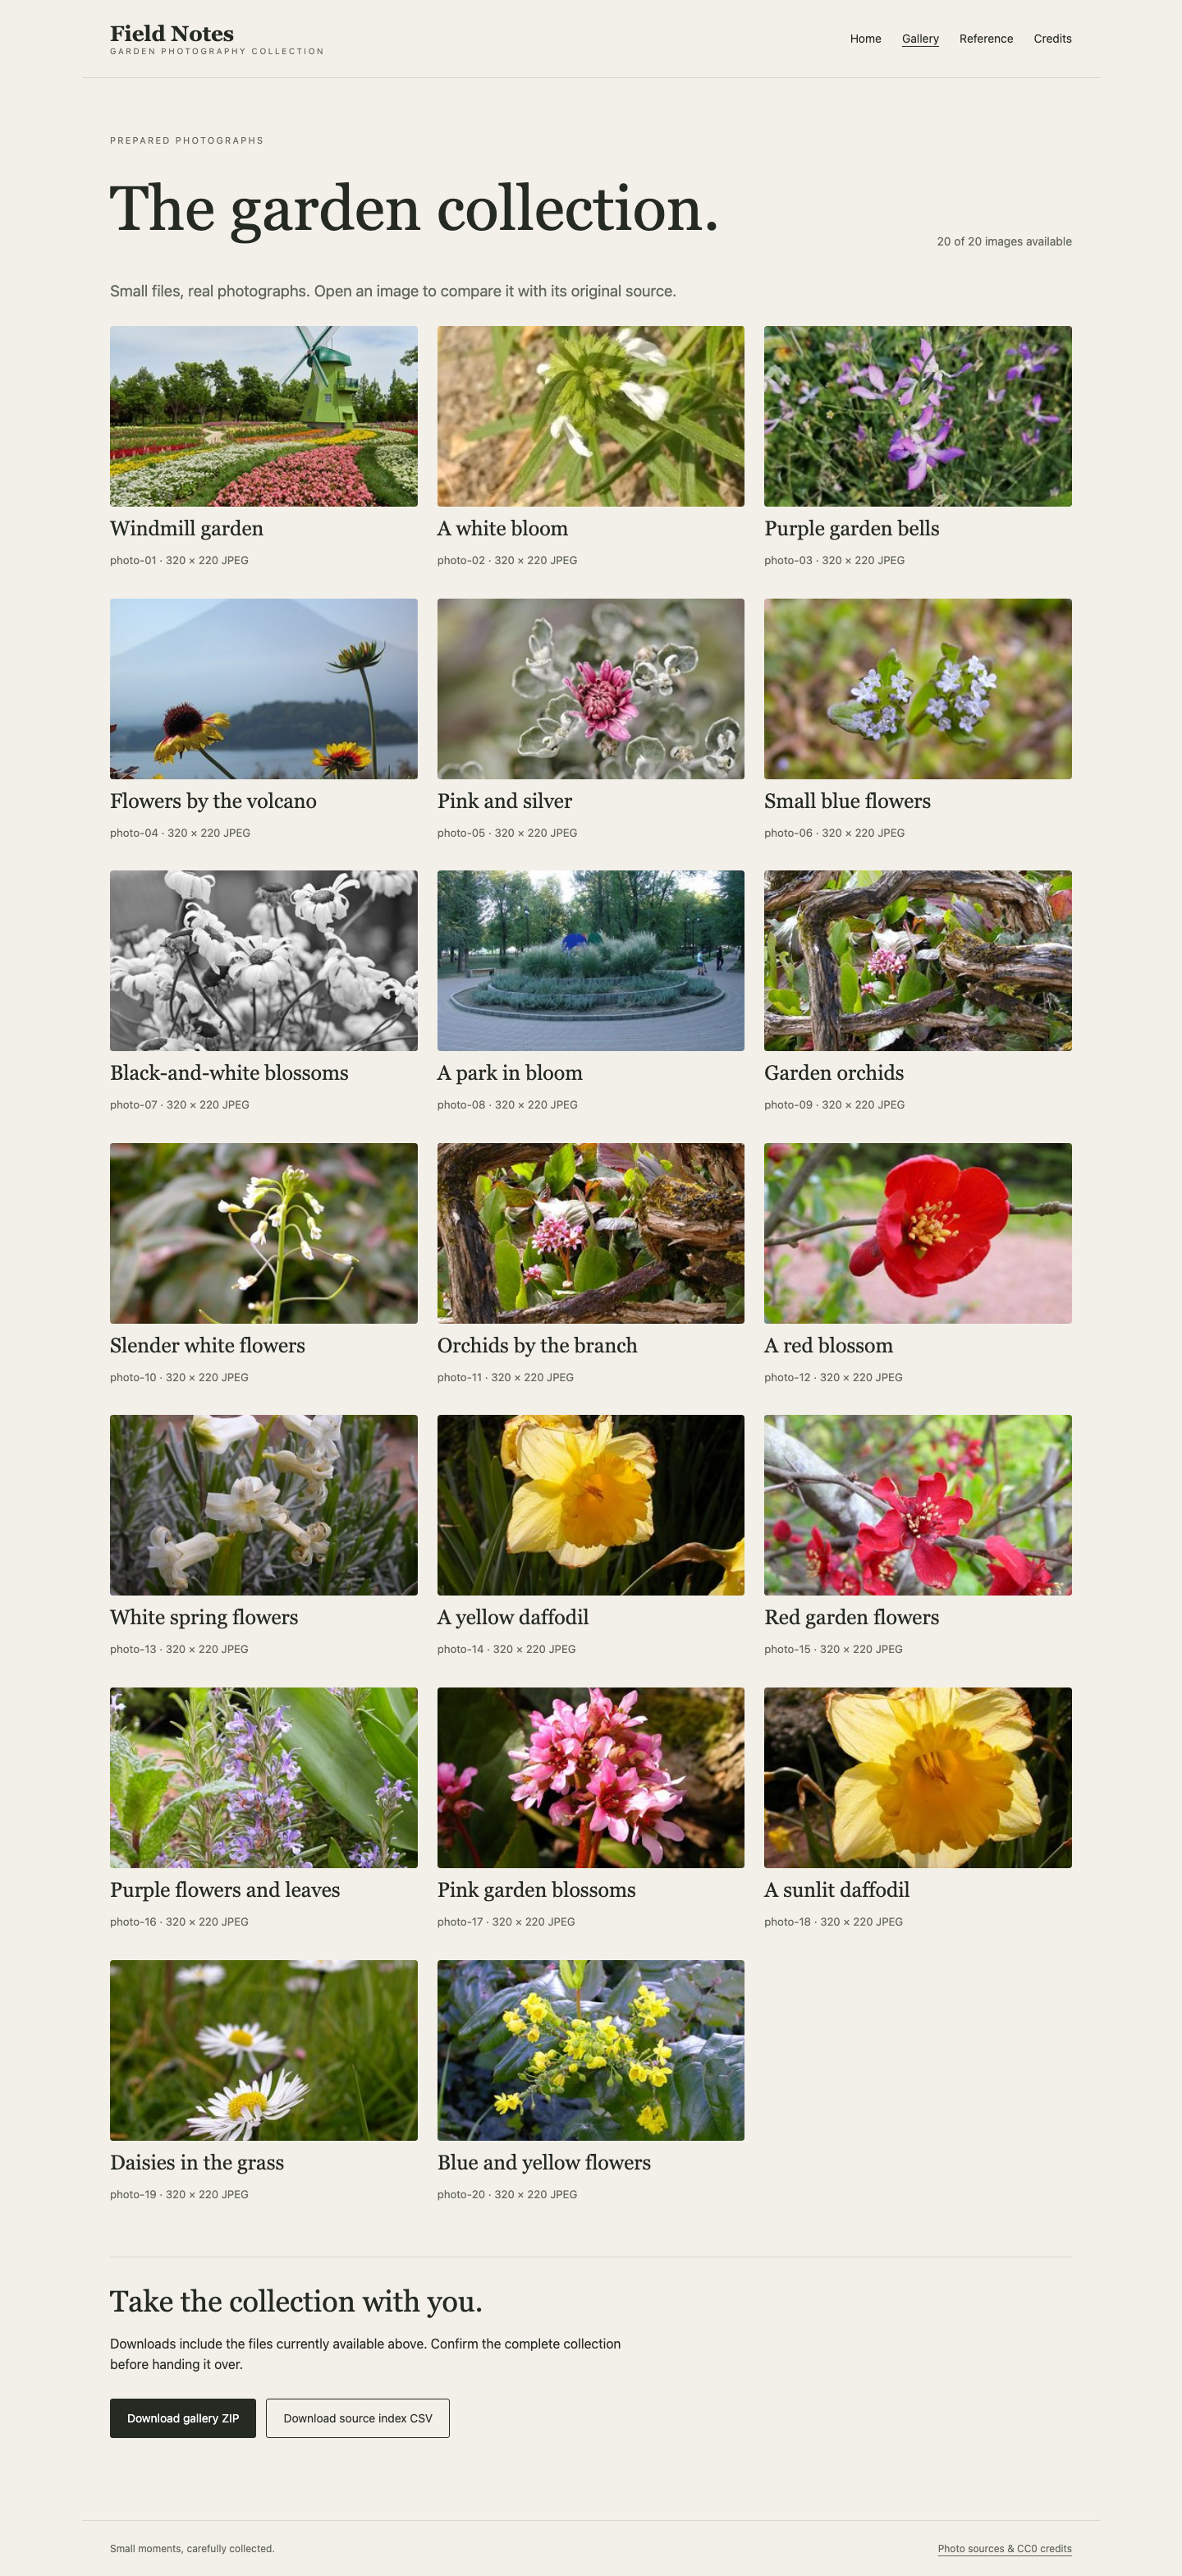
A coleção recuperada agora inclui as seis fotografias ausentes e o último grupo curto. A página ainda aponta para a referência inalterada e para as fontes licenciadas.
Retorne à galeria e use Download source index CSV e Download gallery ZIP. Selecione Reference para confirmar que o exemplo fornecido permanece intacto e Credits para verificar a atribuição das fontes. O site exibe somente saídas reais e legíveis dos workers; ele não preenche imagens ausentes a partir da coleção de origem.
Mude para Workspace, em /home/labex/project/photo-gallery. Salve os arquivos reais atuais de entrega usando as mesmas opções ensinadas no primeiro laboratório:
curl --fail --silent --show-error http://127.0.0.1:8091/download/index.csv -o gallery-index.csv
curl --fail --silent --show-error http://127.0.0.1:8091/download/gallery.zip -o gallery.zip
Inspecione o cabeçalho do CSV e as primeiras linhas:
head -n 3 gallery-index.csv
Liste o arquivo compactado com segurança, sem extraí-lo:
python3 -m zipfile -l gallery.zip
Ele contém index.csv e vinte JPEGs reais, incluindo o grupo recuperado e photos/photo-20.jpg. Os hashes da fonte e da miniatura conectam cada fotografia ao seu próprio resultado; apenas os nomes dos arquivos são insuficientes.
Por fim, confirme que ambas as tentativas continuam disponíveis:
kubectl get jobs -n photo-workshop
O first-try original está com falha, e o novo gallery-retry está concluído. Esse é o estado final pretendido. Deixe disponíveis o manifesto salvo, os downloads, os Pods bem-sucedidos e com falha, os quatorze JPEGs originais, as fontes e a referência. Se um download falhar ou estiver incompleto, corrija a carga de trabalho ou o serviço e baixe novamente; não conserte manualmente os arquivos recebidos.
Resumo
Você diagnosticou uma falha parcial de um Job indexado, preservou suas evidências nativas e usou um novo Job com novas tentativas finitas por índice para concluir a coleção real. Agora os arquivos derivados das fontes, os JPEGs originais bem-sucedidos, a galeria em execução, o manifesto salvo e a entrega coincidem.