Introdução
Quando um modelo de IA prepara uma resposta mais longa, esperar pelo resultado completo pode fazer o aplicativo parecer travado. O streaming permite que o aplicativo receba pequenos trechos assim que ficam prontos. É parecido com ler uma mensagem enquanto a outra pessoa ainda está digitando: a resposta completa exige praticamente o mesmo trabalho, mas o texto útil aparece mais cedo.
Este laboratório usa Server-Sent Events (SSE), um formato de texto para enviar uma sequência de eventos em uma única resposta HTTP. Cada evento do Workers AI começa com data:. Os eventos de texto carregam partes da resposta gerada, e um evento final data: [DONE] indica que o stream terminou normalmente. Uma pausa entre eventos significa apenas que o modelo ainda está trabalhando; sem um sinal de conclusão, o aplicativo não consegue distinguir uma resposta lenta de uma conexão que nunca terminará.
Você criará POST /help, transmitirá uma resposta do Llama hospedado na Cloudflare para um cliente de linha de comando fornecido e testará dois finais: conclusão normal e cancelamento deliberado após o primeiro trecho útil. Cancelamento significa que o cliente não precisa mais do restante da resposta e encerra o trabalho, em vez de deixar uma conexão não utilizada aberta. Você também usará testes determinísticos para provar que uma falha na inicialização do modelo se transforma em um erro limitado e que um stream interrompido termina em vez de travar.
Este é o segundo laboratório do curso. Presume-se que você saiba que um Cloudflare Worker é um código de aplicativo executado na rede da Cloudflare e que um binding AI disponibiliza o Workers AI como env.AI. Se você entrou diretamente no curso, conclua primeiro Conectar o LabEx à sua conta da Cloudflare para aprender a usar o terminal da VM, autorizar o Wrangler, confirmar sua conta de aprendizado e salvar o ID da conta.
O laboratório usa @cf/meta/llama-3.3-70b-instruct-fp8-fast e perguntas sintéticas pequenas. Atualmente, as contas Workers Free recebem uma alocação diária compartilhada de 10.000 Neurons. A inferência local também acessa a Cloudflare e consome essa alocação. Se a alocação se esgotar ou o modelo estiver sem capacidade, pare em vez de enviar solicitações repetidas; o aplicativo deve informar um erro terminal em vez de travar.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/help-stream. Ela fornece o cliente SSE, fixtures determinísticas e verificações independentes. A configuração não faz login, não invoca um modelo, não implanta um Worker nem cria um recurso na nuvem. Mantenha esta VM aberta até excluir o Worker descartável e confirmar o logout.
Autorizar a VM e configurar o Worker de streaming
Nesta etapa, você autorizará esta VM nova e configurará o Worker descartável de streaming. O login existente no Dashboard não concede automaticamente às instruções do terminal permissão para gerenciar a conta de aprendizado.
Entre no projeto preparado e confirme a versão fixada do Wrangler:
cd /home/labex/project/help-stream
npx wrangler --version
Espere 4.132.0. Solicite apenas as permissões necessárias aqui. O acesso de gravação a Workers Scripts gerencia o Worker descartável, o acesso de gravação ao Workers AI permite que o binding chame o modelo e os dois escopos de leitura identificam a conta selecionada. O Wrangler 4.132.0 também verifica dependências de bindings KV durante a exclusão do Worker; por isso, o escopo limitado de gravação em KV permite que o comando de limpeza seja concluído, embora este laboratório não crie dados KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra o link exibido, informe o código atual do dispositivo, verifique a conta e as permissões e autorize a conta de aprendizado. O Background Access também pode aparecer porque o Wrangler continua depois que o navegador é fechado. Volte ao terminal e aguarde a mensagem de sucesso. Em seguida, consulte os dados estruturados de identidade:
npx wrangler whoami --json
Confirme loggedIn: true e leia name e id da conta pretendida. Gere um nome exclusivo para o Worker descartável:
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Substitua YOUR_ACCOUNT_ID pelo ID real dessa conta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
O binding AI ficará disponível como env.AI. remote: true significa que o desenvolvimento local continuará usando o modelo real na nuvem. enable_request_signal faz com que request.signal indique quando o cliente se desconecta, permitindo que o Worker registre e trate um sinal de cancelamento. A observabilidade salva os eventos do ciclo de vida que você examinará mais tarde. Nenhum Worker foi implantado e nenhuma inferência foi executada ainda.
Inspecionar o binding de IA e o cliente SSE
Nesta etapa, você conectará o binding de IA ao cliente SSE fornecido antes de escrever o Worker. O modelo é o produtor, o Worker encaminha os bytes e client.mjs é o consumidor. Separar essas funções deixa claro qual componente deve encerrar o trabalho.
Gere os tipos do ambiente do Worker:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Procure AI: Ai. Isso significa que o binding configurado estará disponível para o handler como env.AI; ele não é uma chave de API armazenada no código-fonte.
Agora inspecione os resultados terminais do cliente fornecido:
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
O cliente lê a resposta pouco a pouco. Uma linha chunk: mostra o texto recém-gerado. complete aparece somente depois de data: [DONE]. O modo de cancelamento fecha o reader após o primeiro trecho não vazio. stream_error indica uma falha terminal, incluindo um timeout de 45 segundos; o timeout é um limite de segurança, não uma previsão de que toda resposta do modelo levará esse tempo.
Um evento SSE é texto simples separado por uma linha em branco. Um stream bem-sucedido típico é semelhante a este:
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
Os limites dos chunks são detalhes do transporte: um evento pode conter uma palavra, uma pontuação ou um trecho maior. A lógica do aplicativo deve combinar as strings response e aguardar [DONE], sem presumir uma quantidade ou um tamanho fixo de chunks.
Criar um endpoint de streaming monitorado
Nesta etapa, você criará o endpoint de streaming e o monitoramento do ciclo de vida. O Worker solicitará um stream ao modelo usando stream: true e exporá esse mesmo protocolo SSE ao cliente. Ele não armazenará primeiro a resposta inteira na memória. Um pequeno wrapper acompanha o ciclo de vida do stream: a conclusão fecha normalmente, o cancelamento cancela o reader upstream e um erro no stream encerra a resposta.
Crie o entrypoint do Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
O código registra IDs de solicitação e eventos do ciclo de vida, mas nunca registra a pergunta nem a resposta gerada. Um ID de solicitação relaciona uma resposta do cliente a uma entrada de log sem copiar o conteúdo de suporte para os dados de observabilidade. A resposta de erro também oculta detalhes internos do provedor; os operadores podem usar o log do ciclo de vida, enquanto os clientes recebem o contrato estável model_unavailable.
Execute os testes determinísticos. O binding de IA falso emite eventos controlados, falha antes do streaming, permite cancelamento e interrompe um stream sem consumir Neurons:
node --test test/worker.test.mjs
Espere seis testes aprovados. Em seguida, gere o bundle do Worker real sem implantá-lo:
npx wrangler deploy --dry-run
Os testes comprovam o comportamento do aplicativo sob condições de tempo controladas. O dry run comprova que o código-fonte e a configuração formam um bundle válido. Nenhum dos dois comprova que o modelo na nuvem está disponível neste momento; a próxima etapa usará um stream real.
Observar um stream local real
Nesta etapa, você observará um stream real por meio de um processo do Worker executado na VM. “Local” descreve o handler da solicitação; a inferência do modelo ainda acontece na conta selecionada e conta para a alocação diária.
Inicie o Wrangler em segundo plano e salve o ID do processo:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Aguarde a rota de integridade que não usa IA:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Agora use o cliente fornecido para fazer uma pergunta sintética pequena:
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Você deverá ver uma ou mais linhas chunk: seguidas por uma linha terminal semelhante a:
complete chunks=18 chars=238
O texto, a quantidade de chunks e a quantidade de caracteres serão diferentes. A evidência importante é receber conteúdo incremental não vazio seguido por [DONE], que o cliente converte em complete. Se aparecer stream_error, inspecione .labex/dev.log. Uma falha de cota, autorização ou capacidade é uma inferência malsucedida, não um motivo para esperar indefinidamente.
Por fim, confirme que a validação do aplicativo ainda acontece antes da inferência:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
Espere {"error":"invalid_question"} e HTTP 400. Um stream só é útil depois que uma solicitação comum passa pelas verificações de entrada.
Implantar, concluir e cancelar um stream
Nesta etapa, você implantará o Worker, concluirá um stream e cancelará outro após o primeiro trecho útil. Primeiro, pare somente o processo de desenvolvimento salvo e aguarde seu encerramento:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Implante o mesmo código do Worker:
npx wrangler deploy
Salve a URL exata de workers.dev exibida pelo Wrangler:
WORKER_URL="https://YOUR_WORKER_URL"
Primeiro, observe a conclusão normal:
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
A linha final complete significa que o modelo enviou [DONE]; receber apenas o primeiro trecho não comprovaria uma resposta completa.
Agora inicie um segundo stream e interrompa-o deliberadamente após o primeiro trecho não vazio:
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
Espere uma linha chunk: seguida por cancelled after 1 chunk. O cancelamento não é um erro do modelo: o cliente decidiu intencionalmente que não precisava mais do restante. Fechar o reader propaga o cancelamento para o stream upstream, enquanto o sinal da solicitação recebida permite que o Worker registre a desconexão.
Abra o Cloudflare Dashboard e acesse Workers & Pages → Overview → seu Worker labex-c07-a02-... → Observability → Logs. Encontre as solicitações recentes. A visão geral abaixo vem de uma execução descartável de aceitação: 14 Success e 0 Errors mostram que o Worker tratou suas verificações de integridade, streams concluídos e desconexões deliberadas sem uma invocação com falha. Seus totais e horários serão diferentes.
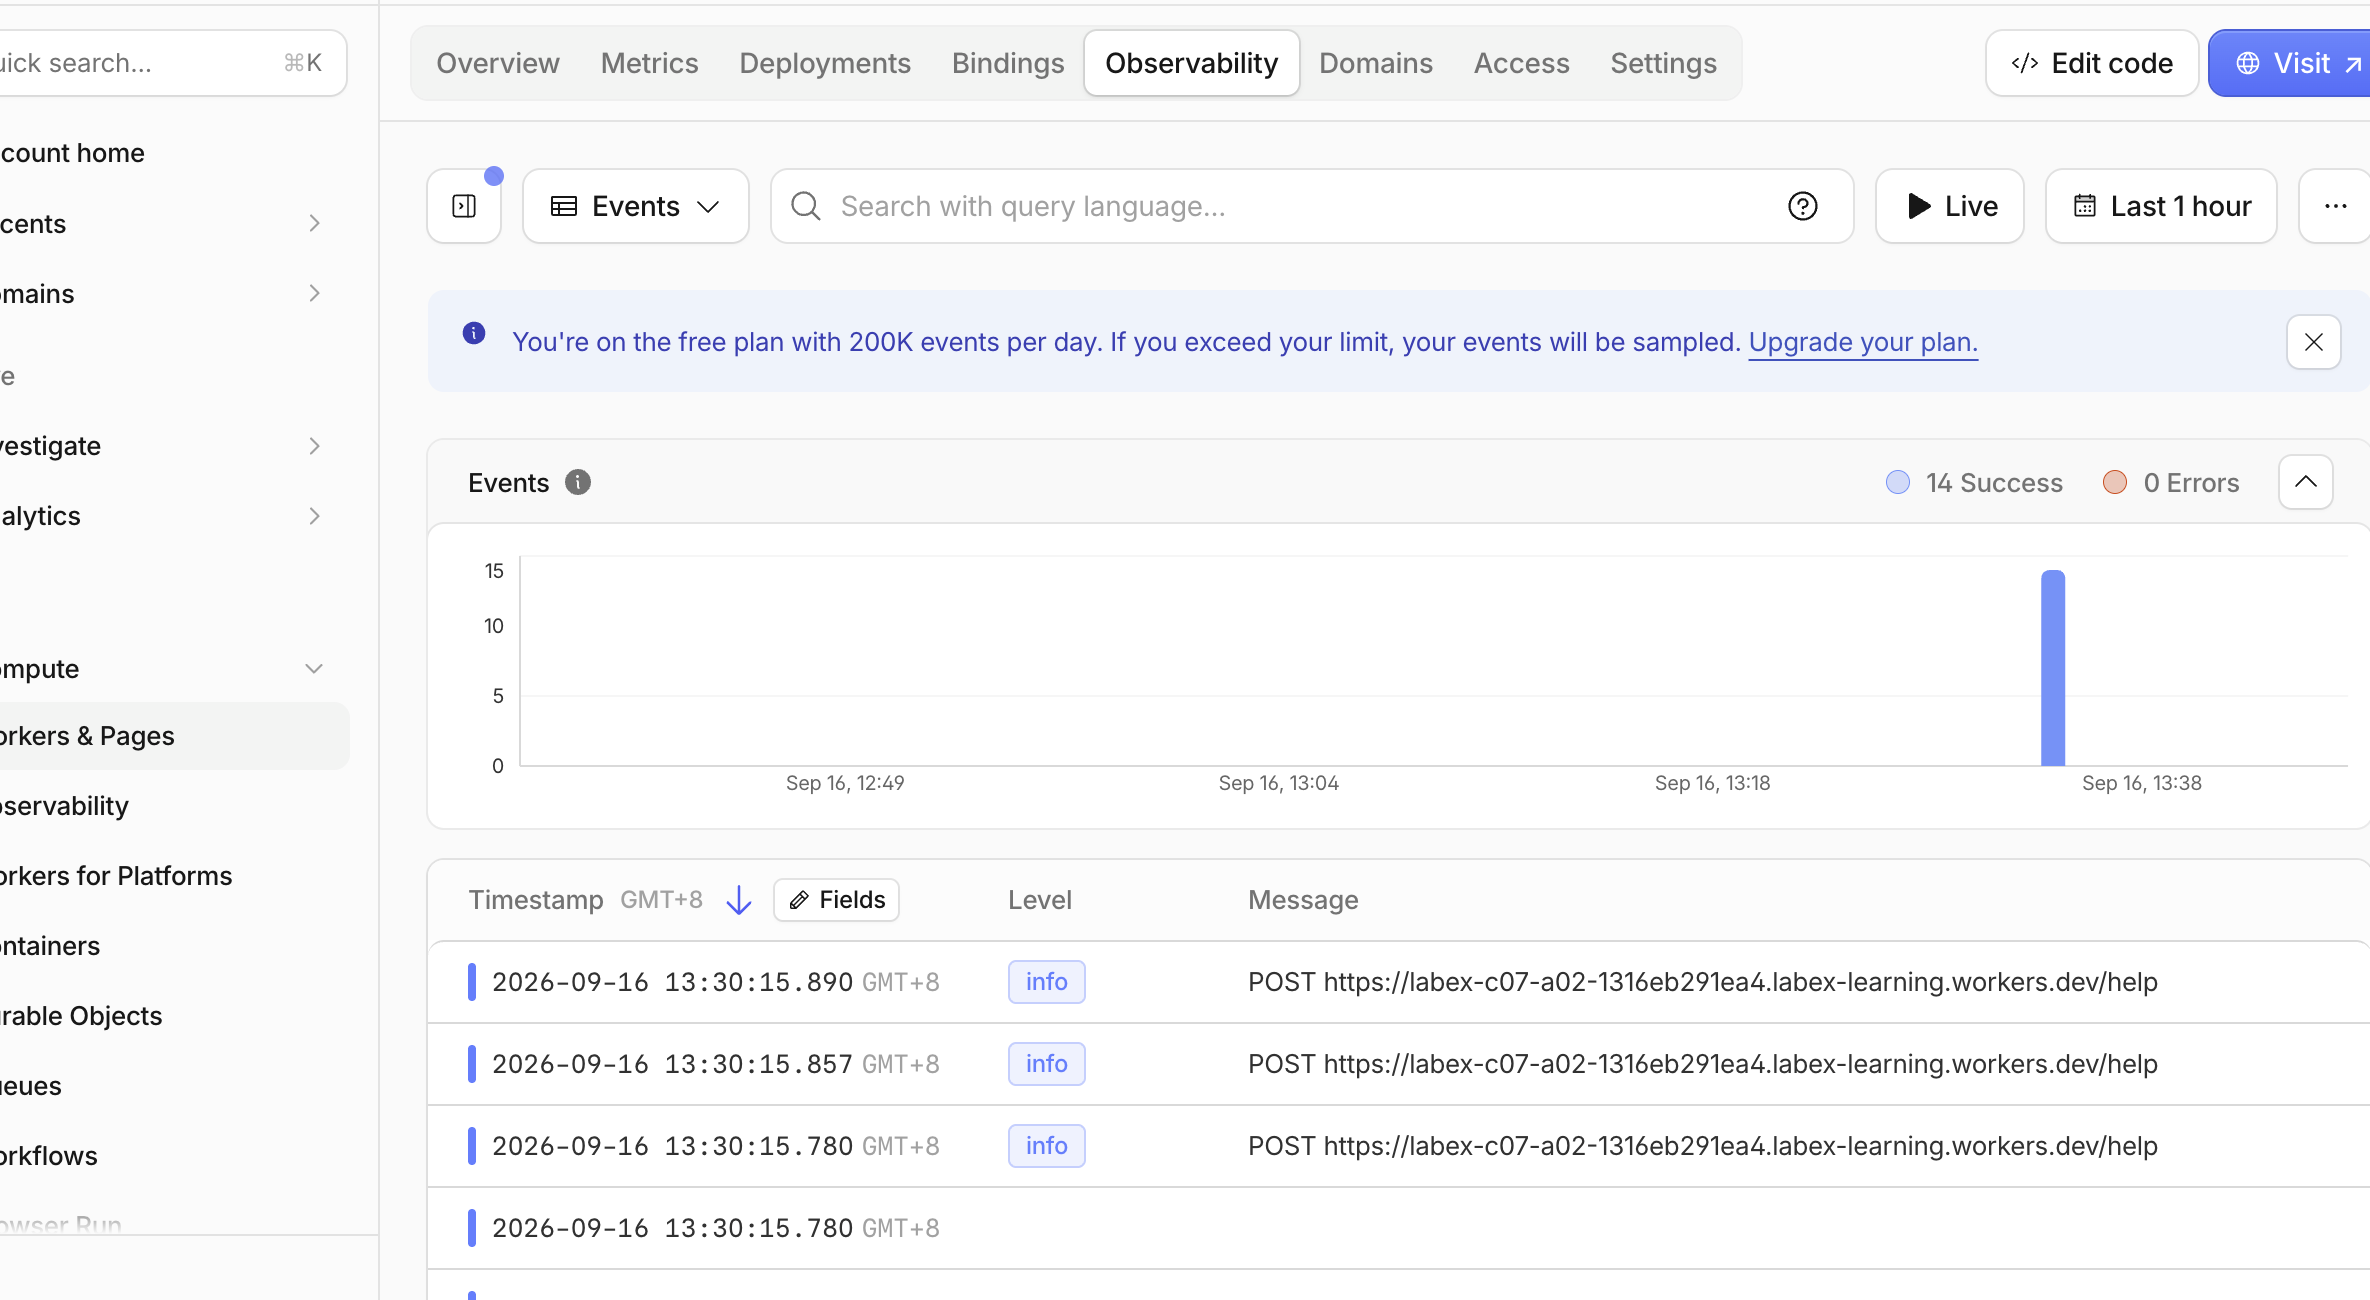
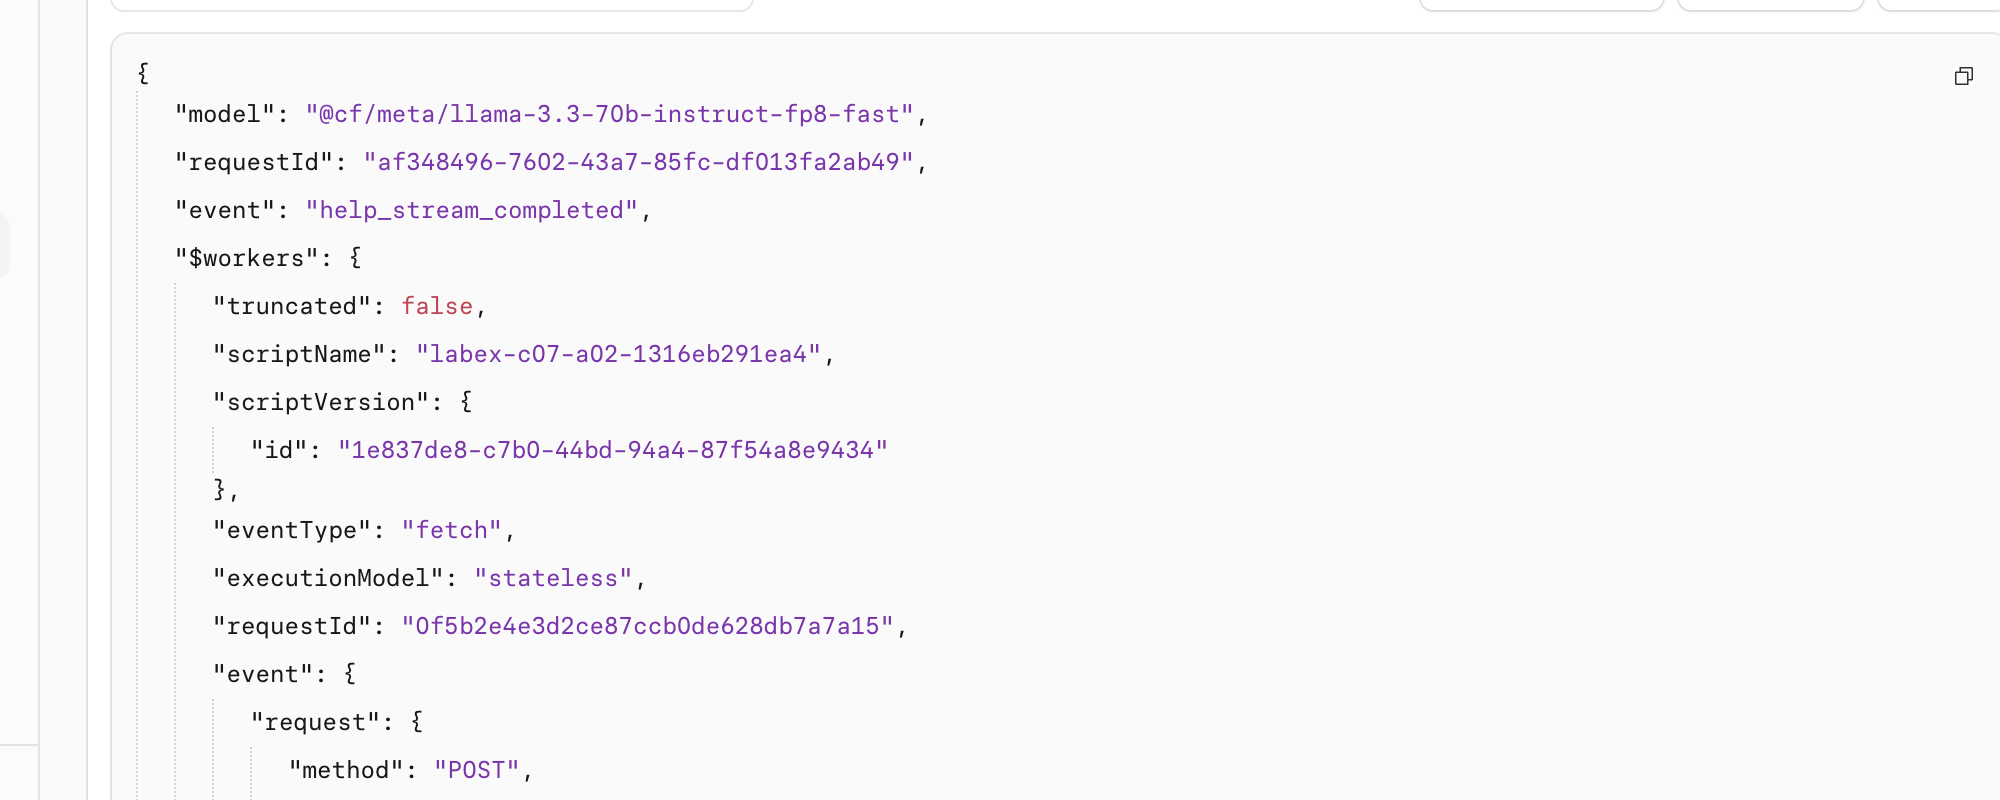
Pesquise help_stream_completed, expanda um resultado e confirme model, requestId e event. O ID de solicitação é um valor seguro para correlação: ele ajuda o operador a relacionar registros do ciclo de vida sem armazenar a pergunta do aluno nem a resposta gerada.
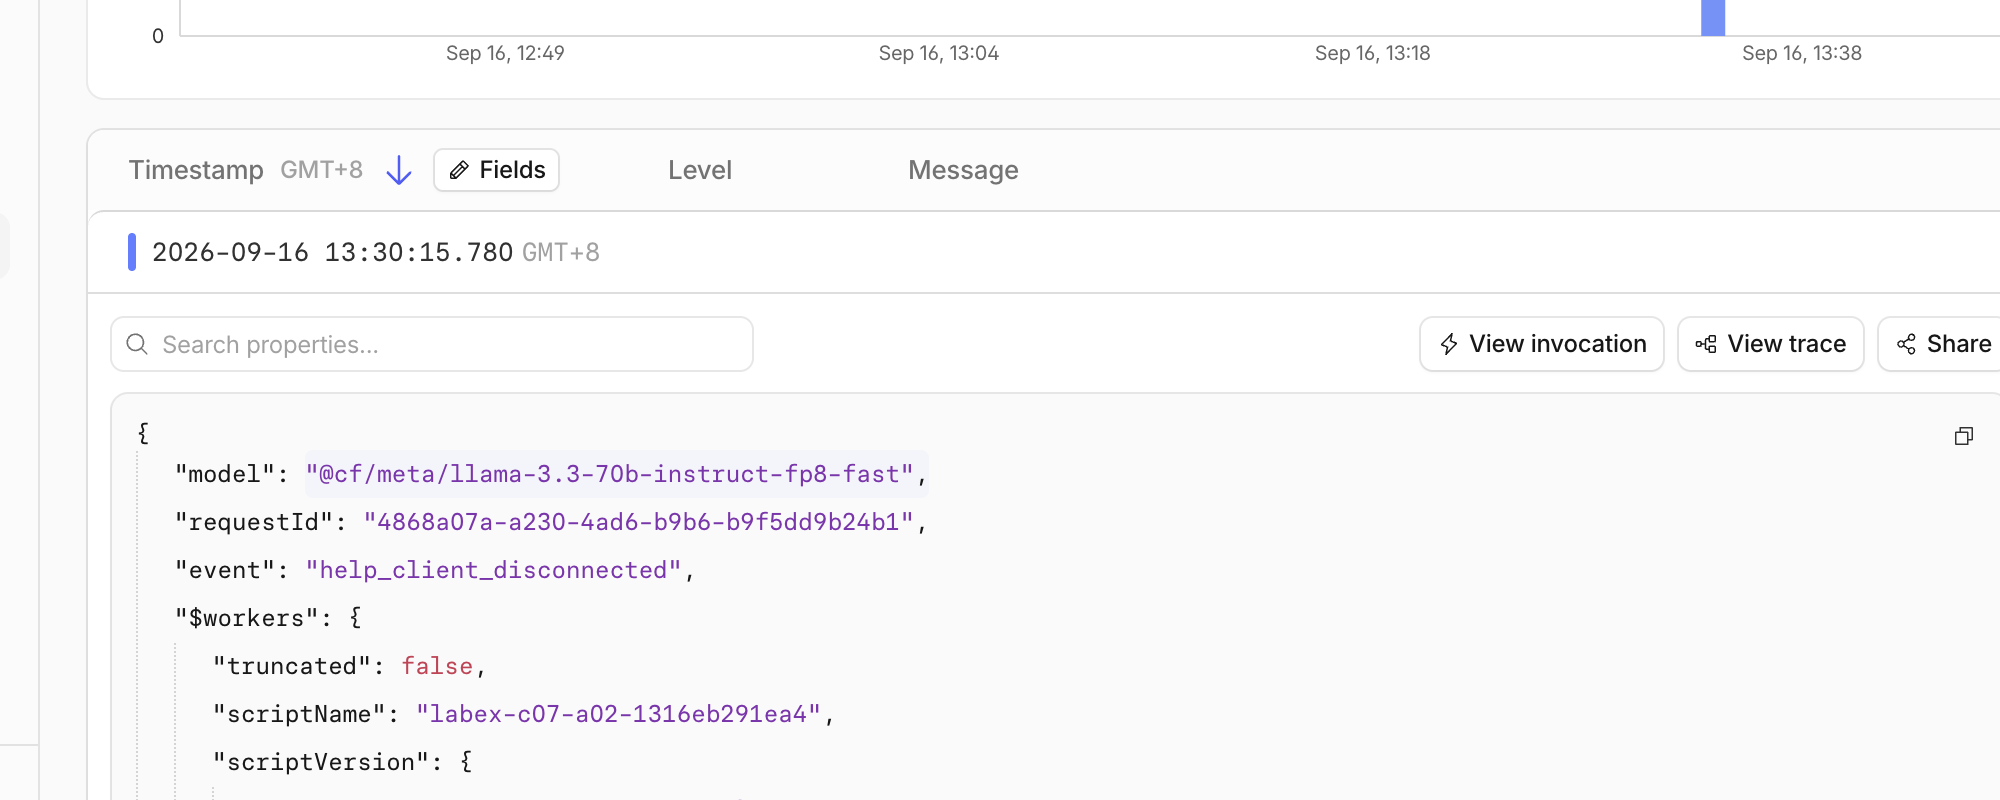
Para a solicitação pública cancelada deliberadamente, pesquise help_client_disconnected. Com enable_request_signal, esse evento é a evidência direta de que o cliente recebido se desconectou. O teste determinístico da Etapa 4 comprova separadamente que o cancel() downstream chega ao fixture do modelo e registra help_stream_cancelled; o tempo real da rede pode fazer com que o evento de sinal da solicitação seja o registro visível na nuvem. Os logs salvos podem chegar depois da resposta; aguarde brevemente e faça no máximo mais uma solicitação de cancelamento limitada, se necessário.
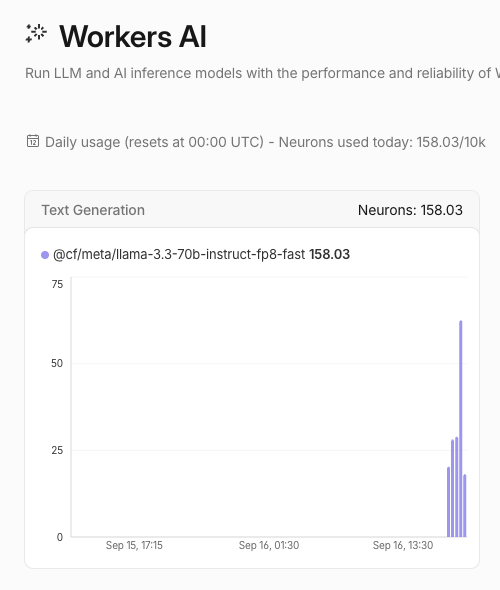
Depois, abra Workers AI e examine o uso do modelo hoje. Encontre o modelo Llama 3.3 e confirme que os exercícios pequenos continuam dentro da alocação Free de 10.000 Neurons. No exemplo abaixo, todo o trabalho na conta de aprendizado usou 158.03/10k Neurons; isso inclui outros exercícios nessa conta, portanto seu número será diferente. Um plano Workers Paid não é necessário para este laboratório enquanto a conta permanecer dentro da alocação Free. O uso pode demorar para aparecer; não repita a inferência apenas para forçar a atualização de um gráfico.
O nome do Worker, os IDs de solicitação, os horários e o uso mostrados nessas capturas são exemplos de uma execução descartável. Os nomes dos eventos e a relação entre os eventos do ciclo de vida — não os valores exatos — são os objetivos de aprendizagem.
Remover o Worker e fazer logout
Nesta etapa, você removerá o Worker descartável e depois fará logout desta VM. Os registros de uso do Workers AI são históricos no nível da conta; portanto, excluir o Worker remove seu endpoint público, mas não apaga esses registros históricos nem altera o plano da conta.
Exclua exatamente o Worker indicado em wrangler.jsonc:
npx wrangler delete
Confirme somente quando o Wrangler mostrar o nome exclusivo deste laboratório, labex-c07-a02-.... O comando deve terminar com Successfully deleted. No Dashboard, atualize Workers & Pages → Overview e confirme que esse nome exato não está mais presente.
Enquanto a VM ainda estiver autorizada, execute a verificação independente de gerenciamento:
python3 .labex/verify.py deleted
Somente depois que o comando informar PASS: deleted, remova a autorização armazenada desta VM:
npx wrangler logout
npx wrangler whoami --json
Exija loggedIn: false. Um arquivo local ausente, uma aba do navegador fechada ou um erro de rede não comprovaria a exclusão na nuvem nem o logout.
Resumo
Você criou um endpoint do Workers AI que encaminha a saída SSE incremental em vez de armazenar uma resposta completa em buffer. Aprendeu por que o cliente precisa de um sinal explícito [DONE], como um timeout impede uma espera indefinida, como o cancelamento deliberado se diferencia de uma falha e como os erros do stream terminam corretamente. Você verificou a inferência real local e implantada, relacionou os eventos do ciclo de vida à observabilidade do Dashboard, removeu o Worker descartável e fez logout da VM nova.