Introdução
Na V03, você transformou uma pergunta em um embedding e recuperou artigos de ajuda semanticamente próximos. No entanto, um sistema de suporte real geralmente atende mais de um cliente, e a similaridade semântica, sozinha, nunca deve decidir quais documentos de um cliente podem ser exibidos a quem fez a solicitação.
Neste laboratório, você adicionará dois limites à pesquisa. Um namespace do Vectorize é uma partição dentro de um único índice; ao pesquisar em um namespace, os vetores de todos os outros namespaces são excluídos antes do início da classificação por similaridade. Em seguida, um filtro de metadados restringe essa partição do cliente por um campo como category. Pense no namespace como a escolha do arquivo correto e no filtro de categoria como a escolha de uma gaveta dentro dele.
Nenhum desses mecanismos autentica uma pessoa. Primeiro, a aplicação precisa validar um login, token ou outro sinal de identidade e derivar o namespace no servidor. Para manter o exercício seguro e reproduzível, este Worker usa dois rótulos públicos de sessão sintéticos que representam sessões já validadas. Eles são recursos didáticos, não credenciais reais nem um sistema de autenticação completo. Uma solicitação nunca pode escolher o próprio cliente ou namespace.
Você implantará um Worker descartável com bindings para Workers AI e Vectorize. Quatro artigos sintéticos incluem deliberadamente o mesmo texto de senha em dois namespaces de clientes. Embeddings reais tornam a pesquisa mais próxima de um cenário real, enquanto verificações exatas de namespace, categoria e ID comprovam o isolamento sem avaliar as pontuações exatas de um modelo. Você também testará um resultado vazio autorizado e rejeitará uma tentativa de substituir o escopo antes que ela possa chamar qualquer um dos serviços de nuvem.
Se você entrou diretamente neste curso, primeiro conclua Conectar o LabEx à sua conta da Cloudflare. V01–V03 também são pré-requisitos: eles apresentam índices compatíveis, mutações assíncronas e recuperação semântica.
O índice pequeno e as solicitações limitadas ao BGE Small são compatíveis com as alocações documentadas do Workers Free; o Workers Paid não é necessário. Chamadas locais ou implantadas ao modelo ainda consomem a alocação diária compartilhada do Workers AI da conta. Portanto, pare em vez de repetir tentativas se essa alocação estiver indisponível.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local ao projeto em /home/labex/project/scoped-vector-search. Ela fornece testes determinísticos e verificações independentes somente de leitura, mas não autoriza o Wrangler, cria um índice, implanta um Worker, executa inferência nem insere dados na nuvem.
Autorizar e nomear os recursos da pesquisa com escopo
Nesta etapa, você autorizará a VM recém-criada e descreverá um Worker e seu índice Vectorize correspondente usando uma configuração comum do Wrangler.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/scoped-vector-search
npx wrangler --version
O resultado esperado é 4.132.0. A autorização por dispositivo permite que a VM receba uma concessão OAuth temporária sem receber sua senha da Cloudflare. Os escopos solicitados abrangem a identidade da conta, o índice descartável, a implantação do Worker e o binding do Workers AI usado para gerar embeddings:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Abra o link exibido no navegador, informe o código atual e aprove a conta de aprendizagem pretendida. De volta ao terminal, confirme loggedIn: true, authType: OAuth Token e o nome da conta antes de copiar o ID.
Gere um sufixo aleatório e derive o nome do índice a partir do nome do Worker. Esse padrão de propriedade torna a limpeza posterior precisa:
RUN="labex-c08-v04-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Substitua YOUR_ACCOUNT_ID pelo ID exibido por whoami. Um binding fornece ao código do Worker um nome local para um serviço da Cloudflare: AI criará embeddings, e DOCUMENTS consultará exatamente o índice indicado por index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
O arquivo nomeia os recursos pretendidos, mas ainda não cria nada. Manter a identidade e a propriedade explícitas antes de uma operação de gravação é especialmente importante em uma conta de aprendizagem compartilhada.
Criar um Worker de pesquisa com escopo definido no servidor
Nesta etapa, você implementará o limite de segurança antes de implantá-lo.
O cabeçalho x-lab-session usa apenas dois rótulos públicos para simular o resultado de uma camada de autenticação anterior. resolveSession mapeia esse contexto validado para um namespace no servidor. O corpo da solicitação pode escolher uma consulta e uma categoria permitida, mas não pode informar um cliente ou namespace. Em uma aplicação de produção, substitua esses rótulos por uma sessão ou provedor de identidade devidamente verificado; um namespace organiza dados, mas não é autenticação.
Os quatro documentos incluem texto de senha idêntico para os clientes blue e green. Isso torna o resultado de segurança fácil de observar: a similaridade não consegue distinguir as cópias, portanto somente o escopo controlado pelo servidor pode mantê-las separadas.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);
const SESSION_CONTEXTS = Object.freeze({
  "blue-session": Object.freeze({ customer: "blue", namespace: "customer-blue" }),
  "green-session": Object.freeze({ customer: "green", namespace: "customer-green" })
});

const DOCUMENTS = [
  {
    id: "blue-password",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "blue-invoice",
    namespace: "customer-blue",
    category: "billing",
    title: "Download an invoice",
    text: "Download an invoice or receipt for a completed payment."
  },
  {
    id: "green-password",
    namespace: "customer-green",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "green-upload",
    namespace: "customer-green",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function resolveSession(label) {
  const context = SESSION_CONTEXTS[label];
  if (!context) throw new Error("session_invalid");
  return context;
}

export function parseSearchInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const query = typeof value.query === "string" ? value.query.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!query || query.length > 200) throw new Error("query_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { query, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    namespace: document.namespace,
    values: vectors[index],
    metadata: {
      category: document.category,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "scoped_documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let context;
  try {
    context = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch (error) {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 3,
    namespace: context.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });
  const matches = result.matches.map((match) => ({
    id: match.id,
    score: match.score,
    namespace: match.namespace,
    title: match.metadata?.title,
    category: match.metadata?.category
  }));
  console.log(JSON.stringify({
    event: "scoped_search",
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    returnedCount: matches.length
  }));
  return json({
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    candidateCount: result.matches.length,
    matches
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Execute os testes determinísticos. Os bindings em memória comprovam que o Worker constrói os dois limites da consulta a partir do contexto do servidor sem consumir a cota da nuvem:
node --test test/worker.test.mjs
Você deve obter seis testes aprovados. Gere os tipos dos bindings a partir da configuração real e depois crie o bundle sem implantá-lo:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v04-dry-run
O arquivo gerado deve conter AI: Ai e DOCUMENTS: VectorizeIndex. A simulação de implantação comprova que o código-fonte e a configuração podem ser empacotados juntos; ela não cria nem testa nenhum dos dois recursos da nuvem.
Criar o índice filtrável e fazer a implantação
Nesta etapa, você criará o índice compatível, preparará o campo category para filtragem e implantará o Worker somente depois que essa preparação for processada.
Um vetor pode armazenar metadados sem torná-los pesquisáveis. Um índice de metadados informa ao Vectorize qual campo deve ser organizado para consultas que filtram primeiro. Ele precisa existir antes da inserção dos vetores dos documentos; caso contrário, os registros anteriores não participarão desse filtro de metadados.
Crie um índice de 384 dimensões com métrica de cosseno, compatível com o BGE Small. --update-config=false impede que o Wrangler reescreva o binding explícito que você já revisou:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Agora, enfileire a preparação do campo de texto category e preserve o identificador da mutação:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Uma mutação aceita é um trabalho enfileirado, não um trabalho concluído. Crie um único verificador limitado, somente de leitura, que você reutilizará depois da inserção dos documentos. Ele exige três leituras consecutivas da mesma mutação e da mesma quantidade de vetores, para que uma leitura temporariamente desatualizada não se torne a evidência final do laboratório:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
A mutação pode ser processada antes que a visualização separada da lista seja atualizada. Use um loop limitado e somente de leitura para aguardar a linha category visível, em vez de considerar uma única resposta desatualizada da lista como falha:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Você deve ver category com o tipo String. Por fim, implante o Worker cujo binding DOCUMENTS aponta para esse índice preparado:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
O índice ainda está vazio. A implantação conecta os bindings; ela não cria embeddings dos documentos automaticamente.
Inserir dados nos namespaces dos dois clientes
Nesta etapa, você criará embeddings reais e armazenará cada registro exatamente em um namespace de cliente, junto com seus metadados de categoria.
Um namespace pertence ao próprio registro vetorial. Os dois registros de senha contêm deliberadamente texto idêntico, mas vivem em partições diferentes. category é um metadado separado; portanto, um registro pode pertencer ao namespace blue e à categoria account ao mesmo tempo.
Chame o endpoint fixo de inserção uma vez. O corpus é controlado pelo servidor, por isso o corpo da solicitação fica vazio:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " scoped vectors in mutation " + value.mutationId);
'
Você deve obter count: 4, 384 dimensões, pooling cls e um UUID de mutação. Aguarde essa mutação e essa quantidade exatas, em vez de adivinhar quantos segundos o serviço precisa:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 4
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'blue-password' <<<"$VECTOR_LIST" &&
     grep -q 'blue-invoice' <<<"$VECTOR_LIST" &&
     grep -q 'green-password' <<<"$VECTOR_LIST" &&
     grep -q 'green-upload' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in blue-password blue-invoice green-password green-upload; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed vector %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
O inventário deve conter blue-password, blue-invoice, green-password e green-upload. Os IDs relacionam os resultados aos documentos de origem; o namespace e a categoria determinam se um registro, mesmo semelhante, pode participar de uma consulta.
Comprovar o isolamento por cliente e categoria
Nesta etapa, você fará a mesma pergunta semântica como dois clientes e depois testará um resultado vazio autorizado e uma substituição de escopo insegura.
Comece com a sessão sintética blue e a categoria account:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/blue-account.json
A resposta deve informar customer: blue, namespace: customer-blue e somente blue-password. Agora envie a mesma pergunta com a sessão green:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: green-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/green-account.json
Desta vez, somente green-password pode participar. O texto do documento é idêntico, portanto essa diferença vem do namespace selecionado pela sessão validada, não do modelo de embeddings nem de uma pontuação favorável por acaso.
Em seguida, solicite a categoria files na sessão blue. Existe um artigo de upload green altamente relevante, mas o namespace blue não contém nenhum artigo de arquivos:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files"}' \
  | tee .labex/blue-files-empty.json
Você deve obter candidateCount: 0 e matches: []. Vazio é a resposta autorizada correta; pegar um registro relevante de outro namespace causaria um vazamento de dados.
Por fim, tente substituir o namespace no corpo da solicitação:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files","namespace":"customer-green"}'
cat .labex/override-response.json
Você deve obter HTTP 400 e scope_override_not_allowed. O Worker rejeita o campo antes de executar a inferência ou a consulta no Vectorize. Um cliente pode solicitar uma categoria permitida, mas somente a lógica confiável do servidor pode mapear a identidade para um namespace de cliente.
Abra Workers & Pages → seu Worker labex-c08-v04-... → Bindings. Confirme que AI aponta para o Workers AI e que DOCUMENTS aponta para o índice Vectorize descartável exato. Essa relação visual explica como env.AI e env.DOCUMENTS no código chegam aos serviços gerenciados; as verificações independentes ainda comprovam as identidades exatas dos bindings.
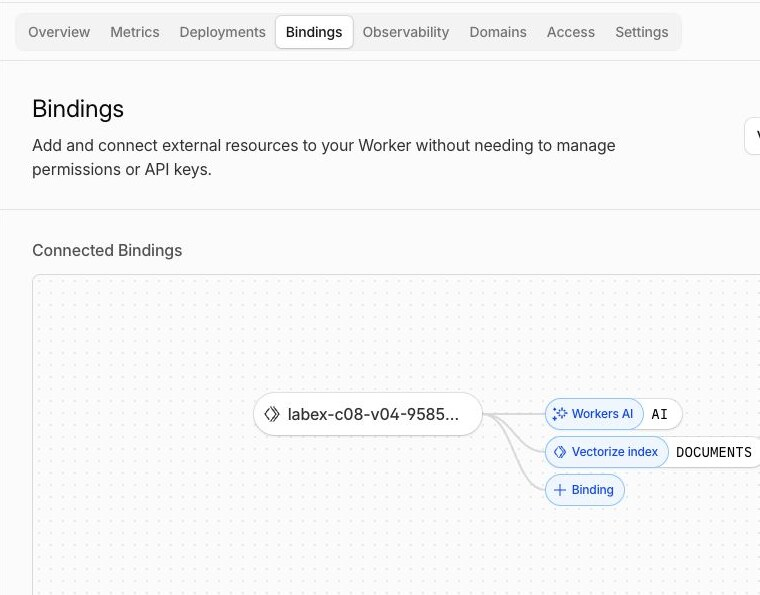
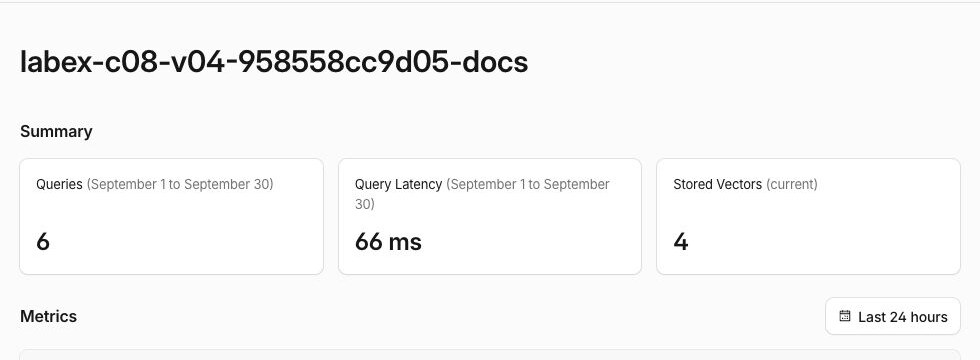
Depois, abra AI → Vectorize → o índice -docs correspondente. A quantidade atual de vetores deve eventualmente chegar a quatro, e as métricas de consulta devem começar a refletir as pesquisas com escopo. Os contadores do painel podem demorar para atualizar; as leituras autenticadas dos registros e as respostas HTTP continuam sendo a autoridade para IDs, namespaces e categorias exatos.
Se os Logs do Workers estiverem disponíveis, abra a visualização Observability → Logs do Worker e examine uma entrada scoped_search. Ela registra apenas o rótulo sintético do cliente, o namespace, a categoria e a quantidade retornada — não o texto da pergunta nem o rótulo da sessão. Logs estruturados e limitados em relação à privacidade ajudam a diagnosticar qual escopo selecionado pelo servidor foi executado sem copiar conteúdo sensível da solicitação.
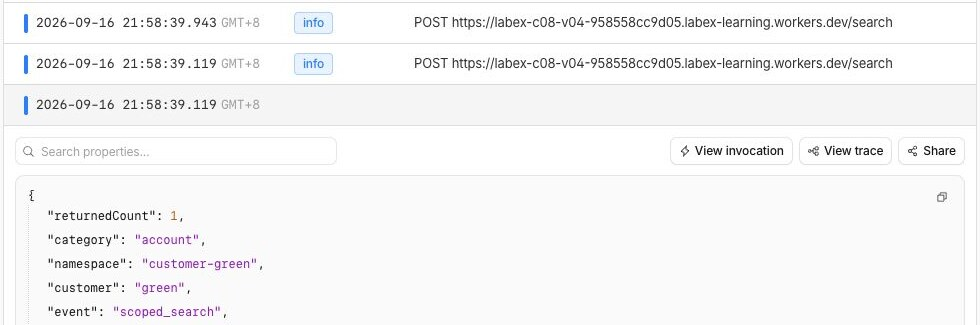
Estas capturas de tela são exemplos focados de uma execução de teste descartável. O nome aleatório do seu recurso, os horários, a latência e o total de consultas serão diferentes; compare os nomes dos bindings, a quantidade atual de vetores e as relações entre os campos, em vez de copiar os valores dos exemplos.
Remover os recursos da pesquisa com escopo
Nesta etapa, você removerá o Worker e o índice descartáveis e comprovará que eles não existem mais enquanto o Wrangler ainda estiver autorizado.
Recupere os nomes exatos de wrangler.jsonc para que a limpeza não dependa de variáveis de uma sessão de terminal anterior:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Confirme que os dois valores começam com o prefixo exclusivo labex-c08-v04-.... Exclua primeiro o Worker, para que nenhum código implantado mantenha o binding, e depois exclua somente o índice correspondente:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Salve um inventário autenticado bem-sucedido e verifique o nome exato:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Conclua esta etapa antes de sair da sessão. Uma falha de rede ou de autorização é inconclusiva; a avaliação exige independentemente leituras bem-sucedidas da conta e a ausência do nome exato.
Sair da VM de aprendizagem
Nesta etapa, você removerá a autorização temporária do Wrangler nesta VM. Os recursos da nuvem já foram removidos, e a verificação de limpeza autenticada foi aprovada:
npx wrangler logout
npx wrangler whoami --json
Você deve obter loggedIn: false. A sessão do navegador no Cloudflare Dashboard é separada e continua disponível para sua conta de aprendizagem.
Resumo
Você adicionou duas verificações independentes de elegibilidade à recuperação semântica. Uma sessão sintética validada selecionou um namespace de cliente no servidor, e um campo category indexado restringiu essa partição antes de o Vectorize classificar os resultados. Documentos de senha idênticos comprovaram que a similaridade, sozinha, não consegue impor o isolamento entre clientes, enquanto a consulta de arquivos do cliente blue mostrou que um resultado vazio autorizado é mais seguro do que pegar um registro relevante de outro cliente.
Você também rejeitou substituições de cliente e namespace fornecidas pelo cliente antes da inferência, inspecionou no Dashboard as relações reais entre binding, índice e logs com privacidade limitada, removeu o Worker e o índice descartáveis enquanto ainda estava autorizado e, em seguida, encerrou a sessão. A V05 reutilizará esse limite seguro de recuperação para reunir evidências de origem limitadas antes que um modelo de linguagem responda.