Introdução
A V01 armazenou os vetores identificados, e a V02 manteve esses registros atualizados. Este laboratório adiciona o caminho de leitura que faltava: uma pessoa digita uma pergunta, a aplicação transforma esse texto em um vetor compatível e pergunta ao Vectorize quais documentos armazenados apontam para as direções mais próximas.
Isso é pesquisa semântica. Ela compara embeddings orientados ao significado, em vez de exigir que a consulta repita as palavras exatas de um artigo. A consulta e os documentos armazenados devem usar o mesmo modelo, 384 dimensões e o pooling cls. Uma pontuação de similaridade do Vectorize ajuda a classificar vetores compatíveis para uma consulta; ela não é uma porcentagem universal de confiança nem prova que um artigo responde à pergunta.
Você criará um Worker descartável com dois bindings do Cloudflare. AI enviará textos curtos para o modelo de embeddings hospedado no Cloudflare, @cf/baai/bge-small-en-v1.5. DOCUMENTS gravará e consultará um índice descartável do Vectorize. O Worker expõe uma operação fixa /seed para três artigos de ajuda sintéticos e uma operação /search que aceita uma consulta, topK e uma pontuação mínima opcional. topK significa “retorne no máximo esta quantidade de candidatos mais próximos”, e não “estes candidatos são definitivamente relevantes”.
Este é o terceiro laboratório do Vectorize. Se você entrou diretamente, primeiro conclua Conectar o LabEx à sua conta do Cloudflare, depois conclua a V01 e a V02 para se familiarizar com a compatibilidade do índice, os IDs estáveis e as mutações assíncronas.
O Vectorize e o Workers AI têm cotas gratuitas. Este laboratório armazena três vetores pequenos e faz apenas algumas solicitações curtas de embeddings. Ele não exige o Workers Paid. A inferência local ou implantada ainda consome a cota diária compartilhada do Workers AI. Portanto, pare em vez de repetir tentativas se o modelo ou a cota gratuita estiver indisponível.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local ao projeto em /home/labex/project/vector-search. Ela fornece testes determinísticos e verificações independentes, mas não autoriza o Wrangler, chama um modelo, cria um índice, implanta um Worker nem grava dados na nuvem.
Autorizar e nomear os recursos de pesquisa
Nesta etapa, você autorizará a VM recém-criada e criará uma configuração que nomeia o Worker e o índice do Vectorize associado a ele.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/vector-search
npx wrangler --version
Espere 4.132.0. O Wrangler usa um fluxo de dispositivo para que sua senha nunca entre na VM. Solicite acesso à identidade da conta, ao Worker, ao Vectorize e ao Workers AI para este exercício descartável:
O Wrangler separa a operação do índice da implantação do script e das verificações de limpeza. Solicite workers:write para o Vectorize, workers_scripts:write para o Worker, workers_kv:write para a verificação de exclusão segura de dependências do Wrangler e ai:write para o binding do modelo:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Confirme loggedIn: true e a conta de aprendizagem correta. Gere um sufixo aleatório e derive os dois nomes de recursos a partir dele para que a limpeza não os confunda com recursos não relacionados:
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Substitua YOUR_ACCOUNT_ID pelo ID real da conta selecionada. Um binding é o nome pelo qual o código do Worker recebe um serviço gerenciado do Cloudflare. AI fornecerá a inferência do modelo; DOCUMENTS fornecerá exatamente o índice do Vectorize nomeado por index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
A configuração nomeia os recursos, mas não os cria. Essa separação permite inspecionar o limite de propriedade pretendido antes que qualquer coisa seja alterada na conta.
Criar o Worker de pesquisa com os bindings
Nesta etapa, você implementará a gravação fixa dos documentos e o endpoint de pesquisa voltado ao usuário antes de implantar qualquer código.
Os três documentos de origem permanecem no código da aplicação porque o Vectorize armazena vetores e metadados, não o sistema completo de registro dos artigos. /seed gera embeddings desse corpus fixo uma vez. /search gera o embedding de uma consulta validada, solicita ao Vectorize os topK candidatos mais próximos e aplica minScore depois. Os metadados retornados ajudam a aplicação a transformar os IDs dos vetores em referências úteis.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Execute os testes determinísticos. Eles substituem os dois bindings por pequenos fixtures em memória. Assim, verificam a validação e o fluxo de controle sem consumir a cota do AI ou do Vectorize:
node --test test/worker.test.mjs
Espere cinco testes aprovados. Em seguida, gere os tipos dos bindings e peça ao Wrangler para empacotar o Worker sem implantá-lo:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
O arquivo de tipos gerado deve conter AI: Ai e DOCUMENTS: VectorizeIndex. Uma execução de teste comprova que o módulo e a configuração podem ser empacotados juntos; ela não comprova que os serviços de nuvem existem.
Criar o índice e implantar os dois bindings
Nesta etapa, você criará o índice vazio compatível e, em seguida, implantará o Worker que recebe os dois bindings gerenciados.
O modelo de embeddings retorna 384 números. A distância cosseno compara a direção desses números, portanto crie um índice com o mesmo contrato imutável:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Implante o Worker somente depois que o índice existir, porque o Cloudflare precisa associar o binding DOCUMENTS configurado a um recurso real:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
O Wrangler deve listar os dois bindings e exibir a URL workers.dev. Salve a URL exata em vez de tentar reconstruir um subdomínio por suposição:
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
Neste ponto, o índice está intencionalmente vazio. A implantação conecta os serviços; ela não gera embeddings nem grava documentos automaticamente.
Gravar embeddings de documentos reais
Nesta etapa, você chamará a operação fixa /seed uma vez, registrará a mutação e aguardará até que os três embeddings do modelo possam ser lidos.
O Worker envia os três textos curtos dos documentos ao BGE Small em um único lote. Ele valida o formato retornado, associa IDs estáveis e metadados úteis e, depois, faz o upsert dos registros. Chame a operação com um objeto JSON vazio porque o corpus é controlado pelo servidor:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
Espere dados HTTP 202 contendo count: 3, 384 dimensões, pooling cls e um UUID de mutação. A mutação aceita é assíncrona; portanto, crie a mesma verificação de estabilidade limitada usada nos laboratórios anteriores. execFileSync executa o processo fixado do Wrangler, enquanto readFileSync lê a resposta de seed salva; eles vêm de módulos internos diferentes do Node.js:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
As três leituras correspondentes protegem o resultado visível contra uma réplica temporariamente desatualizada. Depois que o processo de espera for concluído, liste os IDs estáveis da aplicação:
npx wrangler vectorize list-vectors "$INDEX" --count=10
O inventário deve conter password-reset, upload-pdf e billing-receipt. Os valores reais vieram do modelo hospedado no Cloudflare, e não dos vetores didáticos determinísticos usados na V01 e na V02.
Recuperar e interpretar artigos semelhantes
Nesta etapa, você enviará uma pergunta clara sobre senha, examinará os dois candidatos mais próximos e distinguirá uma classificação de um resultado vazio explícito.
Solicite topK: 2. O Vectorize pode examinar todo o índice pequeno, mas retornará no máximo os dois candidatos mais próximos. O primeiro resultado deve ser o artigo sobre senha, porque a consulta e o artigo têm um significado fortemente relacionado, embora a formulação exata seja diferente:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
Espere duas linhas ordenadas pela pontuação decrescente, com password-reset na primeira posição. Leia as pontuações de forma comparativa: um valor maior indica maior proximidade para esta consulta e este índice compatíveis, mas 0.8 não significa “80% correto”. topK também não aplica um limite de relevância.
Agora faça uma pergunta não relacionada e defina minScore: 1. O Vectorize ainda retornará três candidatos à aplicação, mas a aplicação removerá todos os candidatos abaixo do limite:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
Espere candidateCount: 3 e matches: []. Uma lista de correspondências vazia é uma decisão explícita da aplicação, não uma prova de que o índice não contém vetores.
Por fim, envie uma entrada vazia:
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
Espere HTTP 400 e query_required. A validação acontece antes da chamada ao modelo ou ao banco de dados, portanto uma entrada inválida não consome capacidade de inferência nem de consulta.
Abra Workers & Pages → seu Worker labex-c08-v03-... → Bindings. Um binding fornece ao código do Worker um nome seguro para outro serviço do Cloudflare. Aqui, AI é o nome usado por env.AI para executar o modelo de embeddings, enquanto DOCUMENTS é o nome usado por env.DOCUMENTS para consultar exatamente este índice do Vectorize.
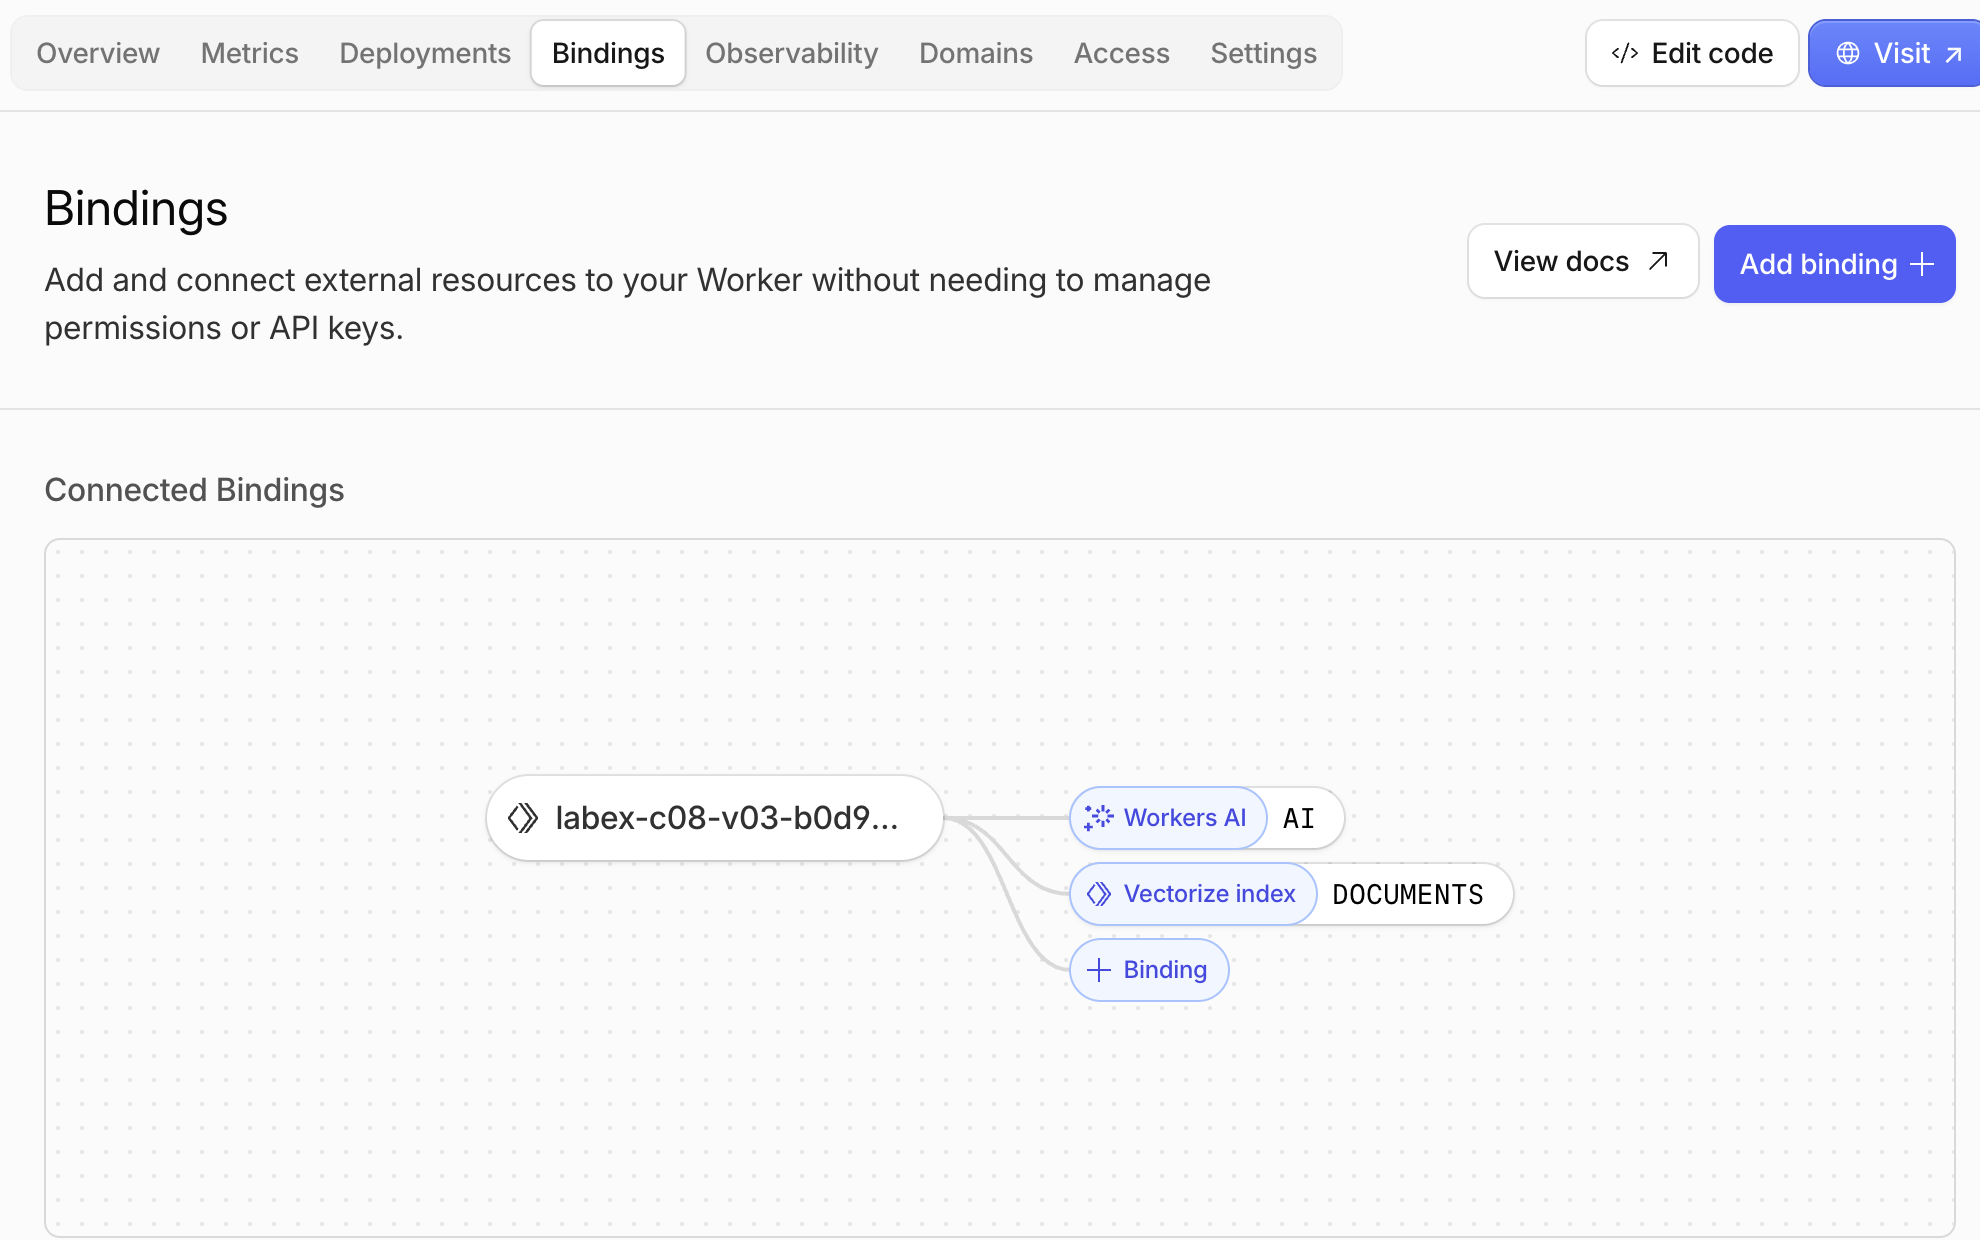
Em seguida, abra AI → Vectorize → o índice -docs correspondente. O resumo deve mostrar três vetores atuais: um para cada artigo de ajuda que você gravou. O total de consultas pode ser diferente do exemplo porque cada pesquisa bem-sucedida adiciona outra consulta, inclusive verificações repetidas.
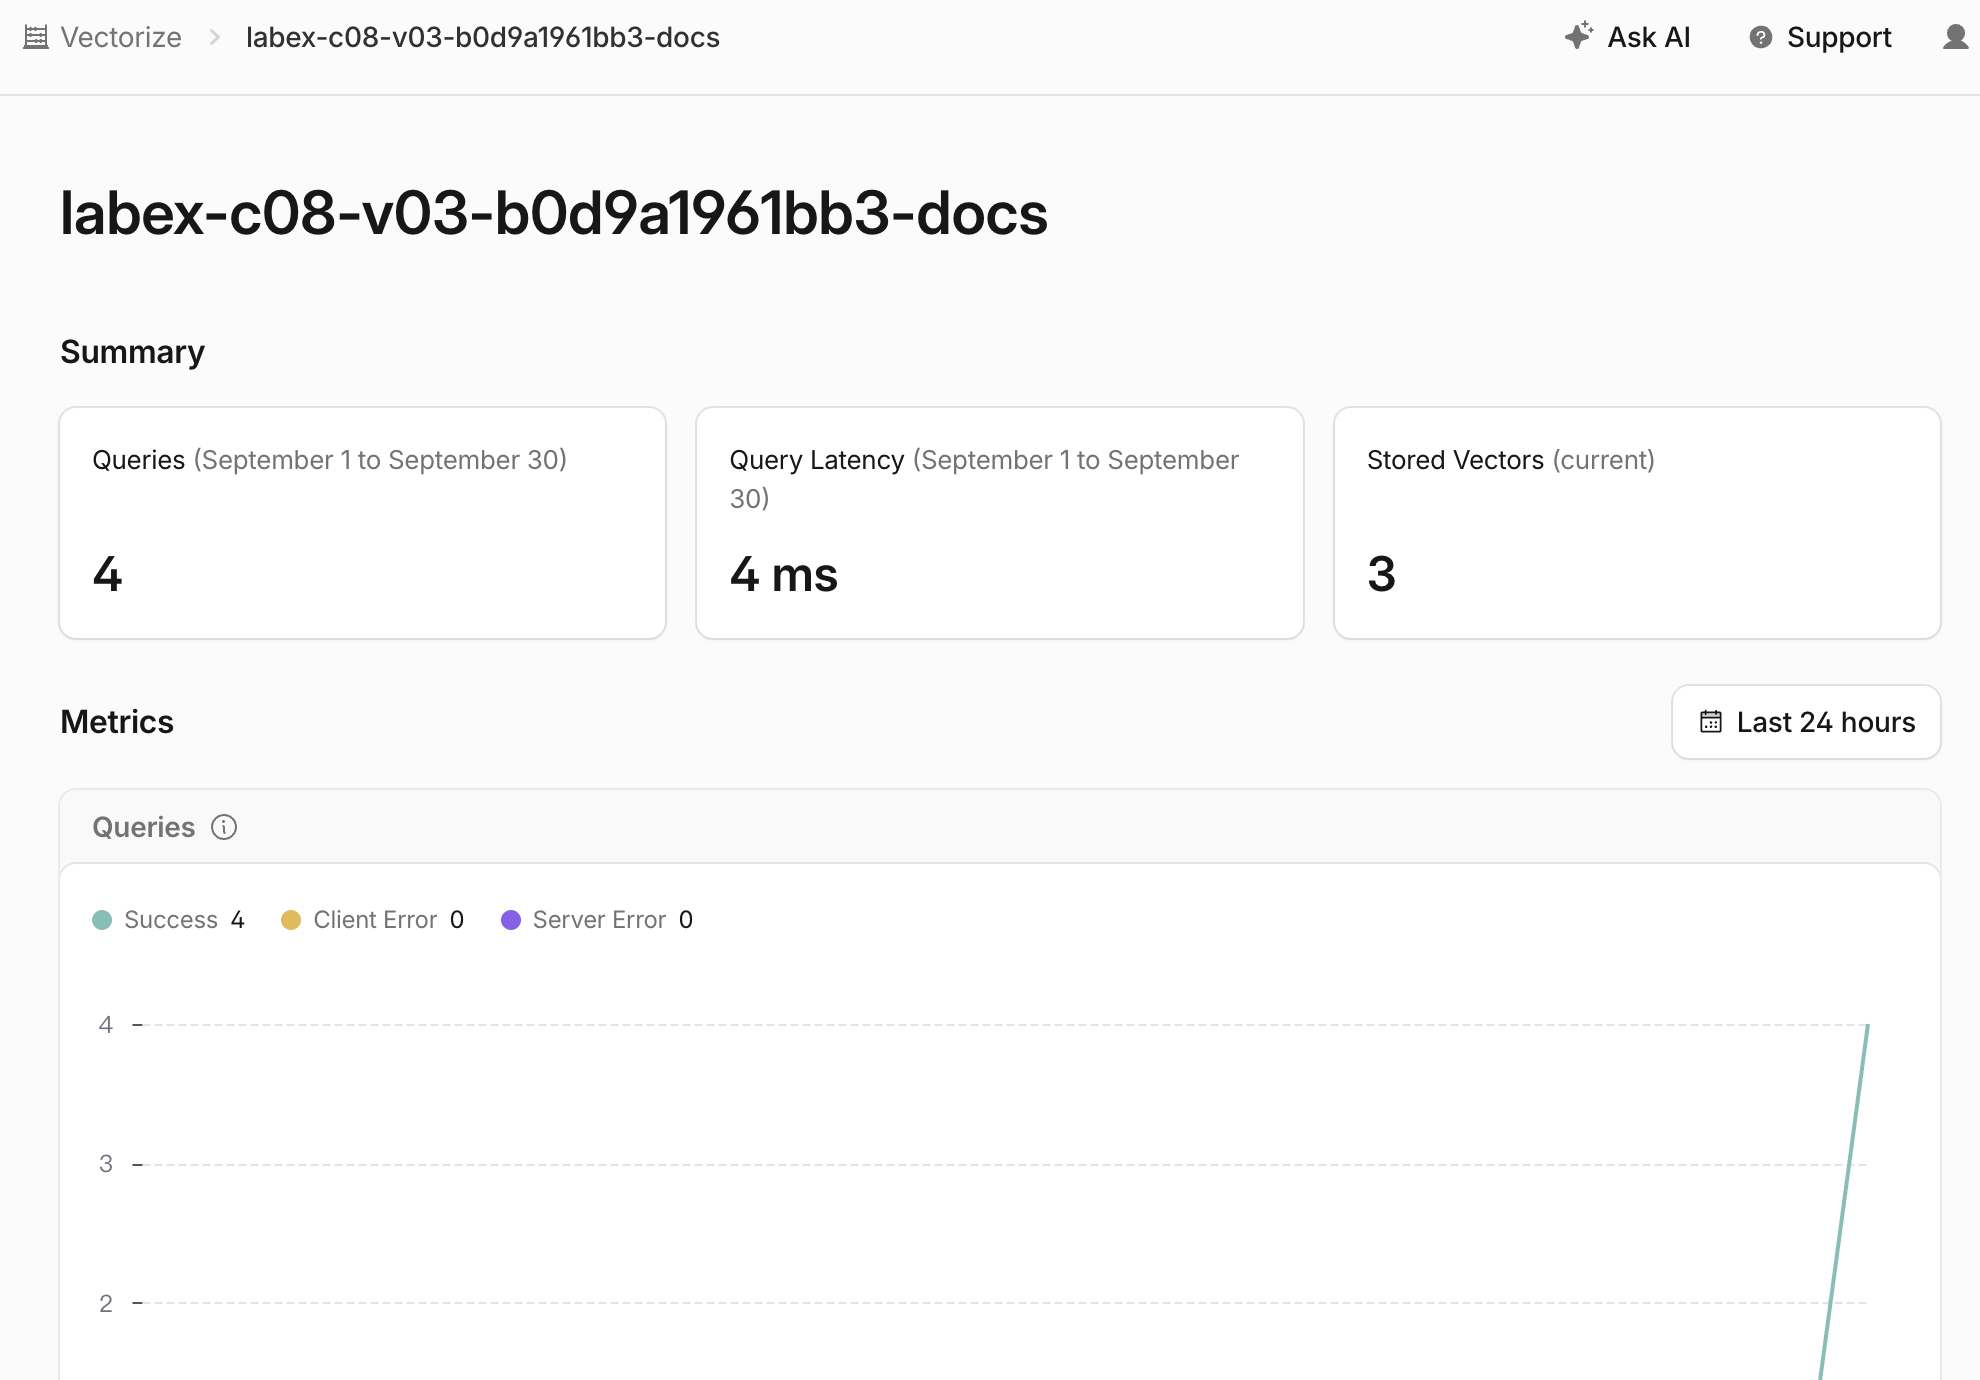
Role até Metrics. P50, P75 e P95 são percentis de latência: por exemplo, P95 significa que 95% das consultas bem-sucedidas foram concluídas nesse tempo ou menos. Esses números descrevem velocidade, não a relevância de uma correspondência. O gráfico Stored Vectors deve permanecer em três enquanto você apenas pesquisa e não adiciona nem remove documentos.
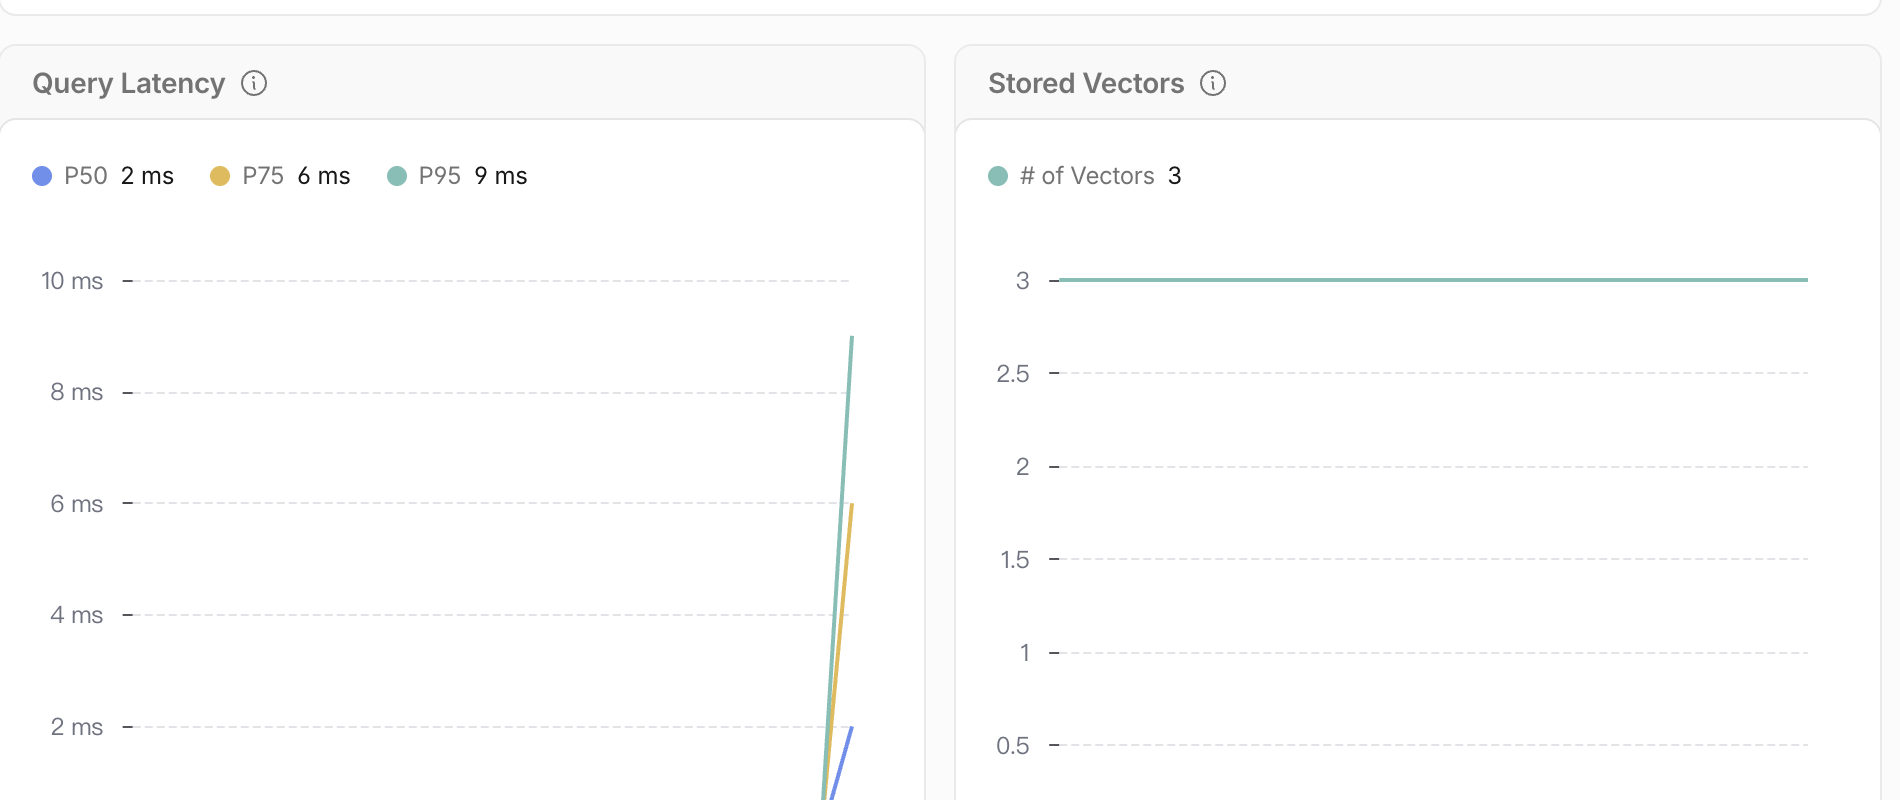
Os contadores do Dashboard podem atrasar alguns instantes em relação ao terminal. Considere as respostas da API, os IDs retornados e as verificações independentes como o resultado oficial; use o Dashboard para relacionar esses resultados aos recursos que você pode visualizar e operar.
Remover o Worker e o índice de pesquisa
Nesta etapa, você excluirá os dois recursos descartáveis na nuvem e comprovará que eles não existem mais enquanto o Wrangler ainda estiver autorizado. O logout é uma etapa final separada porque a verificação de limpeza precisa de acesso de leitura ao Cloudflare.
Primeiro, recupere os nomes exatos de wrangler.jsonc. Isso torna a limpeza segura mesmo que você tenha aberto um novo terminal e as variáveis RUN e INDEX anteriores não existam mais:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Confirme que os dois valores começam com o prefixo exclusivo labex-c08-v03-... antes de excluir qualquer coisa.
Exclua primeiro o Worker para que nenhum código implantado mantenha um binding para o índice:
npx wrangler delete --name "$RUN" --force
Exclua somente o índice associado e, depois, salve um inventário autenticado bem-sucedido para a avaliação da limpeza:
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Conclua esta etapa agora, antes de sair da sessão. A avaliação lê o Cloudflare de forma independente e não considera falhas de autenticação ou de rede como evidência de exclusão.
Sair da VM de aprendizagem
Nesta etapa, você removerá a autorização temporária do Wrangler nesta VM. Os recursos na nuvem já foram removidos e a verificação de limpeza autenticada foi aprovada; agora é seguro sair:
npx wrangler logout
npx wrangler whoami --json
Espere loggedIn: false. A sessão do navegador no Dashboard do Cloudflare é independente e continua disponível para sua conta de aprendizagem.
Resumo
Você criou um Worker que usa um único contrato de modelo tanto para os embeddings dos documentos armazenados quanto para os embeddings das consultas em tempo real, gravou três IDs estáveis no Vectorize e aguardou a mutação assíncrona real. Você usou topK para limitar os candidatos, interpretou as pontuações como sinais relativos de classificação, retornou metadados em vez de vetores brutos e produziu um resultado vazio explícito após aplicar o limite da aplicação. Por fim, confirmou os dois bindings na Dashboard, removeu o Worker e o índice descartáveis enquanto ainda estava autorizado e depois saiu da VM.
A V04 adicionará namespaces de clientes controlados pelo servidor e filtros de metadados, para que um registro semanticamente semelhante só seja retornado quando também pertencer ao escopo de pesquisa autorizado.