Introdução
Na V01, você armazenou um vetor para cada artigo de ajuda. Artigos reais não permanecem estáticos: as instruções mudam, os títulos são corrigidos e as páginas obsoletas são retiradas. Um índice de pesquisa precisa acompanhar esse ciclo de vida; caso contrário, pode retornar respostas desatualizadas mesmo quando o site de origem está correto.
O Cloudflare Vectorize fornece três operações de gravação relacionadas:
- insert adiciona um novo ID de vetor e não deve substituir silenciosamente um ID existente;
- upsert significa “atualizar ou inserir” e substitui o vetor e os metadados desse ID;
- delete by ID retira registros selecionados sem recriar todo o índice.
Você vai inserir três documentos sintéticos, fazer upsert de um artigo revisado sobre redefinição de senha, excluir um artigo de cobrança retirado e comprovar que o artigo não relacionado sobre upload nunca muda. Cada gravação retorna um ID de mutação assíncrona. Por isso, você vai aguardar o estado exato em vez de presumir que uma gravação aceita já pode ser lida.
Este é o segundo laboratório sobre Vectorize. Se você entrou diretamente, primeiro conclua Conecte o LabEx à sua conta da Cloudflare e depois conclua a V01, para que a compatibilidade do índice, os IDs dos documentos e a visibilidade das mutações já sejam familiares.
O Vectorize está disponível no Workers Free. Este laboratório armazena no máximo três vetores pequenos de 384 dimensões, executa leituras limitadas e não invoca nenhum modelo de IA. Portanto, o Workers Paid e o Workers AI Neurons não são necessários.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/document-lifecycle-index. Ela fornece verificações independentes somente de leitura, mas não autoriza o Wrangler, cria um índice, grava vetores nem altera sua conta da Cloudflare.
Autorize um novo índice para o ciclo de vida de documentos
Nesta etapa, você vai autorizar a nova VM, registrar a conta pretendida e criar uma configuração local exclusiva para um índice descartável.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/document-lifecycle-index
npx wrangler --version
A saída esperada é 4.132.0. Autorize a mesma conta limitada e o mesmo acesso ao recurso Workers usados na V01:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
npx wrangler whoami --json
Confirme loggedIn: true, identifique sua conta de aprendizado e gere um nome exclusivo:
RUN="labex-c08-v02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Substitua YOUR_ACCOUNT_ID pelo ID real dessa conta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
O novo índice é independente da V01. Reutilizar o conhecimento não significa depender da VM ou do recurso de nuvem de um laboratório anterior.
Insira o conjunto atual de documentos
Nesta etapa, você vai criar o índice e inserir os três registros que representam a central de ajuda atual antes de qualquer edição ou retirada.
Crie o mesmo contrato de 384 dimensões e cosseno usado pelo modelo de embeddings BGE Small:
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Crie um mecanismo reutilizável de espera com limite de tempo. Três leituras correspondentes protegem o resultado visível para você contra uma réplica temporariamente desatualizada:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
Gere três vetores determinísticos de documentos. O campo revision facilita reconhecer uma substituição posterior; o objeto completo de metadados representa o que a aplicação de pesquisa precisaria depois de uma atualização na origem.
cat > scripts/create-seed.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const documents = [
  { id: "password-reset", axis: 0, category: "account", title: "Reset your password" },
  { id: "upload-pdf", axis: 1, category: "files", title: "Upload a PDF" },
  { id: "billing-receipt", axis: 2, category: "billing", title: "Download a billing receipt" }
];

const rows = documents.map((document) => {
  const values = Array(DIMENSIONS).fill(0);
  values[document.axis] = 1;
  return {
    id: document.id,
    values,
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      revision: 1,
      model: "@cf/baai/bge-small-en-v1.5",
      pooling: "cls"
    }
  };
});

writeFileSync("vectors/seed.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`prepared ${rows.length} current documents`);
JS
node scripts/create-seed.mjs
Insira somente IDs novos, preserve o resultado completo e aguarde a mutação real:
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/seed.ndjson 2>&1 | tee .labex/seed-output.txt
Só prossiga quando o Wrangler informar três vetores enfileirados e um ID de mutação. Um erro de autenticação ou de rede não é conclusivo; corrija-o antes de aguardar.
SEED_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/seed-output.txt | tail -n 1)
if [ -z "$SEED_MUTATION_ID" ]; then
  printf '%s\n' 'No seed mutation ID was returned; fix the insert error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$SEED_MUTATION_ID" 3
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
O inventário deve conter os três IDs estáveis da aplicação. insert é apropriado aqui porque eles são novos; na próxima etapa, você vai substituir intencionalmente um ID existente.
Faça upsert de um artigo revisado sobre senha
Nesta etapa, você vai substituir o vetor e os metadados de password-reset, mantendo o ID estável.
Um upsert insere um ID ausente ou substitui um ID existente. A substituição é útil quando um documento de origem muda, mas também significa que você precisa enviar os metadados completos desejados. Não presuma que os campos omitidos do novo registro continuarão existindo.
Crie a revisão 2 com um eixo determinístico diferente e um título atualizado, mantendo todos os campos de metadados que ainda são válidos:
cat > scripts/create-update.mjs <<'JS'
import { writeFileSync } from "node:fs";

const values = Array(384).fill(0);
values[3] = 1;
const updated = {
  id: "password-reset",
  values,
  metadata: {
    category: "account",
    published: true,
    title: "Reset an expired password",
    revision: 2,
    model: "@cf/baai/bge-small-en-v1.5",
    pooling: "cls"
  }
};

writeFileSync("vectors/password-update.ndjson", JSON.stringify(updated) + "\n");
console.log("prepared password-reset revision 2");
JS
node scripts/create-update.mjs
Envie a substituição e preserve a mutação exata:
set -o pipefail
npx wrangler vectorize upsert "$RUN" --file=vectors/password-update.ndjson 2>&1 | tee .labex/upsert-output.txt
UPSERT_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/upsert-output.txt | tail -n 1)
if [ -z "$UPSERT_MUTATION_ID" ]; then
  printf '%s\n' 'No upsert mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$UPSERT_MUTATION_ID" 3
fi
npx wrangler vectorize get-vectors "$RUN" --ids password-reset > .labex/password-after-upsert.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/password-after-upsert.txt", "utf8");
const [row] = JSON.parse(text.slice(text.indexOf("[")));
console.table([{ id: row.id, dimensions: row.values.length, changedAxis: row.values[3], title: row.metadata.title, revision: row.metadata.revision }]);
JS
Espere o mesmo ID, 384 dimensões, o eixo 3 igual a 1, o título revisado e a revisão 2. A contagem total continua em três, porque o upsert substituiu uma identidade em vez de adicionar um quarto documento.
Retire um documento sem recriar o índice
Nesta etapa, você vai excluir o artigo de cobrança retirado pelo ID estável e comprovar que o artigo atualizado sobre senha e o artigo de upload, que não foi alterado, continuam presentes.
Excluir por ID é mais específico do que remover um índice inteiro: o contrato do índice e todos os registros não relacionados permanecem no lugar. Envie somente o ID retirado:
set -o pipefail
npx wrangler vectorize delete-vectors "$RUN" --ids billing-receipt 2>&1 | tee .labex/delete-output.txt
Aguarde a mutação de exclusão e uma contagem de dois:
DELETE_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/delete-output.txt | tail -n 1)
if [ -z "$DELETE_MUTATION_ID" ]; then
  printf '%s\n' 'No delete mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$DELETE_MUTATION_ID" 2
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/documents-after-retirement.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/documents-after-retirement.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map((row) => ({ id: row.id, title: row.metadata.title, revision: row.metadata.revision })));
JS
Somente password-reset na revisão 2 e upload-pdf na revisão 1 devem permanecer. A ausência de billing-receipt é significativa porque a mesma leitura autenticada também retornou os dois registros que deveriam sobreviver.
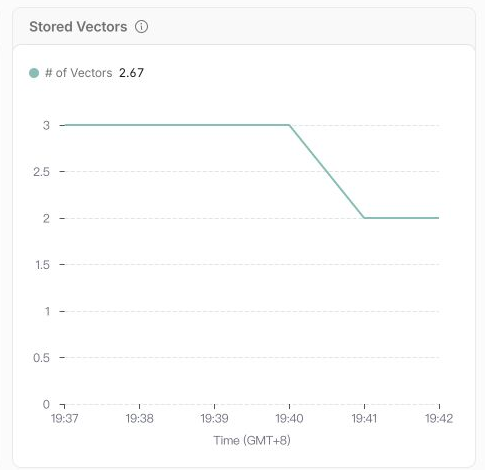
Abra a conta selecionada no Cloudflare Dashboard e acesse AI → Vectorize. Em seguida, abra o índice cujo nome está em $RUN. Confirme que o resumo informa dois vetores armazenados. No gráfico Stored Vectors, associe o ciclo de vida visível aos comandos: a contagem sobe para três depois da mutação de inserção inicial e cai para dois depois da exclusão direcionada. O Dashboard não informa qual ID foi removido; por isso, as leituras do Wrangler e da API independente continuam sendo a evidência oficial da identidade dos registros.
O resumo mostra o estado atual rapidamente: dois documentos continuam pesquisáveis depois da retirada de um registro.
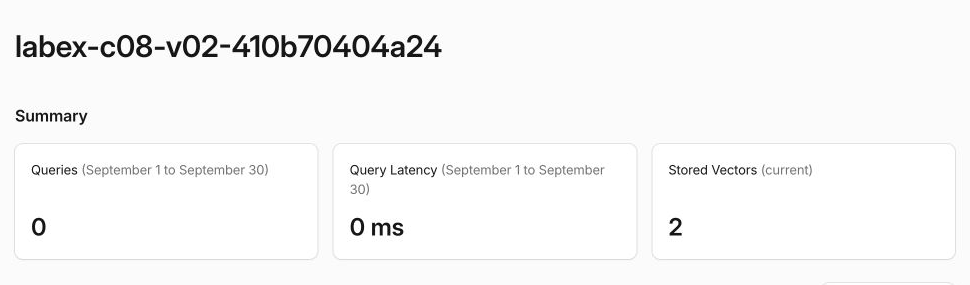
O gráfico transforma o ciclo de vida em uma imagem. A média pode mostrar brevemente um valor decimal porque a linha abrange várias amostras de um minuto; o importante é a transição visível de três vetores armazenados para dois.
Remova o índice do ciclo de vida e saia da sessão
Nesta etapa, você vai remover todo o índice descartável somente depois de comprovar o ciclo de vida direcionado do documento.
Excluir um vetor na etapa anterior preservou o índice. Este comando final remove deliberadamente todo o recurso do laboratório:
npx wrangler vectorize delete "$RUN" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Conclua a verificação de limpeza do laboratório enquanto o inventário autenticado bem-sucedido ainda estiver disponível. Mantenha o Wrangler autorizado até essa verificação ser aprovada, pois sair da sessão antes disso faria com que um erro de autenticação não pudesse ser distinguido de uma exclusão bem-sucedida.
Depois, remova a autorização desta VM e inspecione o resultado estruturado:
npx wrangler logout
npx wrangler whoami --json
A saída esperada é loggedIn: false. A sessão separada do Dashboard no navegador continua disponível para sua conta de aprendizado.
Resumo
Você começou com três IDs de documentos atuais, usou upsert para substituir o vetor e os metadados completos de um artigo revisado e usou a exclusão direcionada para retirar um artigo obsoleto. IDs de mutação exatos e leituras consecutivas limitadas distinguiram gravações aceitas de estados realmente legíveis.
Você também comprovou as duas propriedades de segurança importantes em um pipeline de indexação real: uma atualização não criou uma identidade duplicada, e uma retirada não removeu documentos não relacionados. Por fim, você associou o estado com dois registros ao Dashboard, excluiu o índice descartável, confirmou sua ausência em uma leitura autenticada e saiu da sessão da nova VM.
Na V03, você vai gerar um embedding de consulta em tempo real usando o mesmo contrato do modelo e usar o índice mantido para recuperar artigos de ajuda semelhantes.