Introdução
No laboratório anterior sobre embeddings do Workers AI, o texto se tornou um embedding: uma lista ordenada de números que captura relações úteis entre significados. Um embedding não é o artigo original nem uma resposta gerada. Ele só se torna útil para buscas quando uma aplicação consegue armazená-lo com um ID de documento estável e depois encontrar vetores próximos.
O Vectorize da Cloudflare é um banco de dados vetorial. Diferentemente de uma tabela organizada em linhas e colunas, um índice vetorial é projetado para comparar vetores numéricos com eficiência. Cada índice define duas escolhas de compatibilidade no momento da criação:
- dimensions — quantos números cada vetor contém;
- distance metric — como o Vectorize determina quais vetores estão mais próximos.
Você criará um índice com 384 dimensões para embeddings @cf/baai/bge-small-en-v1.5 hospedados na Cloudflare e escolherá a distância de cosseno, a mesma comparação baseada em direção apresentada em A04. Você adicionará índices de metadados para category e published, inserirá três vetores sintéticos de pequenos artigos de ajuda, aguardará a disponibilização da mutação assíncrona para leitura e confirmará que um vetor de três dimensões é rejeitado.
Este é o primeiro laboratório do curso de Vectorize. Se você entrou diretamente, conclua primeiro Conectar o LabEx à sua conta da Cloudflare para aprender a usar o terminal da VM do LabEx, autorizar o Wrangler, confirmar sua conta de aprendizado e configurar o ID da conta. Conclua primeiro o Workers AI A04 se vetores, dimensões ou similaridade de cosseno ainda não forem familiares.
O Vectorize está disponível no Workers Free. A franquia incluída atualmente é muito maior que os três vetores de 384 dimensões e as verificações somente leitura deste laboratório, portanto o Workers Paid não é necessário. Este laboratório não chama o Workers AI e não consome Neurons.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/document-vector-index. Ela também fornece verificações independentes somente leitura. A configuração não autoriza o Wrangler, não cria um índice, não grava vetores nem modifica sua conta da Cloudflare.
Autorizar a VM e nomear o índice
Nesta etapa, você autorizará a VM recém-criada, selecionará a conta de aprendizado pretendida e registrará um nome exclusivo para o índice descartável.
O login no Cloudflare Dashboard pertence ao seu navegador. O Wrangler nesta VM recém-criada é um cliente separado, portanto precisa de autorização limitada antes de poder gerenciar recursos do Vectorize.
Entre no projeto preparado e confirme a versão fixada da CLI:
cd /home/labex/project/document-vector-index
npx wrangler --version
O resultado esperado é 4.132.0. Solicite a identidade da conta e a permissão para gerenciar recursos do Workers. Nesta versão do Wrangler, o escopo OAuth workers:write inclui as operações de gerenciamento do Vectorize usadas aqui; o laboratório não solicita um escopo de AI porque não executa inferência.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
Abra o link exibido, informe o código atual, verifique a conta e as permissões e autorize sua conta de aprendizado. Depois, consulte os dados estruturados de identidade:
npx wrangler whoami --json
Confirme loggedIn: true e identifique a conta de aprendizado pretendida. Gere um nome exclusivo para o índice descartável:
RUN="labex-c08-v01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Substitua YOUR_ACCOUNT_ID pelo ID real dessa conta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
O binding registra a relação que os próximos laboratórios usarão no código do Worker: DOCUMENTS é o nome usado pela aplicação, enquanto index_name é o recurso pertencente à nuvem. remote: true significa que um Worker local se conectará ao índice remoto real, em vez de usar uma simulação local isolada.
Criar o índice e seus campos filtráveis
Nesta etapa, você criará o contrato vetorial fixo e preparará dois campos de metadados para filtragem posterior.
As dimensões e a métrica de distância de um índice são fixas porque toda comparação deve seguir o mesmo contrato numérico. O BGE Small produz 384 números. A distância de cosseno compara a direção dos vetores, o que é adequado aos embeddings orientados por significado do A04.
Crie o índice V2:
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Os vetores também podem conter pequenos metadados, como a categoria de um documento. Armazenar metadados não os torna filtráveis automaticamente. Um índice de metadados informa ao Vectorize qual campo deve ser preparado para filtros. Crie estes campos antes de inserir os vetores:
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=category --type=string | tee .labex/category-index-output.txt
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=published --type=boolean | tee .labex/published-index-output.txt
--update-config=false impede que o Wrangler ofereça substituir o binding que você já escreveu. A criação dos índices de metadados é assíncrona. Cada comando coloca uma mutação em uma fila, portanto uma mensagem de sucesso significa que a Cloudflare aceitou a alteração, não que todas as leituras já a exibem.
Crie um verificador reutilizável. Ele executa apenas o comando somente leitura vectorize info, compara o ID exato da mutação e exige três leituras consecutivas correspondentes antes de confiar no resultado. Essa confirmação adicional evita apresentar uma réplica de leitura brevemente desatualizada como estado final. O verificador termina com erro após quatro minutos, em vez de esperar indefinidamente:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS

METADATA_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/published-index-output.txt | tail -n 1)
test -n "$METADATA_MUTATION_ID"
node scripts/wait-for-vectorize.mjs "$RUN" "$METADATA_MUTATION_ID" 0
npx wrangler vectorize get "$RUN"
npx wrangler vectorize list-metadata-index "$RUN"
As tabelas finais devem mostrar 384 dimensões, distância de cosseno, category como String e published como Bool. Bool é o nome de exibição atual da API para o campo criado com --type=boolean. Aguardar a segunda mutação de metadados impede que a próxima inserção de vetores fique aguardando uma preparação de índice ainda não concluída.
Criar vetores de documentos identificados
Nesta etapa, você gerará um pequeno conjunto transparente de vetores cujos IDs e metadados podem ser verificados de forma independente.
Um banco de dados vetorial não substitui o documento de origem. Cada vetor precisa de um ID estável que a aplicação possa relacionar ao conteúdo real. Este laboratório usa três IDs sintéticos de artigos de ajuda e registra como metadados a categoria, o estado de publicação, o modelo de embedding e a escolha de pooling.
Os embeddings reais serão usados no V03. Aqui, vetores determinísticos tornam o comportamento de armazenamento repetível e gratuito: cada documento aponta para um eixo diferente, seguido de zeros até atingir 384 posições.
Crie o gerador transparente do conjunto de dados:
cat > scripts/create-vectors.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const documents = [
  { id: "password-reset", axis: 0, category: "account" },
  { id: "upload-pdf", axis: 1, category: "files" },
  { id: "billing-receipt", axis: 2, category: "billing" }
];

function unitVector(axis) {
  const values = Array(DIMENSIONS).fill(0);
  values[axis] = 1;
  return values;
}

const rows = documents.map((document) => ({
  id: document.id,
  values: unitVector(document.axis),
  metadata: {
    category: document.category,
    published: true,
    model: MODEL,
    pooling: POOLING
  }
}));

writeFileSync("vectors/documents.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`wrote ${rows.length} vectors with ${DIMENSIONS} dimensions each`);
JS
node scripts/create-vectors.mjs
NDJSON significa JSON delimitado por novas linhas: um objeto vetorial completo por linha, em vez de um único array JSON externo. O Wrangler pode transmitir esse formato em lotes. Inspecione as identidades e as dimensões sem imprimir todos os 1.152 números:
node - <<'JS'
const rows = require("fs").readFileSync("vectors/documents.ndjson", "utf8").trim().split("\n").map(JSON.parse);
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
As três linhas devem informar 384 dimensões. Os metadados do modelo e do pooling cls documentam a compatibilidade; o Vectorize não deduz nem valida esse significado semântico por você.
Inserir os vetores e aguardar a mutação
Nesta etapa, você inserirá um lote e aguardará até que a mutação assíncrona exata fique visível nas leituras.
As gravações do Vectorize são assíncronas. Uma inserção chega primeiro a um log de gravação antecipada durável e retorna um ID de mutação. Em seguida, o processamento em segundo plano torna essa mutação visível para as leituras. Esse design mantém as gravações eficientes, mas significa que “aceita” e “legível” são dois momentos diferentes.
Insira o lote com os três vetores e preserve o resultado completo. pipefail impede que uma falha do Wrangler seja ocultada pelo comando tee, que é executado depois e termina com sucesso:
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/documents.ndjson 2>&1 | tee .labex/insert-output.txt
Continue somente depois que o Wrangler informar que colocou três vetores na fila e imprimir um identificador de mutação. Se a API retornar um erro de autenticação ou de rede, o resultado será inconclusivo: confirme npx wrangler whoami --json e execute novamente este mesmo bloco de inserção uma vez. Não inicie o verificador sem um ID de mutação real.
Extraia a mutação aceita e aguarde somente quando ela existir:
MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/insert-output.txt | tail -n 1)
if [ -z "$MUTATION_ID" ]; then
  printf '%s\n' 'No mutation ID was returned; fix the insert error before waiting.' >&2
else
  printf 'Waiting for mutation %s\n' "$MUTATION_ID"
  node scripts/wait-for-vectorize.mjs "$RUN" "$MUTATION_ID" 3
fi
O JSON final do verificador deve mostrar vectorCount igual a 3 e o ID de mutação registrado. Exigir três leituras correspondentes torna o resultado visível para o aluno resistente a uma breve defasagem da réplica. A sondagem com tempo limitado é mais segura do que uma espera fixa: uma mutação rápida termina prontamente, enquanto uma mutação saudável mais lenta recebe tempo suficiente sem gerar gravações duplicadas.
Ler os documentos e testar a compatibilidade
Nesta etapa, você lerá os registros aceitos, observará a rejeição de uma gravação incompatível e relacionará o estado da CLI ao Dashboard.
Leia os registros armazenados usando seus IDs de aplicação:
Salve os registros completos e depois imprima uma tabela compacta, em vez de inundar o terminal com 1.152 números:
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/stored-vectors.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/stored-vectors.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Cada linha do resumo deve manter o ID, a estrutura com 384 valores e os metadados. O arquivo bruto contém os valores completos para verificação independente. get-vectors lê registros conhecidos; ele não executa uma busca por similaridade. As consultas de similaridade serão apresentadas no V03.
Agora crie intencionalmente um registro incompatível com apenas três valores:
cat > vectors/incompatible.ndjson <<'NDJSON'
{"id":"wrong-dimensions","values":[1,0,0],"metadata":{"category":"account","published":true}}
NDJSON
if npx wrangler vectorize insert "$RUN" --file=vectors/incompatible.ndjson > .labex/incompatible.log 2>&1; then
  STATUS=0
else
  STATUS=$?
fi
printf '%s\n' "$STATUS" > .labex/incompatible-exit.txt
sed -n '/invalid vector/p' .labex/incompatible.log
test "$STATUS" -ne 0
A rejeição protege o contrato do índice: um vetor com três posições não pode ser comparado de forma significativa com vetores de 384 posições. Confirme que os registros aceitos continuam presentes e que o ID rejeitado não aparece:
npx wrangler vectorize info "$RUN"
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids wrong-dimensions
Abra o Cloudflare Dashboard da conta selecionada e acesse AI → Vectorize. O inventário relaciona o nome da CLI ao índice real, mostra 384 dimensões e distância de cosseno e informa três vetores no total, sem uso faturável neste pequeno exemplo.
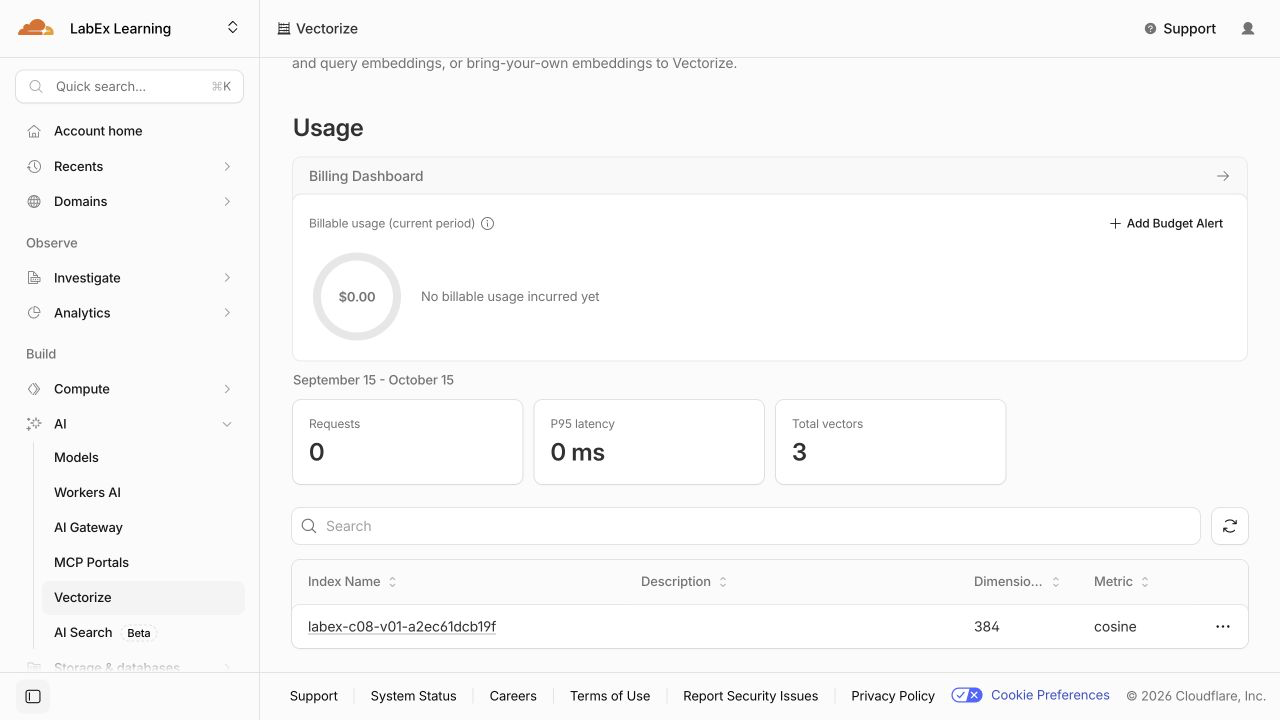
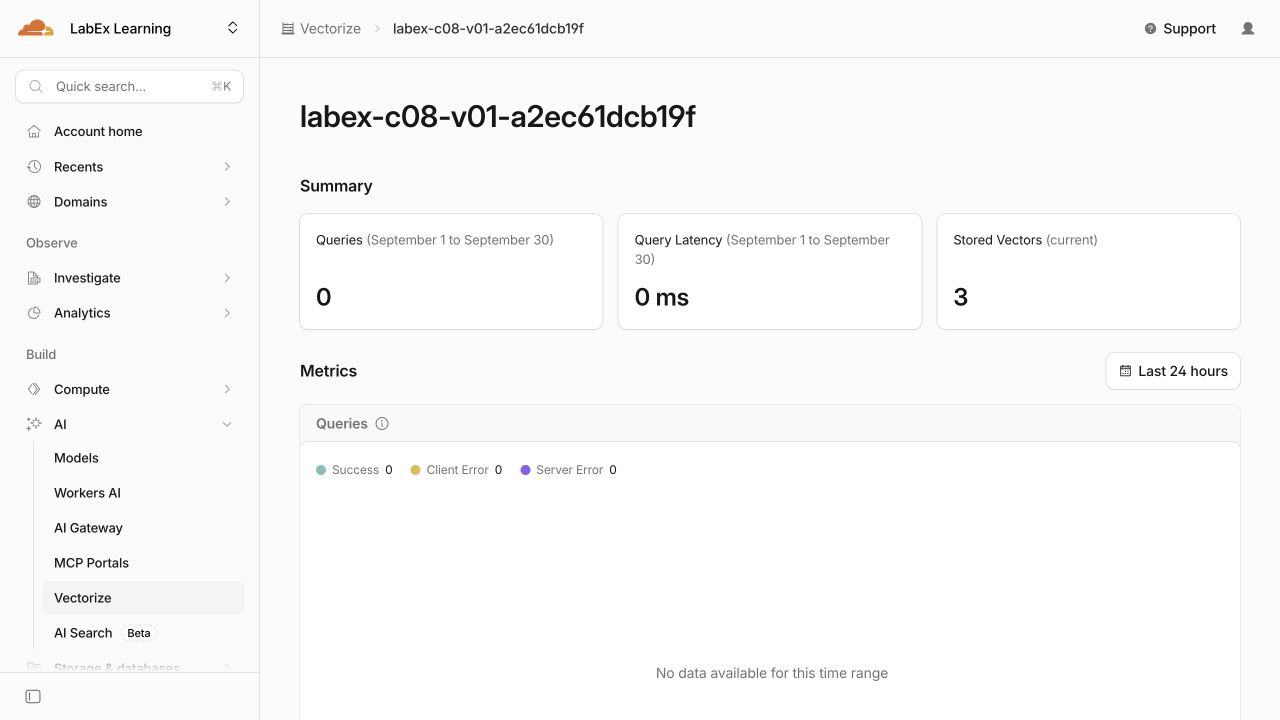
Abra o índice nomeado em $RUN. O resumo mostra três vetores armazenados atualmente. O número de consultas continua igual a zero porque este primeiro laboratório usa leituras por ID; as consultas de similaridade começam no V03.
Role até Stored Vectors. O gráfico torna concreta a visibilidade assíncrona: a contagem permanece em zero e depois muda para três quando a mutação de inserção é processada.
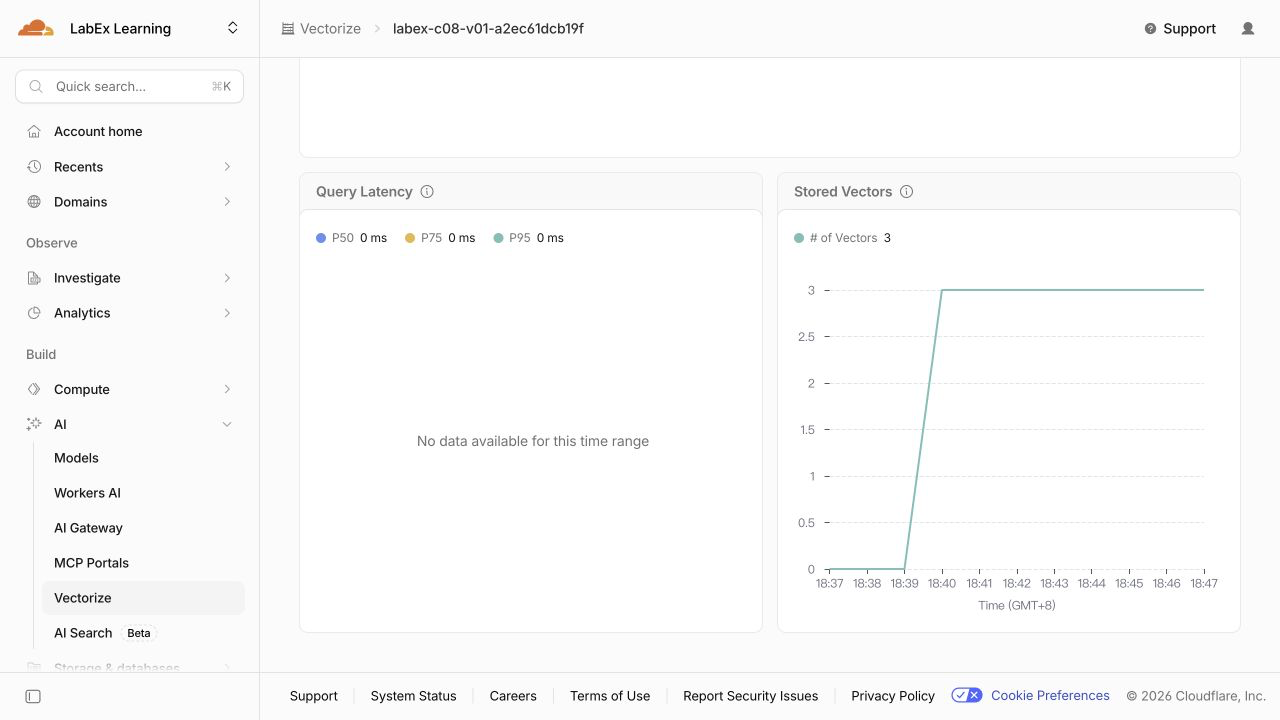
O Dashboard atual não lista IDs individuais de vetores nem definições de índices de metadados. Use as leituras anteriores do Wrangler para password-reset, upload-pdf, billing-receipt, category e published; não deduza esses detalhes de um gráfico que mostra apenas a contagem. As páginas do Dashboard ajudam na orientação, enquanto as verificações independentes usam leituras autorizadas da API.
As capturas de tela mostradas aqui após a aceitação do laboratório na nuvem são exemplos de uma execução descartável. O nome aleatório do seu índice e os horários serão diferentes; compare a configuração e os IDs pertencentes à sua conta, em vez de copiar os valores de exemplo.
Remover o índice descartável e sair da conta
Nesta etapa, você excluirá o índice exato pertencente à sua conta, comprovará sua ausência com autenticação e depois removerá a autorização da VM.
O índice, seus índices de metadados e seus vetores formam um único recurso descartável. Exclua o nome exato salvo em wrangler.jsonc enquanto a autorização ainda estiver disponível:
npx wrangler vectorize delete "$RUN" --force
Confirme sua ausência por meio de uma leitura autenticada do inventário:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Esse inventário concluído com sucesso é importante: uma falha de rede ou de autorização não comprovaria a exclusão. Execute a avaliação de limpeza antes de revogar a autorização da VM:
bash verify6-1.sh
Por fim, remova o login do Wrangler na VM e examine o resultado estruturado:
npx wrangler logout
npx wrangler whoami --json
O resultado esperado é loggedIn: false. O login do navegador no Dashboard é separado e continua disponível para sua conta de aprendizado.
Resumo
Você criou um índice Vectorize V2 com o mesmo contrato de 384 dimensões do modelo de embedding selecionado, escolheu a distância de cosseno e preparou dois campos de metadados para filtros posteriores. Você gerou vetores determinísticos identificados, inseriu-os como NDJSON, distinguiu uma mutação assíncrona aceita de uma mutação processada e leu os registros armazenados novamente por ID.
Você também comprovou que o Vectorize rejeita um vetor com dimensões incorretas, preservando os registros compatíveis. Por fim, inspecionou o recurso real no Dashboard, excluiu o índice descartável exato, confirmou sua ausência com autenticação e removeu a autorização do Wrangler na VM recém-criada.
O próximo laboratório amplia esse ciclo de vida com upsert e exclusão, para que documentos alterados e aposentados não deixem o índice desatualizado.