Introdução
No V03, você transformou perguntas em embeddings e recuperou artigos de ajuda próximos. O V04 manteve esses resultados dentro de um limite controlado pelo servidor para cliente e categoria. A recuperação é útil por si só, mas muitos aplicativos de suporte precisam de mais uma etapa: transformar os trechos aprovados em uma resposta curta em linguagem natural.
Esse padrão é chamado de retrieval-augmented generation, geralmente abreviado como RAG. Primeiro, o aplicativo recupera as evidências, cria um contexto pequeno usando apenas esses registros e, depois, solicita que um modelo de linguagem responda com base nesse contexto. A recuperação não torna um modelo automaticamente verdadeiro. O aplicativo ainda precisa controlar quais fontes são elegíveis, limitar a quantidade de texto inserida no prompt, preservar as identidades das fontes e interromper o fluxo quando não houver evidências aprovadas.
Você criará um Worker descartável com dois bindings da Cloudflare. DOCUMENTS pesquisa um índice do Vectorize, enquanto AI executa tanto o modelo de embedding BGE Small quanto um modelo de geração de texto Llama hospedado pela Cloudflare. O Worker resolve os IDs de vetor retornados usando um corpus fornecido no código; os metadados dos vetores são úteis para a pesquisa, mas não são tratados como o corpo canônico do artigo.
O endpoint retornará um array sources controlado pelo aplicativo junto com a resposta gerada. Se a recuperação não encontrar nada dentro do namespace e da categoria selecionados, o endpoint retornará uma resposta fixa no_evidence sem chamar o modelo de geração de texto. Esse desvio explícito é mais seguro do que pedir que o modelo improvise.
Se você entrou diretamente neste curso, conclua primeiro Conectar o LabEx à sua conta da Cloudflare. V01–V04 são pré-requisitos: eles apresentam índices compatíveis, mutações assíncronas, recuperação semântica e escopo controlado pelo servidor.
Este laboratório usa o modelo hospedado pela Cloudflare @cf/meta/llama-3.3-70b-instruct-fp8-fast, pois ele já foi testado no Workers Free no curso anterior de Workers AI. O DeepSeek V4 Flash é hospedado pela Cloudflare, mas atualmente exige acesso pago; portanto, não é uma dependência obrigatória para o aluno. O laboratório envia apenas solicitações limitadas de embedding e geração; o Workers Paid não é necessário enquanto a alocação gratuita compartilhada do Workers AI da conta permanecer disponível.
A configuração instala Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/grounded-answer. Ela fornece testes determinísticos e verificações independentes somente de leitura, mas não autoriza o Wrangler, cria um índice, implanta um Worker, executa inferência nem popula dados na nuvem.
Autorizar e nomear os recursos do RAG
Nesta etapa, você autorizará esta VM nova, confirmará a conta de aprendizado e definirá um Worker e um índice do Vectorize correspondentes antes de criar qualquer recurso.
Acesse o projeto preparado e verifique as versões fixadas das ferramentas:
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Espere Node.js v22.22.0 e Wrangler 4.132.0. O login no Dashboard feito pelo navegador não autoriza automaticamente esta VM. Por isso, use o fluxo de dispositivo do Wrangler com as permissões necessárias para consultar a identidade da conta e gerenciar o Worker descartável, o Vectorize e o Workers AI:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Abra o link de autorização exibido, confirme se o código corresponde e aprove a conta LabEx Learning pretendida. Não envie o código, a senha ou o token a ninguém. No resultado JSON, confirme loggedIn: true e anote o nome e o ID da conta.
Gere um sufixo aleatório. Os dois nomes de recursos compartilharão esse sufixo, para que a limpeza posterior possa identificar o par exato:
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Crie wrangler.jsonc. Um here-document envia o bloco entre os marcadores JSON para o arquivo; $RUN e $INDEX são expandidos para os nomes exclusivos desta VM. Substitua YOUR_ACCOUNT_ID pelo ID exibido por whoami:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
AI é um único binding, embora o código chame dois modelos por meio dele. DOCUMENTS aponta para o índice correspondente. O arquivo nomeia os recursos pretendidos, mas ainda não cria nada.
Criar o Worker de recuperação seguida de geração
Nesta etapa, você implementará a sequência completa de RAG e comprovará suas decisões com bindings determinísticos em memória antes de usar a cota da nuvem.
O CORPUS fornecido é o mapa canônico de IDs para textos. O Vectorize armazena embeddings e metadados pesquisáveis; depois de uma consulta, o Worker aceita apenas IDs que possam ser resolvidos por esse mapa. Em seguida, ele inclui no máximo dois trechos no prompt. Assim, um registro inesperado do índice não se torna parte do contexto do modelo apenas por ter obtido uma pontuação alta.
Crie o código-fonte do Worker:
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Observe a ordem em answer(): valide o escopo controlado pelo servidor, gere o embedding da pergunta, recupere no máximo duas correspondências elegíveis, resolva cada ID por meio de CORPUS, crie um contexto limitado e, então, gere a resposta. A resposta pública omite o texto completo do contexto e os valores dos vetores, mas mantém referências de fontes que podem ser resolvidas.
Execute a suíte determinística:
node --test test/worker.test.mjs
Espere sete testes aprovados. Os bindings falsos comprovam que IDs desconhecidos e uma recuperação vazia nunca chegam à geração de texto. Gere os tipos dos bindings e empacote o projeto sem implantá-lo:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
Os tipos gerados devem incluir AI: Ai e DOCUMENTS: VectorizeIndex. Uma execução de teste comprova que os arquivos podem ser empacotados juntos; ela não cria recursos na nuvem nem executa nenhum dos modelos.
Criar o índice preparado e implantar
Nesta etapa, você criará um índice do Vectorize compatível, preparará category para filtragem e implantará o Worker depois que essa preparação se tornar estável.
Crie o índice de 384 dimensões com similaridade de cosseno usado pelo BGE Small. --update-config=false impede que o Wrangler reescreva o binding explícito que você já revisou:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Crie o índice de metadados de string para category e salve o ID da mutação retornado. set -o pipefail faz o pipeline falhar se o Wrangler falhar, mesmo que tee também grave uma cópia da saída:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Uma mutação aceita é um trabalho colocado em fila. Crie um verificador limitado, somente de leitura, que exija a mutação exata e a contagem de vetores em três leituras consecutivas:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
A visualização de lista separada pode atrasar em relação ao estado da mutação processada; portanto, aguarde brevemente até que a linha também fique visível:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Por fim, implante o Worker e salve o URL público:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
O índice ainda está vazio. A implantação conecta os bindings, mas não cria embeddings nem registros de fontes automaticamente.
Popular o corpus de fontes aprovadas
Nesta etapa, você criará embeddings ativos para os três artigos fornecidos e aguardará até que todos os IDs de fonte possam ser lidos.
O texto das fontes permanece em CORPUS; os registros de vetores contêm o embedding compatível e pequenos metadados de pesquisa. Essa separação permite que o aplicativo resolva um ID para o corpo de um artigo aprovado, em vez de confiar em texto arbitrário copiado dos metadados do vetor.
Chame o endpoint fixo de população uma vez:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
Espere três registros, 384 dimensões, pooling cls e um UUID de mutação. Aguarde esse estado exato e, depois, aguarde brevemente até que os três IDs apareçam na visualização de inventário separada:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
Agora cada ID conecta os resultados da pesquisa a uma entrada exata do corpus. O índice deliberadamente não contém nenhum artigo files, o que tornará observável o fluxo de ausência de evidências sem depender de um limite de similaridade.
Comparar respostas fundamentadas e respostas sem evidências
Nesta etapa, você enviará uma pergunta com suporte e outra pergunta cuja categoria autorizada não possui fontes. O contraste torna visível o fluxo de controle do RAG.
Pergunte como redefinir uma senha expirada dentro do escopo da conta azul:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
Espere mode: grounded, generated: true, uma resposta não vazia e um array sources iniciado por password-reset. O texto gerado pelo modelo pode ser diferente. A evidência estável é que cada ID, título e URL retornado pode ser resolvido por meio do corpus fornecido e que apenas trechos aprovados da categoria account foram colocados no prompt.
Agora pergunte sobre o upload de arquivos mantendo o mesmo escopo de cliente controlado pelo servidor. files é uma categoria permitida, mas este corpus não contém nenhum registro de arquivo elegível:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
Espere mode: no_evidence, generated: false, a mensagem fixa I don't have enough approved evidence to answer that question. e sources: []. O Worker ainda gerou o embedding da pergunta para fazer a pesquisa, mas ignorou a geração de texto porque não havia contexto aprovado.
Tente uma solicitação insegura que forneça seu próprio namespace:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
Espere HTTP 400 e scope_override_not_allowed. O RAG não substitui o limite de autorização aprendido no V04; a recuperação precisa ser segura antes que seu texto se torne contexto do modelo.
Abra Workers & Pages → seu Worker labex-c08-v05-... → Bindings. Confirme que AI aponta para o Workers AI e que DOCUMENTS aponta para o índice correspondente do Vectorize. Essa visualização conecta os dois nomes de serviço usados no código aos recursos gerenciados reais.
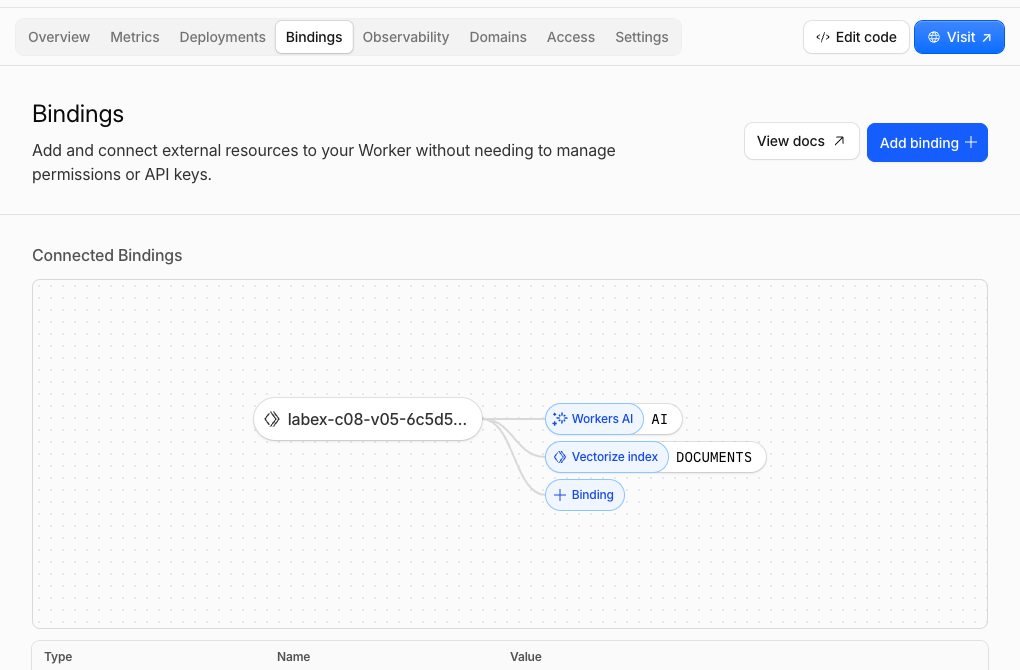
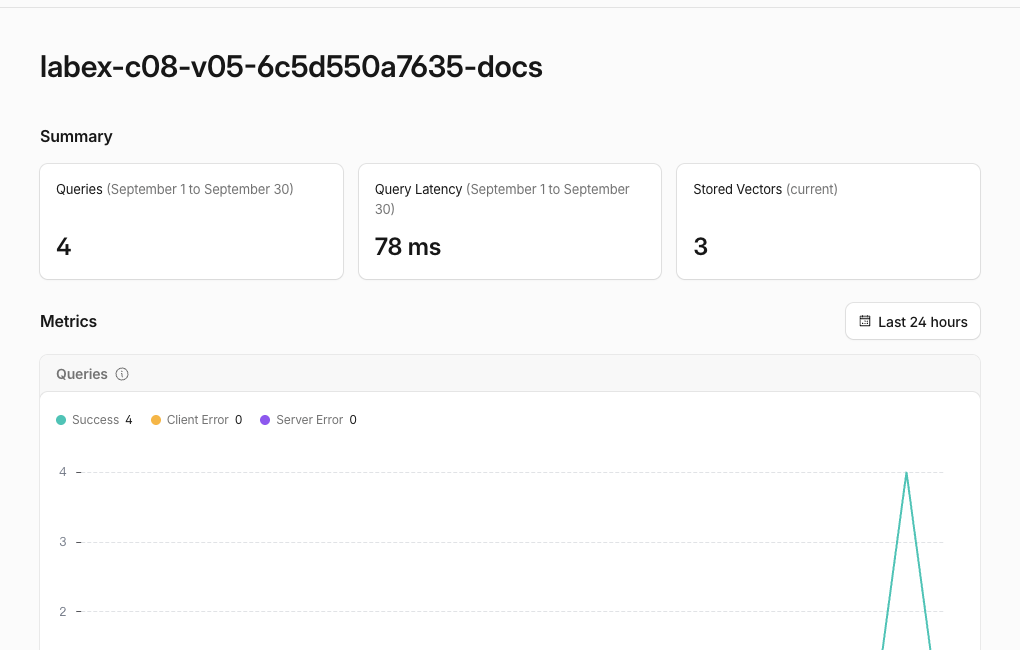
Depois, abra AI → Vectorize → o índice -docs correspondente. A contagem atual deverá mostrar três vetores eventualmente, e a atividade de consulta deverá refletir as pesquisas com e sem evidências. As métricas do Dashboard podem atrasar; portanto, as leituras autenticadas dos IDs e as respostas do endpoint continuam sendo a fonte de verdade.
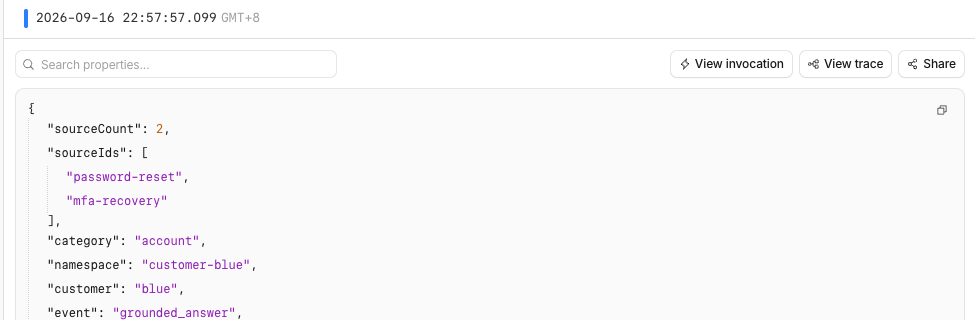
Se os Workers Logs estiverem disponíveis, abra Observability → Logs e examine as entradas grounded_answer e grounded_no_evidence. Os logs incluem a categoria, os IDs das fontes e as contagens, mas omitem a pergunta, a resposta, o texto dos trechos, o rótulo da sessão e os valores dos vetores. Assim, os operadores obtêm evidências úteis do fluxo de controle sem copiar o prompt para os logs.
Remover os recursos de respostas fundamentadas
Nesta etapa, você excluirá o Worker descartável e o índice do Vectorize e, depois, comprovará a ausência deles enquanto o Wrangler ainda estiver autorizado.
Recupere os dois nomes exatos de wrangler.jsonc para que a limpeza não dependa de variáveis de uma sessão anterior do terminal:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Confirme que os dois valores usam seu prefixo exclusivo labex-c08-v05-.... Exclua primeiro o Worker para que nenhum código implantado mantenha o binding e, depois, exclua apenas o índice correspondente:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Salve um inventário autenticado dos índices e verifique a ausência do nome exato:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Conclua essa verificação antes de sair da conta. Um erro de rede ou de autorização é inconclusivo; a avaliação exige separadamente leituras bem-sucedidas da conta e a ausência do nome exato.
Sair da VM de aprendizado
Nesta etapa, você removerá a autorização temporária do Wrangler desta VM. Os recursos na nuvem já foram removidos e a verificação autenticada da limpeza foi aprovada:
npx wrangler logout
npx wrangler whoami --json
Espere loggedIn: false. A sessão do navegador no Cloudflare Dashboard é separada e continua disponível para sua conta de aprendizado.
Resumo
Você criou um endpoint pequeno de retrieval-augmented generation: o escopo controlado pelo servidor restringiu a pesquisa no Vectorize, os IDs retornados foram resolvidos por meio de um corpus aprovado, no máximo dois trechos se tornaram contexto do modelo e o aplicativo retornou referências de fontes estáveis junto com um texto gerado variável.
Você também comprovou que uma pesquisa elegível sem resultados segue um fluxo fixo de ausência de evidências sem gerar texto, rejeitou substituições de escopo feitas pelo cliente antes da recuperação, examinou as relações entre Worker, Vectorize e observabilidade com limites de privacidade, excluiu os dois recursos descartáveis enquanto estava autorizado e, depois, saiu da conta. O desafio do curso pedirá que você corrija um endpoint com defeito que viola o mesmo limite de escopo.