



Introdução
A equipe de suporte precisa executar a mesma pequena verificação de duas formas: depois que um usuário solicita a verificação e periodicamente, sem uma solicitação do usuário. Você implementará as duas formas, diferenciará confirmação de conclusão, testará a duração dos eventos localmente e observará uma invocação agendada real na nuvem.
Esta VM independente é iniciada em /home/labex/project/task-monitor, com Node.js 22.22.0, Wrangler 4.131.1 local do projeto, Miniflare 4.20260730.0 para avaliação isolada e um fixture sintético de serviço interno de integridade. Você reutilizará as habilidades anteriores de service bindings e autorização de dispositivos, sem depender de uma VM ou recurso de um laboratório anterior. Use sua própria conta de aprendizagem; não é necessário domínio, produto de armazenamento nem upgrade pago. As solicitações e invocações agendadas contam para o uso normal da conta.
Mantenha um terminal aberto. O agendamento breve de um minuto serve apenas para testes descartáveis. Termine interrompendo os fluxos de logs, excluindo os dois Workers enquanto ainda estiver autorizado, confirmando a ausência deles e fazendo logout. O trabalho em segundo plano deste laboratório tem duração limitada e não é durável; não o use como promessa de entrega confiável em uma fila.
Retornar antes da conclusão do trabalho em segundo plano
Nesta etapa, um endpoint público confirmará uma pequena solicitação de verificação de integridade enquanto um serviço interno fornecido executa o trabalho assíncrono. Esta é uma VM independente; o serviço é um fixture novo, não um recurso de um laboratório anterior.
cd /home/labex/project/task-monitor
node --version
npx wrangler --version
cat health/index.js
O fixture aguarda 250 milissegundos e retorna JSON sintético. Ele não faz solicitações externas nem armazena dados. Gere um nome-base exclusivo e configure o Worker público e o serviço interno HEALTH. Essas são as service bindings padrão usadas anteriormente.
WORKER_NAME="labex-tasks-$(openssl rand -hex 6)"
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": []
  }
}
CONFIG
cat > health/wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME-health",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
CONFIG
cat > src/index.js <<'JS'
async function checkHealth(env, details) {
  const url = new URL('https://health.internal/health');
  url.searchParams.set('probe', details.probe);
  const response = await env.HEALTH.fetch(url, {signal: AbortSignal.timeout(3000)});
  if (!response.ok) throw new Error('health_service_unavailable');
  const data = await response.json();
  if (data.status !== 'ok' || data.service !== 'labex-health-fixture' || data.probe !== details.probe) {
    throw new Error('unexpected_health_response');
  }
  console.log(JSON.stringify({event: 'health_check', ...details, status: data.status, service: data.service}));
}

export default {
  async fetch(request, env, ctx) {
    const url = new URL(request.url);
    if (url.pathname === '/health' && request.method === 'GET') {
      return Response.json({status: 'ok'}, {headers: {'Cache-Control': 'no-store'}});
    }
    if (url.pathname !== '/checks') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'POST') {
      return Response.json({error: 'method_not_allowed'}, {status: 405, headers: {Allow: 'POST'}});
    }
    const probe = url.searchParams.get('probe') || '';
    if (!/^[a-z0-9-]{1,48}$/.test(probe)) {
      return Response.json({error: 'invalid_probe'}, {status: 400});
    }
    ctx.waitUntil(checkHealth(env, {source: 'request', probe}).catch(() => {
      console.error(JSON.stringify({event: 'health_check_failed', source: 'request', probe}));
    }));
    return Response.json({accepted: true, probe}, {status: 202, headers: {'Cache-Control': 'no-store'}});
  }
};
JS
checkHealth valida a resposta real da dependência e emite um pequeno resultado estruturado. O sinal de interrupção de três segundos limita a duração da solicitação. O handler público passa sua promise para ctx.waitUntil e retorna HTTP 202 imediatamente. O status 202 confirma esta tentativa de curta duração; ele não promete entrega durável. O catch registra uma falha sem imprimir exceções brutas, solicitações ou credenciais. Use somente os valores sintéticos de probe mostrados aqui.
npx wrangler dev -c wrangler.jsonc -c health/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
Aguarde o prompt e depois inspecione o log. Continue quando o servidor de desenvolvimento público estiver pronto na porta 8080. Se ele ainda estiver iniciando, aguarde brevemente e leia o log novamente.
cat dev.log
curl -i http://127.0.0.1:8080/health
curl -i -X POST "http://127.0.0.1:8080/checks?probe=manual-one"
cat dev.log
A rota de integridade em primeiro plano retorna 200 e status ok. A solicitação POST retorna 202 com accepted true e probe manual-one. Depois que a dependência terminar, o log incluirá event health_check, source request, o mesmo probe e status ok. Se você ler o log rápido demais, leia-o novamente depois de alguns instantes. A chegada da resposta antes de um log posterior é uma observação, não uma medição precisa de desempenho.
Use a verificação enquanto o servidor estiver em execução. Um runtime isolado mantém seu próprio fixture de integridade atrás de um controle, exige que a resposta em primeiro plano chegue antes de abrir esse controle e depois exige a conclusão do trabalho em segundo plano. Ele também verifica a rota pública de integridade e os casos de método/probe rejeitados. Nada nesse teste chama o Cloudflare.
Invocar o handler agendado localmente
Nesta etapa, reutilize a operação de verificação de integridade em um handler acionado por Cron. Inspecione e interrompa o job de desenvolvimento real antes de alterar o código. Substitua o número do job atual se ele for diferente do exemplo.
jobs
kill %1
cat > src/index.js <<'JS'
async function checkHealth(env, details) {
  const url = new URL('https://health.internal/health');
  url.searchParams.set('probe', details.probe);
  const response = await env.HEALTH.fetch(url, {signal: AbortSignal.timeout(3000)});
  if (!response.ok) throw new Error('health_service_unavailable');
  const data = await response.json();
  if (data.status !== 'ok' || data.service !== 'labex-health-fixture' || data.probe !== details.probe) {
    throw new Error('unexpected_health_response');
  }
  console.log(JSON.stringify({event: 'health_check', ...details, status: data.status, service: data.service}));
}

export default {
  async fetch(request, env, ctx) {
    const url = new URL(request.url);
    if (url.pathname === '/health' && request.method === 'GET') {
      return Response.json({status: 'ok'}, {headers: {'Cache-Control': 'no-store'}});
    }
    if (url.pathname !== '/checks') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'POST') {
      return Response.json({error: 'method_not_allowed'}, {status: 405, headers: {Allow: 'POST'}});
    }
    const probe = url.searchParams.get('probe') || '';
    if (!/^[a-z0-9-]{1,48}$/.test(probe)) {
      return Response.json({error: 'invalid_probe'}, {status: 400});
    }
    ctx.waitUntil(checkHealth(env, {source: 'request', probe}).catch(() => {
      console.error(JSON.stringify({event: 'health_check_failed', source: 'request', probe}));
    }));
    return Response.json({accepted: true, probe}, {status: 202, headers: {'Cache-Control': 'no-store'}});
  },
  async scheduled(controller, env) {
    await checkHealth(env, {
      source: 'scheduled',
      probe: `cron-${controller.scheduledTime}`,
      cron: controller.cron,
      scheduledTime: controller.scheduledTime
    });
  }
};
JS
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": [
      "* * * * *"
    ]
  }
}
CONFIG
A expressão de cinco campos * * * * * significa a cada minuto, em UTC. Esse agendamento deliberadamente frequente serve apenas para um experimento curto e descartável. scheduled aguarda a operação de integridade, portanto o resultado da invocação reflete a conclusão; ele não retorna uma resposta HTTP. O log registra a expressão cron real do trigger e o horário agendado.
npx wrangler dev -c wrangler.jsonc -c health/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
Aguarde o prompt e depois inspecione o log. Continue quando o servidor de desenvolvimento público estiver pronto na porta 8080. Se ele ainda estiver iniciando, aguarde brevemente e leia o log novamente.
cat dev.log
curl -i "http://127.0.0.1:8080/cdn-cgi/local/scheduled?cron=*+*+*+*+*&time=1700000000000&format=json"
cat dev.log
O trigger local deve retornar outcome ok, e o log da aplicação deve conter source scheduled, cron * * * * * e scheduledTime 1700000000000. Esse timestamp antigo é uma entrada de teste sintética intencional, não uma evidência de execução atual na nuvem. Use a verificação para executar um horário agendado controlado diferente e confirmar que o serviço de integridade foi chamado.
Para invocações HTTP, waitUntil pode estender o trabalho por até 30 segundos depois que a resposta é enviada ou o cliente se desconecta; esse limite é compartilhado pelas promises em segundo plano da solicitação. Ele não é uma fila durável nem uma garantia de nova tentativa. A operação deste laboratório, limitada a três segundos, se encaixa nesse uso. O trabalho que precisa de entrega ou novas tentativas confiáveis deve usar uma arquitetura adequada de fila ou workflow fora deste laboratório. Consulte a documentação da Context API e do scheduled handler para conhecer as diferentes durações das invocações.
Fazer o deploy e observar o trabalho em segundo plano de uma solicitação
Nesta etapa, faça o deploy dos dois novos Workers na sua própria conta de aprendizagem. Interrompa o job local real e autorize esta VM nova usando o fluxo familiar de dispositivo.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Abra o link de dispositivo exibido no navegador em que você está conectado, informe o código, revise o acesso solicitado e selecione a conta de aprendizagem. Aguarde a confirmação de sucesso no terminal.
npx wrangler whoami --json
Confirme o nome da conta, mesmo que apenas uma conta seja listada. Substitua YOUR_ACCOUNT_ID nas duas configurações abaixo pelo ID real. Mantenha os mesmos nomes de Worker gerados e o agendamento de um minuto. O Worker público também habilita Workers Logs, portanto os logs de invocação e da aplicação ficam disponíveis em Observability no Dashboard. Isso é separado da conexão ativa de wrangler tail. Este laboratório descartável emite apenas dados sintéticos de verificação de integridade; nunca registre credenciais. Consulte a documentação do Workers Logs.
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": [
      "* * * * *"
    ]
  },
  "observability": {
    "enabled": true
  },
  "account_id": "YOUR_ACCOUNT_ID"
}
CONFIG
cat > health/wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME-health",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false,
  "account_id": "YOUR_ACCOUNT_ID"
}
CONFIG
npx wrangler deploy -c health/wrangler.jsonc
npx wrangler deploy
O serviço interno de integridade é implantado primeiro para que o binding do Worker público possa resolvê-lo. Confirme que a saída do deploy público inclui schedule: * * * * *. Copie abaixo o endereço workers.dev real.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
curl -i "$APP_URL/health"
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
Aguarde alguns segundos para a conexão do tail ser inicializada e envie uma verificação sintética.
sleep 5
curl -i -X POST "$APP_URL/checks?probe=remote-one"
cat events.log
Encontre o evento POST e o log health_check correspondente, com source request e probe remote-one. Se nenhum evento estiver visível, inspecione tail-errors.log, aguarde brevemente, envie a solicitação novamente e leia events.log outra vez. Um arquivo de log de um laboratório anterior não é evidência deste deploy.
No Dashboard, abra Compute → Workers & Pages desta conta. Confirme os dois nomes exatos, o endereço do Worker público e o binding HEALTH para o serviço interno correspondente. Use a verificação: ela confirma a propriedade autenticada e os metadados do endpoint/binding, depois abre sua própria sessão curta de live tail e envia um probe novo para confirmar a conclusão do trabalho em segundo plano. O avaliador não considera seu events.log como prova. Mantenha o job de tail em execução para a próxima etapa.
Observar uma execução real do Cron
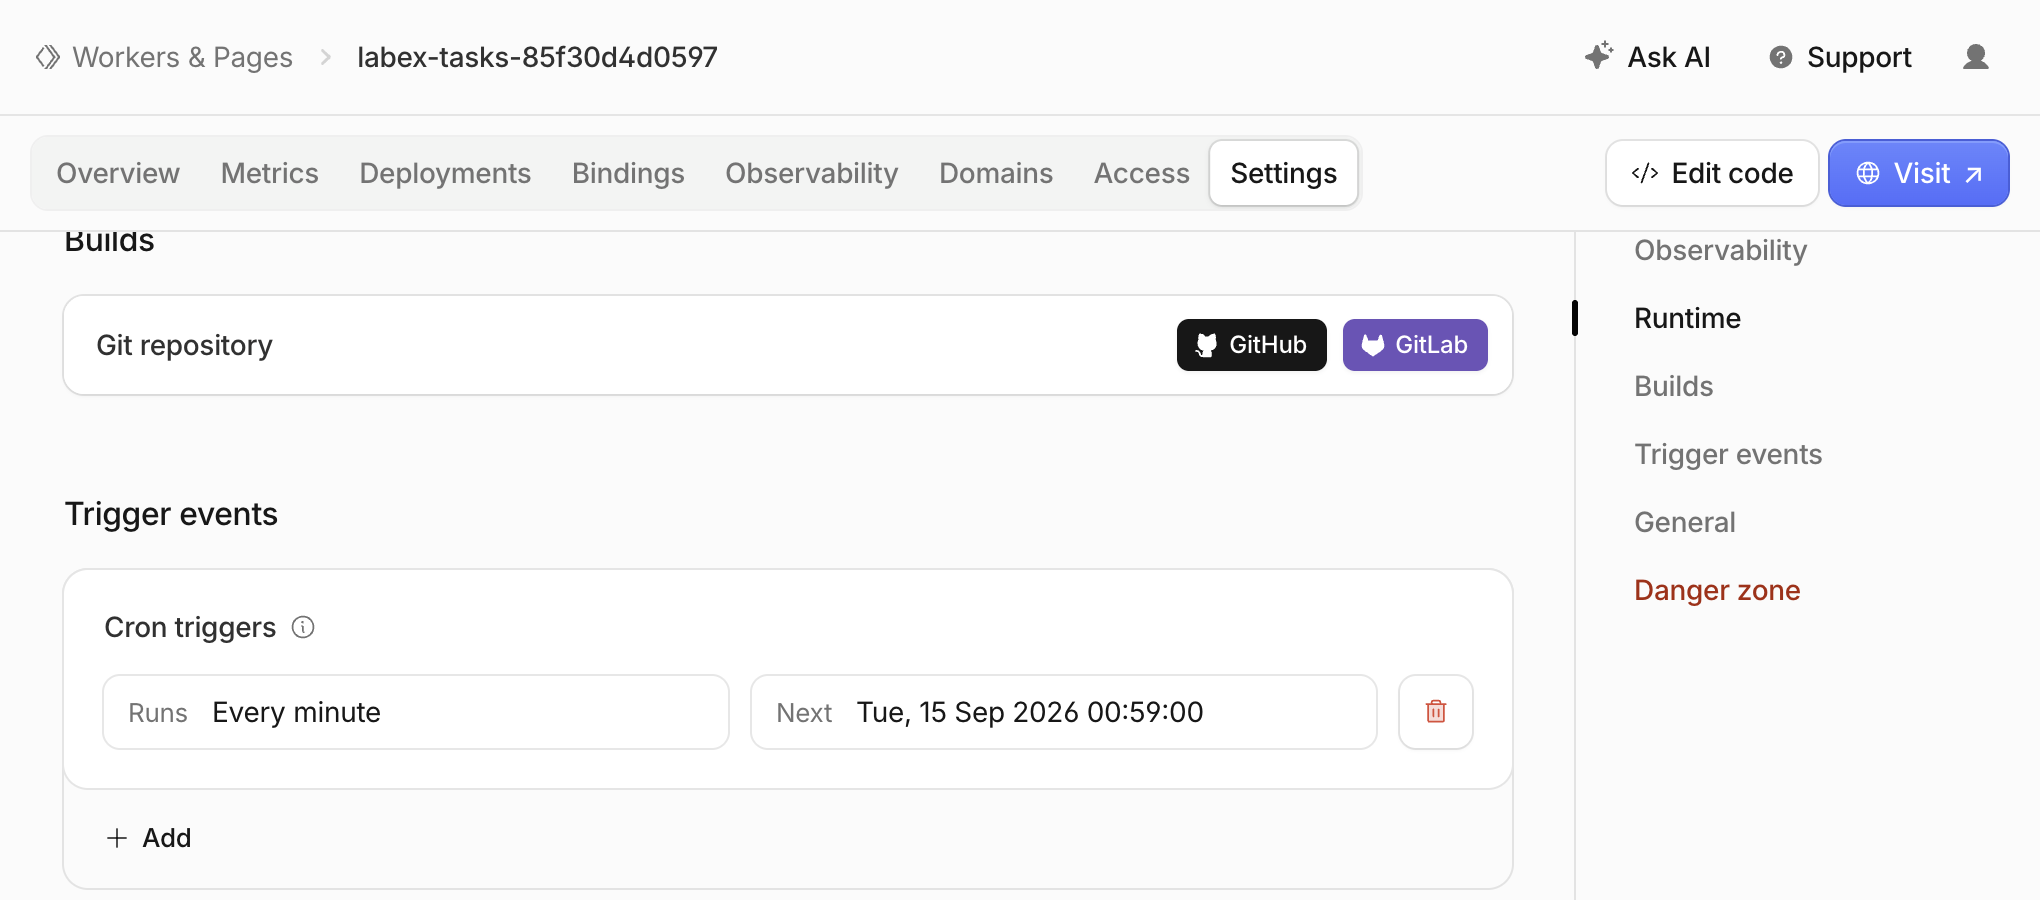
Nesta etapa, diferencie a configuração do deploy da execução. Abra o Worker público no Dashboard e acesse Settings → Trigger events → Cron triggers. Confirme que o agendamento aparece como Every minute. Next time é uma previsão, não uma execução concluída. A existência de um agendamento configurado, por si só, não prova que o handler foi executado.
O exemplo abaixo mostra o menor intervalo compatível: * * * * *, ou uma vez por minuto. Compare o nome do Worker com sua própria configuração. O nome e o horário exibidos são exemplos; você não precisa adicionar outro trigger no Dashboard quando o Wrangler já tiver configurado o trigger.
Mantenha a conexão de tail existente em execução. Aguarde um evento agendado real e inspecione o mesmo arquivo de log:
sleep 60
cat events.log
Encontre uma invocação agendada bem-sucedida na saída legível do tail, identificada pela expressão cron e pelo horário de execução. O log health_check deve ter source scheduled, cron * * * * *, status ok, service labex-health-fixture e scheduledTime. O probe é cron- seguido desse scheduledTime. O verificador independente compara separadamente os metadados estruturados do evento no Cloudflare com este log da aplicação. Um evento POST, um timestamp sintético local ou um log vazio não comprovam esse resultado.
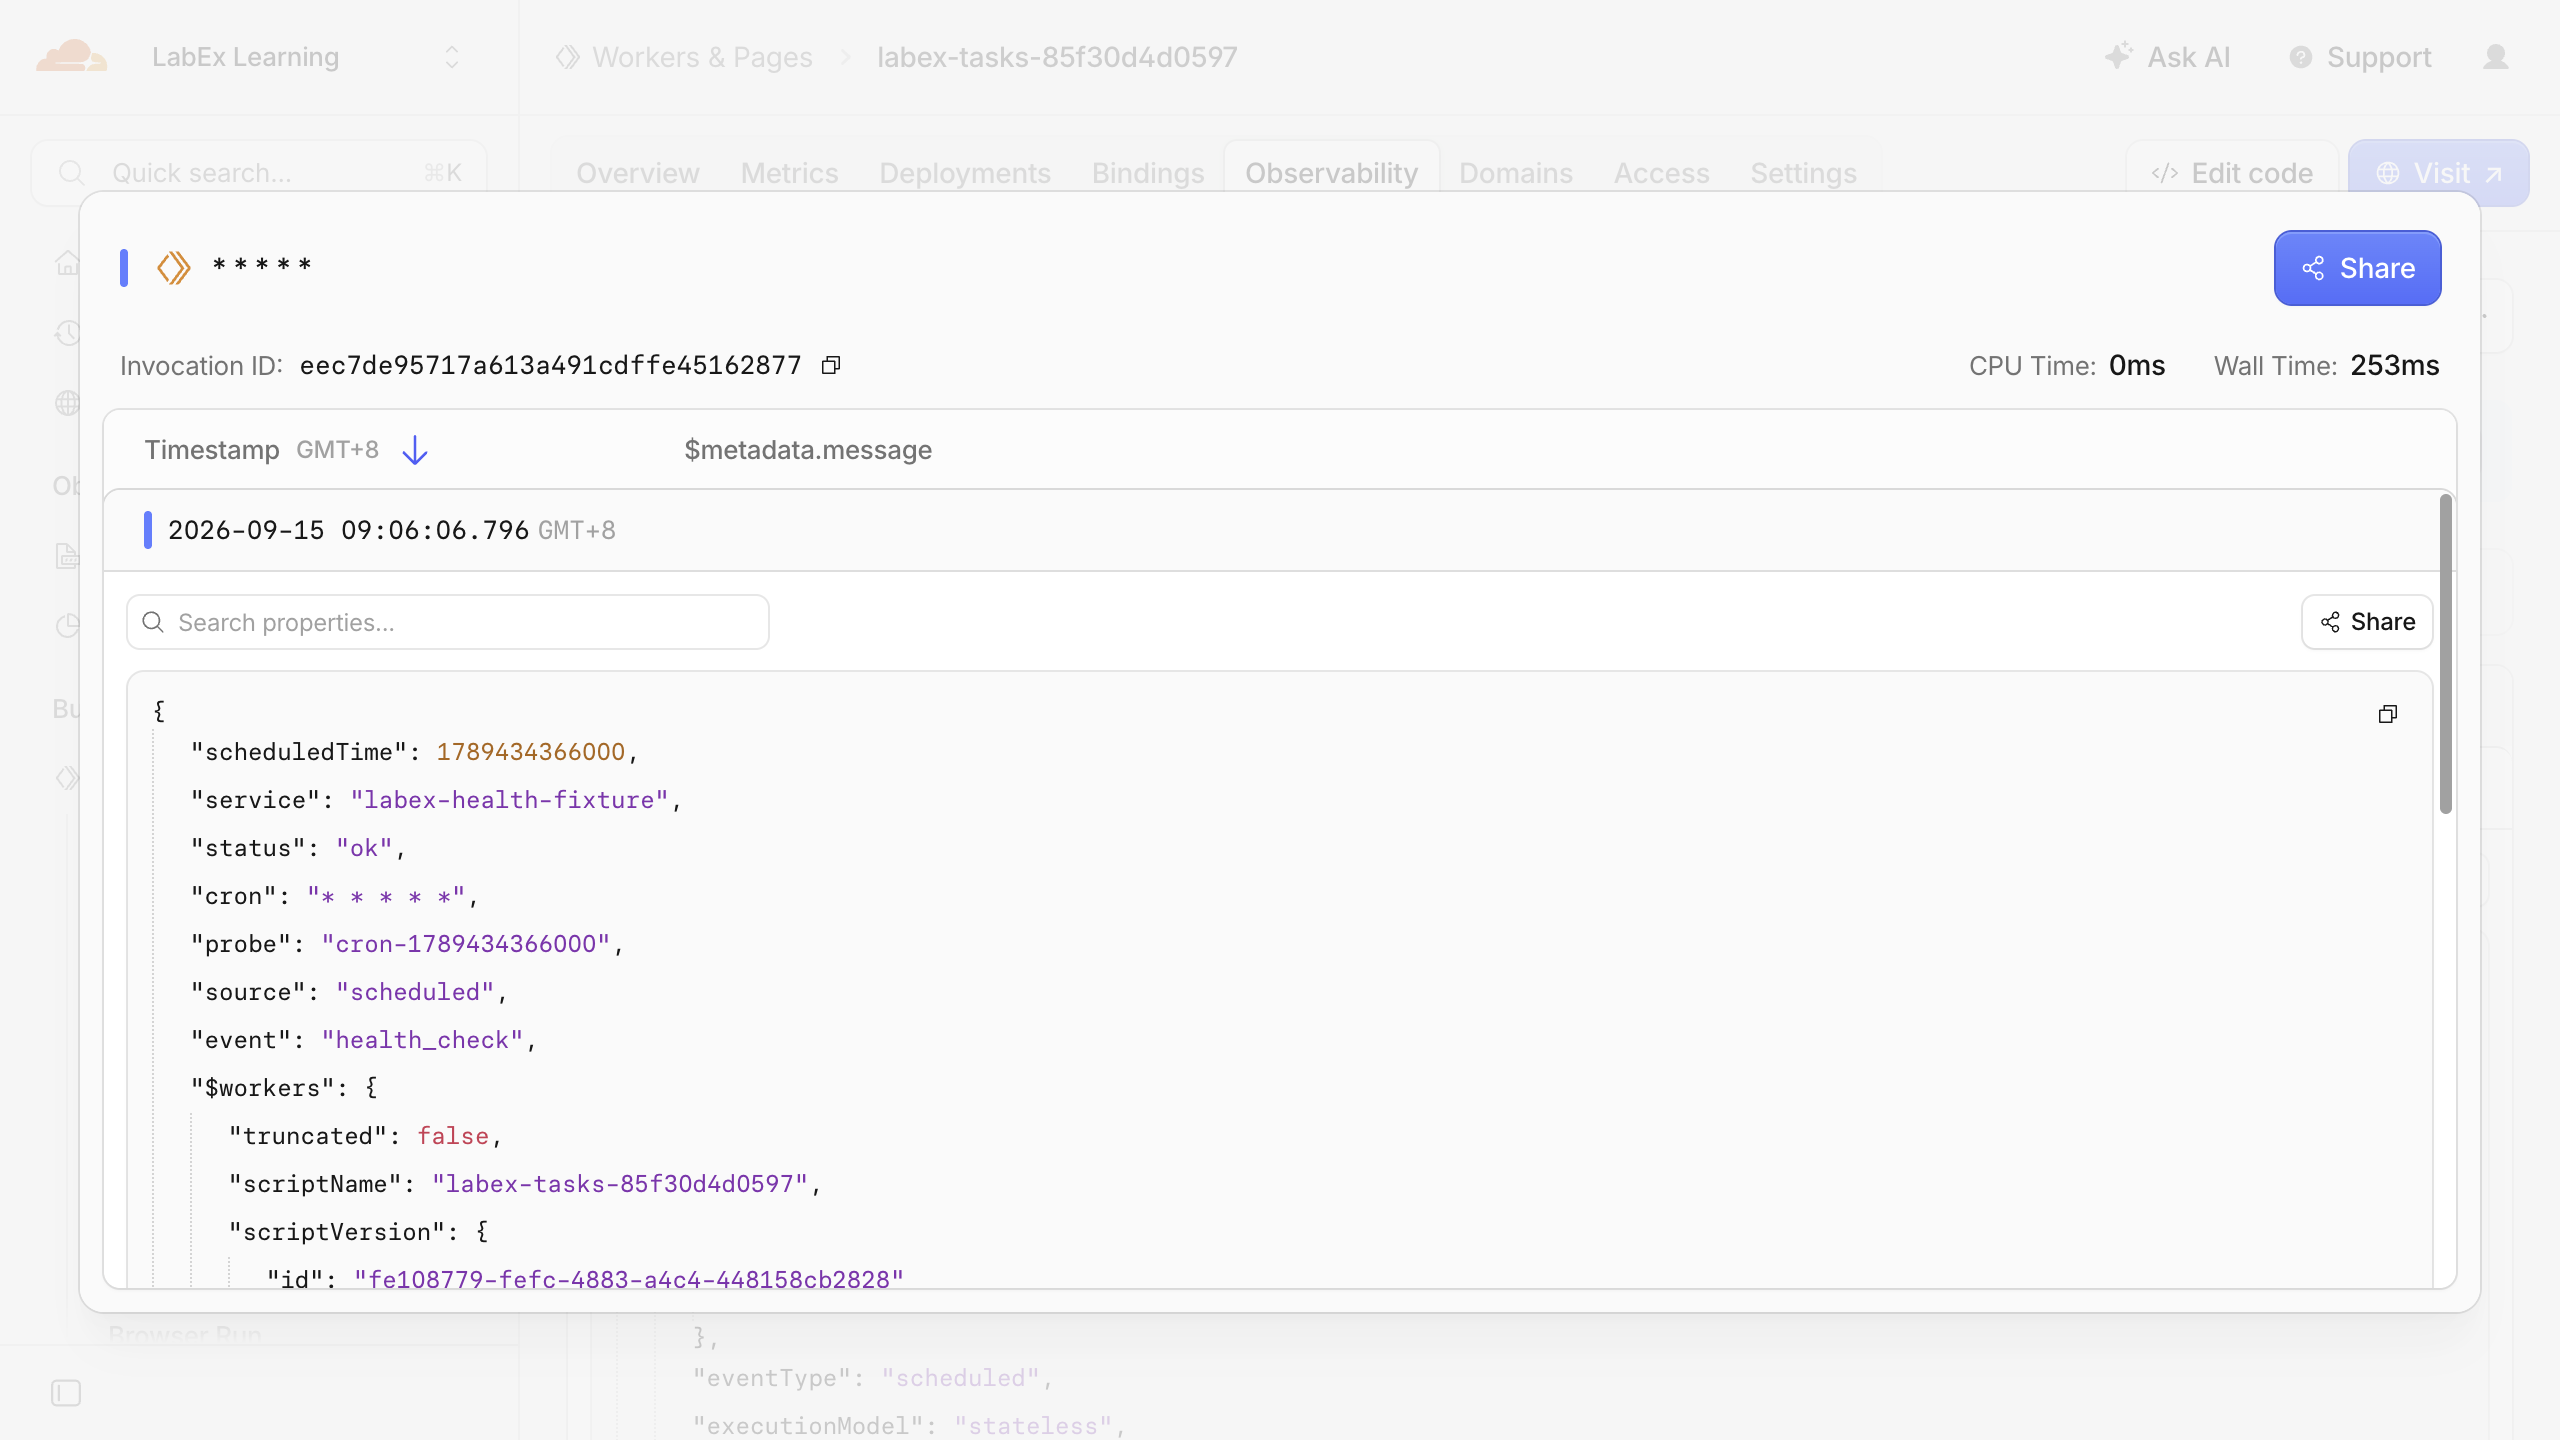
Para relacionar essa saída ao navegador, abra a página Observability → Events do mesmo Worker. Use Live enquanto aguarda ou atualize a consulta de eventos salva com um intervalo de tempo que inclua seu deploy. As linhas de invocação deste handler exibem * * * * *. Expanda uma delas, selecione View invocation e expanda a linha de log da aplicação associada para inspecionar os campos da verificação de integridade. Um log estruturado da aplicação pode ter uma célula Message vazia; expanda a linha em vez de tratá-la como dado ausente. Você pode pausar a exibição ao vivo durante a leitura.
Neste exemplo real, source é scheduled, status é ok e service é labex-health-fixture. O probe cron-... corresponde ao scheduledTime do log da aplicação em milissegundos. O Dashboard exibe o timestamp visível no fuso horário configurado na interface (GMT+8 neste caso), enquanto o agendamento do Cron usa UTC. Seu nome, ID da invocação e horário serão diferentes. Leia esses campos junto com o resultado da invocação; a captura de tela, sozinha, não comprova a conclusão.
As atualizações do Cron podem levar até 15 minutos para serem propagadas. Repita o ciclo de espera de um minuto e inspeção, permitindo no máximo 17 minutos desde o deploy bem-sucedido. Inspecione tail-errors.log se o fluxo estiver vazio ou interrompido. Se nenhum evento correspondente aparecer dentro desse limite, pare e investigue a configuração, a autorização e o status do trigger; não relate sucesso. Esta é uma observação de aprendizagem com limite de tempo, não uma garantia de latência exata de execução. A documentação do Cron Triggers explica a propagação e o agendamento em UTC. Os Workers Logs salvos também podem levar algum tempo para aparecer; atualize a consulta depois de aguardar a ingestão. O histórico separado Past Cron Events de um Worker novo pode levar até 30 minutos para exibir eventos. Um histórico vazio não prova uma falha; use a observação em tempo real acima dentro do limite deste laboratório.
Use a verificação depois de observar uma execução. Ela verifica o agendamento implantado e monitora um fluxo ao vivo separado por até 70 segundos em busca de um evento agendado real com o resultado de integridade. Isso cobre um limite completo de um minuto após o início da conexão. Um resultado sem evento é inconclusivo; inspecione o estado da conexão e da propagação e tente novamente dentro do mesmo limite de observação. O avaliador não fabrica nenhum evento agendado. Interrompa seu tail somente depois que a verificação for bem-sucedida; use o número de job real.
jobs
kill %1
Encerre prontamente o agendamento descartável concluindo a próxima etapa. Não deixe um job de aprendizagem executando a cada minuto sem supervisão.
Excluir os dois Workers do teste agendado
Nesta etapa, remova o Worker público e seu trigger e depois o fixture interno de integridade, enquanto ainda estiver autorizado. Confirme que as duas configurações contêm os nomes exatos deste laboratório e a conta pretendida.
cat wrangler.jsonc
cat health/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c health/wrangler.jsonc
Em cada prompt que corresponder a um nome, pressione a única tecla y. Preserve projetos não relacionados, a conta e seu subdomínio. O Wrangler fixado pode emitir o diagnóstico conhecido de autenticação de limpeza legada do KV depois de excluir um Worker; nem essa mensagem nem uma solicitação de rede malsucedida comprovam a exclusão. Não amplie as permissões por causa desse diagnóstico.
Atualize o Dashboard e use a verificação. Um inventário autenticado bem-sucedido de Workers deve mostrar os dois nomes como ausentes. Isso confirma a remoção dos recursos implantados, não a propagação global imediata de todas as alterações do scheduler. Fazer logout ou simplesmente fechar a VM não executaria essa limpeza.
Desconectar a VM do laboratório
Nesta etapa, confirme que o job de tail foi interrompido e que os recursos foram removidos antes de desconectar esta VM.
jobs
npx wrangler logout
npx wrangler whoami --json
Exija explicitamente loggedIn: false. O comando estruturado não autenticado pode terminar com código diferente de zero; um erro de rede não é o mesmo resultado. Use a verificação e encerre a VM. O login do navegador pode continuar disponível para laboratórios independentes posteriores.
Resumo
Você usou waitUntil para permitir que uma verificação de integridade com duração limitada fosse concluída depois de uma confirmação em primeiro plano e, em seguida, reutilizou essa operação em um handler agendado. Os testes locais controlados separaram a resposta do trabalho atrasado, enquanto um evento real na nuvem comprovou a execução agendada após o deploy. A configuração, a invocação manual e a execução ao vivo forneceram tipos diferentes de evidência.
Você verificou a propriedade e os service bindings, correlacionou probes sintéticos com logs estruturados, respeitou os limites de duração das invocações e removeu a aplicação agendada descartável antes de se desconectar. A entrega confiável de longa duração exige uma arquitetura diferente deste padrão de trabalho em segundo plano de curta duração.
