Introdução
Quando uma API depende de outro serviço, a falha que você vê pode começar em outro lugar. Uma dependência lenta pode deixar um chamador esperando ou produzir uma exceção pouco útil. Você acompanhará uma requisição por uma API de suporte, usará os logs para entender a falha e retornará um erro claro dentro de um limite de tempo, preservando as respostas saudáveis. A mesma técnica ajuda a investigar o relato de um usuário em vez de tentar adivinhar qual parte falhou.
Comece nesta VM nova usando sua própria conta de aprendizagem. Os pré-requisitos são um deployment comum com Wrangler, service bindings e testes locais; nenhum Worker ou VM anterior será reutilizado. A configuração instala Node.js 22.22.0, Wrangler 4.131.1 e Miniflare 4.20260730.0, além de fornecer o chamador com falha e um upstream sintético. O upstream retorna dados sintéticos, um 503 controlado ou um atraso de 2,5 segundos. Não é necessário usar banco de dados, domínio comprado ou realizar um experimento de alta carga.
Uma exceção do runtime, um HTTP 504 deliberado e uma falha por limite de execução são observações diferentes. Você examinará cada tipo de evidência sem tratar toda resposta 5xx como uma falha da plataforma.
Reproduzir e correlacionar o timeout
Nesta etapa, reproduza uma dependência lenta e associe sua resposta ao registro de log correspondente. Um ID de requisição identifica uma requisição para que você possa acompanhá-la entre outras atividades. Um prazo limita por quanto tempo o handler espera: este chamador permite 400 ms, enquanto o modo lento do fixture leva 2,5 segundos. O código inicial não captura a rejeição de fetch, então primeiro você observará essa falha localmente.
cd /home/labex/project/failure-diagnostics
cat src/index.js
cat upstream/index.js
Gere uma base exclusiva para os recursos. O primeiro EOF sem aspas expande essa variável nas duas configurações. O service binding UPSTREAM mantém o fixture privado; um hostname na URL da requisição não seleciona um serviço público.
WORKER_NAME="labex-diagnose-$(node -p "require('node:crypto').randomBytes(6).toString('hex')")"
cat > wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [{"binding": "UPSTREAM", "service": "$WORKER_NAME-upstream"}]
}
EOF
cat > upstream/wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME-upstream",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
EOF
Execute as duas configurações em um único processo de desenvolvimento local. O job em segundo plano mantém o terminal disponível; > e 2>&1 gravam a saída e os erros em dev.log. Aguarde a mensagem Ready antes de enviar requisições.
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Use -H para anexar um pequeno ID de requisição sintético. O handler aceita apenas um formato restrito de ID e gera um ID caso contrário. --max-time limita o cliente curl; ele é separado do prazo definido no handler.
curl -i --max-time 6 -H "X-Request-ID: healthy-one" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-one" "http://127.0.0.1:8080/api/check?mode=slow"
cat dev.log
A requisição saudável retorna 200 com dados sintéticos do upstream. O modo lento deve retornar um erro local 500 e mostrar o registro request_started de slow-one, seguido por uma exceção de timeout não capturada. A página de erro local exata e o stack podem variar. Isso comprova que o prazo rejeita a operação; não comprova que existe uma resposta de erro útil. Execute a verificação antes de alterar o chamador.
Corrigir a resposta de falha e os diagnósticos
Nesta etapa, capture a falha limitada do upstream e mantenha os diagnósticos úteis sem registrar headers ou credenciais. Pare o job atual usando o número real dele.
jobs
kill %1
O tratamento de erros torna uma falha compreensível; ele não torna a dependência saudável. Seu chamador deve informar se a dependência falhou ou demorou demais, enquanto os logs mantêm detalhes não secretos suficientes para a investigação.
Substitua o chamador pelo handler corrigido completo abaixo. O delimitador entre aspas preserva o JavaScript literalmente. Um 504 identifica o prazo da dependência do chamador; um 502 identifica uma resposta do upstream ou um protocolo com falha. As chamadas bem-sucedidas mantêm o resultado do upstream. elapsed_ms é o tempo decorrido no relógio, não o uso de CPU. O log e a resposta compartilham um ID de requisição para que você possa acompanhar uma única requisição em todo o sistema.
cat > src/index.js <<'JS'
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === '/health') return Response.json({status: 'ok'});
    if (url.pathname !== '/api/check') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'GET') return Response.json({error: 'method_not_allowed'}, {status: 405});
    const mode = url.searchParams.get('mode') || 'healthy';
    if (!['healthy', 'slow', 'fail'].includes(mode)) {
      return Response.json({error: 'invalid_mode'}, {status: 400});
    }
    const suppliedId = request.headers.get('X-Request-ID') || '';
    const requestId = /^[a-z0-9-]{1,64}$/.test(suppliedId) ? suppliedId : crypto.randomUUID();
    const headers = {'X-Request-ID': requestId, 'Cache-Control': 'no-store'};
    const started = Date.now();
    console.log(JSON.stringify({event: 'request_started', request_id: requestId, mode}));
    const upstreamUrl = new URL('https://diagnostic.internal/check');
    upstreamUrl.searchParams.set('mode', mode);
    upstreamUrl.searchParams.set('probe', requestId);
    const signal = AbortSignal.timeout(400);
    const failure = (event, status, detail = {}) => {
      console.error(JSON.stringify({event, request_id: requestId, mode, status,
        elapsed_ms: Date.now() - started, ...detail}));
      return Response.json({error: event, requestId}, {status, headers});
    };
    try {
      const response = await env.UPSTREAM.fetch(upstreamUrl, {signal});
      if (!response.ok) return failure('upstream_status', 502, {upstream_status: response.status});
      const data = await response.json();
      if (data.service !== 'labex-diagnostic-fixture' || data.status !== 'ok' || data.probe !== requestId) {
        return failure('upstream_protocol', 502);
      }
      console.log(JSON.stringify({event: 'request_complete', request_id: requestId,
        mode, status: 200, elapsed_ms: Date.now() - started}));
      return Response.json({status: 'ok', requestId, upstream: data}, {headers});
    } catch {
      return signal.aborted ? failure('upstream_timeout', 504) : failure('upstream_exception', 502);
    }
  }
};
JS
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Depois de ver Ready, compare os três modos e a rota de integridade que não foi alterada. Cada falha deve terminar rapidamente; esperar mais tempo pelo modo lento não é a correção.
curl -i --max-time 6 -H "X-Request-ID: healthy-two" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-two" "http://127.0.0.1:8080/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: fail-two" "http://127.0.0.1:8080/api/check?mode=fail"
curl -i http://127.0.0.1:8080/health
cat dev.log
Espere 200/504/502 para healthy/slow/fail. Cada resposta inclui o ID de requisição no JSON e em X-Request-ID. Os logs associam request_started a request_complete, upstream_timeout ou upstream_status. A última categoria registra o 503 do upstream separadamente do 502 do chamador. Uma falha capturada pode ter um resultado bem-sucedido no runtime porque o handler foi concluído normalmente, mesmo que o status HTTP seja 504 ou 502.
Compare esse resultado com o exemplo fornecido de limite de execução:
cat evidence/execution-limit.json
Esse arquivo é explicitamente uma evidência sintética para ensino, não uma captura do seu Worker. O resultado exceededCpu identifica uma falha por limite de execução; não há garantia de que um catch da aplicação será executado depois que o runtime interromper a execução. Esperar pelo upstream assíncrono deste laboratório não equivale a consumir tempo de CPU. Investigue cálculos ou trabalho de requisição dispendiosos antes de considerar limites; não remova o prazo nem gere carga para imitar este exemplo. A referência oficial de erros explica as categorias de exceções e limites, e a documentação sobre resultados do runtime diferencia o resultado do status HTTP.
Execute a verificação. Ela inicia um runtime isolado com seu próprio fixture e seus próprios IDs de requisição, verifica os contratos de sucesso e falha e confirma que um header Authorization sintético não aparece nos logs capturados da aplicação. Os arquivos de log do aluno não são a prova independente.
Verificar requisições, logs e métricas ao vivo
Nesta etapa, verifique o comportamento corrigido na sua conta de aprendizagem. Pare o desenvolvimento local e autorize esta VM nova usando o mesmo fluxo de dispositivo com escopo ensinado anteriormente.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Abra o link exibido, informe o código e aprove a conta de aprendizagem correta no navegador. Confirme o nome e o ID reais da conta na saída padrão do Wrangler.
npx wrangler whoami --json
Substitua YOUR_ACCOUNT_ID pelo ID real. Este comando comum do Node salva o ID nas duas configurações do projeto, para que cada deployment deixe explícito quem é o proprietário.
node -e 'const fs=require("node:fs");for(const p of ["wrangler.jsonc","upstream/wrangler.jsonc"]){const c=JSON.parse(fs.readFileSync(p));c.account_id="YOUR_ACCOUNT_ID";fs.writeFileSync(p,JSON.stringify(c,null,2)+"\n");}'
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler deploy -c upstream/wrangler.jsonc
npx wrangler deploy
O fixture não tem endpoint público. Copie abaixo a URL workers.dev real do chamador. Se a conta precisar do registro inicial do subdomínio, siga o procedimento de Deploy Your First Cloudflare Worker antes de continuar.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
Inicie um fluxo ao vivo legível. Aguarde até events.log informar Connected antes de enviar requisições; a simples existência do arquivo não indica que o fluxo está pronto.
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
cat events.log
curl -i --max-time 6 -H "X-Request-ID: cloud-healthy" "$APP_URL/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: cloud-slow" "$APP_URL/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: cloud-fail" "$APP_URL/api/check?mode=fail"
cat events.log
Encontre as respostas esperadas 200/504/502 e os IDs correspondentes nos logs da aplicação ao vivo. Se um evento ainda não tiver chegado, examine o mesmo log novamente após alguns segundos; não altere a aplicação para fabricá-lo. Pare e examine tail-errors.log se o fluxo tiver terminado. Uma saída legível pode marcar a invocação capturada com 504 como Ok: isso significa que o runtime foi concluído, não que o upstream estava saudável.
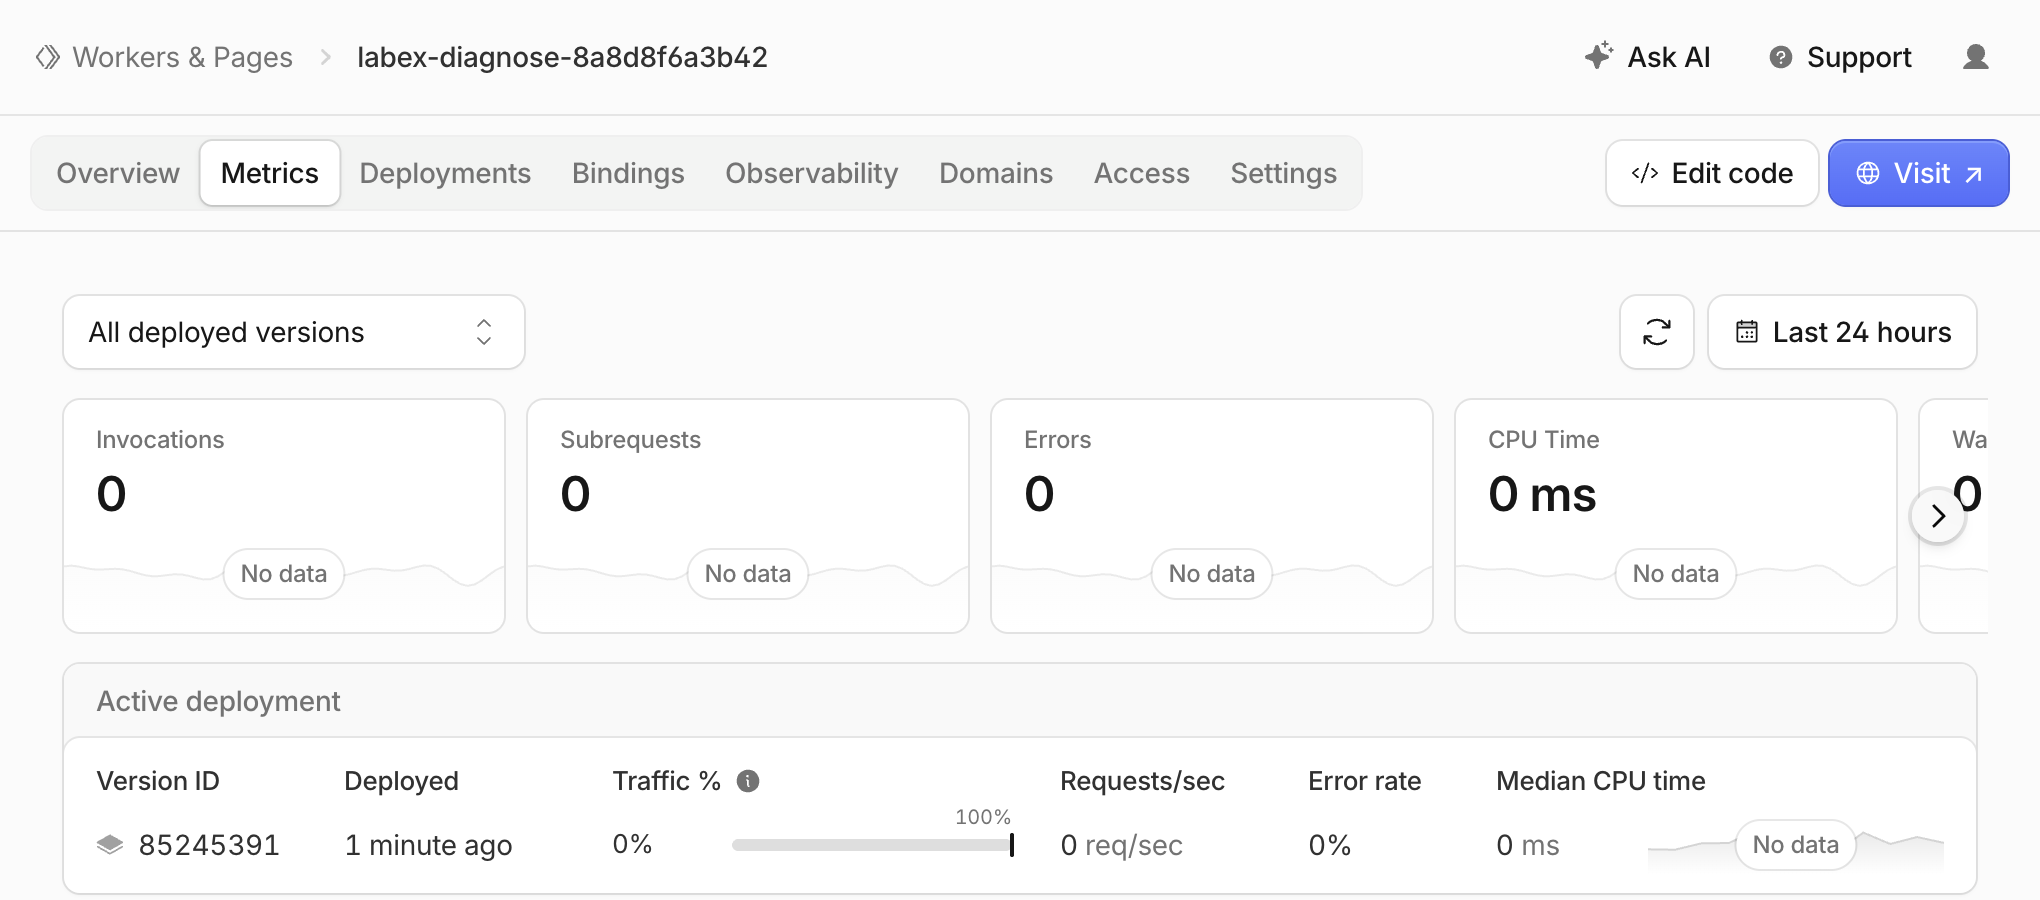
No Dashboard, abra o chamador exato na conta selecionada, confirme que o binding UPSTREAM aponta para este fixture e examine Metrics. Os gráficos disponíveis agregam requisições e erros de invocação e podem atrasar em relação a um teste curto; registre o que estiver realmente visível, sem exigir um total diferente de zero imediatamente. Use os logs ao vivo e as respostas HTTP como evidência de requisições individuais. Um 504 capturado pode aparecer nos dados de status das respostas HTTP sem ser contabilizado como uma exceção não capturada do runtime. A referência de métricas explica a agregação e as categorias de invocação.
Em Compute → Workers & Pages, abra o chamador exato e selecione Metrics. Verifique a trilha de navegação do Worker, o filtro de versão implantada e um intervalo de tempo que inclua suas requisições. O botão de atualização fica ao lado do seletor de intervalo de tempo. A captura de tela abaixo foi feita pouco depois das requisições sintéticas saudável, lenta e com falha no upstream; os cartões ainda mostravam No data. Essa é uma observação válida de análises atrasadas, não uma prova de que nenhuma requisição foi executada ou de que a correção falhou. Seu nome, ID da versão e totais serão diferentes. Não gere carga extra apenas para reproduzir uma imagem.
Execute a verificação enquanto estiver autorizado. Ela consulta a propriedade e o estado dos bindings, envia novas requisições independentes e captura um fluxo ao vivo separado. Aguarde aproximadamente um minuto. Um fluxo indisponível ou incompleto é inconclusivo; verifique se a conexão está pronta e tente novamente. Nunca trate logs ausentes como sucesso. Depois que a verificação for aprovada, pare o tail do aluno usando o número atual do job.
jobs
kill %1
Excluir os Workers de diagnóstico
Nesta etapa, remova apenas o chamador e o fixture deste laboratório enquanto ainda estiver autorizado. Revise os dois nomes e a conta correspondente antes de excluir primeiro o chamador.
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c upstream/wrangler.jsonc
Em cada prompt que corresponder a um dos nomes, pressione a única tecla y. A CLI fixada pode exibir um diagnóstico de autenticação relacionado à limpeza de KV legado depois de excluir um Worker; não amplie as permissões por causa disso nem presuma que erros arbitrários comprovam a exclusão. Atualize o Dashboard e execute a verificação. Os dois nomes devem estar ausentes de um inventário autenticado bem-sucedido. Preserve a conta, o subdomínio e os recursos não relacionados.
Desconectar a VM
Nesta etapa, desconecte a VM depois de verificar a exclusão dos recursos. Fechar o terminal ou sair da conta não removeria os recursos da nuvem.
npx wrangler logout
npx wrangler whoami --json
Espere loggedIn=false; o comando pode terminar com código diferente de zero nesse estado não autenticado. Execute a verificação final. O login do navegador e a conta de aprendizagem poderão ser reutilizados em um laboratório novo posteriormente.
Resumo
Você reproduziu um timeout não tratado, corrigiu falhas limitadas de dependências e correlacionou IDs de requisição entre respostas e logs estruturados. O comportamento saudável foi preservado. Você distinguiu falhas HTTP da aplicação de resultados do runtime e de evidências sintéticas de limite de CPU, verificou o comportamento real na nuvem, removeu os dois Workers e desconectou a VM.