



Introdução
Normalmente, um modelo de IA gera uma nova resposta sempre que uma aplicação o chama. Esse trabalho leva tempo e consome uso do modelo, mesmo quando a solicitação é exatamente igual a uma que o modelo acabou de responder. Um cache mantém uma resposta reutilizável por tempo limitado, permitindo responder a uma solicitação idêntica sem fazer outra chamada ao modelo.
O cache só é útil quando a reutilização é segura. Uma pergunta pública e fixa de FAQ é uma boa candidata, porque todos os usuários podem receber a mesma resposta. Um prompt personalizado de suporte não é: duas pessoas clientes nunca devem ser agrupadas sob uma chave de cache compartilhada apenas para melhorar a velocidade. A chave de cache padrão do AI Gateway protege este laboratório incluindo o provedor, o endpoint, o modelo, a credencial do provedor e o corpo completo da solicitação. Qualquer alteração no corpo cria uma entrada diferente.
Você criará um gateway autenticado descartável com validade de cache de cinco minutos. Enviará uma pequena pergunta pública ao Workers AI e observará um MISS de cache; repetirá a solicitação exata e comprovará um HIT; depois alterará a pergunta e verá outro MISS. Por fim, ignorará a resposta armazenada quando a atualização for importante e confirmará nos logs do gateway que a solicitação chegou ao modelo.
Se você entrou diretamente neste curso, primeiro conclua Conectar o LabEx à sua conta da Cloudflare. Esse laboratório ensina a usar o terminal da VM do LabEx, autorizar o dispositivo do Wrangler, confirmar a conta de aprendizagem e identificar explicitamente os IDs das contas. Conclua também Encaminhar inferências por um gateway antes deste laboratório, pois este laboratório reutiliza os limites separados de gateway e autorização upstream configurados nele.
O laboratório usa o modelo hospedado pela Cloudflare @cf/meta/llama-3.3-70b-instruct-fp8-fast com o faturamento Standard do Workers AI. Workers Paid, Unified Billing e uma conta de provedor externo não são necessários. Apenas três solicitações devem chegar ao modelo; a repetição exata deve vir do cache. Pare, em vez de tentar repetidamente, se a alocação diária compartilhada do Workers AI estiver indisponível.
A configuração instala o Node.js 22.22.0 e o Wrangler 4.132.0 local do projeto em /home/labex/project/ai-gateway-cache. Ela prepara avaliações independentes somente leitura, mas não autoriza o Wrangler, não cria recursos na nuvem nem envia tráfego ao modelo. O LabEx destrói a VM temporária quando o laboratório termina; mesmo assim, você deverá excluir o gateway e o token antes de sair, porque a destruição da VM não remove recursos da nuvem.
Autorizar a VM e nomear o experimento de cache
Nesta etapa, você conectará a VM recém-criada à sua conta de aprendizagem e gerará nomes para um gateway e um token descartáveis.
O cache é uma infraestrutura compartilhada, portanto seu escopo deve ser definido cuidadosamente. Este laboratório usa um gateway com nome exclusivo e somente perguntas públicas sintéticas. O sufixo aleatório impede que seu experimento entre em conflito com outro gateway na mesma conta de aprendizagem.
Entre no projeto preparado, confirme a CLI fixada e autorize esta VM:
cd /home/labex/project/ai-gateway-cache
npx wrangler --version
npx wrangler login --device --browser=false --scopes account:read user:read ai:write
Abra o link exibido, informe o código e autorize a conta de aprendizagem pretendida. Confirme a identidade estruturada:
npx wrangler whoami --json
A saída esperada é Wrangler 4.132.0 e loggedIn: true. Substitua YOUR_ACCOUNT_ID abaixo pelo ID real de 32 caracteres exibido para a conta pretendida:
GATEWAY_ID="labex-c09-g03-$(openssl rand -hex 6)"
TOKEN_NAME="$GATEWAY_ID-token"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "tokenName": "$TOKEN_NAME"
}
JSON
cat .labex/state.json
Esses identificadores não secretos permanecem em um inventário local para que todas as leituras, verificações e etapas de limpeza posteriores tenham como alvo somente os recursos deste laboratório.
Criar um gateway autenticado com cache de curta duração
Nesta etapa, você criará o gateway e dará às respostas armazenadas uma time to live, ou TTL, de cinco minutos. A TTL é o tempo máximo durante o qual uma entrada pode ser reutilizada antes de ficar obsoleta e precisar ser atualizada a partir do modelo.
Abra o Cloudflare Dashboard e escolha AI → AI Gateway → Create gateway → Custom gateway. Use o gatewayId salvo como nome do gateway. Mantenha o registro de solicitações e a autenticação do gateway ativados, habilite Cache responses e defina a TTL exatamente como 300 segundos. Mantenha os limites de taxa, os limites de gastos e as tentativas desativados, e mantenha o faturamento do Workers AI em Standard.
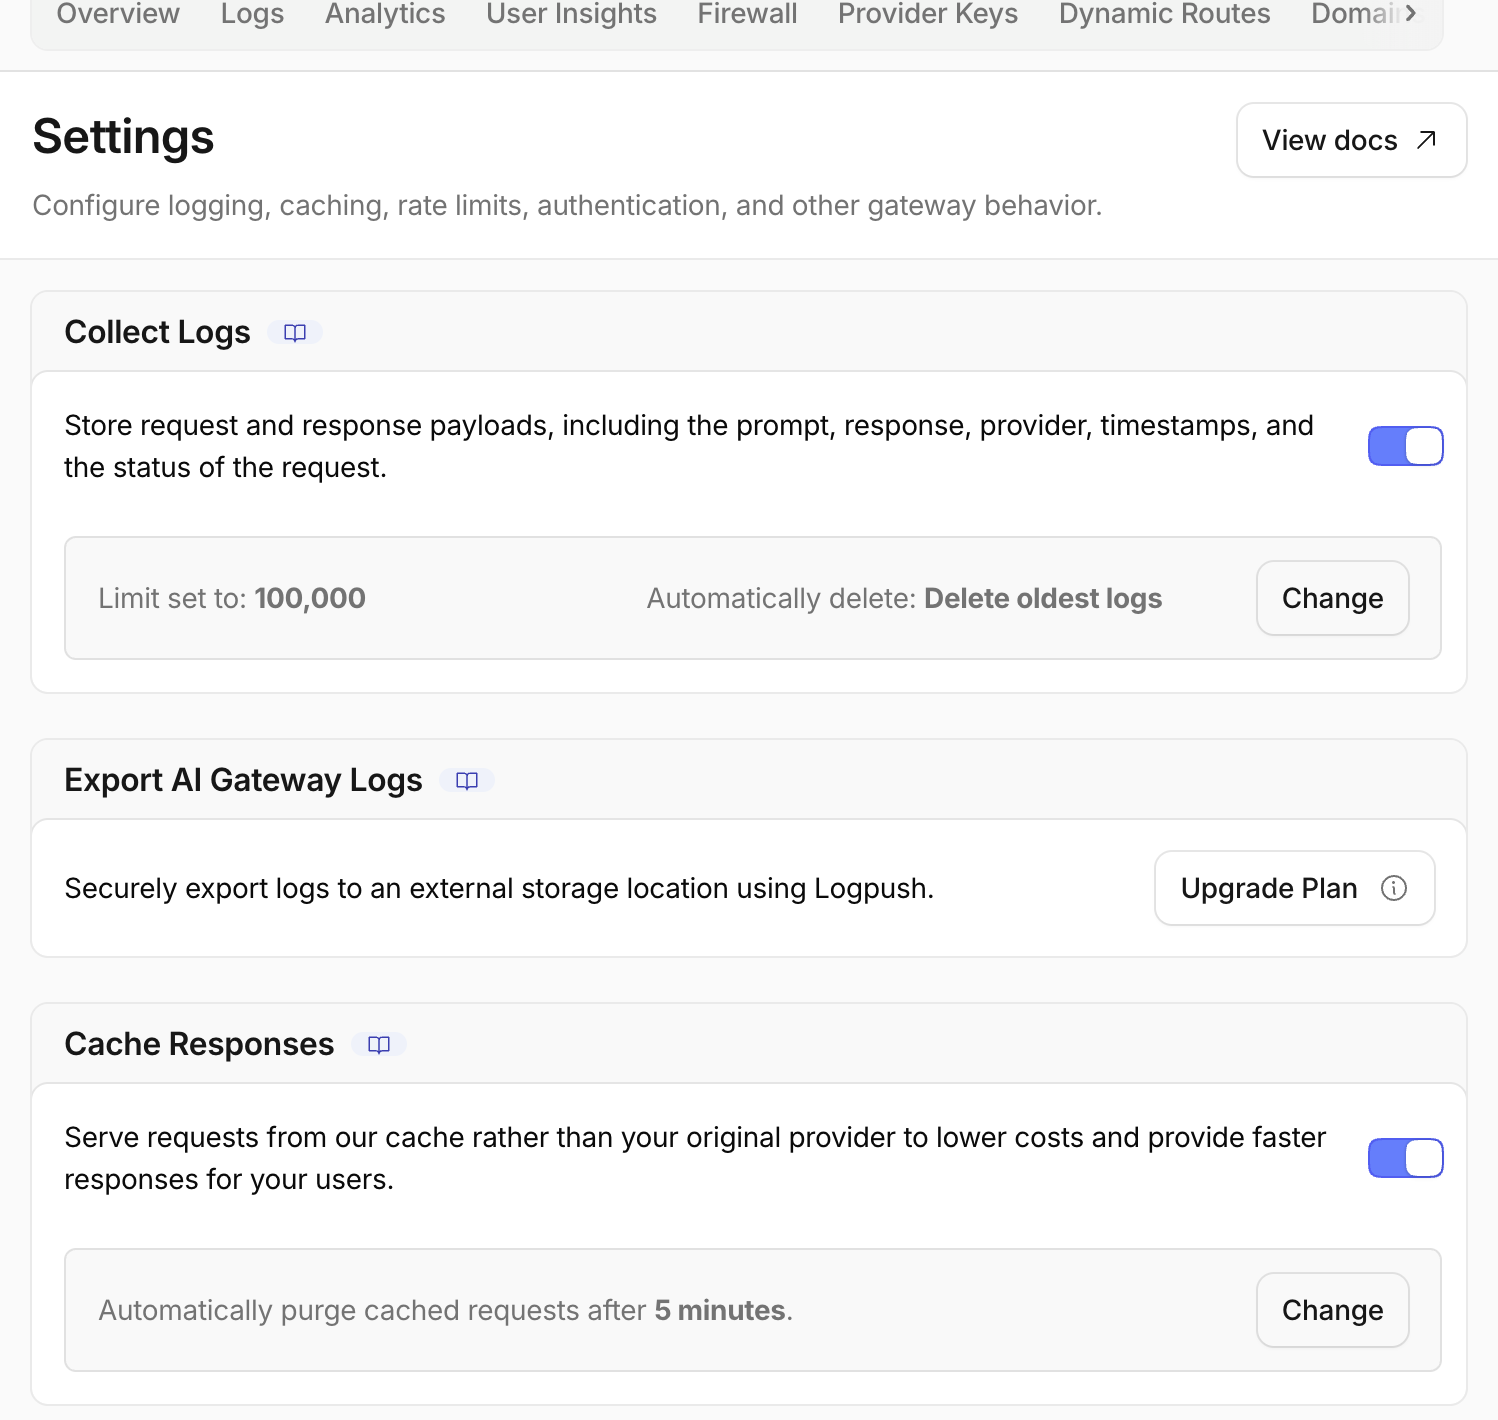
Após a criação, confirme o ID exclusivo do gateway na trilha de navegação. A TTL curta é suficiente para repetir este experimento, mas impede que a resposta de exemplo permaneça armazenada por tempo desnecessário.
Escolha Create an AI Gateway authentication token. Use o tokenName salvo, inclua somente a conta de aprendizagem pretendida e defina exatamente estas permissões:
- AI Gateway — Run para acessar o gateway autenticado;
- AI Gateway — Edit para ler as evidências do cache e excluir este gateway descartável.
Não adicione a permissão do Workers AI. O Wrangler fornece a credencial upstream separada e de curta duração. Crie o token após revisar a conta e as permissões; depois, armazene o valor de uso único sem exibi-lo:
bash -c '
while :; do
  read -ersp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
Verifique a configuração exata do cache por meio da API de gerenciamento autenticada:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s),g=b.result||{};console.log(JSON.stringify({success:b.success,id:g.id,collect_logs:g.collect_logs,authentication:g.authentication,cache_ttl:g.cache_ttl},null,2))})'
unset GATEWAY_TOKEN
A saída esperada contém o ID salvo, collect_logs: true, authentication: true e cache_ttl: 300.
Enviar a primeira solicitação pública de FAQ
Nesta etapa, você enviará uma pequena pergunta pública que todos os participantes podem reutilizar com segurança. A primeira solicitação elegível ainda não pode ter uma entrada neste gateway novo, portanto deve resultar em um MISS de cache. Um miss significa que o AI Gateway encaminha a solicitação ao Workers AI e depois armazena a resposta bem-sucedida.
A chave de cache padrão inclui a credencial do provedor upstream. Salve de forma privada a credencial atual do Wrangler desta VM para que as quatro solicitações usem uma única chave controlada. Este é um arquivo de laboratório de curta duração, não um padrão de segredo para produção:
umask 077
npx wrangler auth token --json \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))' \
  > .labex/upstream-token
chmod 600 .labex/upstream-token
Envie a primeira solicitação e salve os cabeçalhos, o corpo da resposta e o status HTTP sem imprimir nenhuma das duas credenciais:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
METADATA='{"lab":"g03-cache","case":"public-faq","synthetic":true}'
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
STATUS=$(curl --http1.1 -sS -D .labex/first-headers.txt \
  -o .labex/first-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/first-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/first-headers.txt \
  | tail -1 | tee .labex/first-cache-status.txt
node -e 'const b=require("./.labex/first-response.json"); console.log(b.result?.response ?? b.result)'
A saída esperada é HTTP 200, status de cache MISS e uma resposta curta gerada pelo modelo. O corpo da solicitação não contém dados de clientes, portanto é seguro reutilizar temporariamente essa resposta.
Repetir a solicitação exata e comprovar um cache hit
Nesta etapa, você enviará exatamente o mesmo provedor, endpoint, modelo, credencial e corpo da solicitação. Assim, o AI Gateway poderá reutilizar a entrada criada na etapa anterior. Um cache HIT significa que a resposta veio do cache do gateway sem uma nova geração pelo modelo.
O armazenamento no cache é assíncrono. Portanto, aguarde alguns segundos para que a primeira resposta bem-sucedida seja processada antes de repeti-la:
sleep 5
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"public-faq","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/repeat-headers.txt \
  -o .labex/repeat-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/repeat-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/repeat-headers.txt \
  | tail -1 | tee .labex/repeat-cache-status.txt
cmp -s .labex/first-response.json .labex/repeat-response.json \
  && echo 'response bytes match the cached source'
A saída esperada é HTTP 200 e HIT. A correspondência dos bytes é uma observação adicional útil, mas o cabeçalho de resposta HIT e o log armazenado no Dashboard são as evidências oficiais. O armazenamento do cache do AI Gateway é assíncrono e volátil; portanto, não envie as duas solicitações simultaneamente. Se a repetição sequencial ainda resultar em miss, aguarde alguns segundos e execute este bloco exato mais uma vez.
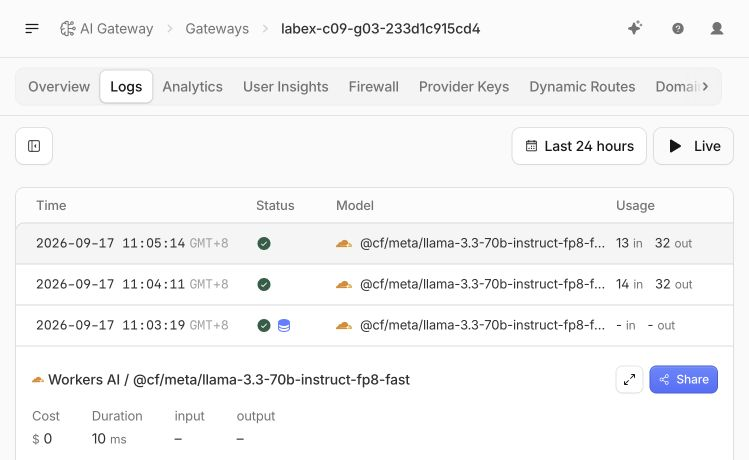
Abra a visualização Logs do gateway no Dashboard. Encontre as duas solicitações public-faq e compare os indicadores de cache, as durações e o uso de tokens. Uma linha deve mostrar o miss atendido pelo modelo, e a outra deve mostrar o hit atendido pelo cache.
Alterar a pergunta e observar um novo miss
Nesta etapa, você alterará somente o prompt. O corpo completo da solicitação participa da chave de cache padrão, portanto esta nova pergunta não deve receber a resposta anterior.
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"changed-question","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/changed-headers.txt \
  -o .labex/changed-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, name one benefit of an AI gateway.","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/changed-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/changed-headers.txt \
  | tail -1 | tee .labex/changed-cache-status.txt
node -e 'const b=require("./.labex/changed-response.json"); console.log(b.result?.response ?? b.result)'
A saída esperada é HTTP 200 e MISS. Esse comportamento de correspondência exata é deliberadamente mais restrito que a similaridade semântica: duas perguntas que parecem relacionadas ainda têm corpos diferentes e entradas de cache diferentes.
Não substitua a chave padrão por uma única chave compartilhada, como support-answer, para prompts personalizados. Uma chave personalizada só é segura quando todas as solicitações agrupadas sob essa chave têm autorização para receber a mesma resposta.
Ignorar o cache quando a atualização for importante
Nesta etapa, você voltará à pergunta original, mas ignorará explicitamente a resposta armazenada. Bypass significa “perguntar ao provedor agora”, mesmo que exista uma entrada de cache válida. Isso é útil quando uma aplicação precisa de uma resposta atualizada para uma solicitação específica.
O cabeçalho cf-aig-skip-cache: true controla somente esta solicitação. Ele não desativa o cache do gateway para os demais usuários:
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"fresh-bypass","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/bypass-headers.txt \
  -o .labex/bypass-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'cf-aig-skip-cache: true' \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/bypass-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/bypass-headers.txt \
  | tail -1 | tee .labex/bypass-cache-status.txt
node -e 'const b=require("./.labex/bypass-response.json"); console.log(b.result?.response ?? b.result)'
A saída esperada é HTTP 200 e nenhum HIT. Dependendo da resposta atual do gateway, o cabeçalho pode indicar um bypass ou simplesmente permanecer diferente de hit; o log oficial do gateway deve mostrar cached: false para fresh-bypass.
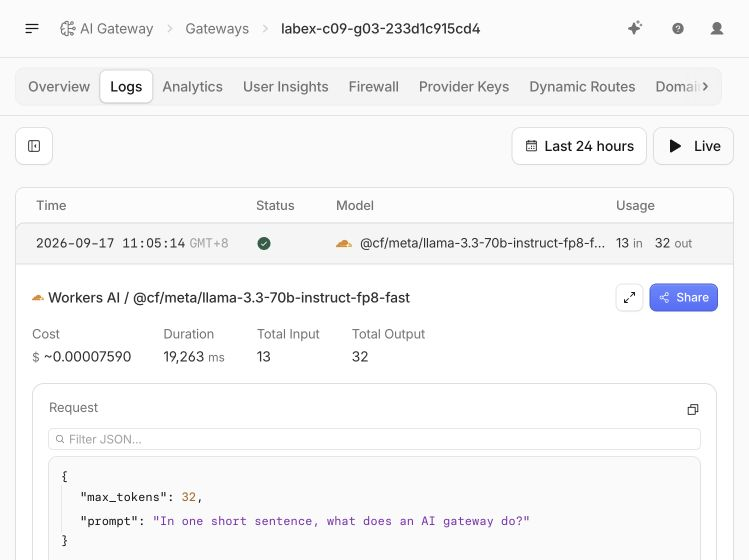
Volte para Logs no Dashboard e abra a solicitação fresh-bypass. Compare-a com a linha armazenada de public-faq. A mesma pergunta chegou ao Workers AI porque o bypass por solicitação substituiu o comportamento padrão do gateway.
Excluir o gateway descartável
Nesta etapa, você removerá o gateway enquanto a credencial de gerenciamento ainda pode comprovar que ele não existe mais. A exclusão deste gateway sob sua responsabilidade também remove seu namespace de cache de curta duração e seus logs.
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s);if(!b.success)process.exit(1);console.log("gateway deletion accepted")})'
unset GATEWAY_TOKEN

GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
node -e 'const b=require("./.labex/gateways-after-delete.json"),id=process.argv[1],found=(b.result||[]).some(g=>g.id===id);console.log("gateway absent:",!found);if(found)process.exit(1)' "$GATEWAY_ID"
A saída esperada é gateway absent: true. Este inventário autenticado diferencia uma exclusão real de uma página ausente causada por logout ou falha de rede.
Excluir o token e sair
Nesta etapa, você revogará a credencial restante na nuvem, apagará as duas cópias temporárias do token e desconectará a VM.
No Cloudflare Dashboard, abra My Profile → API Tokens. Encontre o tokenName salvo exatamente, abra Actions, escolha Delete, revise a confirmação e exclua somente esse token. Agora é seguro revogá-lo, pois a exclusão do gateway já foi comprovada.
Apague os arquivos dos tokens do gateway e upstream e encerre a autorização separada do Wrangler:
shred -u .labex/gateway-token .labex/upstream-token
npx wrangler logout
npx wrangler whoami --json || true
test ! -e .labex/gateway-token -a ! -e .labex/upstream-token \
  && echo "local token files removed"
A saída esperada contém loggedIn: false e local token files removed. A sessão do Dashboard é separada e continua conectada. Quando o laboratório terminar, o LabEx destruirá esta VM temporária em vez de salvá-la.
Resumo
Você configurou um cache curto de respostas do AI Gateway para uma pergunta pública segura. A primeira solicitação produziu um MISS, a repetição exata se tornou um HIT e a entrada alterada criou uma entrada separada. Em seguida, você usou um bypass por solicitação quando a atualização era importante e confirmou pelos logs que o modelo — e não a cópia armazenada — processou a solicitação.
O próximo laboratório adiciona controles de tráfego. Você aprenderá a diferença entre limitar a frequência de chegada das solicitações e limitar quanto uso do modelo um gateway pode consumir, mantendo o volume de testes e o custo deliberadamente baixos.


