



Introdução
A aplicação envia leituras e gravações ao mesmo primário. Você criará uma réplica PostgreSQL, direcionará as consultas a ela e comprovará que novas gravações do primário ficam legíveis na réplica, que rejeita gravações diretas.
Esta é uma extensão opcional após os laboratórios de conexão, SQL e recuperação. O ambiente começa de forma independente com um primário e três pedidos. Você removerá a réplica e o primário ao final.
Relação com certificações
Este laboratório oferece prática introdutória para os seguintes tópicos de exames.
- Cloud Practitioner (CLF-C02) · Tarefa 3.4: Reconhecer um caso de uso de réplica de leitura relacional.
- Solutions Architect – Associate (SAA-C03) · Tarefa 3.3: Configurar réplicas para o padrão de acesso de leitura de uma aplicação.
Crie e inspecione uma réplica de leitura
Nesta etapa, você criará um segundo PostgreSQL que recebe alterações do primário.
Uma réplica de leitura atende consultas com dados copiados. O PostgreSQL envia alterações pelo log de gravação antecipada, o WAL. O servidor em espera reproduz as alterações. É um mecanismo separado, e a replicação pode ficar atrás de uma gravação recém-confirmada.
Uma réplica e um servidor em espera Multi-AZ têm finalidades diferentes. A réplica oferece um endpoint para consultas da aplicação. O servidor em espera de uma implantação padrão de instância DB Multi-AZ apoia disponibilidade e failover, sem atender leituras da aplicação. Este laboratório implementa uma réplica, não um failover Multi-AZ.
Carregue as configurações de conexão:
cd /home/labex/project
source database.env
Inspecione a origem:
aws rds \
  describe-db-instances \
  --db-instance-identifier orders-db \
  --query 'DBInstances[0].{Identifier:DBInstanceIdentifier,Status:DBInstanceStatus,BackupRetention:BackupRetentionPeriod,Endpoint:Endpoint}'
O RDS exige retenção de backups diferente de zero na origem de uma réplica. Este módulo fornece um primário com retenção 1. Você usará essa configuração; o exercício não testa o agendamento automático de backups.
Crie a réplica:
aws rds \
  create-db-instance-read-replica \
  --db-instance-identifier orders-reader \
  --source-db-instance-identifier orders-db \
  --db-instance-class db.t3.micro \
  --no-publicly-accessible \
  --query 'DBInstance.{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Status:DBInstanceStatus,Endpoint:Endpoint}'
aws rds \
  wait db-instance-available \
  --db-instance-identifier orders-reader
Inspecione ambos os recursos:
aws rds \
  describe-db-instances \
  --query 'DBInstances[].{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Endpoint:Endpoint.Address}' \
  --output table
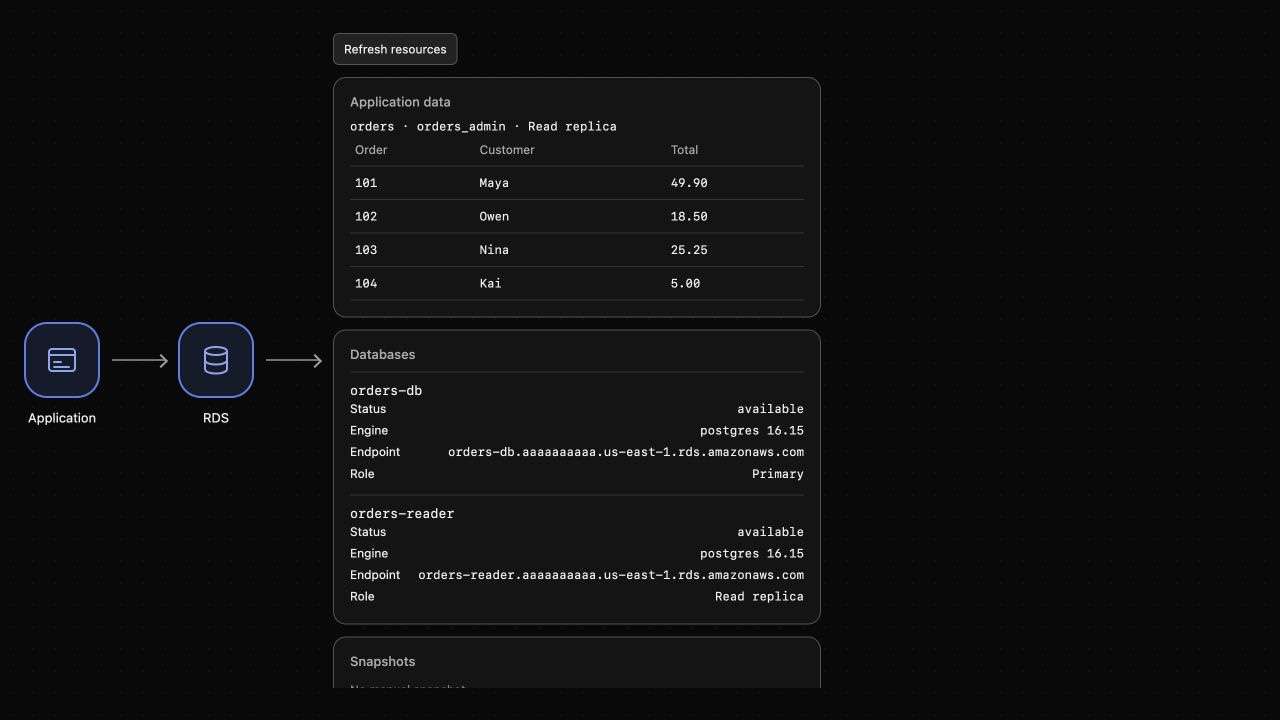
Espere encontrar um endpoint separado para orders-reader e uma relação de origem com orders-db. O AWS View deve listar primário e réplica.
Consulte o mecanismo real da réplica:
psql \
  "service=orders-reader" \
  --command 'SELECT current_database(), pg_is_in_recovery();'
Espere encontrar o banco orders e pg_is_in_recovery igual a t (true). O PostgreSQL realmente executa em recuperação como servidor em espera, além de apenas ter um recurso RDS rotulado como réplica.
Separe endpoints de leitura e gravação
Nesta etapa, você manterá gravações no primário e enviará consultas à réplica.
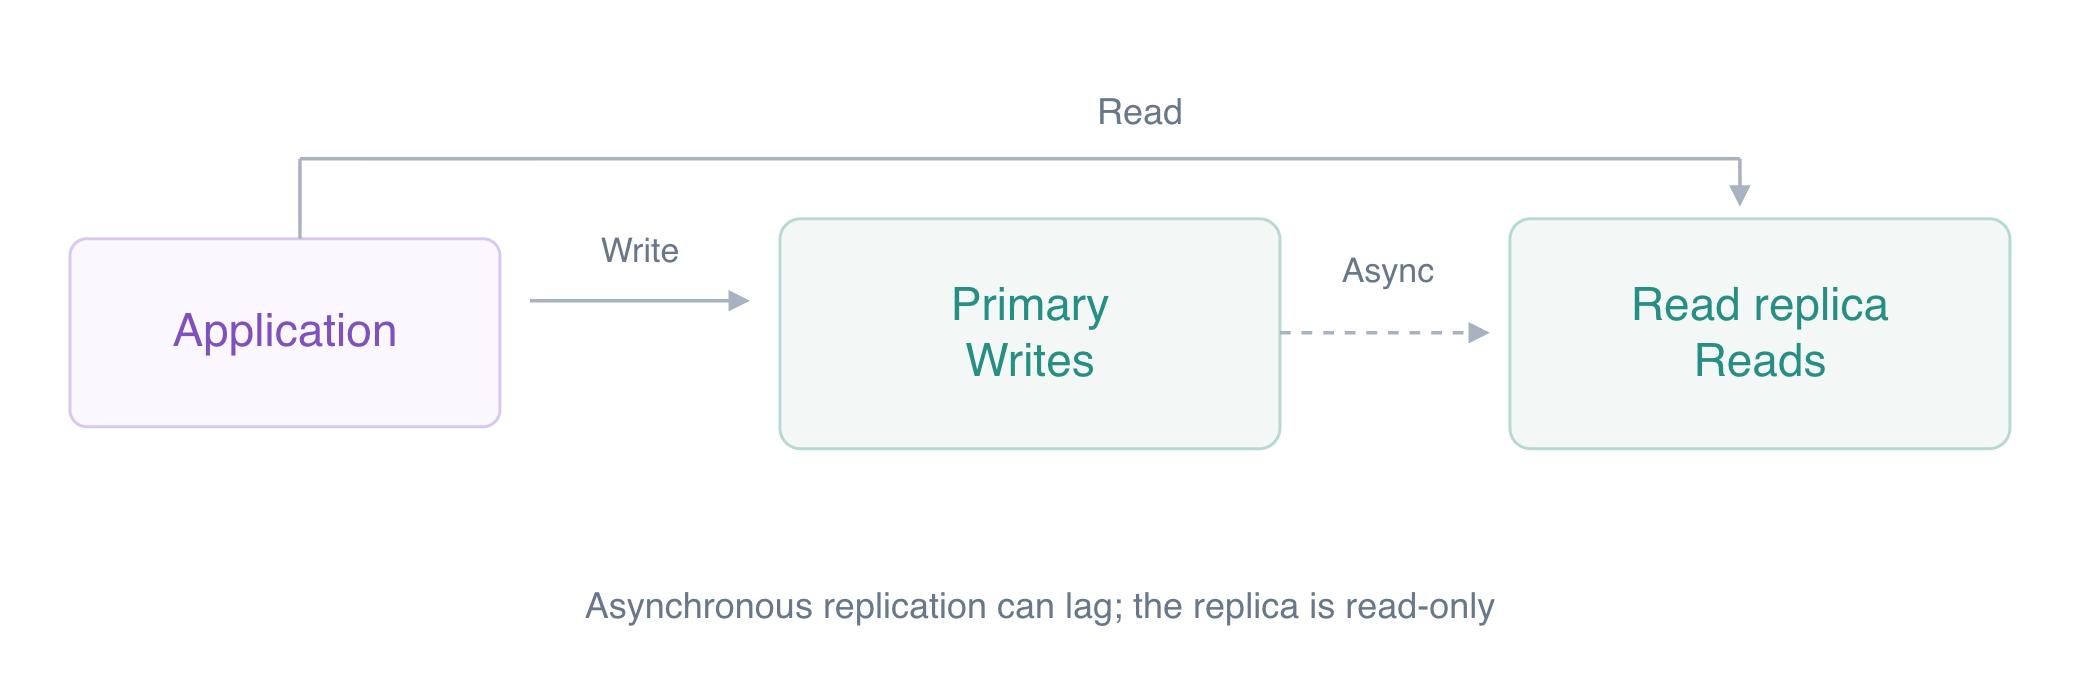
Diagrama conceitual: As escritas vão ao primário; as leituras podem usar a réplica atualizada de forma assíncrona.
Inspecione a configuração da aplicação:
cat app-config.json
Ambos os hosts indicam o primário. Obtenha o endpoint da réplica:
READER_ENDPOINT=$(aws rds \
  describe-db-instances \
  --db-instance-identifier orders-reader \
  --query 'DBInstances[0].Endpoint.Address' \
  --output text)
Altere apenas read_host:
jq \
  --arg host "$READER_ENDPOINT" \
  '.read_host = $host' \
  app-config.json > app-config.new
mv app-config.new app-config.json
Leia pela aplicação:
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Espere encontrar os três pedidos originais e read_only: true. A resposta vem da conexão SQL real ao servidor em espera. O AWS View deve identificar a origem dos dados da aplicação como réplica de leitura.
A réplica usa identidades de banco copiadas da origem. A seleção do endpoint determina a instância alcançada; autenticação e permissões SQL continuam valendo.
Observe a replicação e a rejeição de gravações
Nesta etapa, você salvará um pedido pelo primário e o lerá pela réplica.
Adicione um pedido pela aplicação. Seu manipulador POST usa write_host, ainda apontando ao primário:
curl \
  --silent \
  --show-error \
  --fail \
  --request POST \
  --header 'Content-Type: application/json' \
  --data '{"order_id":104,"customer":"Kai","total":"5.00"}' \
  http://127.0.0.1:8080/application/orders
Espere encontrar saved: true. Consulte origem e réplica de forma independente:
psql \
  "service=orders-db" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
psql \
  "service=orders-reader" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
Espere encontrar o pedido de Kai de 5.00 em ambas. Se a primeira consulta à réplica ainda não encontrar a linha, repita após um momento: a replicação assíncrona admite atraso. Uma réplica ajuda em cargas com muitas leituras, mas a consistência imediata pode exigir ler um valor recém-gravado do primário.
Leia novamente a lista da aplicação:
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Espere encontrar quatro pedidos e read_only: true.
Tente uma inserção real na réplica:
psql \
  "service=orders-reader" \
  --set=ON_ERROR_STOP=1 \
  --command "INSERT INTO orders (order_id, customer, total) VALUES (105, 'Lena', 9.00);"
Espere um erro indicando que INSERT não pode executar em uma transação somente leitura. O modo de recuperação rejeita a gravação mesmo para a identidade mestre. Confirme que o pedido tentado não existe em nenhum mecanismo:
psql \
  "service=orders-db" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
psql \
  "service=orders-reader" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
Espere encontrar 0 em cada um. Gravações pertencem ao primário; consultas podem usar a réplica se seus requisitos de consistência permitirem.
Remova a réplica e o primário
Nesta etapa, você removerá as duas instâncias de exercício.
Exclua primeiro a réplica e depois a origem:
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-reader \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-reader
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-db \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-db
aws rds \
  describe-db-instances \
  --query 'DBInstances[].DBInstanceIdentifier'
Espere encontrar [] e nenhum banco no AWS View. Preserve a aplicação e os recursos de rede preparados.
Resumo
Você criou uma réplica PostgreSQL e verificou seu modo real de recuperação em espera. Separou os endpoints, observou uma nova gravação do primário alcançar a réplica e confirmou a rejeição de gravações diretas. Por fim, removeu ambas as instâncias.
Uma réplica apoia padrões de leitura; sua finalidade e comportamento diferem do servidor em espera de uma implantação padrão de instância DB Multi-AZ. O desafio final aplica as habilidades de conexão e diagnóstico aprendidas.


