Introdução
A loja guarda vendas por mês. September já está catalogado; o novo arquivo October está localmente. Envie ao prefixo S3 mensal, registre a partição Glue e consulte o novo mês e ambos os meses com Athena.
Conclua Query S3 Data with Athena. O ambiente independente fornece sales particionada, September e sua partição, novo CSV local e identidade AWS configurada. Conta pessoal e recursos anteriores não são necessários. Use comandos comuns S3/Glue/Athena no Terminal e compare arquivos, partições e resultados reais no AWS View.
Relação com a certificação
| Certificação | Tarefa do exame | Prática |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Explicar como os metadados Glue tornam dados S3 particionados disponíveis para Athena. |
Adicionar o novo arquivo mensal
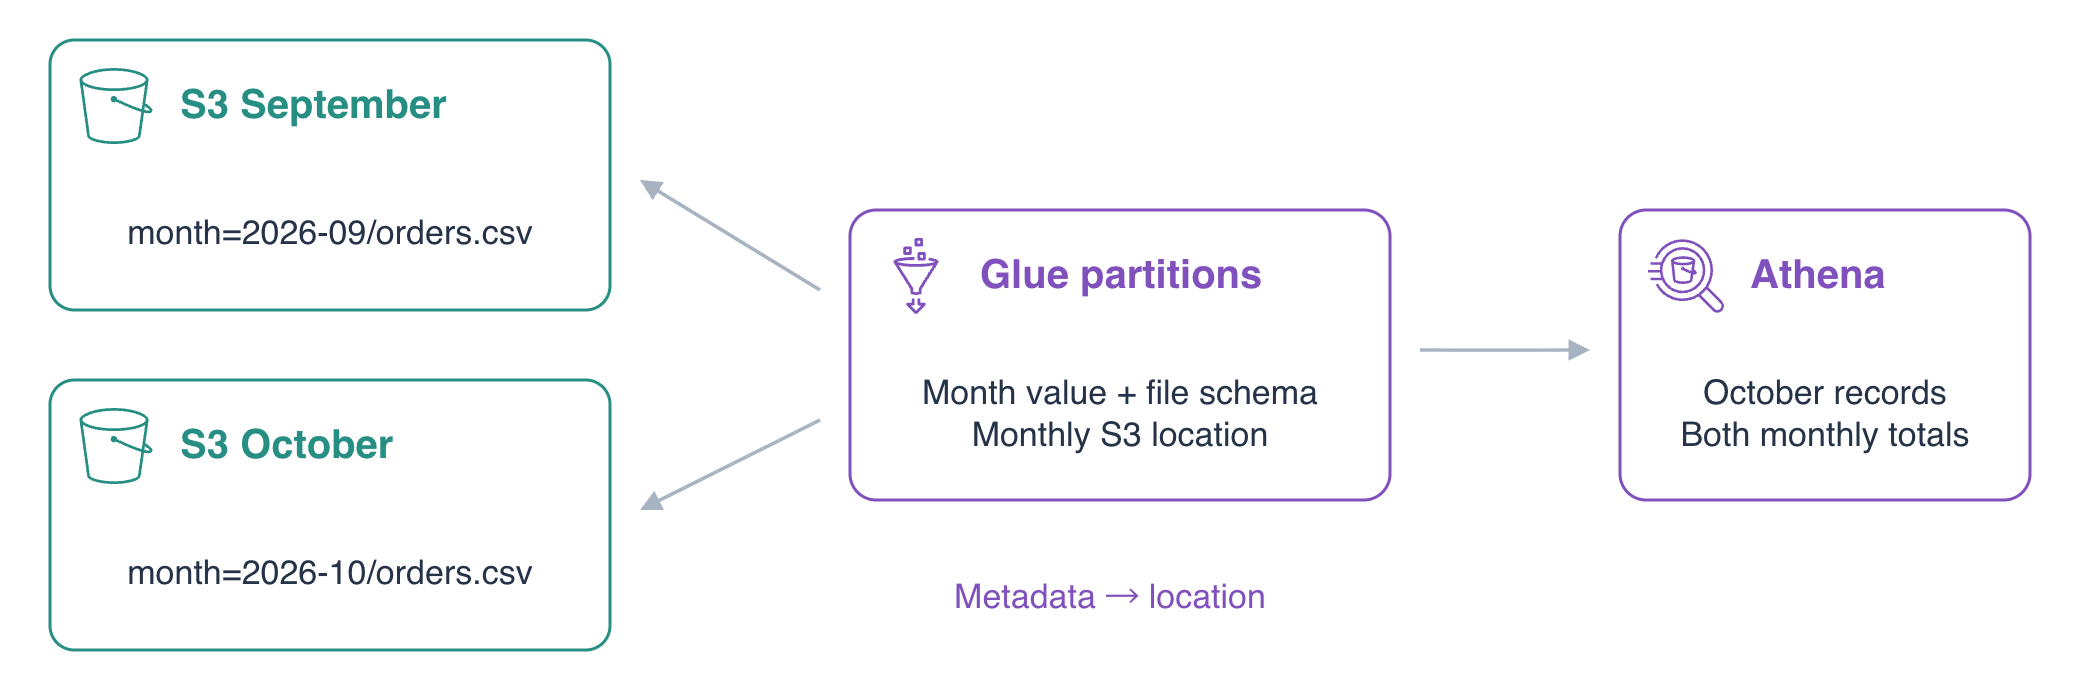
Nesta etapa, envie October sem mudar September. Uma partição agrupa por chave, como mês. sales/month=2026-09/ contém September; sales/month=2026-10/ receberá October. key=value mostra o grupo, mas enviar não registra automaticamente o catálogo.
Entre no projeto e confira a identidade:
cd /home/labex/project
aws sts \
  get-caller-identity
O ARN termina em labex-an03-operator. jq -r extrai texto JSON e $(...) salva a saída em variáveis:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive inclui prefixos aninhados:
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
Deve aparecer sales/month=2026-09/orders.csv. September contém 1000, 2000 e 500 centavos, total 3500. Preserve esse arquivo e reference/notes.txt. Confira October:
cat october.csv
O01/east/700, O02/west/900 e O03/east/400 são três pedidos novos, total 2000, com as mesmas três colunas. Envie ao próprio prefixo:
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
Leia o objeto real de volta:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
O - final imprime o conteúdo. AWS View mostra dois arquivos S3, mas apenas September no Glue. Chegada e registro são diferentes.
Registrar October no catálogo
Nesta etapa, demonstre que enviar não basta e adicione metadados. A definição associa valor da chave, local S3 e esquema. month é uma chave de partição string. O CSV contém apenas order_id, region, total_cents; o month da consulta vem da definição.
Confira a chave:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
É month, tipo string. Consulte antes do registro. COUNT(*) conta registros correspondentes; o delimitador heredoc entre aspas preserva SQL:
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
Envie com banco e prefixo preparados e mostre o ID:
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
Repita para QUEUED ou RUNNING, continue em SUCCEEDED e leia Reason em falhas:
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Leia o resultado:
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
A contagem é 0 apesar do arquivo S3. Esta tabela lê locais registrados; o nome do diretório não cria metadados.
Reutilize o descritor para manter colunas e formato CSV. > escreve JSON em arquivo:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg passa o local real como string; .Location = $location substitui pelo prefixo October. Values fornece o valor da única chave:
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
Inspecione o JSON comum:
cat october-partition.json
Confirme 2026-10 em Values, colunas correspondentes e final /sales/month=2026-10/. As chaves de ${SALES_LOCATION} separam variável e sufixo. file:// lê o JSON local para registrar:
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
Liste as duas partições:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Cada mês aponta ao próprio prefixo e AWS View mostra as duas associações. O registro muda metadados sem copiar nem reescrever CSV.
Consultar o novo mês e ambos os totais
Nesta etapa, prove que October pode ser consultado e September permanece correto. WHERE na chave escolhe o mês. Verificamos registros, não custos de leitura nem velocidade de produção.
Escreva a consulta October:
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
Envie uma nova execução. Registrar não reescreve o resultado zero anterior:
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
Confira estado, repita se necessário, continue após sucesso e examine falhas:
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Leia as linhas:
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Após o cabeçalho estão O01/700, O02/900, O03/400. O mesmo arquivo antes invisível agora fornece três registros.
SUM soma centavos, COUNT(*) conta pedidos em cada grupo GROUP BY month:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Envie e exiba o ID separado:
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
Confirme sucesso, repita enquanto pendente e confira a razão de falhas:
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Leia os grupos:
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September tem 3500 centavos/3 pedidos; October 2000/3. O primeiro mês não mudou. Compare locais Glue, SQL e linhas no AWS View.
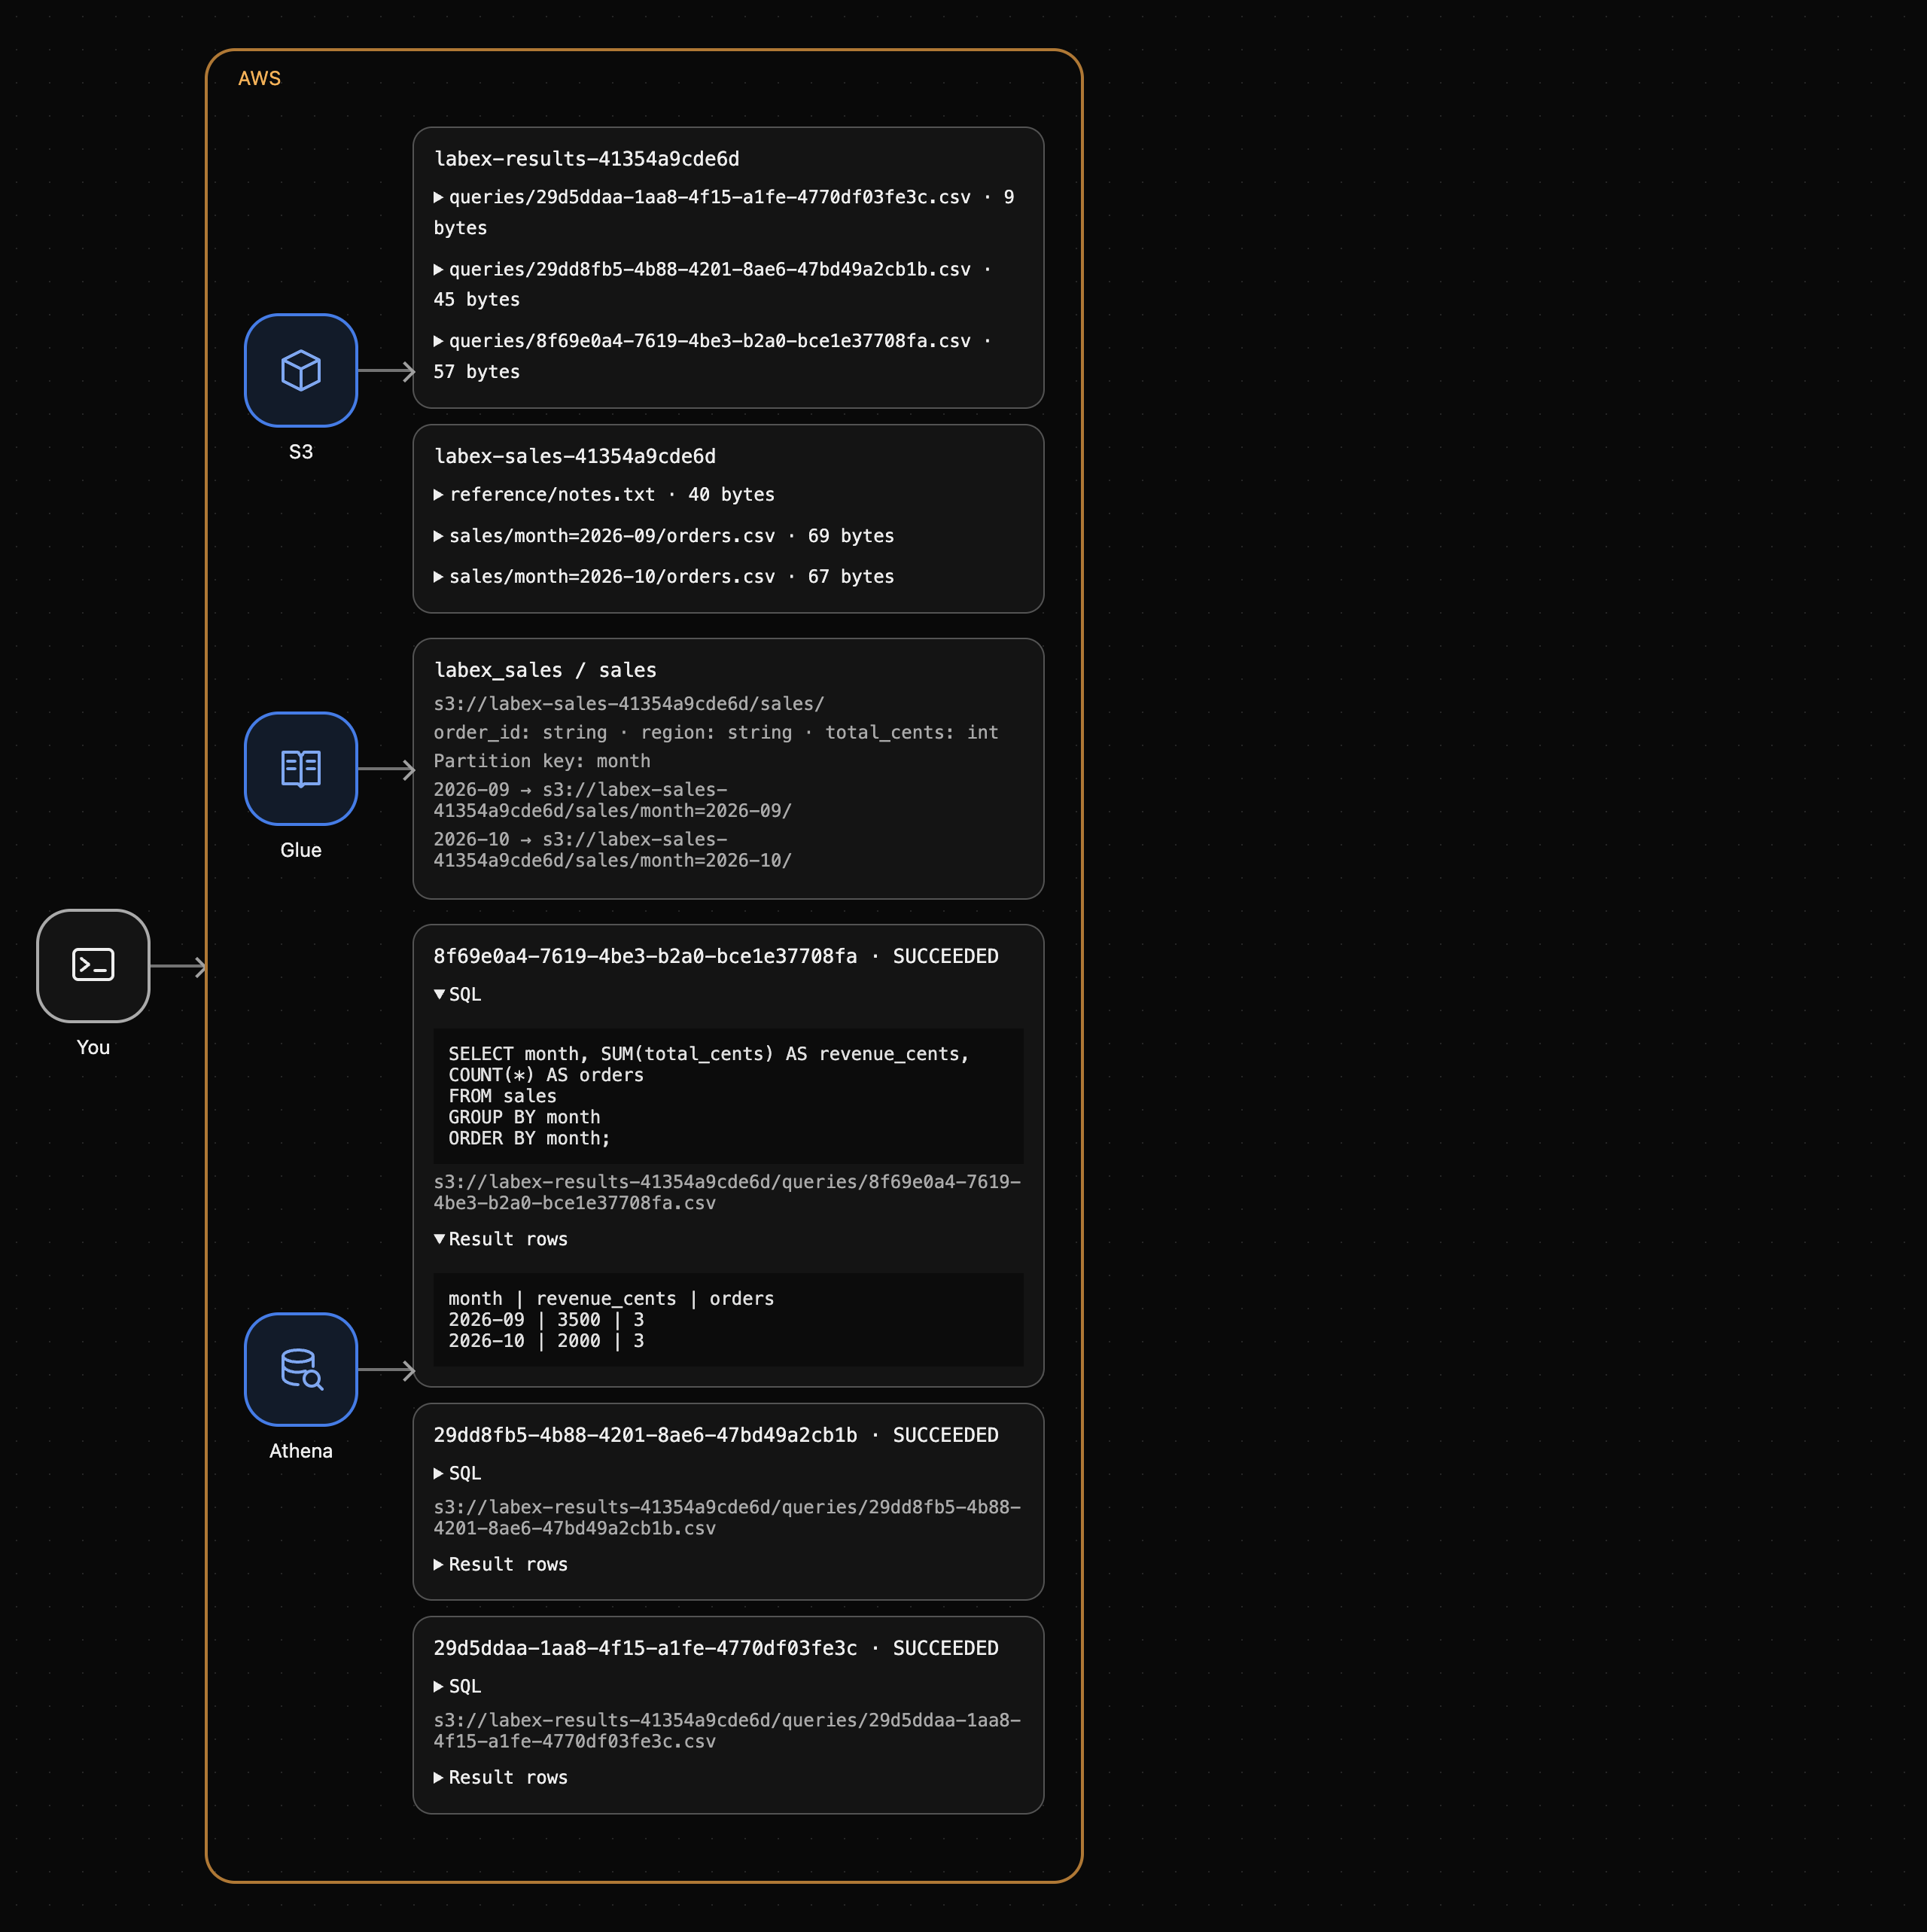
O zero anterior permanece como resultado separado do estado anterior do catálogo.
Resumo
Você enviou um CSV mensal, observou ausência de linhas sem registro, registrou local e esquema Glue e verificou October e ambos os totais. Arquivos e metadados são separados: esta tabela precisa do registro adequado do novo prefixo. O próximo laboratório transforma resultados reais em um arquivo de resumo reutilizável.
Para aprofundar o tema, consulte a documentação da AWS: Chaves, locais e registro de partições.