



Introdução
Sua aplicação tem dois servidores atrás de um Application Load Balancer. Um servidor pode falhar mesmo com sua instância EC2 em execução. Você configurará verificações de saúde, provocará uma falha real e confirmará que o servidor saudável continua atendendo. Depois recuperará a aplicação e removerá os recursos de balanceamento.
Você deve conhecer listeners ALB, grupos de destino e SSH em EC2. Este ambiente novo fornece a rede, dois servidores ativos, seus registros e um listener ALB. Ele é independente do laboratório anterior, com AWS CLI e arquivos de conexão preparados.
Relação com certificações
Este laboratório oferece prática introdutória para estes tópicos de exame.
- Solutions Architect – Associate (SAA-C03) · Tarefa 2.2: Entender como saúde da aplicação e balanceamento apoiam a disponibilidade durante uma falha de servidor.
- CloudOps Engineer – Associate (SOA-C03) · Tarefa 2.2: Configurar verificações ELB e diagnosticar um destino não saudável.
Configure as verificações de saúde
Você inspecionará o serviço fornecido e configurará como ALB verifica a prontidão da aplicação.
Entre no diretório preparado e carregue as variáveis de rede:
cd /home/labex/project
source launch.env
Localize o balanceador e o grupo fornecidos pelo nome. Salve seus ARNs para os próximos comandos e o DNS para HTTP:
LB_ARN=$(aws elbv2 \
  describe-load-balancers \
  --names application-alb \
  --query 'LoadBalancers[0].LoadBalancerArn' \
  --output text)

TG_ARN=$(aws elbv2 \
  describe-target-groups \
  --names application-targets \
  --query 'TargetGroups[0].TargetGroupArn' \
  --output text)

LB_DNS=$(aws elbv2 \
  describe-load-balancers \
  --load-balancer-arns "$LB_ARN" \
  --query 'LoadBalancers[0].DNSName' \
  --output text)
Uma verificação de saúde consulta cada destino independentemente das solicitações dos clientes. O caminho deve indicar se a aplicação pode servir tráfego. Inspecione as configurações atuais:
aws elbv2 \
  describe-target-groups \
  --target-group-arns "$TG_ARN" \
  --query 'TargetGroups[].{Path:HealthCheckPath,Interval:HealthCheckIntervalSeconds,Timeout:HealthCheckTimeoutSeconds,Healthy:HealthyThresholdCount,Unhealthy:UnhealthyThresholdCount,Matcher:Matcher}'
O grupo fornecido consulta /health a cada 30 segundos. Neste exercício pequeno, use intervalo de cinco segundos e timeout de dois. Exija duas falhas consecutivas para excluir um destino e dois sucessos para readmiti-lo. O matcher aceita HTTP 200 como sucesso:
aws elbv2 \
  modify-target-group \
  --target-group-arn "$TG_ARN" \
  --health-check-protocol HTTP \
  --health-check-path /health \
  --health-check-interval-seconds 5 \
  --health-check-timeout-seconds 2 \
  --healthy-threshold-count 2 \
  --unhealthy-threshold-count 2 \
  --matcher HttpCode=200 \
  --query 'TargetGroups[].{Path:HealthCheckPath,Interval:HealthCheckIntervalSeconds,Healthy:HealthyThresholdCount,Unhealthy:UnhealthyThresholdCount}'
O intervalo determina a frequência e o timeout limita cada espera. Limiares evitam reagir a uma falha breve. Em produção, os valores devem refletir o início e as falhas da aplicação; aqui são curtos para facilitar a observação.
Espere os dois destinos ficarem saudáveis e inspecione os estados reais:
aws elbv2 \
  wait target-in-service \
  --target-group-arn "$TG_ARN"

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Port:Target.Port,Health:TargetHealth.State}' \
  --output table
Abra AWS View. Confirme dois destinos healthy e clique em Send request para obter HTTP 200 real. Os estados e a resposta estabelecem a condição inicial.
Observe uma falha real da aplicação
Você fará o endpoint de saúde de app-a falhar sem parar sua instância EC2.
Obtenha os IDs pelas tags de nome e o endereço para SSH:
APP_A=$(aws ec2 \
  describe-instances \
  --filters Name=tag:Name,Values=app-a \
  --query 'Reservations[0].Instances[0].InstanceId' \
  --output text)

APP_B=$(aws ec2 \
  describe-instances \
  --filters Name=tag:Name,Values=app-b \
  --query 'Reservations[0].Instances[0].InstanceId' \
  --output text)

APP_A_IP=$(aws ec2 \
  describe-instances \
  --instance-ids "$APP_A" \
  --query 'Reservations[0].Instances[0].PublicIpAddress' \
  --output text)
A aplicação lê /etc/report-app/config.json em cada solicitação. healthy controla se /health retorna 200 ou 503. Use SSH com a chave e os ajustes fornecidos. jq muda só esse campo; um arquivo temporário evita sobrescrever enquanto lê, e install substitui com permissões de leitura:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'sudo jq ".healthy = false" /etc/report-app/config.json > /tmp/report-config.json && sudo install -m 644 /tmp/report-config.json /etc/report-app/config.json'
Verifique a aplicação de dentro do servidor. -o /dev/null descarta o corpo e -w exibe o status HTTP:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/health'
Espere 503. É uma falha da aplicação, não uma parada EC2. Aguarde duas verificações e inspecione a causa:
sleep 12

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Health:TargetHealth.State,Reason:TargetHealth.Reason}' \
  --output table
APP_A deve estar unhealthy com Target.ResponseCodeMismatch, pois 503 não corresponde a 200. APP_B permanece healthy. As verificações são assíncronas; se a transição estiver pendente, espere brevemente e repita a consulta.
Confirme que as instâncias EC2 continuam em execução:
aws ec2 \
  describe-instances \
  --instance-ids "$APP_A" "$APP_B" \
  --query 'Reservations[].Instances[].{Instance:InstanceId,State:State.Name}' \
  --output table
Envie seis solicitações separadas pelo ALB:
for request in 1 2 3 4 5 6; do
  curl --config client.conf -sS "http://$LB_DNS/health"
  echo
done
Cada resposta deve identificar APP_B. Em AWS View, confirme um destino não saudável e outro saudável. Clique várias vezes em Send request; as respostas bem-sucedidas devem vir do servidor saudável. ALB exclui o destino com falha enquanto houver um saudável.
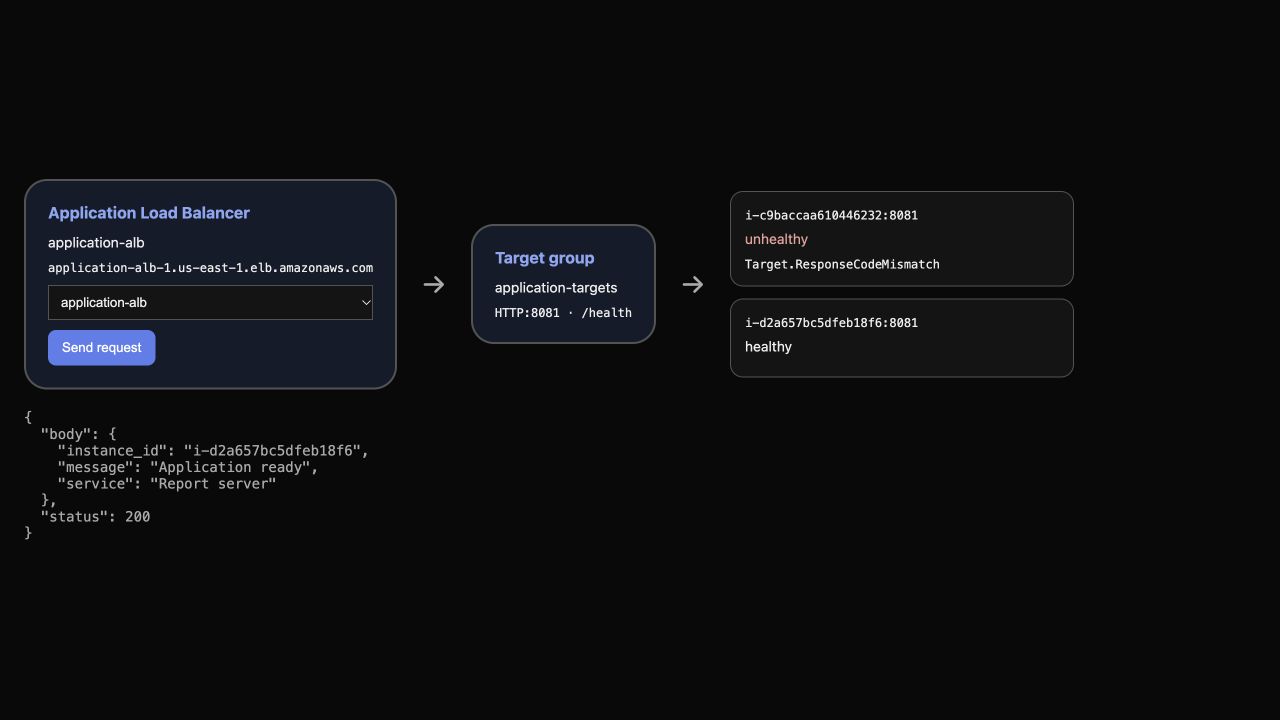
O exemplo mostra HTTP 200 real do destino saudável enquanto o outro informa Target.ResponseCodeMismatch. Seus IDs diferem; compare a resposta com seu próprio destino saudável.
Se todos os destinos falharem, ALB pode usar fail open e encaminhar aos não saudáveis. Manter app-b saudável é essencial; um grupo totalmente não saudável não prova que ALB deixa de encaminhar todas as solicitações.
Recupere e readmita o destino
Você recuperará app-a e observará seu retorno ao tráfego após verificações bem-sucedidas.
Restaure somente healthy com a mesma substituição segura do arquivo:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'sudo jq ".healthy = true" /etc/report-app/config.json > /tmp/report-config.json && sudo install -m 644 /tmp/report-config.json /etc/report-app/config.json'
Confirme que o endpoint direto agora retorna 200:
ssh -F ssh_config "ubuntu@$APP_A_IP" \
  'curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8081/health'
A aplicação se recuperou, mas ALB ainda precisa observar os sucessos consecutivos configurados. Espere o estado saudável e inspecione os dois destinos:
aws elbv2 \
  wait target-in-service \
  --target-group-arn "$TG_ARN"

aws elbv2 \
  describe-target-health \
  --target-group-arn "$TG_ARN" \
  --query 'TargetHealthDescriptions[].{Instance:Target.Id,Health:TargetHealth.State}' \
  --output table
Ambos devem estar healthy. Envie seis solicitações novamente:
for request in 1 2 3 4 5 6; do
  curl --config client.conf -sS "http://$LB_DNS/health"
  echo
done
Procure os dois IDs. Em AWS View, confirme os dois cartões saudáveis e use Send request para observar ambos os servidores. Você reparou a aplicação e permitiu verificações corretas; não substituiu nem cancelou o registro da instância.
Remova os recursos de balanceamento
Você removerá a configuração fornecida e preservará os servidores recuperados e a rede.
Obtenha o ARN do listener, exclua primeiro o listener e depois ALB e grupo:
LISTENER_ARN=$(aws elbv2 \
  describe-listeners \
  --load-balancer-arn "$LB_ARN" \
  --query 'Listeners[0].ListenerArn' \
  --output text)

aws elbv2 \
  delete-listener \
  --listener-arn "$LISTENER_ARN"

aws elbv2 \
  delete-load-balancer \
  --load-balancer-arn "$LB_ARN"

aws elbv2 \
  delete-target-group \
  --target-group-arn "$TG_ARN"
Confirme que ambas as listas estão vazias:
aws elbv2 \
  describe-load-balancers \
  --query 'LoadBalancers[].LoadBalancerName'

aws elbv2 \
  describe-target-groups \
  --query 'TargetGroups[].TargetGroupName'
Espere [] nas duas consultas e áreas de balanceamento vazias em AWS View. Preserve os servidores EC2 e a rede fornecidos.
Resumo
Você configurou verificações ALB, causou uma falha real e a distinguiu de uma parada EC2. Observou tráfego no servidor saudável, recuperou a aplicação e confirmou respostas dos dois servidores. Por fim, removeu o balanceamento e preservou os servidores e a rede.
O próximo laboratório usa um grupo Auto Scaling para substituir instâncias com falha em vez de reparar manualmente um servidor.


