Introdução
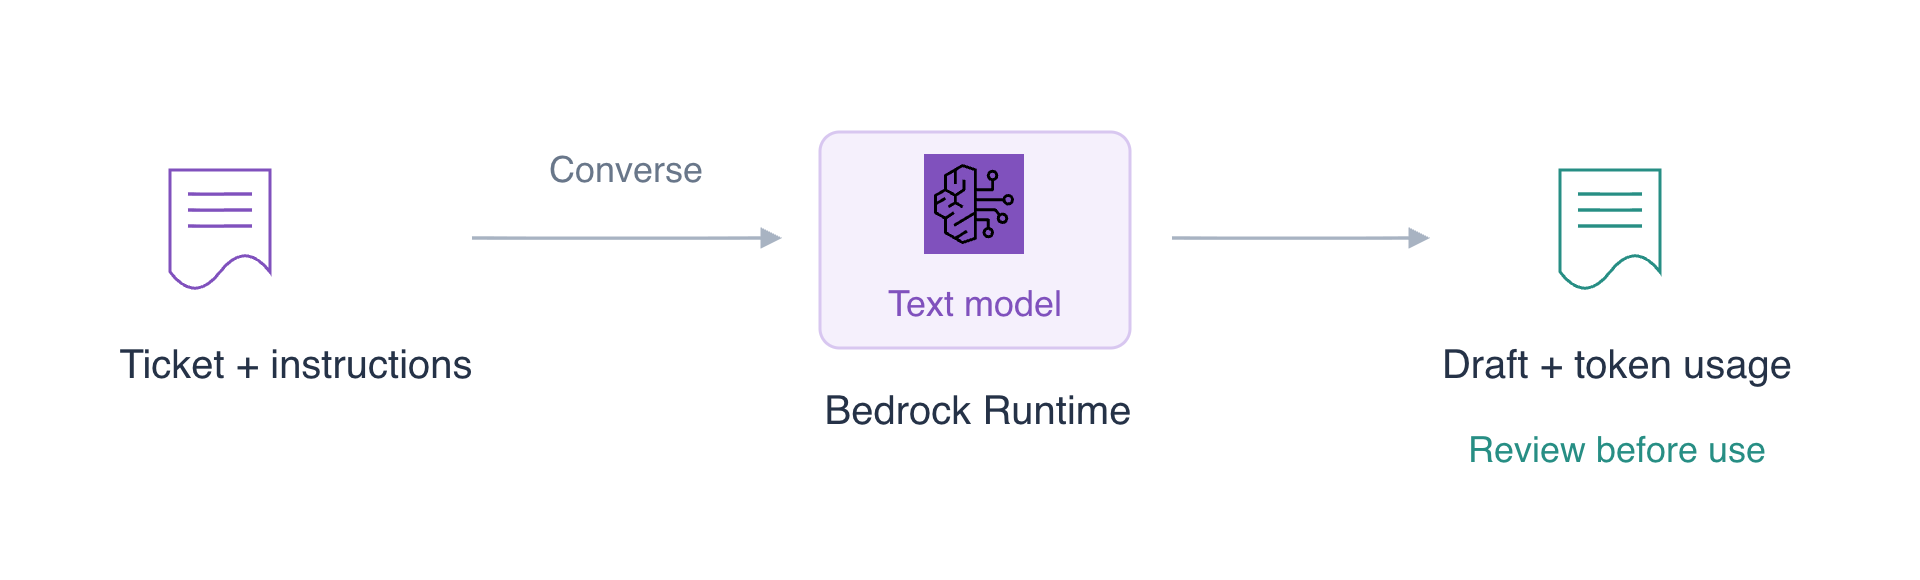
Uma equipe de suporte precisa de um rascunho de resposta para uma cobrança duplicada relatada. Você enviará o chamado ao Bedrock Runtime, aperfeiçoará as instruções de redação, examinará a resposta gerada e comparará o uso de tokens com um limite de saída. A AWS CLI já está configurada na sua nova VM do LabEx; use apenas o chamado sintético fornecido aqui.
Você deve saber executar comandos e ler arquivos de texto. A tarefa consiste em gerar e revisar um rascunho, sem enviar mensagens ao cliente nem alterar registros de cobrança.
Relevância para a certificação
| Certificação | Tarefa do exame | Prática |
|---|---|---|
| AI Practitioner (AIF-C01) | Tarefas 3.1, 3.2 | Ajustar o tamanho da saída, fornecer instruções explícitas de redação e revisar o texto gerado. |
Redigir uma resposta de suporte
Nesta etapa, você selecionará um modelo de texto disponível e enviará um chamado de suporte ao Bedrock Runtime.
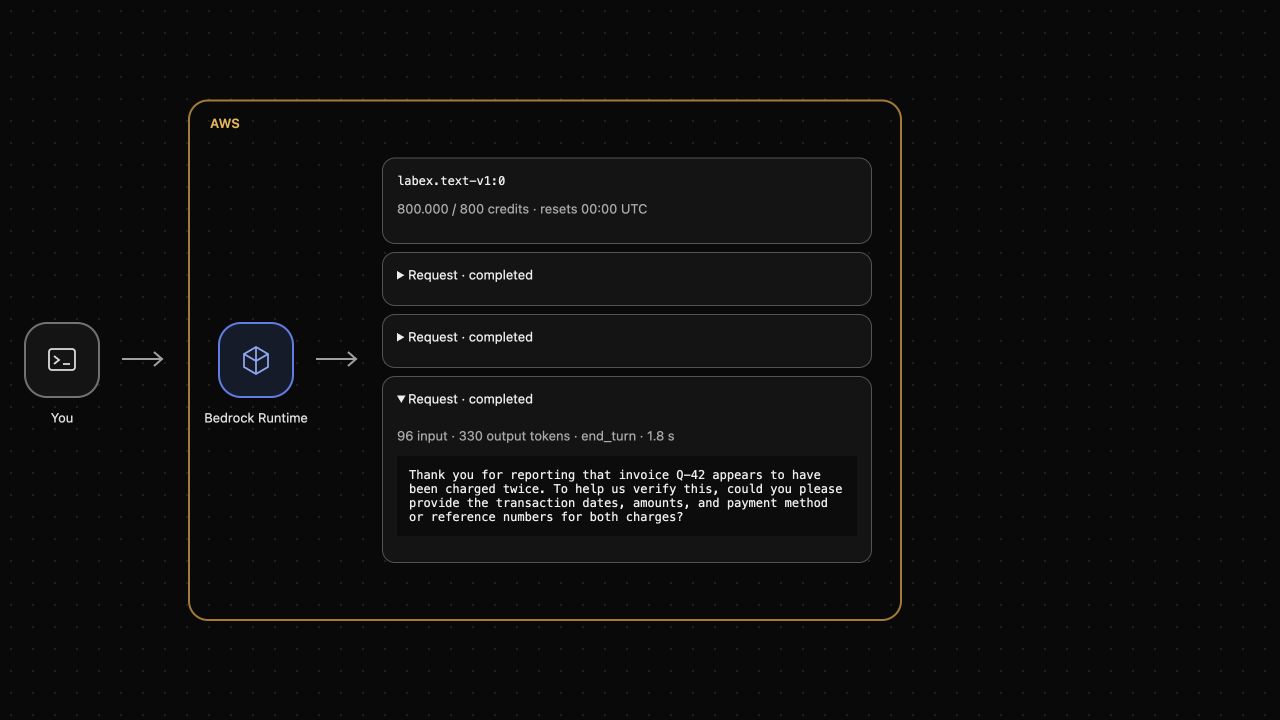
O painel superior AWS View mostra o modelo e os resultados reais das solicitações. No Terminal inferior, você digita os comandos. Antes de enviar uma solicitação, o painel não mostra respostas. Depois, ele mostrará uma solicitação pendente e, em seguida, a resposta, o uso e a cota restante.
O Bedrock oferece acesso a modelos de base: modelos capazes de gerar texto para muitas tarefas. Um identificador seleciona o modelo; Converse é um formato comum de solicitação para modelos de conversação compatíveis. Aqui, você trabalhará com o modelo de texto disponível neste ambiente.
Comece no diretório do exercício. cd altera o diretório atual do Terminal:
cd /home/labex/project
Liste os modelos que produzem texto. --by-output-modality TEXT filtra o catálogo. --query seleciona o identificador e o nome legível, e --output table exibe esses campos em uma tabela:
aws bedrock list-foundation-models \
  --by-output-modality TEXT \
  --query 'modelSummaries[].[modelId,modelName]' \
  --output table
A tabela inclui labex.text-v1:0, o modelo que você usará a seguir. Uma entrada do catálogo descreve um modelo; ela não significa que uma solicitação de inferência já foi executada.
Uma solicitação Converse contém um modelId, uma lista de messages e configurações opcionais de inferência. Cada mensagem tem um role e blocos de conteúdo. Uma mensagem user contém a pergunta ou tarefa, e um bloco de texto usa o campo text. maxTokens limita a saída gerada; temperature controla a variação da amostragem. Uma temperatura baixa pode reduzir a variação, mas não garante respostas corretas ou idênticas.
Crie a solicitação em JSON. cat > request.json grava um arquivo; o marcador <<'EOF' inicia a entrada literal de várias linhas e o EOF final a encerra. Isso substitui apenas o arquivo do exercício indicado:
cat > request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. Draft an English support reply in two sentences."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Envie a solicitação com bedrock-runtime converse. --cli-input-json file://request.json lê os campos da solicitação desse arquivo. O trecho final > reply.json salva a resposta JSON em vez de imprimi-la:
aws bedrock-runtime converse \
  --cli-input-json file://request.json \
  > reply.json
Aguarde até que o prompt do Terminal retorne. A geração de texto costuma levar alguns segundos. Não execute outra solicitação enquanto a primeira estiver pendente.
Leia a resposta:
cat reply.json
Procure output.message.role: "assistant" e um bloco de conteúdo text não vazio. usage informa os tokens processados, e metrics.latencyMs informa o tempo de resposta em milissegundos. Acima do Terminal, expanda a solicitação concluída no AWS View e compare a resposta com o arquivo.
Leia o rascunho com atenção. Ele afirmou que uma investigação começou, que um reembolso foi emitido ou que uma cobrança foi confirmada? O chamado não fornece nenhum desses fatos. Uma resposta fluente pode conter detalhes inventados; você tornará as instruções mais precisas a seguir. Não trate uma frase gerada pelo modelo como uma ação de cobrança concluída.
Aperfeiçoar as instruções de redação
Nesta etapa, você adicionará instruções explícitas e gerará um novo rascunho com os mesmos fatos relatados.
O campo system fornece instruções sobre a tarefa e o estilo. Mantenha o chamado na mensagem do usuário e coloque as restrições de redação na mensagem do sistema. Instruções mais específicas podem reduzir detalhes indesejados, mas você ainda precisa revisar a resposta.
Crie uma solicitação separada para preservar o rascunho original para comparação:
cat > revised-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Gere o rascunho revisado:
aws bedrock-runtime converse \
  --cli-input-json file://revised-request.json \
  > revised-reply.json
Examine a resposta salva com o formatador JSON padrão do Python, que verifica se o arquivo contém JSON válido e o formata para leitura:
python3 -m json.tool revised-reply.json
No AWS View superior, expanda a nova solicitação concluída. Compare os dois rascunhos com o chamado fornecido. A solicitação revisada deve deixar suas expectativas claras; avaliar se esta resposta específica as segue ainda exige julgamento humano. Se ela inventar uma ação, não use essa frase em uma resposta ao cliente.
As solicitações são independentes. Reutilizar o mesmo modelo não envia automaticamente a resposta anterior como histórico da conversa. Uma conversa futura precisaria incluir explicitamente as mensagens anteriores do usuário e do assistente em messages.
Examinar o uso de tokens e os limites de saída
Nesta etapa, você enviará a mesma tarefa de redação com um limite de saída menor e examinará o uso real.
Um token é uma unidade de texto processada pelo modelo; não corresponde necessariamente a uma palavra. Os tokens de entrada incluem a tarefa, as instruções do sistema e qualquer histórico fornecido. Os tokens de saída incluem os tokens gerados informados pelo modelo, que podem incluir raciocínio interno. O totalTokens retornado é a soma dos tokens de entrada e de saída.
maxTokens é um teto, não uma solicitação para produzir exatamente essa quantidade de tokens. O modelo pode terminar antes. Crie a solicitação limitada com um teto de 384 tokens em vez de 512:
cat > bounded-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 384, "temperature": 0}
}
EOF
Envie-a e salve a resposta:
aws bedrock-runtime converse \
  --cli-input-json file://bounded-request.json \
  > bounded-reply.json
Examine o resultado:
python3 -m json.tool bounded-reply.json
Compare usage.outputTokens com o limite de 384 tokens. stopReason: "end_turn" significa que o modelo terminou normalmente; "max_tokens" significa que ele atingiu o limite de saída, portanto o texto pode estar incompleto. Nunca presuma que uma resposta parcial é um documento concluído.
O AWS View superior mostra o mesmo uso e os créditos restantes. Os créditos refletem o consumo de entrada e saída específico do modelo; a contagem de tokens, sozinha, não representa um preço universal entre modelos. Uma solicitação repetida pode usar um resultado do modelo armazenado em cache, de modo que pode haver uso de tokens sem mudança nos créditos restantes. Um limite ajuda a controlar uma solicitação, mas um limite menor não garante que esta resposta curta específica consuma menos tokens do que todas as respostas anteriores.
Se uma solicitação falhar ou seu uso for incerto, examine o erro antes de tentar novamente. Uma solicitação incerta pode manter a cota reservada, e outra solicitação pode consumir mais. O tratamento desses casos na aplicação será ensinado mais adiante no curso.
Limpar os arquivos do exercício
Nesta etapa, você removerá os arquivos locais de solicitação e resposta após revisar os rascunhos.
Converse envia uma solicitação de inferência; ele não cria um servidor ou banco de dados que você precise excluir. Os seis arquivos JSON são artefatos locais do exercício. Removê-los não desfaz o uso de tokens nem devolve os créditos já consumidos.
rm remove os arquivos indicados. Use exatamente os nomes abaixo e preserve os demais arquivos do projeto:
rm request.json reply.json revised-request.json revised-reply.json bounded-request.json bounded-reply.json
Liste as entradas visíveis restantes no ambiente de trabalho:
ls
Os seis arquivos do exercício devem estar ausentes. O AWS View mantém os resultados reais das solicitações concluídas nesta VM, incluindo o uso. Portanto, excluir um arquivo local não transforma uma solicitação malsucedida em bem-sucedida nem apaga seu consumo.
Resumo
Você enviou solicitações reais de texto com Bedrock Converse, aperfeiçoou as instruções do sistema, examinou as respostas geradas e o uso de tokens, limitou o tamanho da saída e removeu os arquivos locais do exercício. Também distinguiu um rascunho plausível de um fato de negócio verificado: uma resposta precisa ser revisada antes de ser usada.
Para aprofundar o tema, consulte a documentação da AWS: Mensagens, instruções e configurações de inferência do Converse; Conteúdo da resposta, motivos de parada e uso do Converse.