Introdução
A loja precisa de um CSV mensal compartilhável. Calcule com Athena, obtenha a saída real S3, corrija uma venda e gere novo resumo. Compare as saídas com a entrada no momento da execução.
Conclua Query Partitioned Sales Data. O ambiente independente oferece dois arquivos S3, partições Glue registradas, identidade AWS e September corrigido localmente. Conta pessoal e recursos anteriores não são necessários. Use CLI oficial no Terminal e confira arquivos, catálogo e resultados no AWS View.
Relação com a certificação
| Certificação | Tarefa do exame | Prática |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Analisar S3 com Athena e Glue e recuperar resultados calculados. |
Calcular o resumo mensal
Nesta etapa, calcule dos arquivos atuais. Glue registra esquema e locais; Athena lê e agrupa por mês. Cada execução tem ID e arquivo próprios.
Entre no projeto e confira a identidade:
cd /home/labex/project
aws sts \
  get-caller-identity
O ARN termina em labex-an04-operator. jq -r extrai strings JSON e $(...) salva a saída em variáveis:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
Confira os locais registrados:
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Ambos os meses estão registrados. Somar centavos inteiros em total_cents evita arredondamento monetário. COUNT(*) conta pedidos, GROUP BY month agrupa, ORDER BY month facilita comparar. Heredoc entre aspas preserva SQL:
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Envie com banco e prefixo S3. file:// lê SQL local; --query e --output text CLI extraem o ID:
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
Repita para QUEUED/RUNNING, continue em SUCCEEDED e confira Reason em FAILED:
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
A projeção aninhada [*] preserva colunas por linha:
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
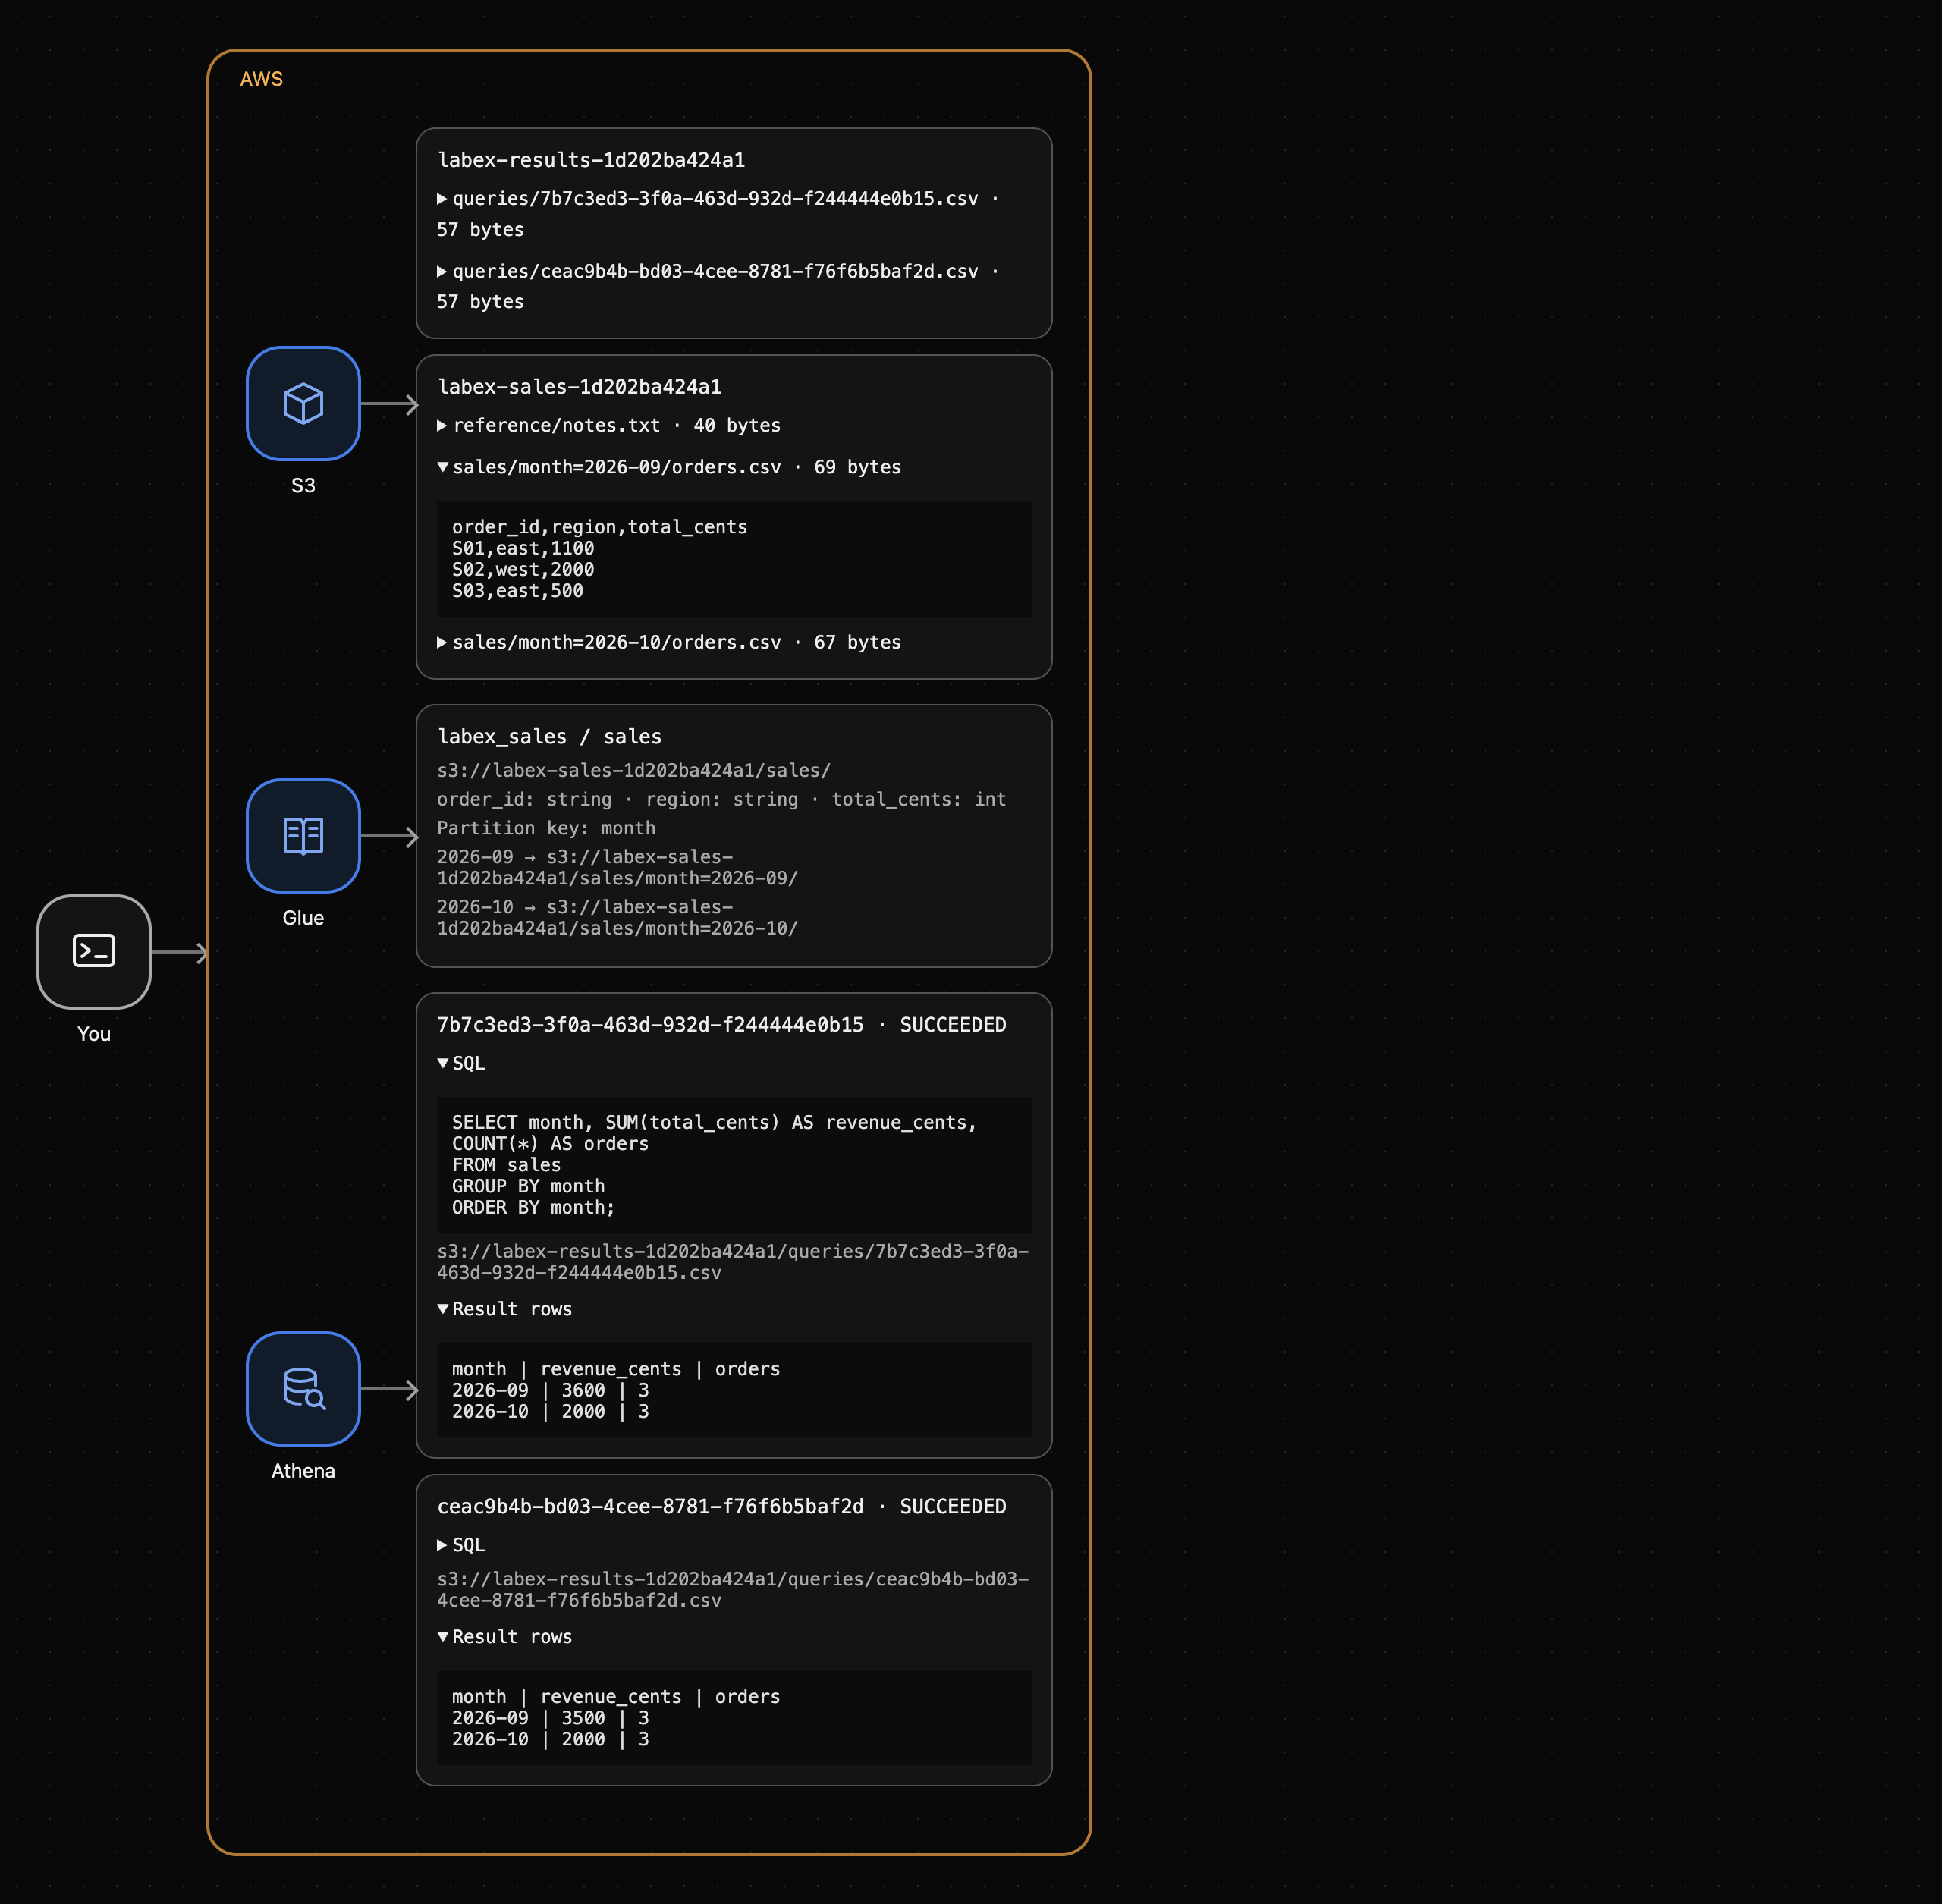
September tem 3500 centavos/3 pedidos, October 2000/3. Expanda SQL e linhas no AWS View e compare com os locais mensais.
Baixar o arquivo S3 real
Nesta etapa, obtenha o CSV desta execução. A API mostra linhas; os metadados fornecem o local S3 exato. Não adivinhe bucket nem ID.
Extraia e exiba a URI:
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
Termina em /queries/<your-execution-id>.csv; o ID liga arquivo e consulta. Baixe como summary.csv:
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
Inspecione o conteúdo:
cat summary.csv
Cabeçalho e dois registros:
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
Os valores correspondem à API. É um arquivo real baixado, não relatório escrito à mão. Preserve summary.csv e a saída S3 original para comparação.
Recalcular depois de corrigir a entrada
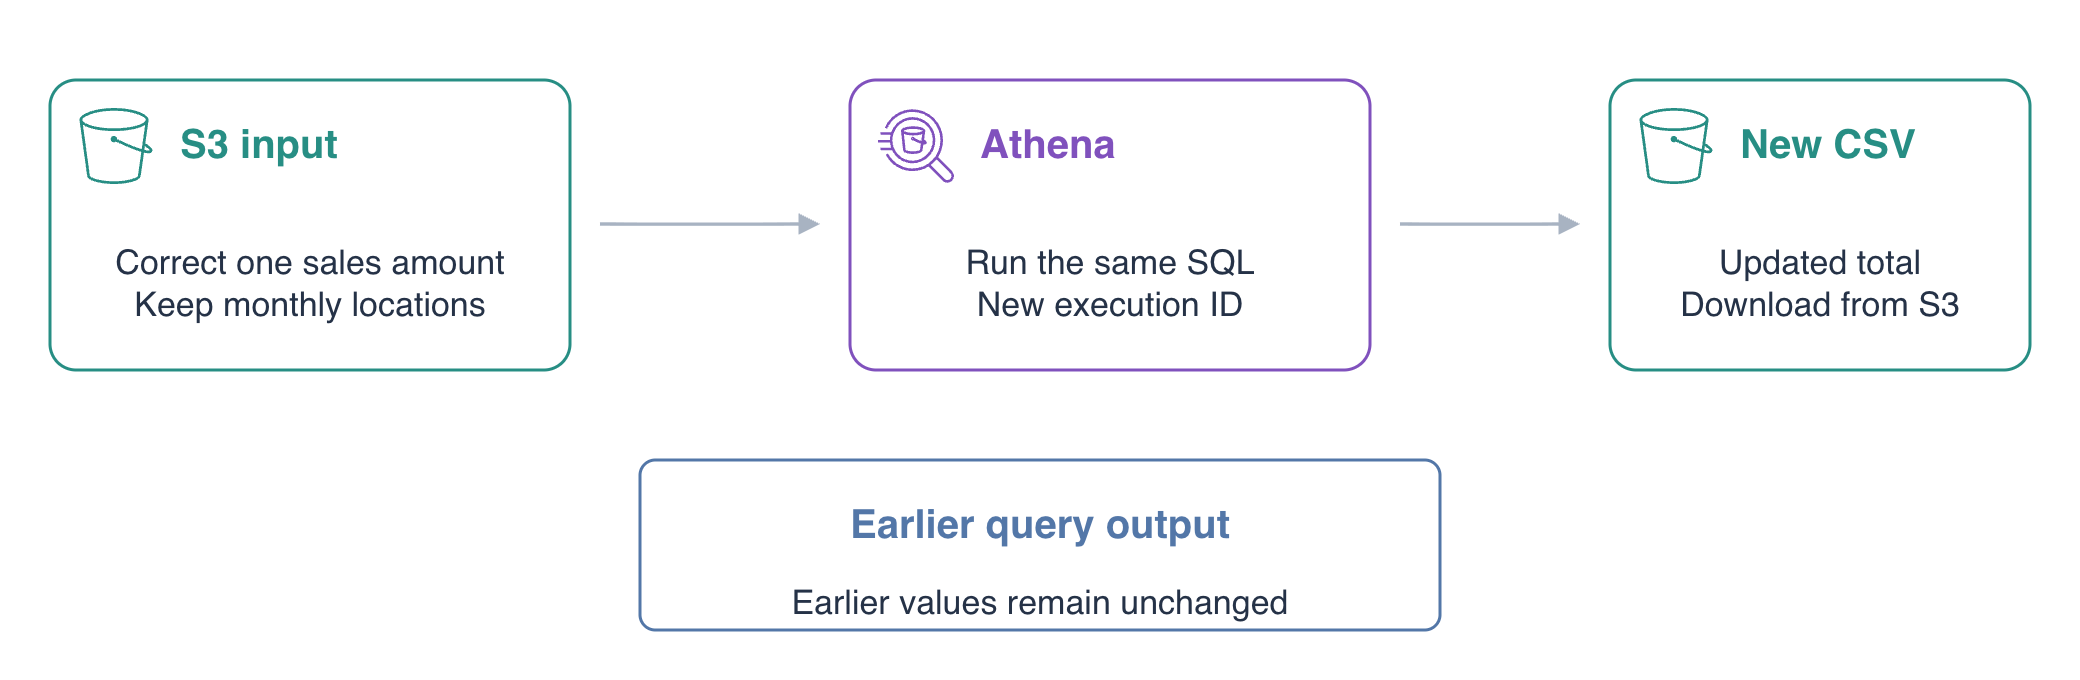
Nesta etapa, corrija um valor September e repita o SQL. O resultado antigo não se atualiza automaticamente; uma nova execução precisa ler a entrada atual.
Confira o arquivo corrigido:
cat september-revised.csv
S01 muda de 1000 para 1100 centavos; o restante fica igual, total 3600. Substitua o objeto existente, preservando October e reference/notes.txt:
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
Leia de volta para confirmar:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
O - final imprime o objeto. Local e esquema não mudaram, então Glue continua válido. Execute o mesmo SQL novamente:
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
Confirme sucesso, repita estados pendentes e confira falhas:
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Obtenha as linhas:
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September é 3600/3, October continua 2000/3. A entrada alterada mudou o cálculo.
Obtenha a saída própria da nova execução:
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
Baixe sem sobrescrever o resumo local original:
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
Confira o novo CSV:
cat summary-revised.csv
Compare com a saída original S3:
aws s3 \
  cp "$SUMMARY_OUTPUT" -
A anterior ainda tem September=3500. Dois IDs apontam a arquivos separados de entradas antiga e corrigida. AWS View mostra origem atual e ambos os resultados reais. Verifica correção, não custos nem desempenho de produção.
Resumo
Você calculou totais, baixou o CSV exato, corrigiu a origem e recalculou. September mudou de 3500 para 3600 centavos e October ficou 2000. Arquivos anteriores mantêm valores: execute o resumo novamente quando a entrada mudar.
Para aprofundar o tema, consulte a documentação da AWS: Localizar arquivos de saída por execução de consulta; Filtros, agrupamento e ordenação de SELECT.