Introdução
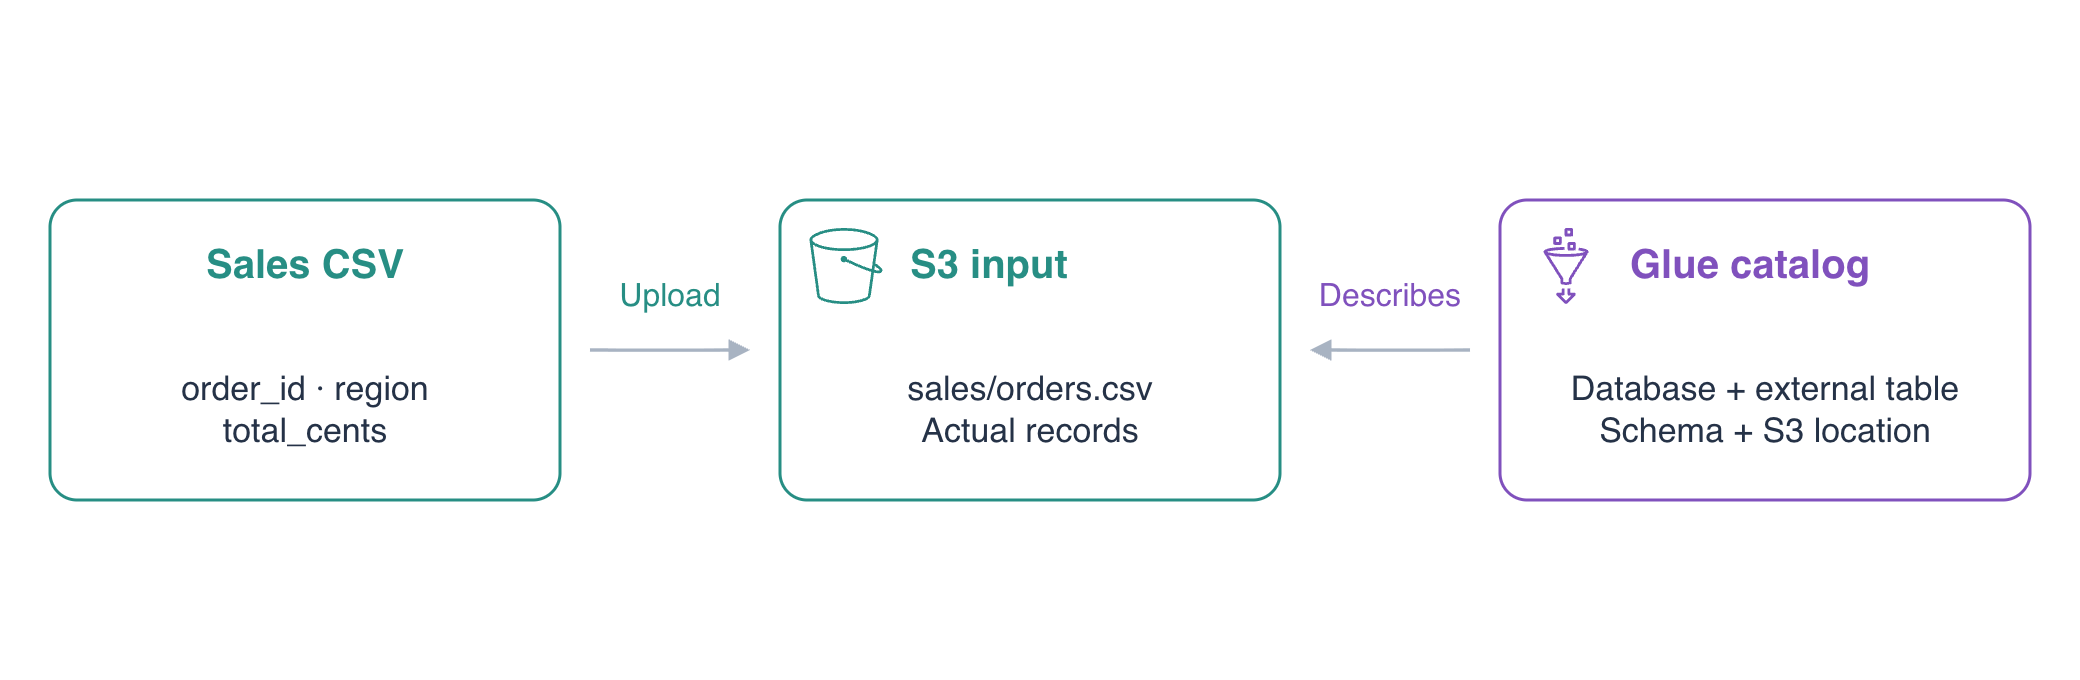
Uma pequena loja exporta vendas em CSV. Um analista precisa consultar os arquivos sem copiá-los para um servidor de banco de dados. Armazene o arquivo no Amazon S3 e descreva-o no AWS Glue Data Catalog, um diretório de metadados que informa aos serviços de consulta onde estão os dados e como lê-los.
Conclua AWS Foundations for Beginners, operações básicas do S3 e fundamentos de identidade IAM. Este ambiente independente fornece buckets vazios, CSV e uma identidade AWS CLI configurada. Não é necessária conta pessoal nem recursos de outro laboratório. Use Terminal e observe objetos e catálogo reais em AWS View. O catálogo descreve arquivos; não copia, transforma nem consulta seu conteúdo. Athena vem no próximo laboratório.
Relação com a certificação
| Certificação | Tarefa do exame | Prática |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Distinguir o papel do catálogo Glue na análise de arquivos do armazenamento de dados no S3. |
Enviar o arquivo de vendas
Nesta etapa, examine os dados fornecidos e envie-os ao S3. Um CSV representa um registro por linha, com campos separados por vírgulas. A primeira linha contém os nomes. Um esquema define nomes, ordem e tipos para interpretar cada registro corretamente.
Entre no projeto e confira a identidade configurada:
cd /home/labex/project
aws sts \
  get-caller-identity
O ARN termina em labex-an01-operator. Você usará os recursos S3 e Glue dessa identidade. Examine September:
cat september.csv
As três vendas têm order_id, region e total_cents. Os dois primeiros são strings; o valor é um inteiro em centavos. 1000, 2000 e 500 somam 3500. O arquivo usa valores sem aspas e uma linha de cabeçalho.
O ambiente novo fornece um bucket de entrada único. jq -r extrai um campo JSON como texto e $(...) salva a saída em uma variável. Salve e exiba o nome:
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
Envie para sales/orders.csv. O prefixo sales/ agrupa os dados que a tabela lerá:
aws s3 \
  cp september.csv "s3://$INPUT_BUCKET/sales/orders.csv"
Leia diretamente o objeto enviado:
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/orders.csv" -
O - final imprime o objeto S3 no terminal. Cabeçalho e três registros devem corresponder a september.csv. Abra AWS View, expanda o objeto e compare o conteúdo. Preserve reference/notes.txt, que fica fora de sales/.
Criar um banco de dados do catálogo
Nesta etapa, crie o espaço de nomes da definição de tabela. Um banco Glue agrupa tabelas do catálogo e armazena metadados, sem executar um servidor de banco de dados. Criá-lo não move o arquivo S3.
Leia o nome no inventário:
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
--database-input aceita a definição JSON comum de nome e descrição:
aws glue \
  create-database \
  --database-input "{\"Name\":\"$DATABASE\",\"Description\":\"Sales CSV catalog\"}"
Uma criação bem-sucedida não imprime corpo. Consulte o banco para comprovar sua existência:
aws glue \
  get-database \
  --name "$DATABASE" \
  --query 'Database.{Name:Name,Description:Description}'
O nome é labex_sales, com a descrição fornecida. AWS View mostra o banco ainda sem tabela. O arquivo S3 permanece no local original.
Descrever o arquivo com uma tabela externa
Nesta etapa, associe cada campo CSV a um nome e tipo e aponte para o prefixo S3 real. Uma tabela externa descreve dados fora do catálogo; remover sua definição não remove os próprios objetos S3.
O descritor de armazenamento registra colunas, localização e configuração de leitura. Um SerDe é um serializador/desserializador que interpreta registros como campos. LazySimpleSerDe lê aqui valores sem aspas separados por vírgulas. O cabeçalho não é uma venda: skip.header.line.count ignora a primeira linha.
Salve e exiba o prefixo da tabela:
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
cat > table.json <<EOF grava o texto até o EOF final. O delimitador sem aspas expande $SALES_LOCATION para seu prefixo real:
cat > table.json <<EOF
{
  "Name": "sales",
  "TableType": "EXTERNAL_TABLE",
  "StorageDescriptor": {
    "Columns": [
      {"Name": "order_id", "Type": "string"},
      {"Name": "region", "Type": "string"},
      {"Name": "total_cents", "Type": "int"}
    ],
    "Location": "$SALES_LOCATION",
    "InputFormat": "org.apache.hadoop.mapred.TextInputFormat",
    "OutputFormat": "org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat",
    "SerdeInfo": {
      "SerializationLibrary": "org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe",
      "Parameters": {"field.delim": ","}
    }
  },
  "PartitionKeys": [],
  "Parameters": {"skip.header.line.count": "1", "classification": "csv"}
}
EOF
PartitionKeys está vazio porque a primeira tabela lê um prefixo sem partições. As partições mensais serão introduzidas depois. As duas classes de formato descrevem entrada de texto e saída comum compatível com Hive; não é preciso instalá-las ou executá-las.
Crie a tabela a partir do JSON. file:// carrega a entrada CLI de um arquivo local:
aws glue \
  create-table \
  --database-name "$DATABASE" \
  --table-input file://table.json
Leia a definição no Glue:
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.{Name:Name,Columns:StorageDescriptor.Columns,Location:StorageDescriptor.Location,Parameters:Parameters}'
Confirme a ordem das colunas, o tipo int de total_cents, o final /sales/ da localização e o valor 1 do cabeçalho. AWS View mostra o objeto S3 ao lado da definição Glue.
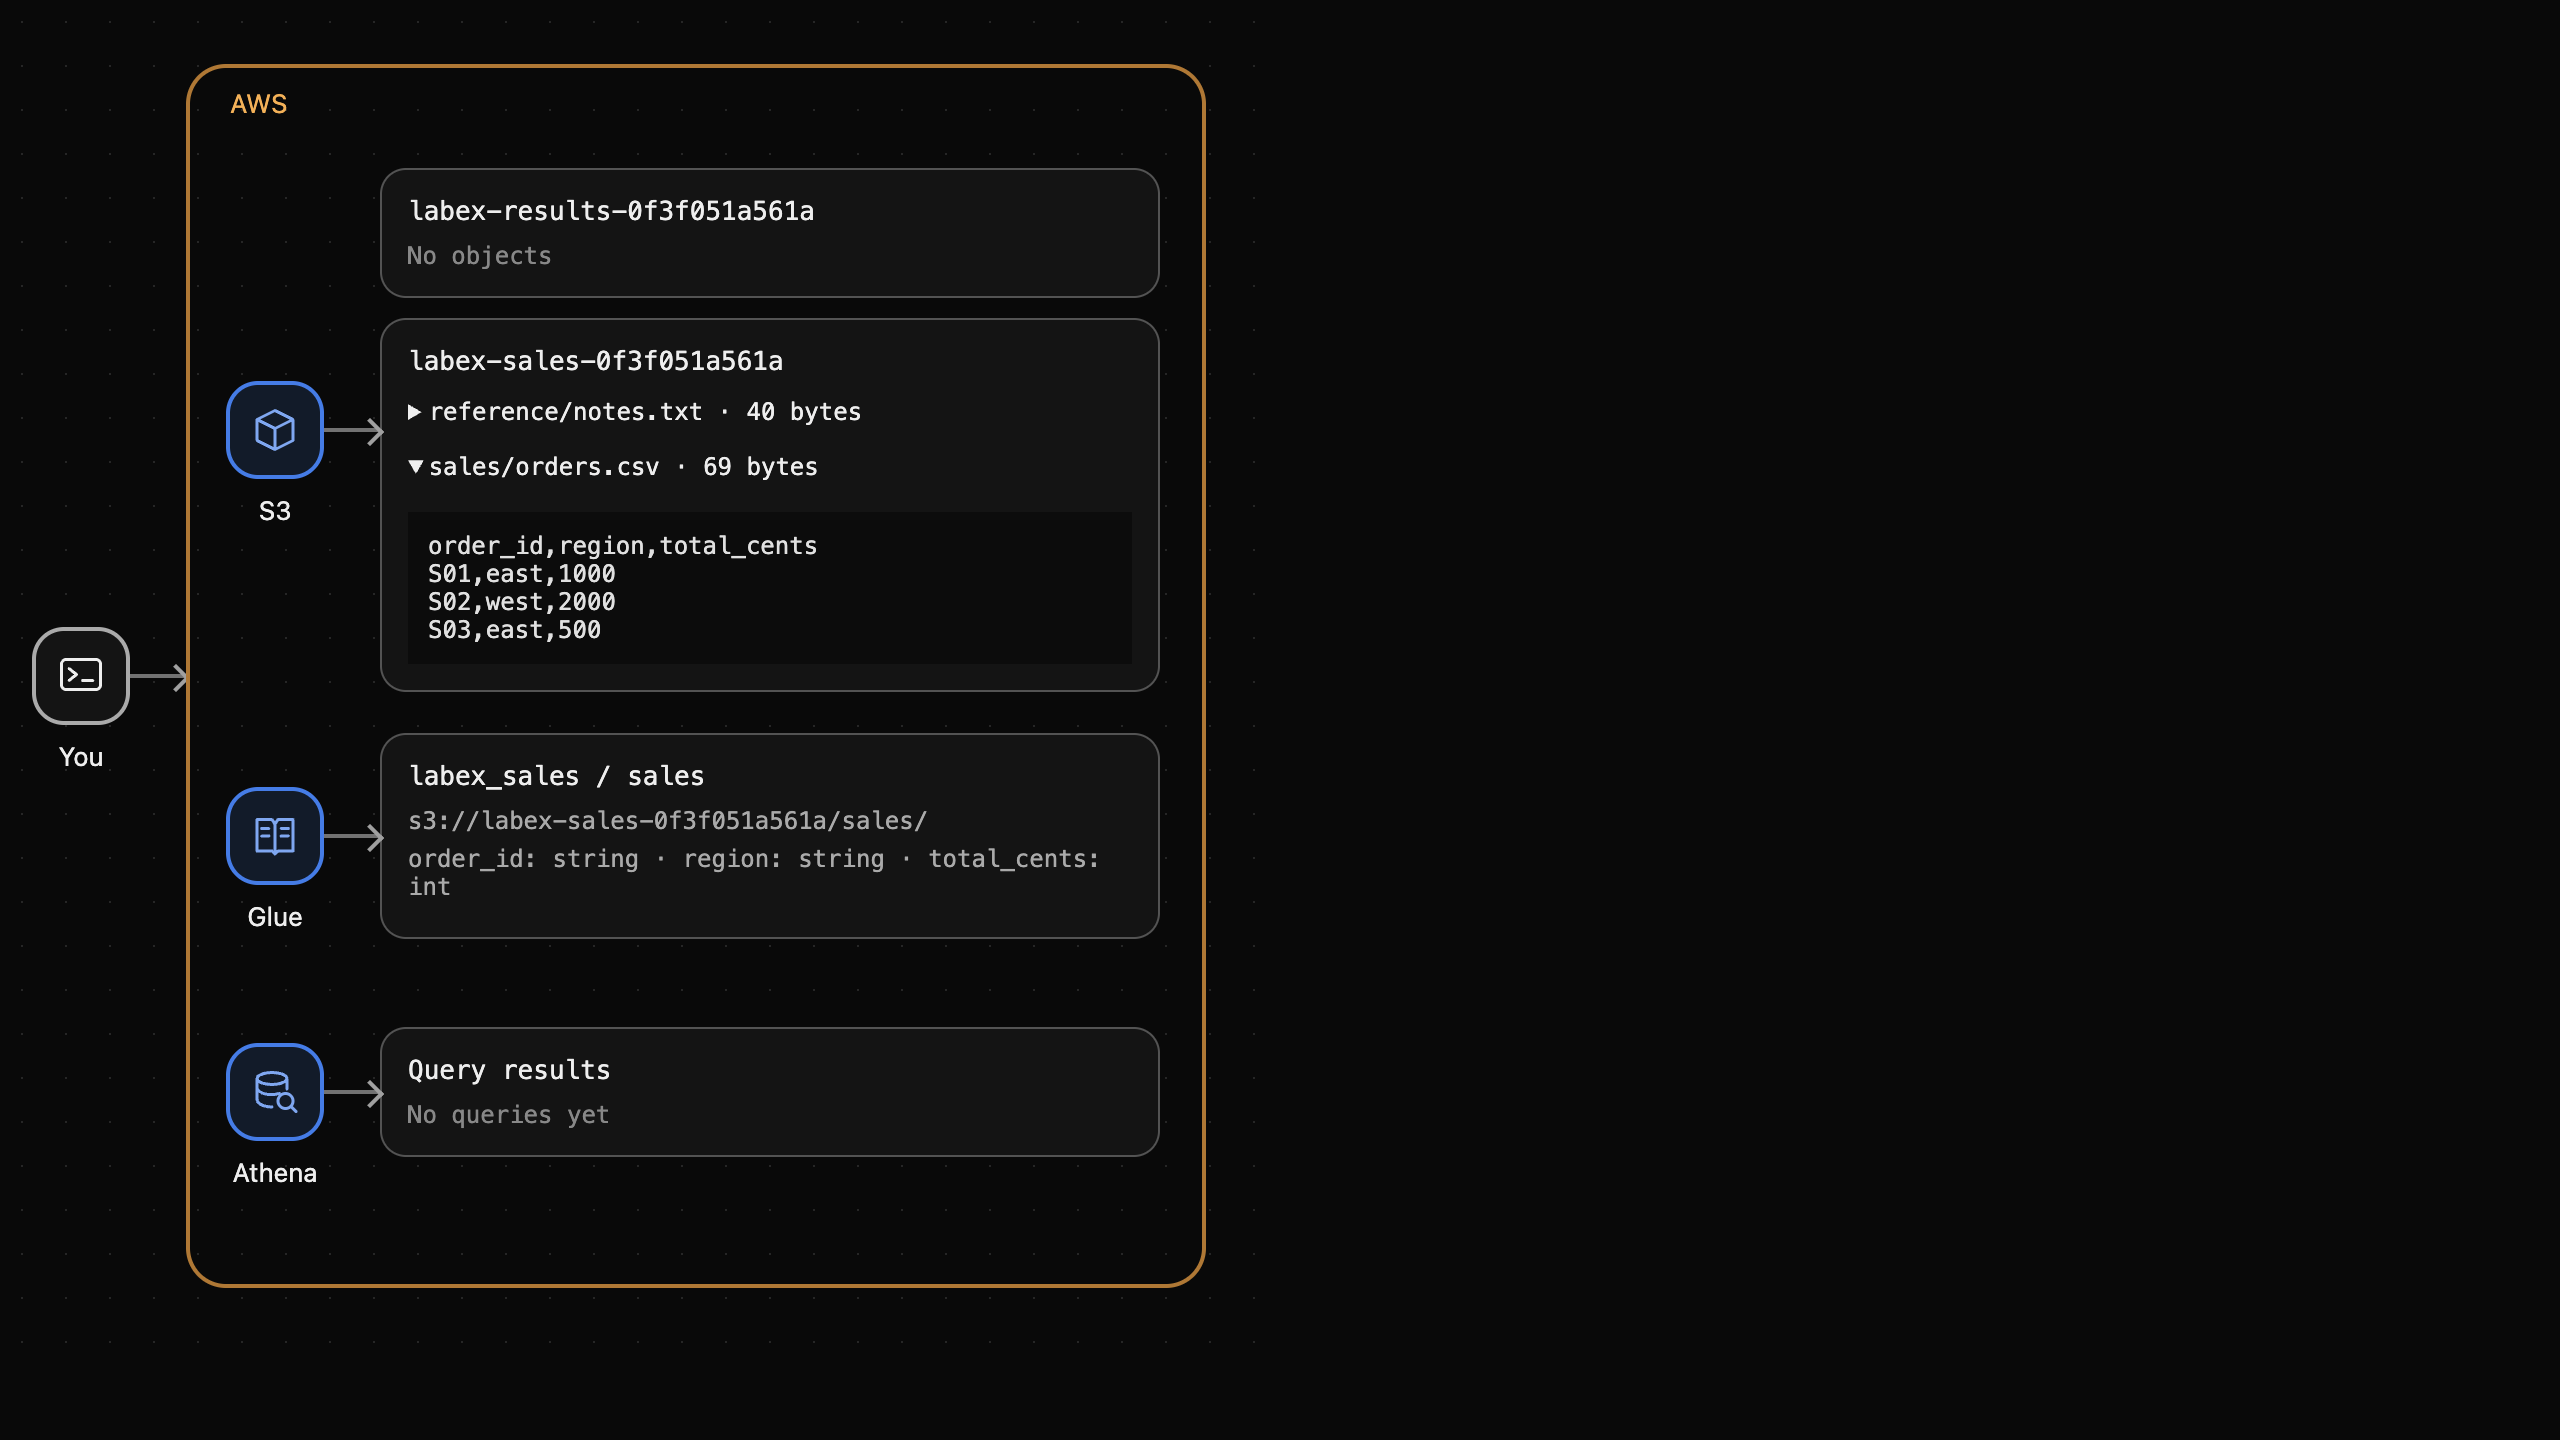
Criar o catálogo não mudou o CSV nem produziu um resultado Athena. Esquema ou localização incorretos fariam consultas falhar ou ler outros registros. Metadados corretos preparam a base para as consultas.
Resumo
Você enviou vendas reais ao S3, criou um banco Glue e definiu uma tabela externa com colunas, formato CSV e localização correspondentes. S3 guarda dados; Glue, metadados. O próximo laboratório consulta dados preparados de forma independente com Athena usando esse modelo.
Para aprofundar o tema, consulte a documentação da AWS: Definir metadados do catálogo manualmente; Campos CSV sem aspas e tratamento do cabeçalho.