Introdução
Uma equipe de operações precisa de um sinal de erro que seja ativado quando as solicitações falham e se recupere após tráfego saudável. Você configurará um alarme de métrica, observará ambas as transições a partir de solicitações reais, comparará zero com dados ausentes e removerá seus alarmes.
Conclua primeiro Meça a Saúde da Aplicação com Métricas do CloudWatch, incluindo dimensões de métricas e Sum. Este laboratório fornece uma aplicação e séries de métricas novas.
Relação com as certificações
| Certificação | Tarefa do exame | Prática |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Tarefa 1.1 | Avaliação de alarmes CloudWatch, recuperação e dados ausentes. |
| DevOps Engineer – Professional (DOP-C02) | Tarefa 4.2 | Prática dos fundamentos: Avaliação de alarmes CloudWatch, recuperação e dados ausentes. |
| Solutions Architect – Professional (SAP-C02) | Tarefa 3.1 | Prática dos fundamentos: Avaliação de alarmes CloudWatch, recuperação e dados ausentes. |
Visão geral do laboratório
Configure um Alarme de Métrica
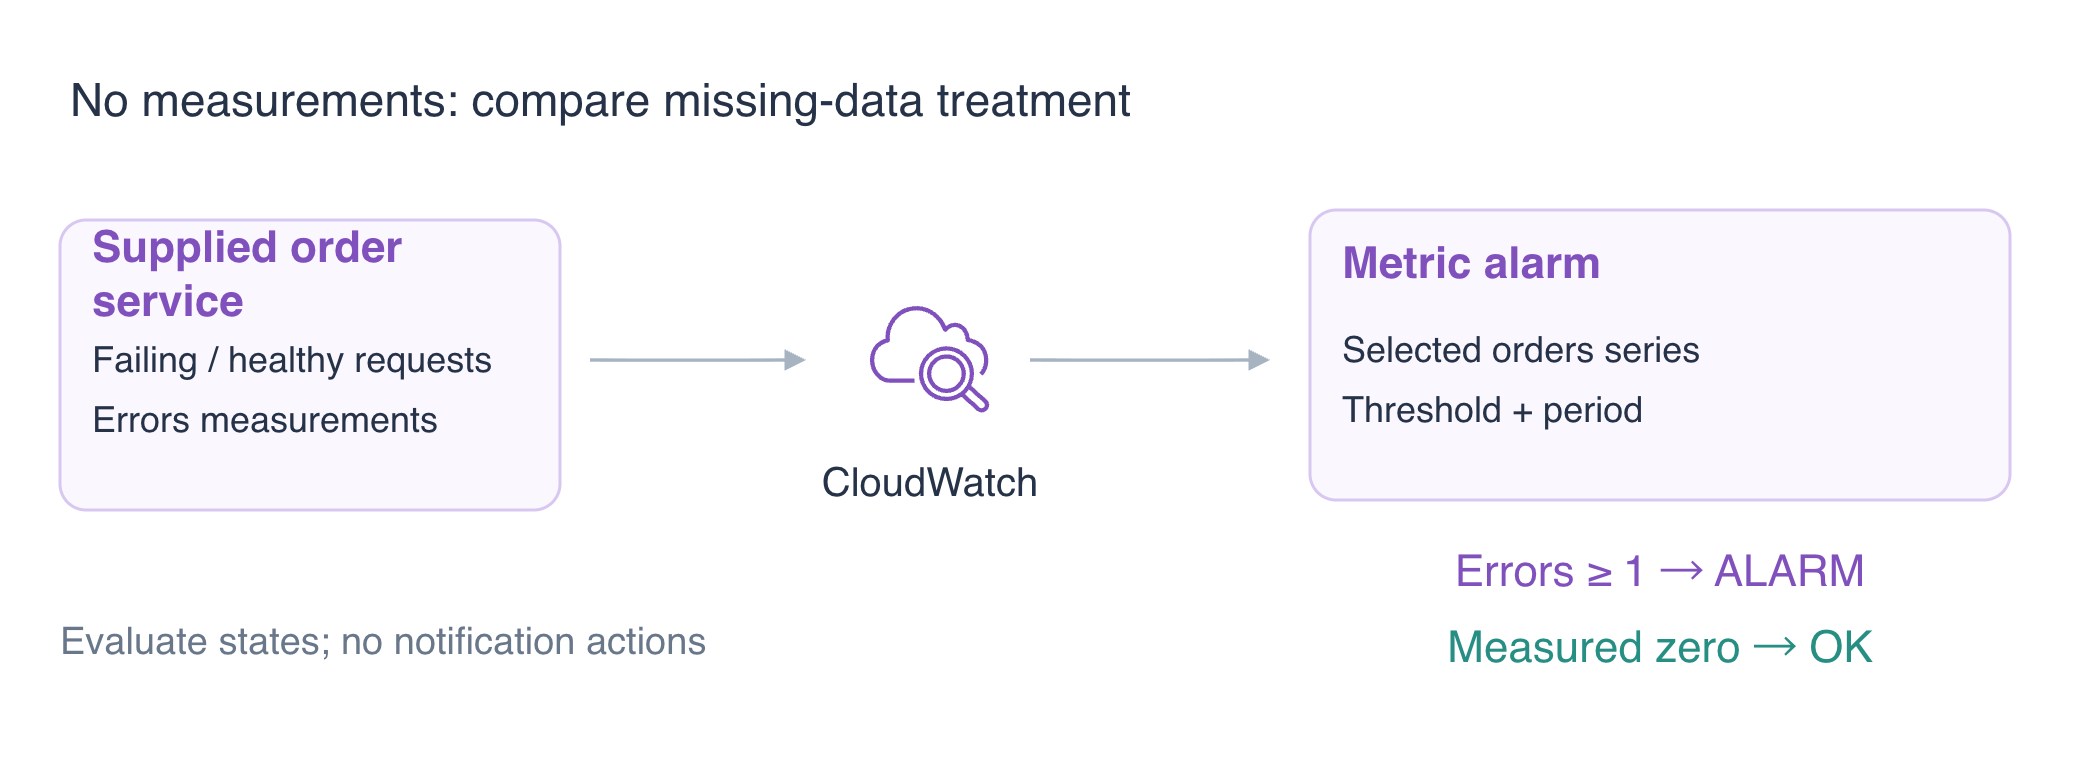
Nesta etapa, você monitorará a contagem de erros do servidor da aplicação orders. Um alarme avalia uma métrica em relação a um limite e informa OK, ALARM ou INSUFFICIENT_DATA. Ele não envia uma notificação a menos que uma ação esteja configurada; este exercício se concentra na avaliação.
A aplicação preparada de forma independente publica métricas reais de solicitações. Sua métrica Errors é um para HTTP 5xx e zero para uma solicitação saudável. A publicação de alta resolução permite um período de 10 segundos para que você observe vários períodos rapidamente. Períodos e limites de produção dependem da carga de trabalho e do custo.
cd /home/labex/project
Crie um alarme de uma única métrica. Namespace, nome e dimensões selecionam a série; Sum conta os erros em cada período concluído.
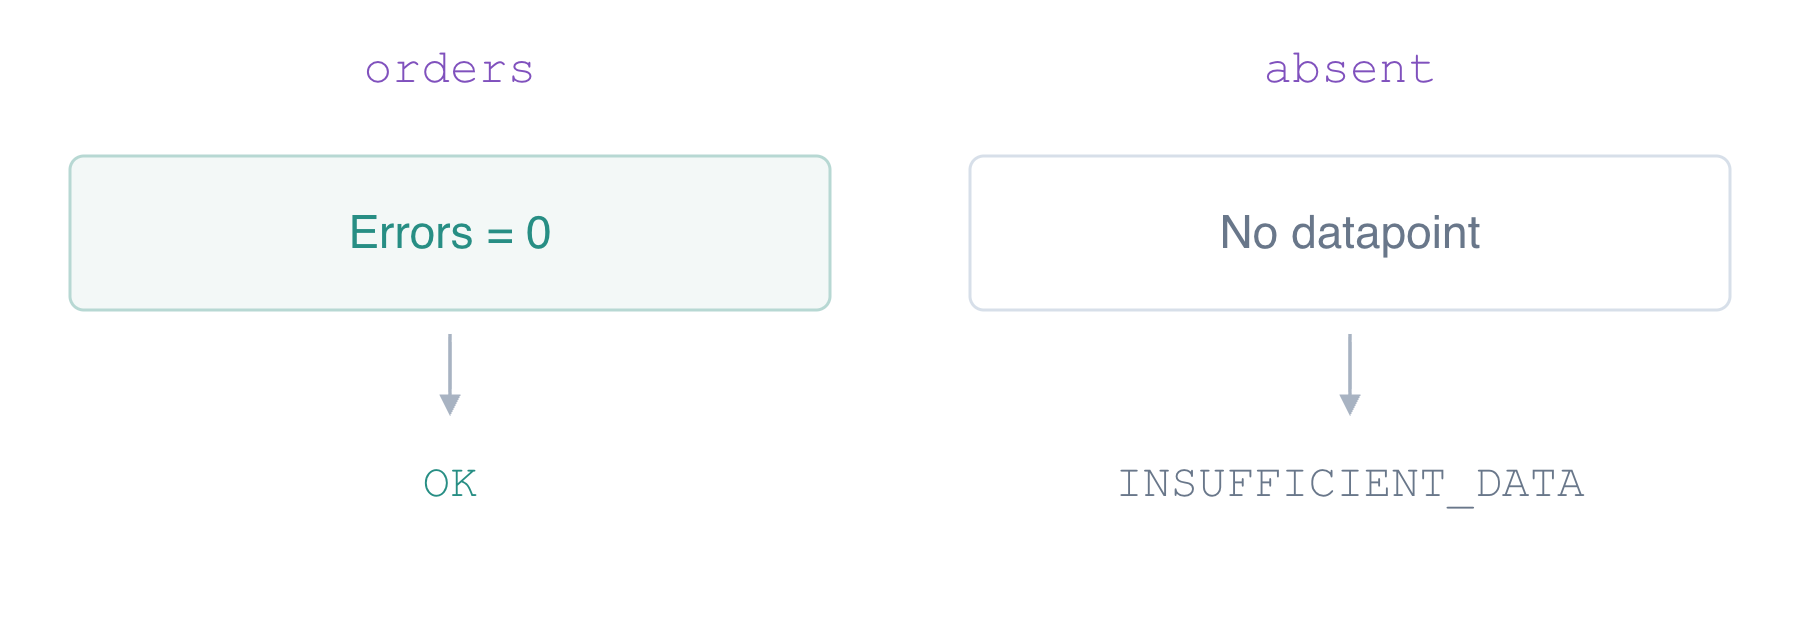
O alarme avalia um período concluído de 10 segundos (--period 10, --evaluation-periods 1). Um Sum de pelo menos 1 atinge o limite; GreaterThanOrEqualToThreshold significa “maior ou igual a”. notBreaching trata um período sem medições como sem violação do limite. Isso mantém os períodos ociosos em OK, mas não comprova a saúde da aplicação.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
Leia o alarme abaixo. Se a avaliação ainda estiver pendente, aguarde alguns segundos e repita este comando de leitura até que ele informe OK.
O OK inicial é causado pelo tratamento de dados ausentes, não por uma verificação de saúde bem-sucedida. Inspecione o motivo da avaliação:
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
Mantenha /labex/o03-reference inalterado. Cada laboratório começa de forma independente; nenhum dado de métrica anterior é necessário.
Dispare o Alarme com Falhas Reais
Nesta etapa, você gerará solicitações reais com falha e aguardará a avaliação automática. Um período concluído exclui pontos do período atual ainda incompleto; observar a resposta HTTP e o estado do alarme são observações separadas.
pear está indisponível no serviço fornecido. O laço envia nove solicitações com dois segundos de intervalo para abranger vários períodos de 10 segundos. for repete os comandos; sleep 2 pausa entre as solicitações. curl sem -f retorna o corpo da resposta mesmo para HTTP 503, tornando a falha observável.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Leia o estado avaliado. Se ele ainda não tiver chegado a ALARM, aguarde alguns segundos e repita este comando. StateReasonData é um JSON armazenado como string, por isso suas aspas aparecem com caracteres de escape na resposta; recentDatapoints lista as somas dos períodos avaliados.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
Espere ALARM e um valor de recentDatapoints de pelo menos 1 em StateReasonData. Se a avaliação ainda mostrar o período anterior, aguarde alguns segundos e repita o comando de leitura. O estado acompanha os pontos de dados derivados de solicitações reais; não defina o estado do alarme manualmente. O alarme monitora apenas orders, portanto a série de outra aplicação não entra nessa avaliação.
Para a equipe de pedidos, ALARM indica se o período selecionado contém falhas do servidor. Ele não explica qual solicitação falhou nem por que o estoque estava indisponível. A resposta HTTP comprova a falha de negócio, o ponto de dados avaliado comprova a transição do alarme e os registros fornecem detalhes para o diagnóstico. Diferencie essas observações ao decidir o que investigar.
Observe a Recuperação e os Dados Ausentes
Nesta etapa, você distinguirá um zero real de telemetria ausente. Envie solicitações saudáveis de apple para que os períodos concluídos contenham Errors=0 medido. Repetir as solicitações ao longo dos períodos evita confundir o intervalo atual incompleto com a recuperação.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Leia o estado avaliado. Se ele ainda não tiver chegado a OK, aguarde alguns segundos e repita este comando.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
Espere OK com recentDatapoints: [0]. Uma lista vazia significa telemetria ausente, portanto confirme o zero medido antes de continuar.
Crie um alarme separado para Application=absent, uma série que a aplicação nunca publica. Trate dados ausentes como ausentes, em vez de saudáveis.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
O novo alarme deve permanecer em INSUFFICIENT_DATA porque sua série selecionada não tem medições.
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
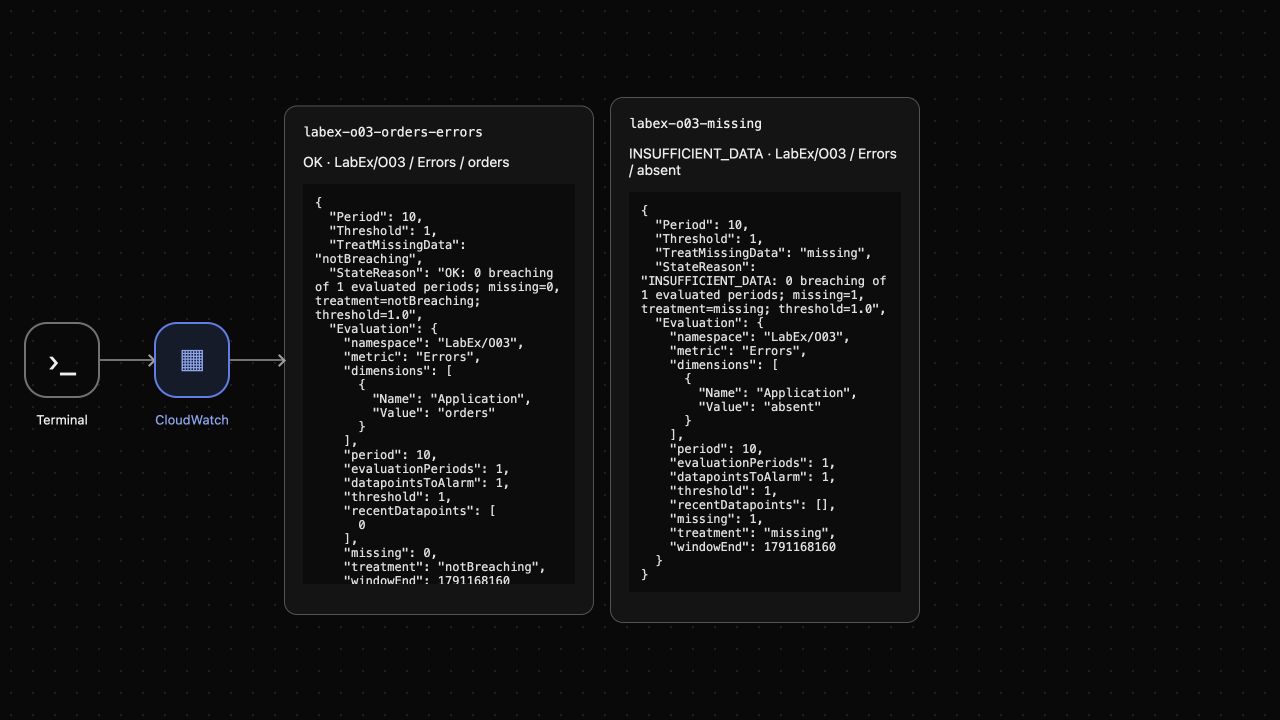
Espere orders em OK devido ao zero medido e absent em INSUFFICIENT_DATA. Use o motivo da avaliação para distinguir o zero medido de telemetria ausente.
O AWS View exibe o estado real do serviço e os pontos de dados avaliados. Compare os motivos, em vez de tratar todo OK como prova de saúde da aplicação.
Remova os Alarmes do Laboratório e Pare a Publicação
Nesta etapa, você removerá apenas os alarmes deste laboratório e preservará os dados não relacionados. Desabilite a instrumentação antes da limpeza para que a aplicação pare de publicar novos pontos.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
Espere um inventário vazio de alarmes e INFO platform reference keep unchanged. Os pontos de métricas existentes são mantidos; o CloudWatch não tem uma API explícita para excluir uma métrica individual. A limpeza do autor ou da plataforma remove este ambiente temporário depois.
Resumo
Você configurou um alarme de erros, observou seu disparo e sua recuperação automáticos a partir de solicitações reais, distinguiu zero medido de dados ausentes e removeu os alarmes do laboratório, preservando os logs de referência.
Para aprofundar o tema, consulte a documentação da AWS: Alarmes de métricas e ações; Avaliação de alarmes com dados ausentes.