소개
AI 모델은 자연어로 답할 수 있지만, 애플리케이션이 유용한 작업을 수행하려면 구조화된 정보가 필요한 경우가 있습니다. **도구 호출 (tool calling)**을 사용하면 애플리케이션이 카탈로그 항목 하나를 조회하는 작업과 같은 연산을 설명하고, 모델이 도구 이름과 인수를 제안하도록 할 수 있습니다. 모델에 임의의 코드를 실행할 권한이 부여되는 것은 아닙니다. 모델은 Worker 가 신뢰할 수 없는 입력으로 처리해야 하는 데이터를 생성합니다.
이 실습에서는 POST /catalog-help를 구현합니다. Cloudflare 에서 호스팅되는 Llama 모델이“SKU KB-101 은 재고가 있나요?”와 같은 짧은 질문을 받고, 읽기 전용 도구인 lookup_catalog_item을 제안할 수 있습니다. Worker 는 미리 알고 있는 도구 하나만 허용하고, 정확히 { sku } 형태인 인수 객체를 검증한 다음에만 작은 테스트용 카탈로그를 읽습니다. 알 수 없는 도구, 누락되거나 추가된 필드, 잘못된 SKU, 여러 도구 호출은 실행 함수에 전달되지 않습니다.
이 실습에서는 기존 방식의 function calling을 사용해 보안 경계를 명확하게 유지합니다. 추론은 제안하고, 검증은 결정하며, 애플리케이션 코드가 실행합니다. 반환 결과는 공개 테스트 데이터의 일부 필드로 제한됩니다. 이 실습에서는 쓰기 권한을 부여하지 않으며, 외부 서비스를 호출하지도 않고, 모델이 실행 가능한 코드를 선택하도록 허용하지도 않습니다.
이 실습은 과정의 다섯 번째 실습입니다. 바로 이 실습으로 시작했다면 먼저 Connect LabEx to Your Cloudflare Account를 완료하세요. VM 터미널 사용법, Wrangler 인증, 학습 계정 확인 방법, 계정 ID 설정 방법을 익힐 수 있습니다.
선택한 @cf/meta/llama-3.3-70b-instruct-fp8-fast 모델은 function calling 을 지원하며 표준 Workers AI 할당량으로 사용할 수 있습니다. 현재 Workers Free 에는 하루 10,000 Neurons 가 포함됩니다. 이 실습에서는 로컬에서 한 번, 배포 후 한 번만 짧은 실시간 요청을 보내므로 무료 할당량이 남아 있는 동안에는 Workers Paid 가 필요하지 않습니다. 로컬 추론도 Cloudflare 에 연결되어 계정 사용량을 차감합니다. 모델이나 할당량을 사용할 수 없으면 반복해서 재시도하지 말고 중지하세요.
설정 과정에서 /home/labex/project/tool-call-guard에 Node.js 22.22.0 과 프로젝트 전용 Wrangler 4.132.0 을 설치합니다. 또한 결정적인 모델 테스트 데이터와 독립적인 검증 기능을 제공합니다. 설정 과정에서는 Wrangler 인증, Worker 소스 생성, 모델 호출, 배포 또는 클라우드 리소스 생성은 수행하지 않습니다.
VM 인증 및 Tool-Call Worker 구성
이 단계에서는 새 VM 을 인증하고 임시 Worker 하나를 구성합니다. 브라우저에서는 이미 Cloudflare Dashboard 에 로그인되어 있을 수 있지만, 새 VM 내부의 Wrangler 에는 별도의 제한된 인증이 필요합니다.
준비된 프로젝트 디렉터리로 이동하고 고정된 CLI 버전을 확인합니다.
cd /home/labex/project/tool-call-guard
npx wrangler --version
4.132.0이 출력되어야 합니다. AI 기반 Worker 에 필요한 권한만 요청합니다. Wrangler 4.132.0 은 삭제할 때 KV 종속성도 확인하므로, 이 실습에서 KV 데이터를 만들지 않더라도 정리 과정에는 KV 권한이 필요합니다.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
표시된 링크를 열고 현재 코드를 입력한 다음 계정과 권한을 확인하고 학습 계정을 인증합니다. 코드, 비밀번호 또는 토큰을 다른 사람에게 보내지 마세요. 그런 다음 구조화된 ID 정보를 확인합니다.
npx wrangler whoami --json
loggedIn: true인지 확인한 후, 정리 과정에서 이 실습의 Worker 만 대상으로 지정할 수 있도록 고유한 이름을 생성합니다.
RUN="labex-c07-a05-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
다음 here-document 는 일반 JSON 구성을 작성합니다. YOUR_ACCOUNT_ID를 사용할 학습 계정의 실제 ID 로 바꾸세요.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
AI 바인딩을 사용하면 소스 코드에 모델 API 키를 넣지 않고도 env.AI 핸들로 안전하게 코드에서 AI 를 사용할 수 있습니다. remote: true는 로컬 개발 중에도 오프라인으로 추론을 흉내 내는 대신 계정에 연결된 모델을 호출한다는 의미입니다.
도구 경계 이해
이 단계에서는 플랫폼 바인딩을 애플리케이션이 적용해야 하는 보안 경계에 연결합니다.
wrangler.jsonc에서 환경 타입을 생성한 다음 생성된 인터페이스를 확인합니다.
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
AI: Ai를 찾으세요. **도구 설명 (tool description)**은 모델에 보내는 구조화된 데이터입니다. 여기에는 이름, 일반 언어로 작성한 목적, 가능한 인수의 스키마가 포함됩니다. 도구 설명은 모델이 호출을 제안하는 데 도움을 주지만, 권한 부여가 아니며 실행 가능한 코드도 아닙니다.
이 실습에서는 lookup_catalog_item이라는 읽기 전용 도구 하나만 허용하며, { "sku": "KB-101" }과 같은 인수 하나를 받습니다. 추론이 끝나면 애플리케이션은 제안된 호출이 정확히 하나인지, 이름이 허용된 이름과 정확히 일치하는지 확인합니다. 그런 다음 arguments가 sku만 포함하는 객체인지 확인하고, 이 실습에서 사용하는 짧은 공개 SKU 형식에 맞는지 검사한 뒤 검증된 값만 애플리케이션의 고정된 읽기 전용 함수에 전달합니다.
제공된 거부 테스트 데이터를 확인합니다.
grep -nE 'unknown tools|missing, extra|zero or multiple' test/worker.test.mjs
이 테스트 데이터는 의도적으로 만든 가짜 모델 응답입니다. 실시간 모델이 잘못된 호출을 생성하기를 기다리거나 Neurons 를 사용하지 않고도 보안 경계가 작동하는지 확인할 수 있습니다.
검증된 카탈로그 도구 구현
이 단계에서는 모델에 도구를 설명하고, 모델의 제안을 검증한 후 애플리케이션의 읽기 전용 카탈로그 함수만 실행합니다.
Worker 의 진입점을 생성합니다.
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const TOOL_NAME = "lookup_catalog_item";
const MAX_QUESTION = 240;
const SKU_PATTERN = /^[A-Z]{2}-[0-9]{3}$/;
const CATALOG = [
  { sku: "KB-101", name: "Compact Keyboard", priceUsd: 49, inStock: true },
  { sku: "MS-205", name: "Wireless Mouse", priceUsd: 29, inStock: false }
];

const TOOLS = [{
  name: TOOL_NAME,
  description: "Read one public catalog item by the exact SKU stated in the user's question.",
  parameters: {
    type: "object",
    properties: { sku: { type: "string", description: "An exact catalog SKU such as KB-101" } },
    required: ["sku"]
  }
}];

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuestion(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) return { error: json({ error: "invalid_question" }, 400) };
  if (question.length > MAX_QUESTION) return { error: json({ error: "question_too_large" }, 413) };
  return { question };
}

export function validateToolSelection(toolCalls) {
  if (!Array.isArray(toolCalls) || toolCalls.length !== 1) throw new Error("exactly one tool call is required");
  const call = toolCalls[0];
  if (!call || call.name !== TOOL_NAME) throw new Error("unknown tool");
  const args = call.arguments;
  if (!args || typeof args !== "object" || Array.isArray(args)) throw new Error("arguments must be an object");
  if (Object.keys(args).length !== 1 || !Object.hasOwn(args, "sku")) throw new Error("unexpected arguments");
  if (typeof args.sku !== "string" || !SKU_PATTERN.test(args.sku)) throw new Error("invalid sku");
  return { name: TOOL_NAME, arguments: { sku: args.sku } };
}

export function executeCatalogTool(argumentsValue) {
  const item = CATALOG.find((candidate) => candidate.sku === argumentsValue.sku);
  return item ? { ...item, found: true } : { sku: argumentsValue.sku, found: false };
}

export async function handleCatalogHelp(request, env, execute = executeCatalogTool) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let inference;
  try {
    inference = await env.AI.run(MODEL, {
      messages: [
        { role: "system", content: "Use exactly one provided read-only tool. Copy only the exact SKU from the user. Do not answer from memory." },
        { role: "user", content: parsed.question }
      ],
      tools: TOOLS,
      max_tokens: 128,
      temperature: 0
    });
  } catch {
    console.error(JSON.stringify({ event: "tool_inference_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let selected;
  try { selected = validateToolSelection(inference?.tool_calls); }
  catch {
    console.error(JSON.stringify({ event: "tool_call_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_tool_call", requestId }, 502);
  }
  const result = execute(selected.arguments);
  console.log(JSON.stringify({ event: "tool_call_executed", requestId, model: MODEL, tool: selected.name, found: result.found }));
  return json({ model: MODEL, tool: selected.name, arguments: selected.arguments, result, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/catalog-help") return handleCatalogHelp(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
실행 순서를 확인하세요. env.AI.run()이 데이터를 반환하고, validateToolSelection()이 데이터를 허용된 하나의 형태로 좁힌 다음, executeCatalogTool()이 실행됩니다. 모델은 JavaScript 를 제공할 수 없고, URL 을 선택할 수도 없으며, 쓰기 작업에 접근할 수도 없습니다. 로그에는 수명 주기 메타데이터만 기록하고 사용자의 질문과 카탈로그 결과는 기록하지 않습니다.
결정적인 테스트 5 개를 실행한 다음, 배포하지 않고 Wrangler 에 번들링을 요청합니다.
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
테스트에서 5 개가 모두 통과해야 합니다. dry run 출력에는 env.AI가 AI 바인딩으로 표시되어야 합니다. 이 두 결과를 통해 실시간 모델 호출로 사용량이 차감되기 전에 검증 코드와 Worker 구성이 올바르게 연결되는지 확인할 수 있습니다.
실시간 도구 선택 한 번 실행
이 단계에서는 AI 바인딩이 실제 원격 추론을 한 번 수행하도록 Worker 를 로컬에서 실행합니다. 카탈로그 조회만 로컬에서 실행되고, 모델은 Cloudflare 에서 계속 실행됩니다.
Wrangler 를 백그라운드에서 시작하고 AI 와 무관한 상태 확인 경로가 응답할 때까지 기다립니다. &는 백그라운드 작업을 만들고, $!은 해당 프로세스 ID 이며, 제한된 반복문은 /health가 성공하는 즉시 대기를 중지합니다.
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
정확한 테스트용 SKU 하나가 포함된 짧은 질문을 보냅니다.
curl --silent --show-error http://127.0.0.1:8787/catalog-help \
  --header 'Content-Type: application/json' \
  --data '{"question":"Is SKU KB-101 in stock and what does it cost?"}'
정확한 Llama 모델, tool: "lookup_catalog_item", KB-101만 포함된 인수, 제한된 Compact Keyboard 테스트 데이터가 반환되어야 합니다. 애플리케이션은 자유 형식의 문장이 아니라 구조화된 도구 제안을 사용하므로, 모델이 생성한 문구 자체는 평가하지 않습니다.
추론을 실행하기 전에 빈 질문이 거부되는지 확인합니다.
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/catalog-help \
  --header 'Content-Type: application/json' --data '{"question":""}'
{"error":"invalid_question"}과 HTTP 400이 반환되어야 합니다. 이를 통해 일반적인 요청 검증이 모델 사용보다 먼저 수행되는지 확인할 수 있습니다.
배포 및 도구 실행 증거 확인
이 단계에서는 동일한 엔드포인트를 배포하고 런타임 동작을 Cloudflare 에서 확인할 수 있는 증거와 연결합니다.
저장해 둔 개발 프로세스만 중지하고 종료될 때까지 기다린 다음 배포합니다.
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Wrangler 가 출력한 정확한 URL 을 저장하고 공개 질문을 하나 보냅니다.
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/catalog-help" \
  --header 'Content-Type: application/json' \
  --data '{"question":"Is SKU KB-101 in stock and what does it cost?"}'
공개 응답이 정확한 모델과 허용된 도구를 사용하는지 확인하세요. 또한 검증된 SKU 인수만 반환하고, 동일하게 제한된 읽기 전용 테스트 데이터 필드를 포함해야 합니다.
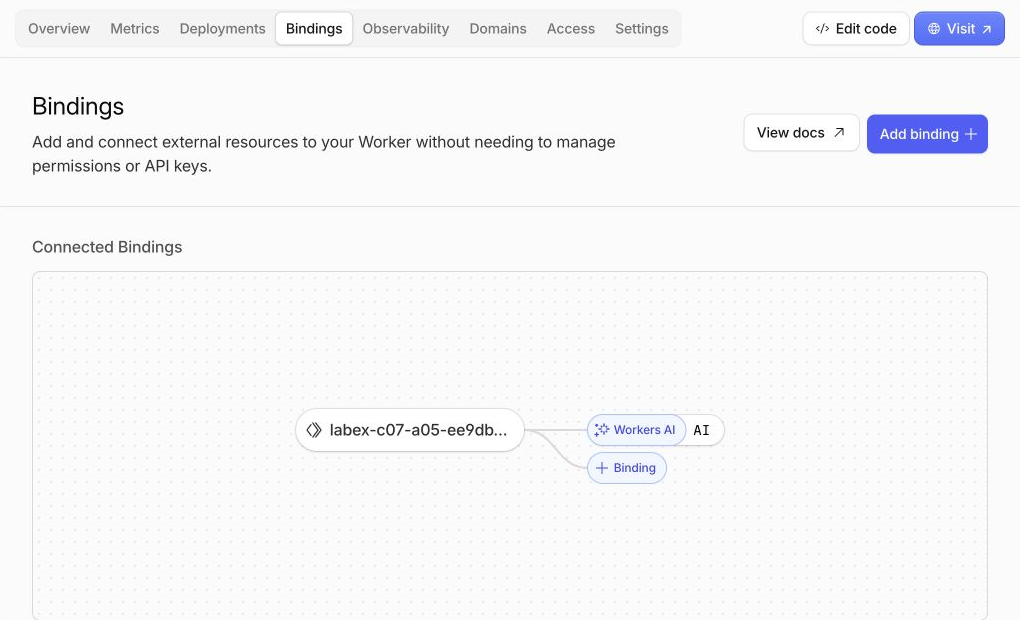
Workers & Pages → labex-c07-a05-... Worker → Bindings를 엽니다. 바인딩은 Cloudflare 서비스를 Worker 코드에서 사용할 수 있도록 연결하는 이름이 지정된 연결입니다. 이름이 AI인 Workers AI 연결이 하나 있는지 확인하세요. 프로그램이 env.AI.run(...)을 호출할 수 있는 이유가 바로 이 이름입니다.
다음으로 Observability를 엽니다. 이 페이지에는 호출 기록과 애플리케이션 로그가 수집됩니다. 아래 예시에는 공개 요청과 독립적인 확인을 수행한 후 성공한 이벤트 4 개와 오류 0 개가 표시됩니다. 요청 하나가 호출 기록과 애플리케이션 이벤트를 각각 생성할 수 있고 Dashboard 에 전달되는 데 시간이 걸릴 수 있으므로, 실제 개수는 다를 수 있습니다.
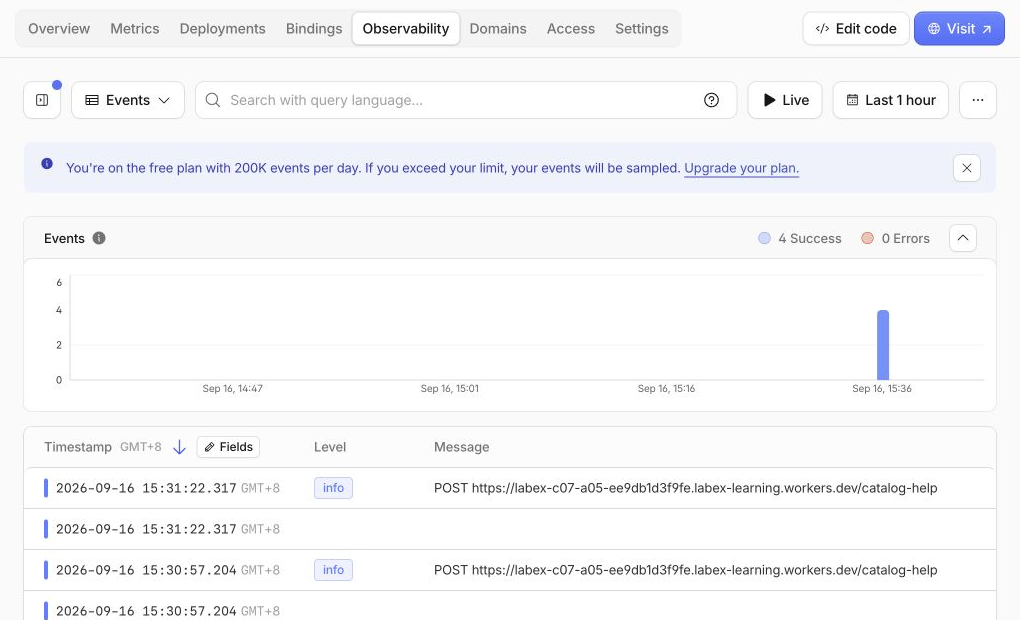
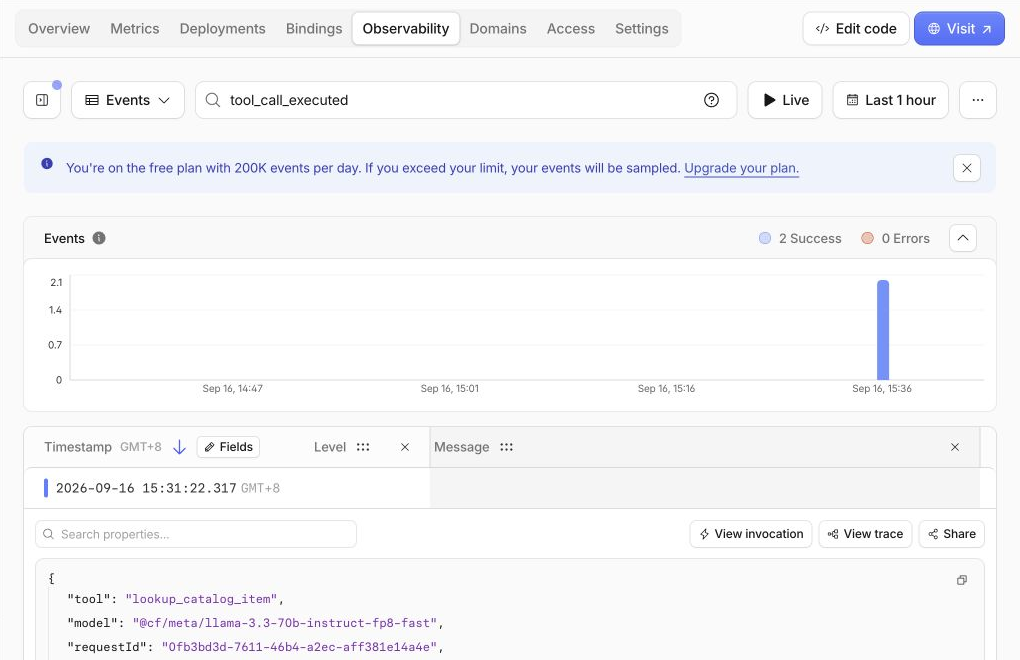
이 페이지의 파란색 Free 요금제 안내는 AI 추론이 아니라 Workers Logs 이벤트 허용량을 의미합니다. 검색 필드에 tool_call_executed를 입력한 후 일치하는 행 하나를 펼칩니다. 예시에는 성공적으로 일치한 항목 2 개와 이벤트 시작 부분의 제한된 필드가 표시됩니다. 여기에는 lookup_catalog_item, 정확한 Llama 모델, 요청 ID 가 포함됩니다. 전체 이벤트에는 event: "tool_call_executed"와 found: true도 포함되지만, 사용자의 질문, 모델의 원시 응답, 반환된 카탈로그 레코드는 기록하지 않습니다.
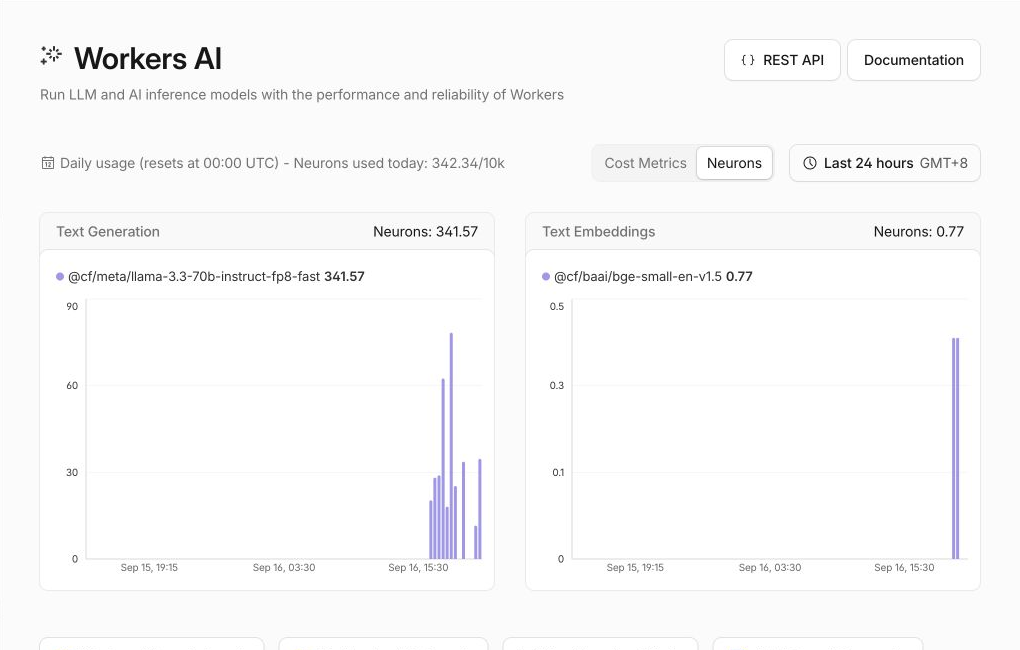
마지막으로 AI → Workers AI를 열고 Neurons 탭을 선택한 상태로 둡니다. Neuron 은 Workers AI 계산량을 나타내는 Cloudflare 의 단위입니다. 예시 계정에서는 해당 날짜에 342.34/10k Neurons 를 사용했으며, Llama 행에는 341.57이 표시되고 이전 임베딩 실습은 별도로 표시됩니다. 이 값은 계정을 공유한 예시일 뿐이며, 요청 하나에 드는 비용을 보장하는 값이 아닙니다. 계정에서 정확한 Llama 행을 찾아 오늘의 총 사용량이 10k Workers Free 할당량 이내인지 확인하세요.
Dashboard 페이지를 사용하면 구성, 트래픽, 사용량을 명령줄 결과와 연결할 수 있습니다. 차트를 갱신하기 위해 추론을 반복해서 실행하지 마세요. 차트와 로그가 나중에 도착할 수 있으므로 JSON 응답과 독립적인 검증 결과를 기준으로 판단해야 합니다.
Worker 삭제 및 로그아웃
이 단계에서는 임시 공개 엔드포인트를 삭제한 다음 이 VM 의 인증을 해제합니다. Workers AI 사용량은 계정 기록으로 남으며, Worker 를 삭제해도 사용량 기록은 삭제되지 않습니다.
wrangler.jsonc에 지정된 정확한 Worker 를 삭제합니다.
npx wrangler delete
Wrangler 에 이 실습의 고유한 labex-c07-a05-... 이름이 표시될 때만 확인하세요. Successfully deleted가 표시되는지 확인한 후, 인증이 아직 유효할 때 클라우드에서 리소스가 사라졌는지 독립적으로 확인합니다.
python3 .labex/verify.py deleted
PASS: deleted가 출력된 후에만 로그아웃하고 구조화된 상태를 확인합니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn: false인지 확인해야 합니다. 브라우저 탭을 닫거나 로컬 소스를 삭제하는 것만으로는 공개 Worker 가 삭제되었다고 증명할 수 없습니다.
요약
모델의 선택과 애플리케이션의 권한을 분리했습니다. Workers AI 는 구조화된 카탈로그 조회 하나를 제안했고, Worker 는 정확한 도구 이름과 인수 객체를 검증한 뒤에만 고정된 읽기 전용 코드를 실행했습니다. 결정적인 테스트 데이터로 알 수 없는 도구, 잘못된 인수, 여러 호출이 실행될 수 없음을 확인했으며, 실시간 추론으로 실제 모델 교환도 확인했습니다. 또한 개인정보를 제한한 증거를 점검하고 임시 Worker 와 VM 인증을 삭제했습니다.