소개
키워드 검색은 같은 단어를 찾습니다. 의미 기반 검색은 같은 의미를 가진 텍스트를 찾습니다. 예를 들어“I cannot sign in”은 문장에 모든 단어가 포함되어 있지 않더라도 비밀번호 재설정에 관한 문서와 가까운 결과로 나와야 합니다.
임베딩 모델은 텍스트를 벡터로 변환합니다. 벡터는 모델이 언어에서 학습한 특징을 나타내는 숫자의 순서 있는 목록입니다. 의미가 서로 관련된 텍스트는 일반적으로 비슷한 방향을 가리킵니다. 이 실습에서는 코사인 유사성으로 이러한 방향을 비교합니다. 코사인 유사성은 벡터가 더 가깝게 정렬될수록 더 큰 점수를 반환하는 계산입니다. 점수는 같은 모델, 차원 수, 풀링 방식을 사용해 생성한 벡터를 비교할 때만 유효합니다. 이 점수는 진실을 나타내는 보편적인 백분율이 아닙니다.
POST /search를 구현합니다. Worker 는 Cloudflare 에서 호스팅하는 @cf/baai/bge-small-en-v1.5를 사용해 하나의 쿼리와 세 개의 짧은 도움말 문서를 함께 임베딩합니다. 이 모델은 텍스트마다 384 개의 숫자를 생성합니다. 애플리케이션은 비교 전에 모든 벡터를 검증하고, 호환되지 않거나 유한하지 않은 값을 거부하며, 벡터 자체를 노출하지 않고 순위가 매겨진 문서 ID 를 반환합니다.
이 실습은 과정의 네 번째 실습입니다. 이 실습으로 바로 시작했다면 먼저 Connect LabEx to Your Cloudflare Account를 완료합니다. VM 터미널 사용법, Wrangler 인증, 학습 계정 확인 방법, 계정 ID 설정 방법을 익힐 수 있습니다.
Workers Free 계정에는 현재 매일 10,000 Neurons 의 공유 할당량이 제공됩니다. 이 모델은 입력 토큰 100 만 개당 약 1,841 Neurons 를 사용하며, 이 실습에서는 짧은 합성 문장 몇 개만 사용하므로 무료 할당량이 남아 있는 동안에는 Workers Paid 가 필요하지 않습니다. 로컬 추론도 Cloudflare 에 연결되며 계정 사용량을 소비합니다. 모델이나 할당량을 사용할 수 없으면 반복해서 재시도하지 말고 중단합니다.
설정 과정에서는 /home/labex/project/search-embeddings에 Node.js 22.22.0 과 프로젝트 전용 Wrangler 4.132.0 을 설치합니다. 또한 결정적 테스트와 독립적인 검증 도구를 제공합니다. 설정 과정에서는 Wrangler 인증, 모델 호출, Worker 배포 또는 클라우드 리소스 생성을 수행하지 않습니다.
VM 인증 및 임베딩 Worker 구성
이 단계에서는 새 VM 을 인증하고 임시 Worker 하나를 구성합니다. Dashboard 로그인은 브라우저에 적용되지만, 이 VM 의 Wrangler 에는 별도의 제한된 인증이 필요합니다.
준비된 프로젝트 디렉터리로 이동하고 고정된 CLI 버전을 확인합니다.
cd /home/labex/project/search-embeddings
npx wrangler --version
4.132.0이 출력되어야 합니다. 앞선 Workers AI 실습에서 사용한 범위가 좁은 권한을 요청합니다. KV 권한은 Wrangler 4.132.0 의 정리 작업 의존성 검사를 지원하기 위한 것이며, 이 실습에서는 KV 데이터를 생성하지 않습니다.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
표시된 링크를 열고 현재 코드를 입력합니다. 계정과 권한을 확인한 뒤 학습 계정을 인증합니다. 그런 다음 구조화된 ID 데이터를 확인합니다.
npx wrangler whoami --json
loggedIn: true인지 확인한 다음 고유한 Worker 이름을 생성합니다.
RUN="labex-c07-a04-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
YOUR_ACCOUNT_ID를 사용할 계정의 실제 ID 로 바꿉니다.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
env.AI는 프로세스 내부 바인딩이며 소스에 저장하는 모델 API 키가 아닙니다. remote: true로 설정하면 로컬 개발 중에도 계정에 연결된 모델을 호출합니다.
벡터 계약 이해
이 단계에서는 모델 설정이 애플리케이션에서 검증해야 하는 숫자와 어떻게 연결되는지 확인합니다.
환경 타입을 생성하고 플랫폼 바인딩을 확인합니다.
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
AI: Ai를 찾습니다. 선택한 BGE Small 모델은 각 입력 텍스트에 대해 384 차원 벡터 하나를 반환합니다. 차원은 위치의 개수를 의미하므로, 텍스트 네 개를 배치로 처리하면 형태는 [4, 384]가 됩니다. 모든 위치에는 유한한 숫자가 들어 있어야 합니다. 즉 NaN, 양의 무한대, 음의 무한대가 아니어야 합니다.
이 실습에서는 cls 풀링을 명시적으로 요청합니다. 풀링은 모델이 토큰 수준의 정보를 하나의 벡터로 압축하는 방식입니다. cls와 mean 풀링으로 생성한 벡터는 둘 다 384 개의 위치를 갖더라도 호환되지 않습니다. 따라서 애플리케이션은 모델 및 차원 정보와 함께 풀링 방식을 기록합니다.
제공된 결정적 픽스처를 확인합니다.
grep -nE 'incompatible|non-finite|cosine similarity' test/worker.test.mjs
이 픽스처를 사용하면 Neurons 를 소비하지 않고도 실패 테스트를 반복해서 실행할 수 있습니다. 또한 모델 동작에 따라 달라질 수 있는 실시간 유사성 점수의 정확한 값을 검증하지 않습니다.
검증된 유사성 엔드포인트 구현
이 단계에서는 임베딩 요청, 벡터 검증, 로컬 코사인 비교를 구현합니다. Worker 는 네 개의 벡터에 포함된 1,536 개의 원시 숫자 대신 문서 ID 와 점수를 반환합니다.
진입점을 생성합니다.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const DIMENSIONS = 384;
const POOLING = "cls";
const MAX_QUERY = 300;
const DOCUMENTS = [
  { id: "password-reset", text: "Reset a forgotten password and regain account access." },
  { id: "upload-pdf", text: "Troubleshoot a PDF document that will not upload." },
  { id: "billing-receipt", text: "Download a receipt for a completed payment." }
];

export function validateEmbeddingBatch(result, expectedCount) {
  if (!Array.isArray(result?.shape) || result.shape[0] !== expectedCount || result.shape[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding shape");
  }
  if (!Array.isArray(result.data) || result.data.length !== expectedCount) {
    throw new Error("incompatible embedding count");
  }
  for (const vector of result.data) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return result.data;
}

export function cosineSimilarity(left, right) {
  if (left.length !== right.length || left.length === 0) throw new Error("incompatible vectors");
  let dot = 0, leftNorm = 0, rightNorm = 0;
  for (let index = 0; index < left.length; index += 1) {
    dot += left[index] * right[index];
    leftNorm += left[index] ** 2;
    rightNorm += right[index] ** 2;
  }
  if (leftNorm === 0 || rightNorm === 0) throw new Error("zero-length direction");
  return dot / (Math.sqrt(leftNorm) * Math.sqrt(rightNorm));
}

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuery(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const query = typeof body?.query === "string" ? body.query.trim() : "";
  if (!query) return { error: json({ error: "invalid_query" }, 400) };
  if (query.length > MAX_QUERY) return { error: json({ error: "query_too_large" }, 413) };
  return { query };
}

async function search(request, env) {
  const parsed = await readQuery(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let result;
  try {
    result = await env.AI.run(MODEL, { text: [parsed.query, ...DOCUMENTS.map((item) => item.text)], pooling: POOLING });
  } catch {
    console.error(JSON.stringify({ event: "embedding_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let vectors;
  try { vectors = validateEmbeddingBatch(result, DOCUMENTS.length + 1); }
  catch {
    console.error(JSON.stringify({ event: "embedding_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_embeddings", requestId }, 502);
  }
  const [queryVector, ...documentVectors] = vectors;
  const matches = DOCUMENTS.map((document, index) => ({ id: document.id, score: cosineSimilarity(queryVector, documentVectors[index]) }))
    .sort((left, right) => right.score - left.score);
  console.log(JSON.stringify({ event: "embedding_compared", requestId, model: MODEL, dimensions: DIMENSIONS, count: vectors.length, pooling: POOLING }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, matches, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/search") return search(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
유사성을 계산하기 전에 벡터를 검증합니다. 이를 통해 자동으로 잘리는 데이터, 의미 없는 차원 간 비교, NaN 점수를 방지합니다. 로그에는 수명 주기 메타데이터만 남기며 쿼리, 문서 텍스트, 벡터는 기록하지 않습니다.
결정적 테스트 다섯 개를 실행한 다음 배포하지 않고 번들링합니다.
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
테스트는 로컬 수학 계산과 거부 동작을 검증합니다. dry run 은 Worker 와 바인딩 설정이 함께 번들링되는지 검증합니다.
실제 임베딩 배치 한 번 실행
이 단계에서는 AI 바인딩이 실제 원격 임베딩 요청을 한 번 수행하는 동안 핸들러를 로컬에서 실행합니다.
Wrangler 를 백그라운드에서 시작하고 AI 가 아닌 health 경로가 응답할 때까지 기다립니다.
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
짧은 합성 쿼리를 전송합니다.
curl --silent --show-error http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
model, dimensions: 384, pooling: "cls", 순위가 매겨진 ID 세 개, 유한한 점수가 출력되어야 합니다. 정확한 점수까지 일치할 필요는 없습니다. 결과 순서는 이 쿼리에 대한 증거일 뿐이며, 모델이 항상 보장하는 영구적인 순서는 아닙니다.
추론을 수행하기 전에 빈 쿼리가 거부되는지 확인합니다.
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' --data '{"query":""}'
{"error":"invalid_query"}와 HTTP 400이 출력되어야 합니다.
배포 후 임베딩 증거 확인
이 단계에서는 같은 엔드포인트를 배포하고 실행 결과를 Cloudflare Dashboard 에서 확인합니다.
저장된 개발 프로세스만 중지한 다음 배포합니다.
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Wrangler 가 출력한 정확한 URL 을 저장하고 공개 쿼리를 하나 전송합니다.
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/search" \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
응답에 모델, 384 개 차원, cls 풀링이 기록되어 있는지 확인합니다. 또한 제공된 ID 세 개만 정확히 포함되고 각각 유한한 점수를 갖는지 확인합니다.
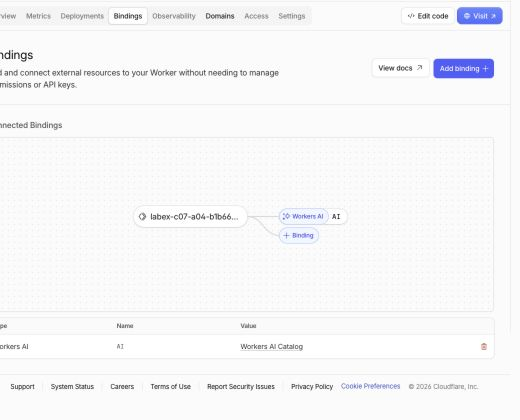
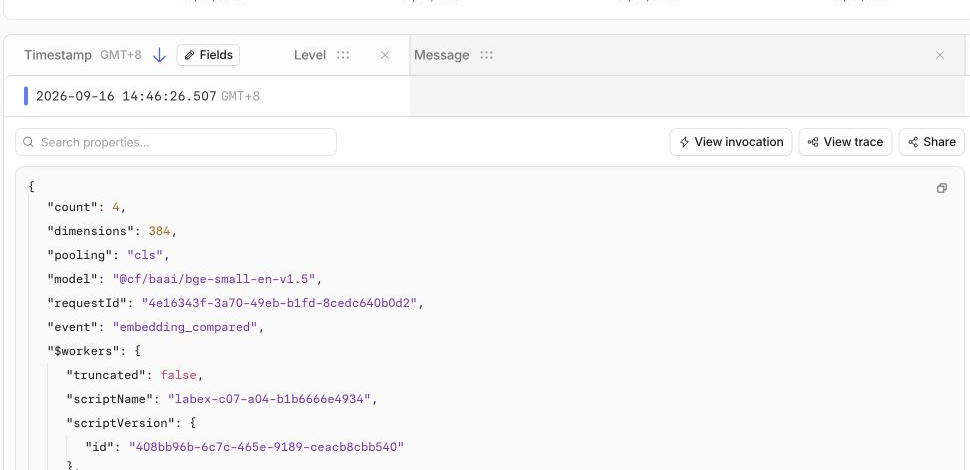
Workers & Pages → Overview → labex-c07-a04-... Worker를 엽니다. Bindings에서 AI 바인딩을 확인합니다. Observability → Logs에서 embedding_compared를 검색하고 이벤트를 펼칩니다. 정확한 모델, dimensions: 384, count: 4, pooling: cls, 요청 ID 가 있는지 확인합니다. 쿼리, 문서, 벡터는 포함되지 않아야 합니다.
Bindings 페이지에서 연결 상태를 확인할 수 있습니다. Worker 에는 AI라는 이름의 Workers AI 바인딩 하나가 있습니다. 바인딩은 코드에서 env.AI로 사용하는 안전한 핸들입니다. 소스 파일에 API 키를 직접 입력하지 않습니다.
Observability 개요에는 이 임시 실행에서 성공한 /search 요청과 오류가 없는 상태가 표시됩니다. 모든 테스트 요청이 이벤트가 되므로 정확한 합계는 다를 수 있습니다.
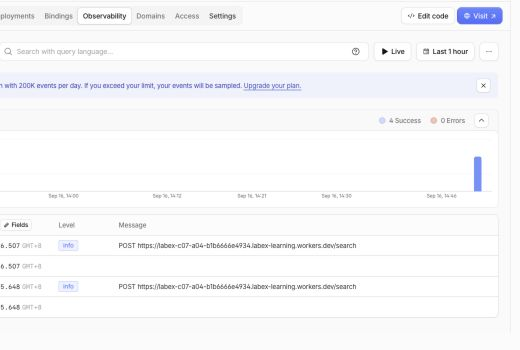
embedding_compared 이벤트 하나를 펼칩니다. 이 예시에는 운영에 필요한 정보만 기록됩니다. 네 개의 텍스트를 비교했고, 각 벡터의 차원은 384 이며, cls 풀링을 사용했고, 모델은 @cf/baai/bge-small-en-v1.5라는 사실입니다. 학습자의 쿼리, 문서 텍스트, 수백 개의 벡터 숫자는 의도적으로 기록하지 않습니다.
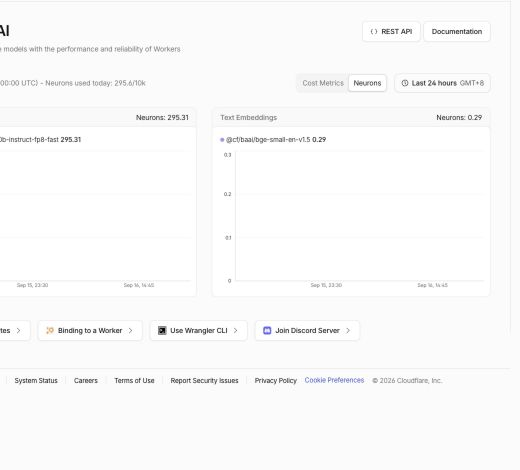
그런 다음 Workers AI를 엽니다. 오늘의 사용량에서 BGE Small 모델을 찾고, 제한된 실행이 공유 10,000-Neuron Free 할당량 안에 있는지 확인합니다. Dashboard 에 사용량이 표시되기까지 시간이 걸릴 수 있으므로 차트를 갱신하려고 추론을 반복하지 말고 잠시 기다립니다.
테스트한 Free 계정에서는 임베딩 모델이 0.29 Neurons 만 사용했고 전체 사용량은 295.6 / 10k였습니다. 전체 사용량에는 같은 날 과정의 다른 테스트가 포함되어 있으므로 이 수치는 필수 결과가 아닌 예시로만 참고합니다. 중요한 확인 사항은 BGE Small 행이 표시되고 일일 총 사용량이 Free 할당량보다 낮은지 여부입니다.
Dashboard 차트는 유용한 시각적 확인 수단이지만, JSON 응답과 독립적인 검증 스크립트가 배포된 Worker 의 정상 동작을 판단하는 기준입니다.
Worker 삭제 및 로그아웃
이 단계에서는 임시 엔드포인트를 삭제한 다음 이 VM 의 인증을 제거합니다. Workers AI 사용량은 계정 기록으로 남으므로 Worker 를 삭제해도 사용량 기록은 삭제되지 않습니다.
wrangler.jsonc에 설정된 정확한 Worker 를 삭제합니다.
npx wrangler delete
Wrangler 에 이 실습의 고유한 labex-c07-a04-... 이름이 표시될 때만 확인합니다. Successfully deleted가 표시되는지 확인한 다음, 인증이 유지되는 동안 클라우드 리소스가 없는지 독립적으로 확인합니다.
python3 .labex/verify.py deleted
PASS: deleted가 출력된 후에만 로그아웃하고 구조화된 상태를 확인합니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn: false인지 확인합니다. 브라우저 탭을 닫거나 로컬 파일이 사라진 것만으로는 클라우드 정리를 확인할 수 없습니다.
요약
Cloudflare 에서 호스팅하는 모델로 384 차원 임베딩을 생성하고, 호환성 설정을 기록했으며, 모든 벡터를 검증했습니다. 또한 코사인 유사성으로 의미 방향을 비교하고 순위를 매기기 전에 호환되지 않는 데이터를 거부했습니다. 실시간 바인딩과 개인정보를 고려한 로그를 확인한 뒤 임시 Worker 와 VM 인증을 삭제했습니다.