소개
V01 에서는 식별된 벡터를 저장했고, V02 에서는 해당 레코드를 최신 상태로 유지했습니다. 이 실습에서는 빠져 있던 읽기 경로를 추가합니다. 사용자가 질문을 입력하면 애플리케이션이 텍스트를 호환 가능한 벡터로 변환하고, Vectorize 에 저장된 문서 중 가장 가까운 방향을 가리키는 문서를 요청합니다.
이것이 시맨틱 검색입니다. 쿼리에 문서의 정확한 단어가 반복되어야 하는 대신, 의미를 나타내는 임베딩을 비교합니다. 쿼리와 저장된 문서는 동일한 모델, 384 개 차원, cls 풀링을 사용해야 합니다. Vectorize 유사도 점수는 하나의 쿼리에 대해 호환되는 벡터의 순위를 정하는 데 도움이 되지만, 보편적인 신뢰도 백분율이나 해당 문서가 질문에 답한다는 증거는 아닙니다.
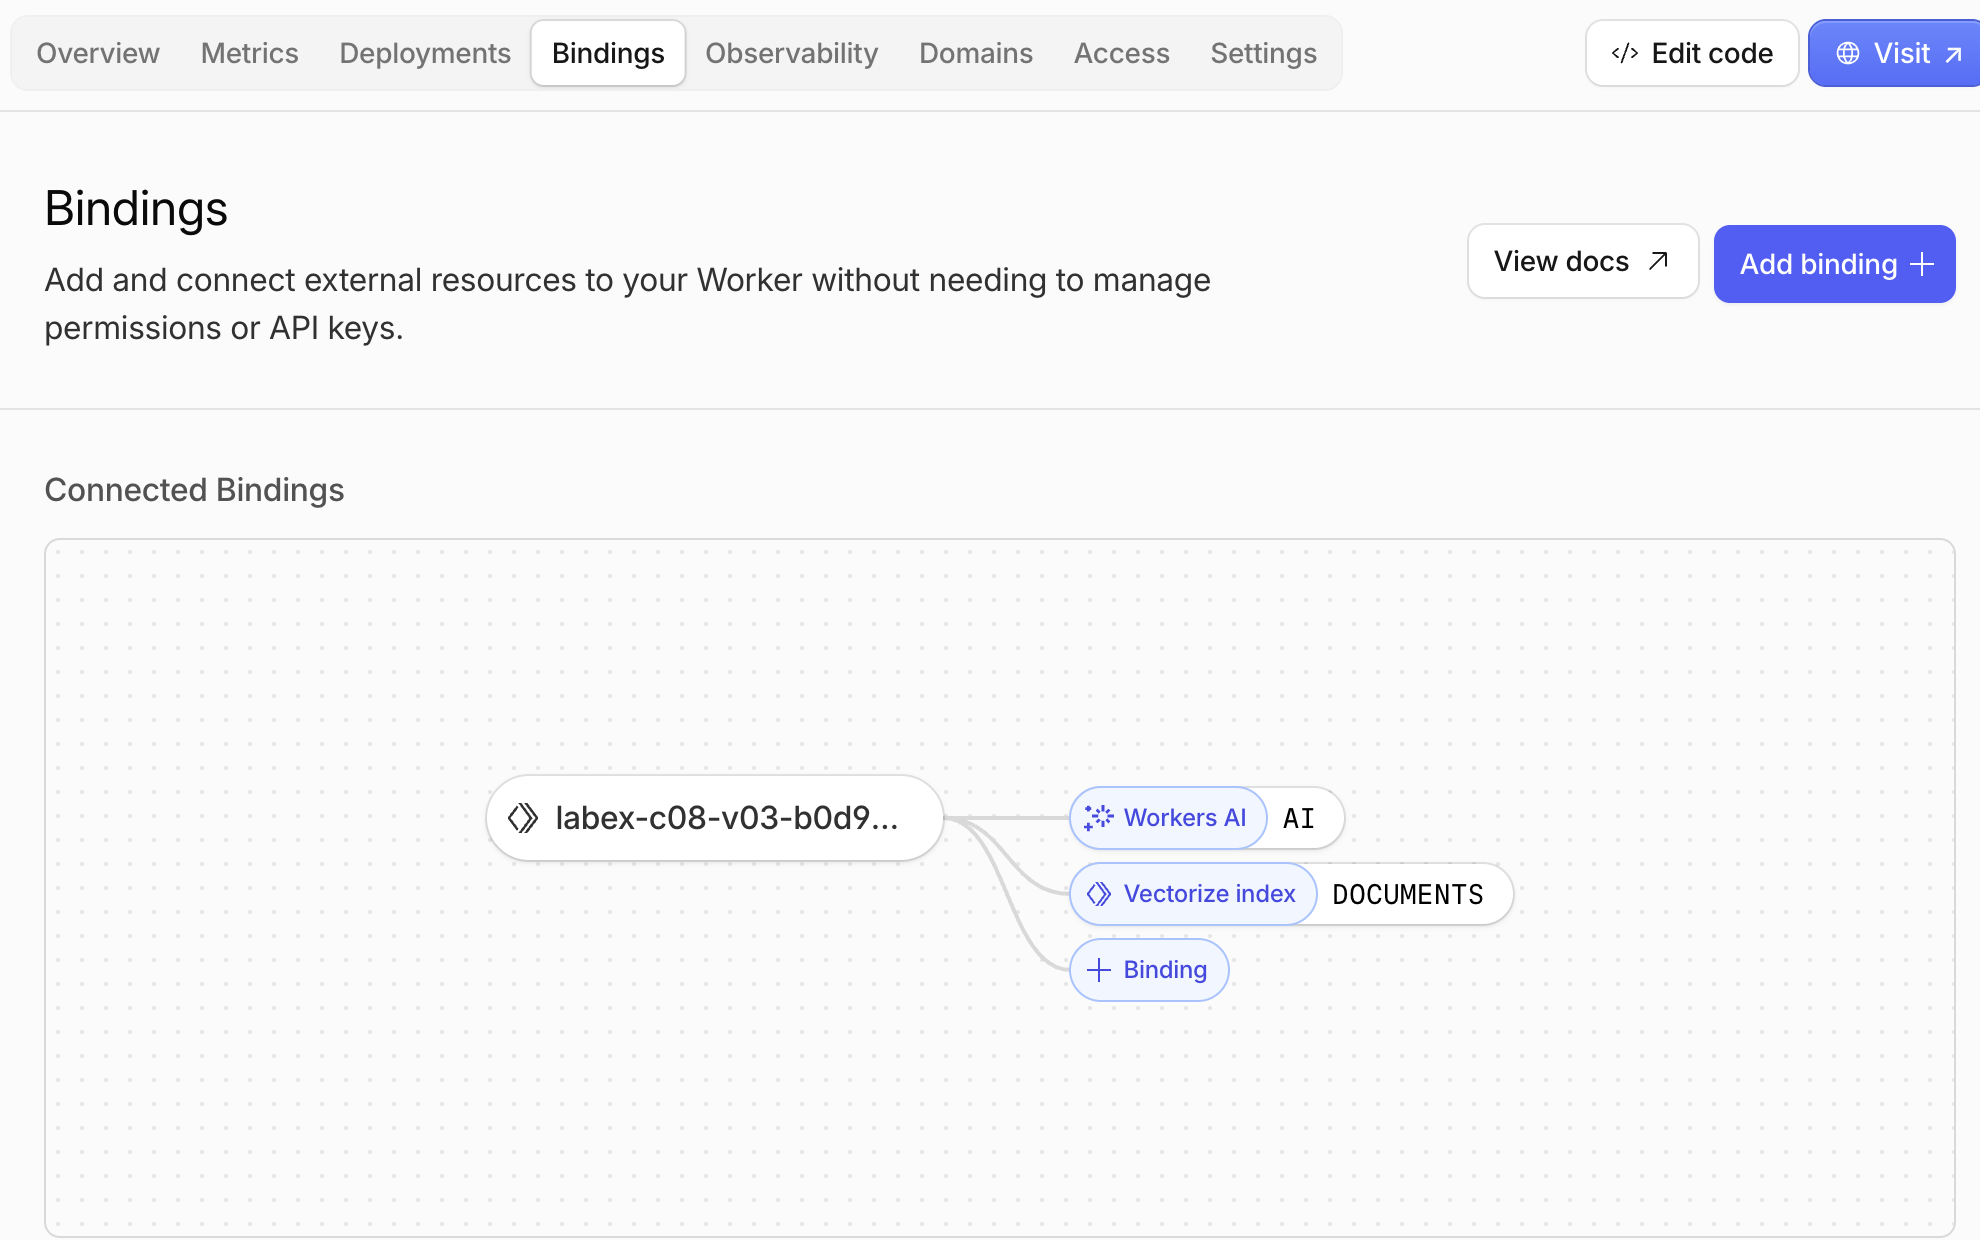
두 개의 Cloudflare 바인딩을 사용하는 일회성 Worker 를 구축합니다. AI는 짧은 텍스트를 Cloudflare 에서 호스팅하는 @cf/baai/bge-small-en-v1.5 임베딩 모델로 보냅니다. DOCUMENTS는 일회성 Vectorize 인덱스 하나에 데이터를 쓰고 쿼리합니다. Worker 는 세 개의 예시 도움말 문서에 대한 고정된 /seed 작업과 쿼리, topK, 선택적 최소 점수를 받는 /search 작업을 제공합니다. topK는“가장 가까운 후보를 최대 몇 개 반환할지”를 의미하며, “이 후보들이 반드시 관련 있다”는 의미는 아닙니다.
이 실습은 세 번째 Vectorize 실습입니다. 바로 시작했다면 먼저 Connect LabEx to Your Cloudflare Account를 완료한 다음, V01 과 V02 를 완료하여 인덱스 호환성, 안정적인 ID, 비동기 변경 작업에 익숙해지세요.
Vectorize 와 Workers AI 에는 모두 무료 할당량이 있습니다. 이 실습에서는 작은 벡터 세 개를 저장하고 짧은 임베딩 요청 몇 번만 실행합니다. Workers Paid 는 필요하지 않습니다. 로컬 추론이나 배포된 추론 모두 공유 Workers AI 일일 할당량을 사용하므로, 모델이나 무료 할당량을 사용할 수 없을 때는 반복해서 재시도하지 말고 중지하세요.
설정 과정에서 /home/labex/project/vector-search에 Node.js 22.22.0 과 프로젝트 로컬 Wrangler 4.132.0 을 설치합니다. 결정적 테스트와 독립적인 검사를 제공하지만, Wrangler 인증, 모델 호출, 인덱스 생성, Worker 배포 또는 클라우드 데이터 시드를 자동으로 수행하지는 않습니다.
검색 리소스 인증 및 이름 지정
이 단계에서는 새 VM 을 인증하고 Worker 와 연결된 Vectorize 인덱스의 이름을 지정하는 설정을 하나 만듭니다.
준비된 프로젝트 디렉터리로 이동한 다음 고정된 CLI 버전을 확인합니다.
cd /home/labex/project/vector-search
npx wrangler --version
4.132.0이 출력되어야 합니다. Wrangler 는 디바이스 플로를 사용하므로 비밀번호가 VM 에 입력되지 않습니다. 이 일회성 실습에 사용할 계정 ID, Worker, Vectorize 및 Workers AI 에 대한 액세스를 요청합니다.
Wrangler 는 인덱스 작업과 스크립트 배포 및 정리 검사를 분리합니다. Vectorize 에는 workers:write, Worker 에는 workers_scripts:write, Wrangler 의 종속성 안전 삭제 검사에는 workers_kv:write, 모델 바인딩에는 ai:write를 요청합니다.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
loggedIn: true와 사용할 학습 계정이 맞는지 확인합니다. 임의의 접미사를 하나 생성한 뒤, 이 접미사에서 두 리소스 이름을 만들어 정리 과정에서 관련 없는 리소스와 혼동하지 않도록 합니다.
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
YOUR_ACCOUNT_ID를 선택한 계정의 실제 ID 로 바꿉니다. **바인딩 (binding)**은 Worker 코드가 관리형 Cloudflare 서비스에 접근할 때 사용하는 이름입니다. AI는 모델 추론을 제공하고, DOCUMENTS는 index_name에 지정한 정확한 Vectorize 인덱스를 제공합니다.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
이 설정은 리소스 이름만 지정하며 리소스를 생성하지는 않습니다. 이렇게 분리하면 계정의 어떤 항목도 변경하기 전에 리소스 소유 경계를 확인할 수 있습니다.
바인딩된 검색 Worker 구축
이 단계에서는 코드를 배포하기 전에 고정된 문서 시드 작업과 학습자가 사용하는 검색 엔드포인트를 구현합니다.
세 개의 원본 문서는 애플리케이션 코드에 둡니다. Vectorize 는 벡터와 메타데이터를 저장하지만, 전체 문서 시스템의 원본 데이터는 저장하지 않기 때문입니다. /seed는 이 고정된 문서 모음을 한 번 임베딩합니다. /search는 검증된 쿼리 하나를 임베딩하고, 가장 가까운 topK 후보를 Vectorize 에 요청한 다음 minScore를 적용합니다. 반환된 메타데이터를 사용하면 애플리케이션이 벡터 ID 를 유용한 문서 정보로 변환할 수 있습니다.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
결정적 테스트를 실행합니다. 두 바인딩을 작은 메모리 내 픽스처로 대체하므로 AI 나 Vectorize 할당량을 사용하지 않고 검증 및 제어 흐름을 확인합니다.
node --test test/worker.test.mjs
테스트 다섯 개가 모두 통과해야 합니다. 그런 다음 바인딩 타입을 생성하고, 배포하지 않은 상태로 Wrangler 에 Worker 번들을 생성하도록 요청합니다.
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
생성된 타입 파일에 AI: Ai와 DOCUMENTS: VectorizeIndex가 모두 포함되어야 합니다. 드라이 런은 모듈과 설정을 함께 번들링할 수 있다는 것을 보여주지만, 클라우드 서비스가 실제로 존재한다는 뜻은 아닙니다.
인덱스 생성 및 두 바인딩 배포
이 단계에서는 호환되는 빈 인덱스를 생성한 다음, 두 관리형 바인딩을 받는 Worker 를 배포합니다.
임베딩 모델은 384 개의 숫자를 반환합니다. 코사인 거리는 벡터의 방향을 비교하므로, 동일한 변경 불가 계약으로 인덱스를 하나 생성합니다.
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Cloudflare 가 설정된 DOCUMENTS 바인딩을 실제 리소스에 연결할 수 있도록 인덱스가 생성된 후에만 Worker 를 배포합니다.
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
Wrangler 가 두 바인딩을 나열하고 workers.dev URL 을 출력해야 합니다. 추측으로 서브도메인을 조합하지 말고 정확한 URL 을 저장합니다.
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
이 시점에서 인덱스는 의도적으로 비어 있습니다. 배포는 서비스를 연결할 뿐, 문서를 자동으로 임베딩하거나 시드하지는 않습니다.
실시간 문서 임베딩 시드
이 단계에서는 고정된 /seed 작업을 한 번 호출하고, 변경 작업을 기록한 다음 세 문서의 모델 임베딩을 모두 읽을 수 있을 때까지 기다립니다.
Worker 는 세 개의 짧은 문서 텍스트를 하나의 배치로 BGE Small 에 보냅니다. 반환된 형태를 검증하고, 안정적인 ID 와 유용한 메타데이터를 추가한 후 레코드를 upsert 합니다. 문서 모음은 서버가 제어하므로 빈 JSON 객체와 함께 호출합니다.
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
count: 3, 384 개 차원, cls 풀링, 변경 작업 UUID 가 포함된 HTTP 202 응답 데이터가 반환되어야 합니다. 승인된 변경 작업은 비동기이므로, 이전 실습에서 사용한 것과 동일한 제한된 안정성 검사를 생성합니다. execFileSync는 고정된 Wrangler 프로세스를 실행하고, readFileSync는 저장된 시드 응답을 읽습니다. 두 함수는 서로 다른 Node.js 내장 모듈에서 제공합니다.
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
일치하는 읽기 결과를 세 번 확인하면 잠시 오래된 복제본이 표시되는 문제로부터 최종 결과를 보호할 수 있습니다. 대기 스크립트가 성공한 후 안정적인 애플리케이션 ID 를 나열합니다.
npx wrangler vectorize list-vectors "$INDEX" --count=10
목록에 password-reset, upload-pdf, billing-receipt가 포함되어야 합니다. 각 ID 의 실제 값은 V01 과 V02 에서 사용한 결정적 학습용 벡터가 아니라, 실시간 Cloudflare 호스팅 모델에서 생성되었습니다.
유사한 문서 검색 및 해석
이 단계에서는 강한 관련성이 있는 비밀번호 질문을 보내고, 가장 가까운 후보 두 개를 확인한 다음 순위와 명시적인 빈 결과를 구분합니다.
topK: 2를 요청합니다. Vectorize 는 작은 인덱스 전체를 확인할 수 있지만, 가장 가까운 후보를 최대 두 개만 반환합니다. 쿼리와 문서의 정확한 표현은 달라도 의미가 강하게 일치하므로 첫 번째 결과는 비밀번호 문서여야 합니다.
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
점수가 높은 순서로 정렬된 두 행이 표시되고, 첫 번째 행은 password-reset이어야 합니다. 점수는 비교 기준으로 읽습니다. 호환되는 쿼리와 인덱스에서 값이 클수록 더 가까운 결과이지만, 0.8이“정확도 80%”를 의미하지는 않습니다. 또한 topK는 관련성 임계값을 적용하지 않습니다.
이제 관련 없는 질문을 보내고 minScore: 1을 설정합니다. Vectorize 는 여전히 세 후보를 애플리케이션에 반환하지만, 애플리케이션은 임계값보다 낮은 후보를 모두 제거합니다.
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
candidateCount: 3과 matches: []가 반환되어야 합니다. 빈 일치 목록은 애플리케이션이 명시적으로 결정한 결과이며, 인덱스에 벡터가 없다는 뜻은 아닙니다.
마지막으로 빈 입력을 보냅니다.
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
HTTP 400 과 query_required가 반환되어야 합니다. 모델이나 데이터베이스를 호출하기 전에 입력을 검증하므로, 잘못된 입력은 추론 용량이나 쿼리 용량을 사용하지 않습니다.
Workers & Pages → labex-c08-v03-... Worker → Bindings를 엽니다. 바인딩은 Worker 코드가 다른 Cloudflare 서비스에 접근할 때 사용하는 안전한 이름입니다. 여기서 AI는 env.AI가 임베딩 모델을 실행할 때 사용하는 이름이고, DOCUMENTS는 env.DOCUMENTS가 이 정확한 Vectorize 인덱스를 쿼리할 때 사용하는 이름입니다.
그런 다음 AI → Vectorize → 해당하는 -docs 인덱스를 엽니다. 요약에 현재 벡터 세 개가 표시되어야 합니다. 시드한 도움말 문서마다 하나씩 있습니다. 성공한 검색을 수행할 때마다 쿼리가 하나씩 추가되므로, 반복 확인을 포함하면 쿼리 총계는 예시와 다를 수 있습니다.
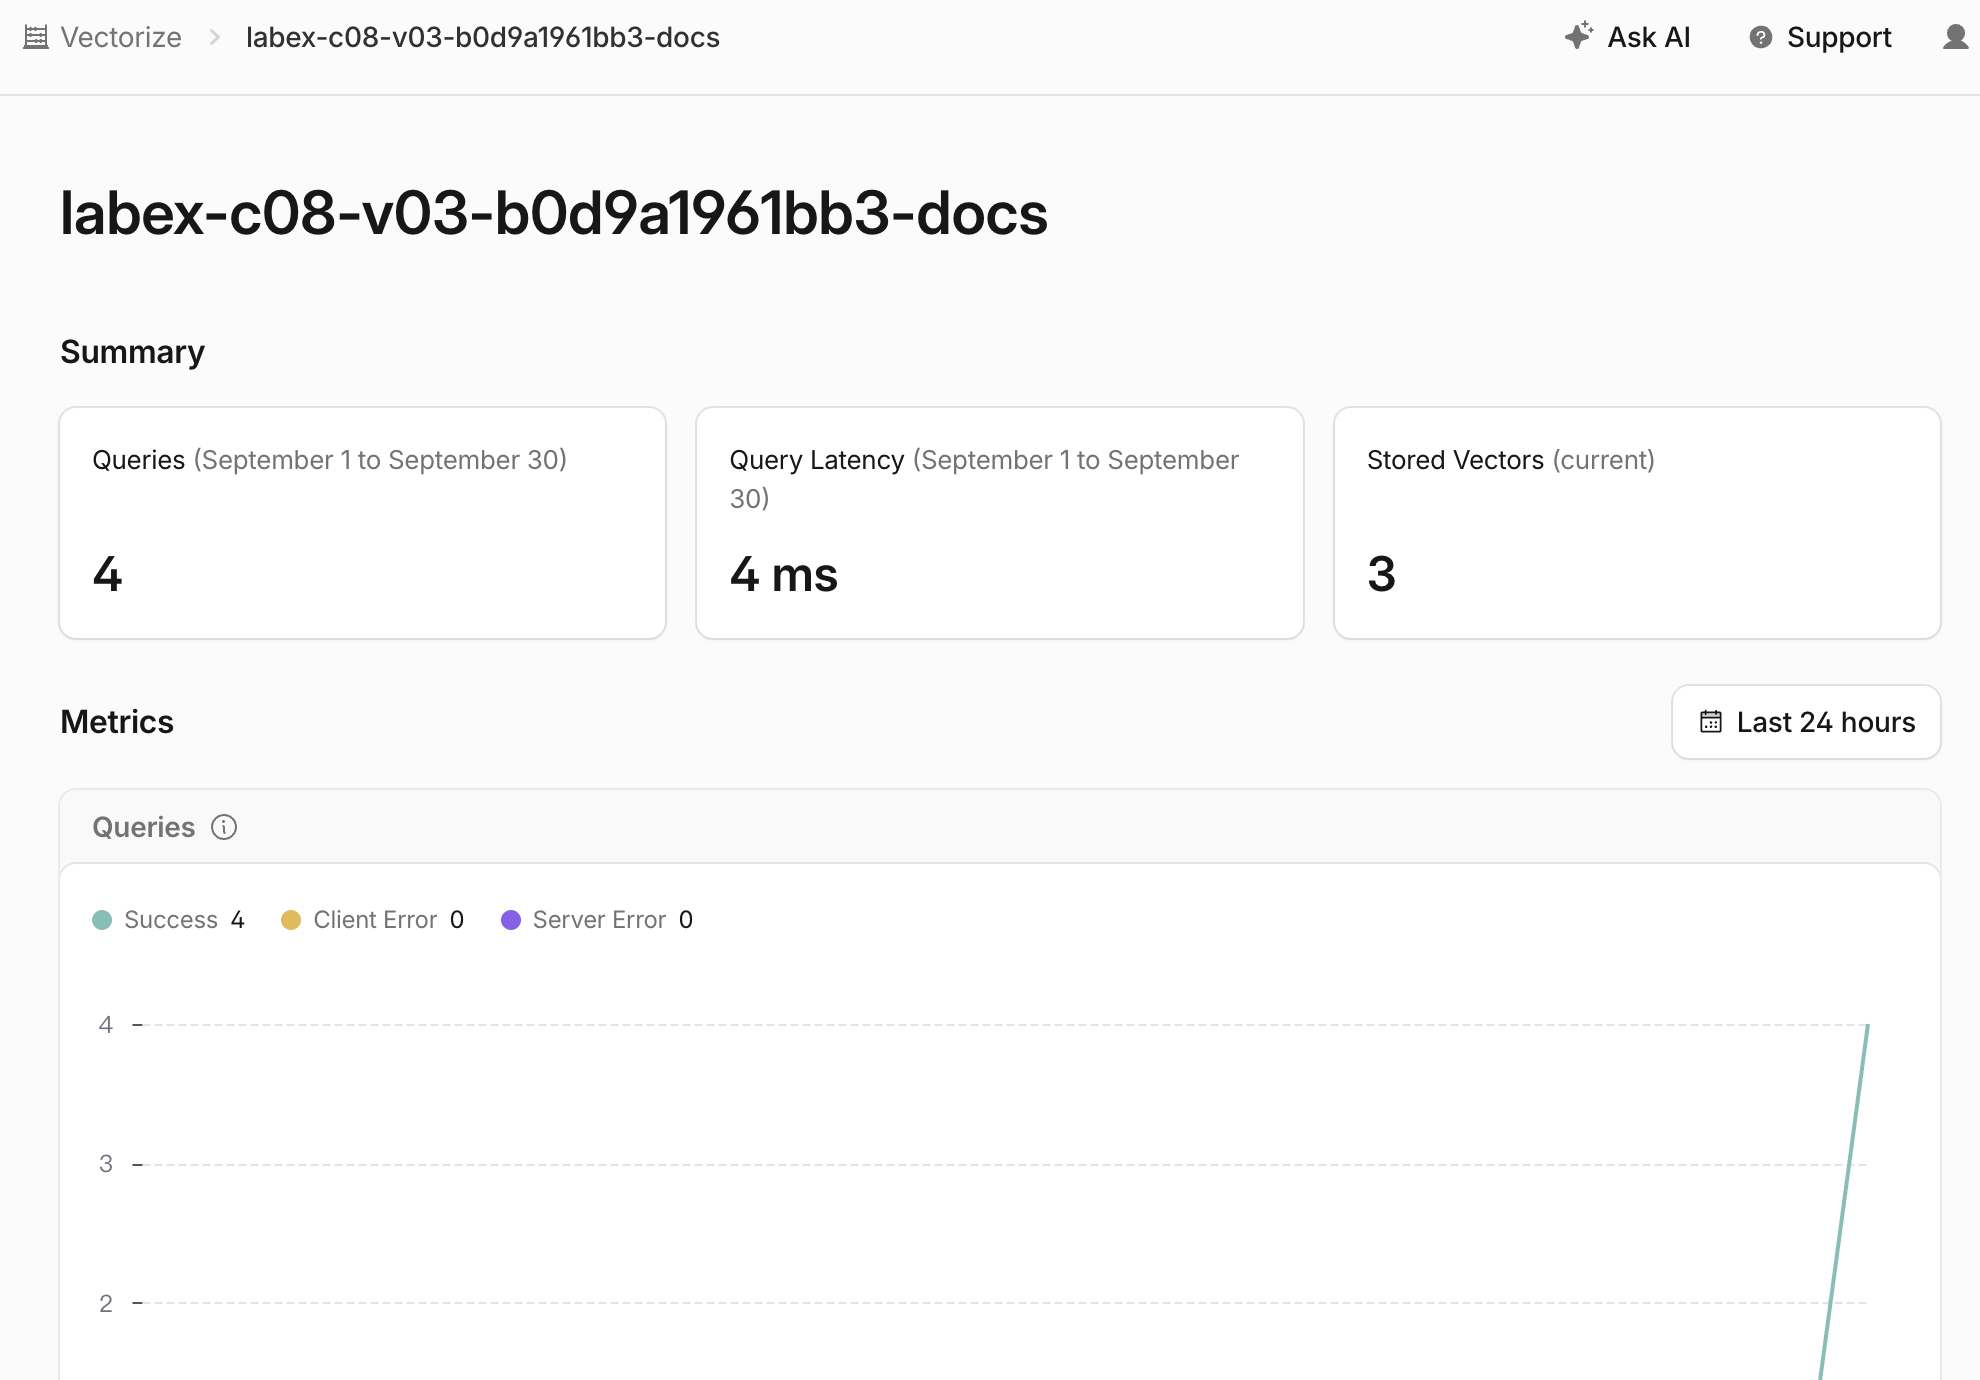
Metrics까지 스크롤합니다. P50, P75, P95는 지연 시간 백분위수입니다. 예를 들어 P95 는 성공한 쿼리의 95% 가 해당 시간 이내에 완료되었다는 뜻입니다. 이 수치는 일치 결과의 관련성이 아니라 속도를 나타냅니다. 문서를 추가하거나 삭제하지 않고 검색만 수행하는 동안에는 Stored Vectors 차트가 세 개를 유지해야 합니다.
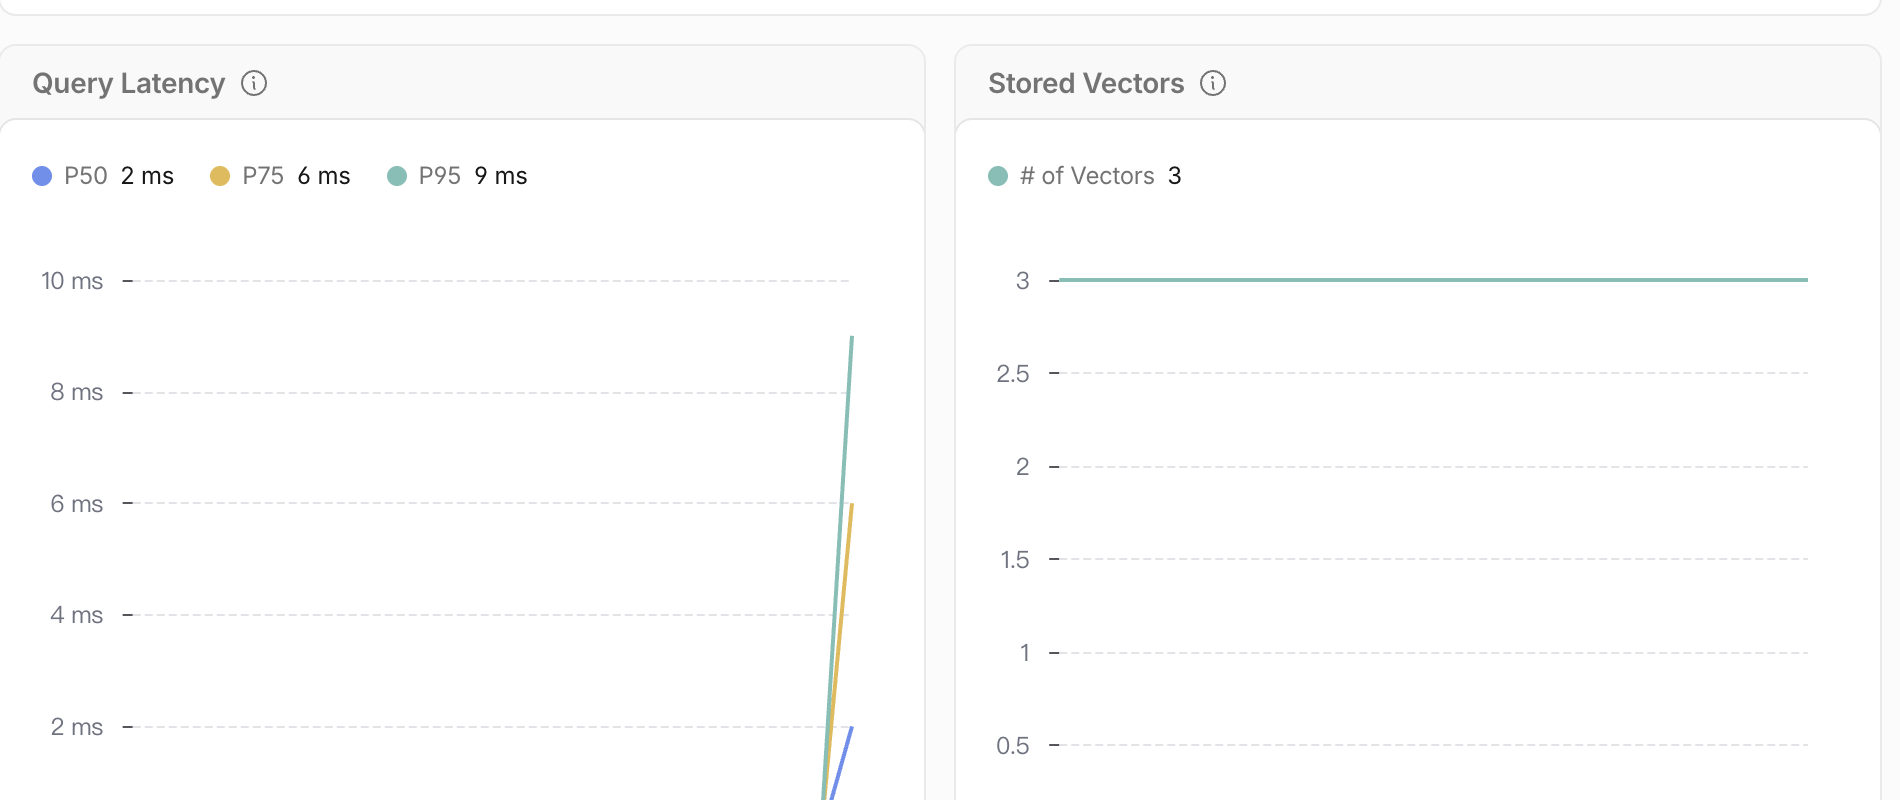
Dashboard 의 카운터는 터미널보다 몇 초 늦게 반영될 수 있습니다. API 응답, 반환된 ID, 독립적인 검사를 권위 있는 결과로 사용하세요. Dashboard 는 이러한 결과를 확인하고 조작할 수 있는 리소스와 연결해 확인하는 용도로 사용합니다.
검색 Worker 및 인덱스 삭제
이 단계에서는 두 개의 일회성 클라우드 리소스를 삭제하고, Wrangler 인증이 유지되는 동안 해당 리소스가 사라졌음을 확인합니다. 로그아웃은 별도의 마지막 단계에서 수행합니다. 정리 검사에는 Cloudflare 읽기 권한이 필요하기 때문입니다.
먼저 wrangler.jsonc에서 정확한 이름을 다시 가져옵니다. 새 터미널을 열어 이전에 사용한 RUN과 INDEX 변수가 더 이상 존재하지 않더라도 안전하게 정리할 수 있습니다.
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
삭제하기 전에 두 값이 고유한 labex-c08-v03-... 접두사로 시작하는지 확인합니다.
먼저 Worker 를 삭제하여 배포된 코드가 인덱스에 대한 바인딩을 더 이상 유지하지 않도록 합니다.
npx wrangler delete --name "$RUN" --force
연결된 인덱스만 삭제한 다음, 정리 평가에 사용할 인증된 인벤토리를 저장합니다.
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
로그아웃하기 전에 지금 이 단계를 완료합니다. 평가 시스템은 Cloudflare 를 독립적으로 확인하며, 인증 실패나 네트워크 오류를 삭제의 증거로 인정하지 않습니다.
학습 VM 에서 로그아웃
이 단계에서는 이 VM 의 임시 Wrangler 인증을 제거합니다. 클라우드 리소스는 이미 삭제되었고 인증된 정리 검사가 통과했으므로 이제 안전하게 로그아웃할 수 있습니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn: false가 반환되어야 합니다. Cloudflare Dashboard 브라우저 세션은 별개이며 학습 계정에서 계속 사용할 수 있습니다.
요약
저장된 문서 임베딩과 실시간 쿼리 임베딩에 동일한 모델 계약을 사용하는 Worker 를 구축하고, 안정적인 ID 세 개를 Vectorize 에 시드한 다음 실제 비동기 변경 작업이 완료될 때까지 기다렸습니다. topK로 후보 수를 제한하고, 점수를 상대적인 순위 신호로 해석했으며, 원시 벡터 대신 메타데이터를 반환하고 애플리케이션 임계값 적용 후 명시적인 빈 결과를 생성했습니다. 마지막으로 Dashboard 에서 두 클라우드 바인딩을 확인하고, 인증이 유지되는 동안 일회성 Worker 와 인덱스를 삭제한 다음 VM 에서 로그아웃했습니다.
V04 에서는 서버가 제어하는 고객 네임스페이스와 메타데이터 필터를 추가합니다. 이를 통해 의미적으로 유사한 레코드라도 인증된 검색 범위에 속한 경우에만 반환할 수 있습니다.