소개
앞선 Workers AI 임베딩 실습에서는 텍스트가 임베딩으로 변환되었습니다. 임베딩은 의미 사이의 유용한 관계를 담은 숫자의 순서 있는 목록입니다. 임베딩은 원본 문서도 아니고 생성된 답변도 아닙니다. 애플리케이션이 임베딩을 안정적인 문서 ID 와 함께 저장하고 나중에 가까운 벡터를 찾을 수 있을 때 검색에 유용해집니다.
Cloudflare Vectorize는 벡터 데이터베이스입니다. 행과 열을 중심으로 설계된 테이블과 달리, 벡터 인덱스는 숫자 벡터를 효율적으로 비교하도록 설계됩니다. 인덱스를 생성할 때마다 다음 두 가지 호환성 조건이 고정됩니다.
- dimensions — 모든 벡터에 포함되는 숫자의 개수입니다.
- distance metric — Vectorize 가 어떤 벡터를 가장 가까운 것으로 판단할지 결정하는 기준입니다.
Cloudflare 에서 호스팅하는 @cf/baai/bge-small-en-v1.5 임베딩에 맞는 384 차원 인덱스를 생성하고, A04 에서 소개한 방향 기반 비교와 같은 코사인 거리를 선택합니다. category와 published에 메타데이터 인덱스를 추가하고, 작은 합성 도움말 문서 벡터 3 개를 삽입합니다. 그런 다음 비동기 변경 사항을 읽을 수 있을 때까지 기다리고, 3 차원 벡터가 거부되는지 확인합니다.
이 실습은 Vectorize 과정의 첫 번째 실습입니다. 바로 이 실습에 들어왔다면 먼저 Connect LabEx to Your Cloudflare Account를 완료합니다. 그러면 LabEx VM 터미널 사용법, Wrangler 인증 방법, 학습 계정 확인 방법 및 계정 ID 설정 방법을 알 수 있습니다. 벡터, 차원 또는 코사인 유사성이 익숙하지 않다면 먼저 Workers AI A04 를 완료합니다.
Vectorize 는 Workers Free 에서 사용할 수 있습니다. 현재 기본 제공 한도는 이 실습에서 사용하는 384 차원 벡터 3 개와 읽기 전용 확인 작업보다 훨씬 크므로 Workers Paid 는 필요하지 않습니다. 이 실습에서는 Workers AI 를 호출하지 않으며 Neurons 도 사용하지 않습니다.
설정 과정에서는 /home/labex/project/document-vector-index에 Node.js 22.22.0 과 프로젝트 로컬 Wrangler 4.132.0 을 설치합니다. 독립적인 읽기 전용 확인 명령도 제공합니다. 설정 과정에서는 Wrangler 인증, 인덱스 생성, 벡터 쓰기 또는 Cloudflare 계정 수정 작업을 수행하지 않습니다.
VM 인증 및 인덱스 이름 지정
이 단계에서는 새 VM 을 인증하고, 사용할 학습 계정을 선택한 다음, 삭제할 임시 인덱스에 고유한 이름을 지정합니다.
Cloudflare Dashboard 로그인은 브라우저에 연결되어 있습니다. 새 VM 의 Wrangler 는 별도의 클라이언트이므로 Vectorize 리소스를 관리하기 전에 제한된 인증이 필요합니다.
준비된 프로젝트 디렉터리로 이동하고 고정된 CLI 버전을 확인합니다.
cd /home/labex/project/document-vector-index
npx wrangler --version
4.132.0이 표시되어야 합니다. 계정 ID 확인과 Workers 리소스 관리를 요청합니다. 이 Wrangler 버전에서는 workers:write OAuth 범위에 여기서 사용하는 Vectorize 관리 작업이 포함됩니다. 이 실습에서는 추론을 수행하지 않으므로 AI 범위는 요청하지 않습니다.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
표시된 링크를 열고 현재 코드를 입력합니다. 계정과 권한을 확인한 후 학습 계정을 인증합니다. 그런 다음 구조화된 ID 데이터를 확인합니다.
npx wrangler whoami --json
loggedIn: true인지 확인하고 사용할 학습 계정을 식별합니다. 삭제할 임시 인덱스에 사용할 고유한 이름을 생성합니다.
RUN="labex-c08-v01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
YOUR_ACCOUNT_ID를 해당 계정의 실제 ID 로 바꿉니다.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
이 바인딩은 다음 실습에서 Worker 코드가 사용할 관계를 기록합니다. DOCUMENTS는 애플리케이션에서 사용하는 이름이고, index_name은 소유한 클라우드 리소스 이름입니다. remote: true는 로컬 Worker 가 격리된 로컬 시뮬레이션이 아니라 실제 원격 인덱스에 연결된다는 뜻입니다.
인덱스와 필터링 가능한 필드 생성
이 단계에서는 고정된 벡터 계약을 생성하고 나중에 필터링할 두 개의 메타데이터 필드를 준비합니다.
인덱스의 차원과 거리 메트릭은 모든 비교가 동일한 숫자 계약을 따라야 하므로 생성 후 변경할 수 없습니다. BGE Small 은 384 개의 숫자를 생성합니다. 코사인 거리는 벡터의 방향을 비교하므로 A04 에서 사용한 의미 중심 임베딩에 적합합니다.
V2 인덱스를 생성합니다.
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
벡터에는 문서 카테고리와 같은 작은 메타데이터를 함께 저장할 수 있습니다. 메타데이터를 저장한다고 해서 자동으로 필터링할 수 있는 것은 아닙니다. 메타데이터 인덱스는 Vectorize 에 필터에서 사용할 필드를 준비하도록 지시합니다. 벡터를 삽입하기 전에 다음 필드를 생성합니다.
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=category --type=string | tee .labex/category-index-output.txt
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=published --type=boolean | tee .labex/published-index-output.txt
--update-config=false는 이미 작성한 바인딩을 Wrangler 가 교체하도록 제안하지 못하게 합니다. 메타데이터 인덱스 생성은 비동기 작업입니다. 각 명령은 변경 작업을 대기열에 추가하므로 성공 메시지는 Cloudflare 가 변경을 수락했다는 뜻이지, 모든 읽기 작업에서 즉시 변경 사항이 보인다는 뜻은 아닙니다.
재사용 가능한 대기 스크립트를 생성합니다. 이 스크립트는 읽기 전용 vectorize info 명령만 실행하고, 정확한 변경 ID 를 비교하며, 결과를 신뢰하기 전에 일치하는 읽기가 3 회 연속 발생해야 통과시킵니다. 이렇게 추가로 확인하면 잠시 오래된 읽기 복제본을 최종 상태로 표시하는 일을 방지할 수 있습니다. 대기 스크립트는 무한히 기다리지 않고 4 분 후 오류로 종료됩니다.
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS

METADATA_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/published-index-output.txt | tail -n 1)
test -n "$METADATA_MUTATION_ID"
node scripts/wait-for-vectorize.mjs "$RUN" "$METADATA_MUTATION_ID" 0
npx wrangler vectorize get "$RUN"
npx wrangler vectorize list-metadata-index "$RUN"
최종 표에는 384 차원, 코사인 거리, category는 String, published는 Bool로 표시되어야 합니다. Bool은 --type=boolean으로 생성한 필드의 현재 API 표시 이름입니다. 두 번째 메타데이터 변경이 완료될 때까지 기다리면 다음 벡터 삽입이 아직 준비되지 않은 인덱스 작업 뒤에서 대기하는 일을 방지할 수 있습니다.
식별된 문서 벡터 생성
이 단계에서는 ID 와 메타데이터를 독립적으로 확인할 수 있는 작고 투명한 벡터 테스트 데이터를 생성합니다.
벡터 데이터베이스는 원본 문서를 대신하지 않습니다. 각 벡터에는 애플리케이션이 실제 콘텐츠로 다시 매핑할 수 있는 안정적인 ID 가 필요합니다. 이 실습에서는 합성 도움말 문서 ID 3 개를 사용하고, 해당 문서의 카테고리, 게시 상태, 임베딩 모델 및 풀링 방식을 메타데이터로 기록합니다.
실제 임베딩은 V03 에서 사용합니다. 여기서는 결정적인 벡터를 사용하므로 저장 동작을 반복해서 확인할 수 있고 비용도 발생하지 않습니다. 각 문서는 서로 다른 축을 가리키며, 384 개 위치에 도달할 때까지 나머지는 0 으로 채웁니다.
투명한 테스트 데이터 생성기를 만듭니다.
cat > scripts/create-vectors.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const documents = [
  { id: "password-reset", axis: 0, category: "account" },
  { id: "upload-pdf", axis: 1, category: "files" },
  { id: "billing-receipt", axis: 2, category: "billing" }
];

function unitVector(axis) {
  const values = Array(DIMENSIONS).fill(0);
  values[axis] = 1;
  return values;
}

const rows = documents.map((document) => ({
  id: document.id,
  values: unitVector(document.axis),
  metadata: {
    category: document.category,
    published: true,
    model: MODEL,
    pooling: POOLING
  }
}));

writeFileSync("vectors/documents.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`wrote ${rows.length} vectors with ${DIMENSIONS} dimensions each`);
JS
node scripts/create-vectors.mjs
NDJSON는 줄바꿈으로 구분된 JSON(Newline-Delimited JSON) 을 뜻합니다. 하나의 JSON 배열로 감싸는 대신, 각 줄에 완전한 벡터 객체 하나를 기록합니다. Wrangler 는 이 형식을 배치 단위로 스트리밍할 수 있습니다. 숫자 1,152 개를 모두 출력하지 않고 ID 와 구조를 확인합니다.
node - <<'JS'
const rows = require("fs").readFileSync("vectors/documents.ndjson", "utf8").trim().split("\n").map(JSON.parse);
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
세 행 모두 384 차원으로 표시되어야 합니다. 모델과 cls 풀링 메타데이터는 호환성을 기록할 뿐입니다. Vectorize 가 그 의미를 대신 추론하거나 검증하지는 않습니다.
벡터 삽입 및 변경 사항 대기
이 단계에서는 벡터 3 개를 한 번에 삽입하고, 해당 비동기 변경 사항이 읽기 작업에 표시될 때까지 기다립니다.
Vectorize 의 쓰기 작업은 비동기로 처리됩니다. 삽입 요청은 먼저 내구성 있는 쓰기 선행 로그에 기록되고 변경 ID를 반환합니다. 그런 다음 백그라운드 처리가 진행되어 해당 변경 사항이 읽기 작업에 표시됩니다. 이 구조에서는 쓰기 작업을 효율적으로 처리할 수 있지만, “수락됨”과“읽을 수 있음”은 서로 다른 시점입니다.
벡터 3 개를 배치로 삽입하고 전체 결과를 저장합니다. pipefail을 설정하면 뒤의 tee 명령이 성공하더라도 Wrangler 실패가 숨겨지지 않습니다.
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/documents.ndjson 2>&1 | tee .labex/insert-output.txt
Wrangler 가 벡터 3 개를 대기열에 추가했다고 알리고 변경 식별자를 출력한 후에만 다음 단계로 진행합니다. API 가 인증 오류나 네트워크 오류를 반환하면 결과를 확정할 수 없습니다. npx wrangler whoami --json으로 인증 상태를 확인한 다음 이 삽입 블록을 한 번 다시 실행합니다. 실제 변경 ID 없이 대기 스크립트를 시작하지 마세요.
승인된 변경 ID 를 추출하고, 변경 ID 가 있을 때만 기다립니다.
MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/insert-output.txt | tail -n 1)
if [ -z "$MUTATION_ID" ]; then
  printf '%s\n' 'No mutation ID was returned; fix the insert error before waiting.' >&2
else
  printf 'Waiting for mutation %s\n' "$MUTATION_ID"
  node scripts/wait-for-vectorize.mjs "$RUN" "$MUTATION_ID" 3
fi
대기 스크립트의 최종 JSON 에는 vectorCount가 3 이고 기록된 변경 ID 가 표시되어야 합니다. 일치하는 읽기가 3 회 필요하므로 짧은 복제 지연이 있어도 학습자에게 표시되는 결과가 안정적입니다. 제한된 폴링은 고정된 시간 동안 무조건 기다리는 것보다 안전합니다. 변경이 빠르게 완료되면 즉시 끝나고, 정상적으로 처리 중인 변경이 느리면 중복 쓰기 없이 충분히 기다립니다.
문서 읽기 및 호환성 테스트
이 단계에서는 수락된 레코드를 읽고, 호환되지 않는 쓰기 작업이 거부되는지 확인한 다음 CLI 상태를 Dashboard 와 연결합니다.
애플리케이션 ID 로 저장된 레코드를 읽습니다.
전체 레코드를 저장한 후, 숫자 1,152 개로 터미널을 가득 채우지 않도록 요약 표를 출력합니다.
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/stored-vectors.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/stored-vectors.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
각 요약 행에는 ID, 384 개 값의 구조 및 메타데이터가 유지되어야 합니다. 원시 파일에는 독립적으로 확인할 수 있는 전체 값이 들어 있습니다. get-vectors는 알려진 레코드를 읽는 명령이며 유사성 검색은 아닙니다. 유사성 쿼리는 V03 에서 다룹니다.
이제 값이 3 개뿐인 호환되지 않는 레코드를 의도적으로 하나 생성합니다.
cat > vectors/incompatible.ndjson <<'NDJSON'
{"id":"wrong-dimensions","values":[1,0,0],"metadata":{"category":"account","published":true}}
NDJSON
if npx wrangler vectorize insert "$RUN" --file=vectors/incompatible.ndjson > .labex/incompatible.log 2>&1; then
  STATUS=0
else
  STATUS=$?
fi
printf '%s\n' "$STATUS" > .labex/incompatible-exit.txt
sed -n '/invalid vector/p' .labex/incompatible.log
test "$STATUS" -ne 0
이 거부 동작은 인덱스 계약을 보호합니다. 3 개 위치로 구성된 벡터는 384 개 위치로 구성된 벡터와 의미 있게 비교할 수 없습니다. 기존 레코드는 유지되고 거부된 ID 는 나타나지 않는지 확인합니다.
npx wrangler vectorize info "$RUN"
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids wrong-dimensions
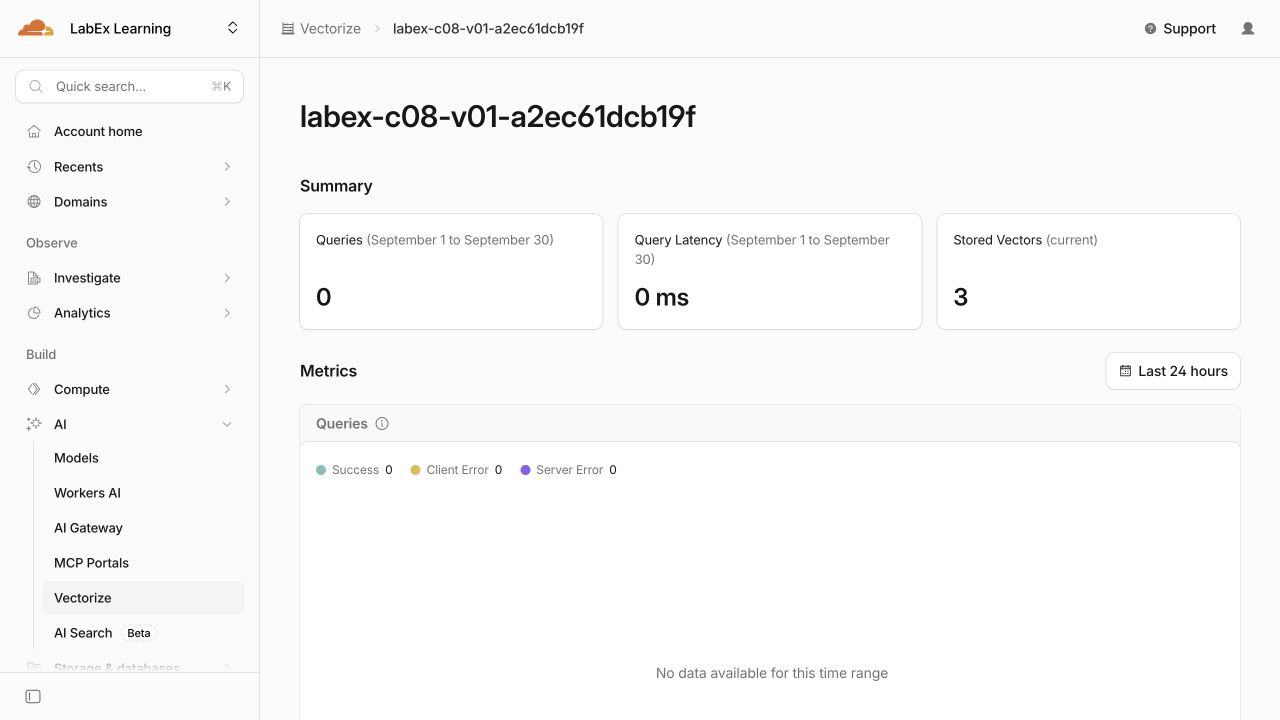
선택한 계정의 Cloudflare Dashboard 를 열고 AI → Vectorize로 이동합니다. 인벤토리에서 CLI 이름과 실제 인덱스가 연결되어 있는지 확인할 수 있습니다. 또한 384 차원, 코사인 거리 및 이 작은 예제에서 청구 가능한 사용량 없이 총 벡터 3 개가 표시됩니다.
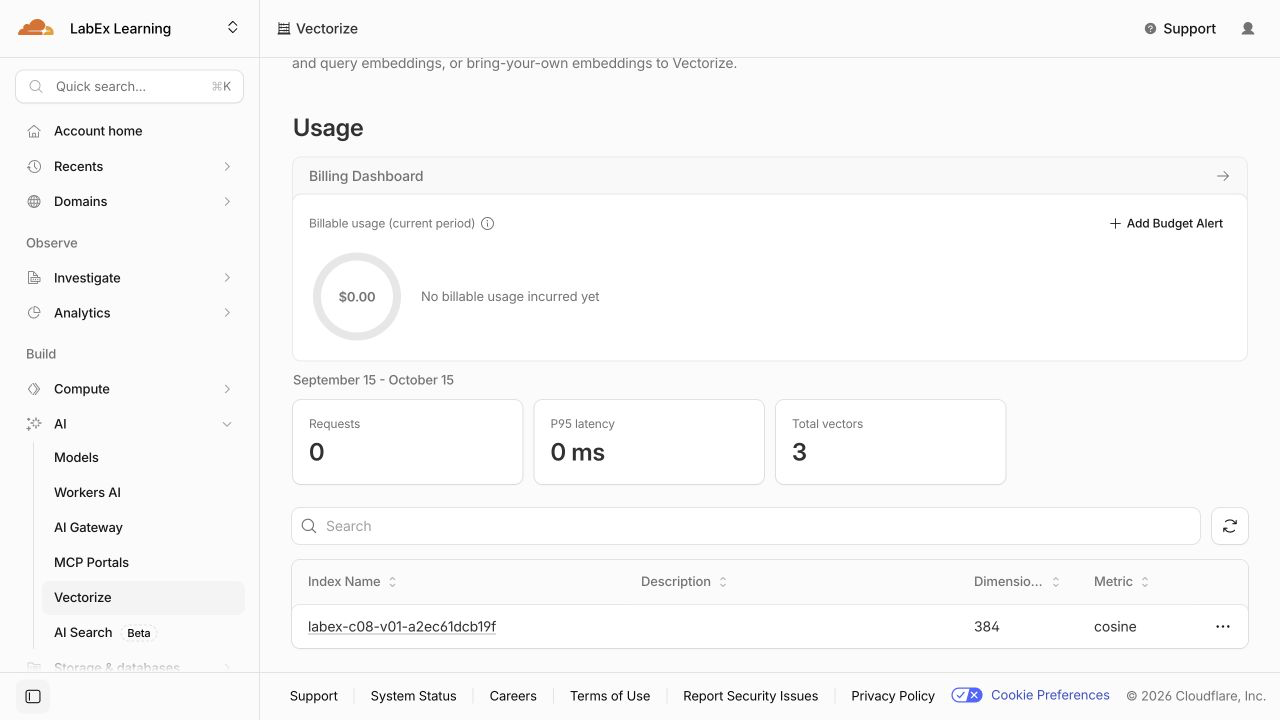
$RUN에 저장된 이름의 인덱스를 엽니다. 요약에는 현재 저장된 벡터 3 개가 표시됩니다. 이 첫 번째 실습에서는 ID 읽기만 사용하므로 쿼리 수는 0 으로 유지됩니다. 유사성 쿼리는 V03 에서 시작합니다.
Stored Vectors까지 스크롤합니다. 그래프에서 비동기 표시 과정을 확인할 수 있습니다. 삽입 변경이 처리되기 전에는 개수가 0 으로 유지되다가 처리된 후 3 으로 바뀝니다.
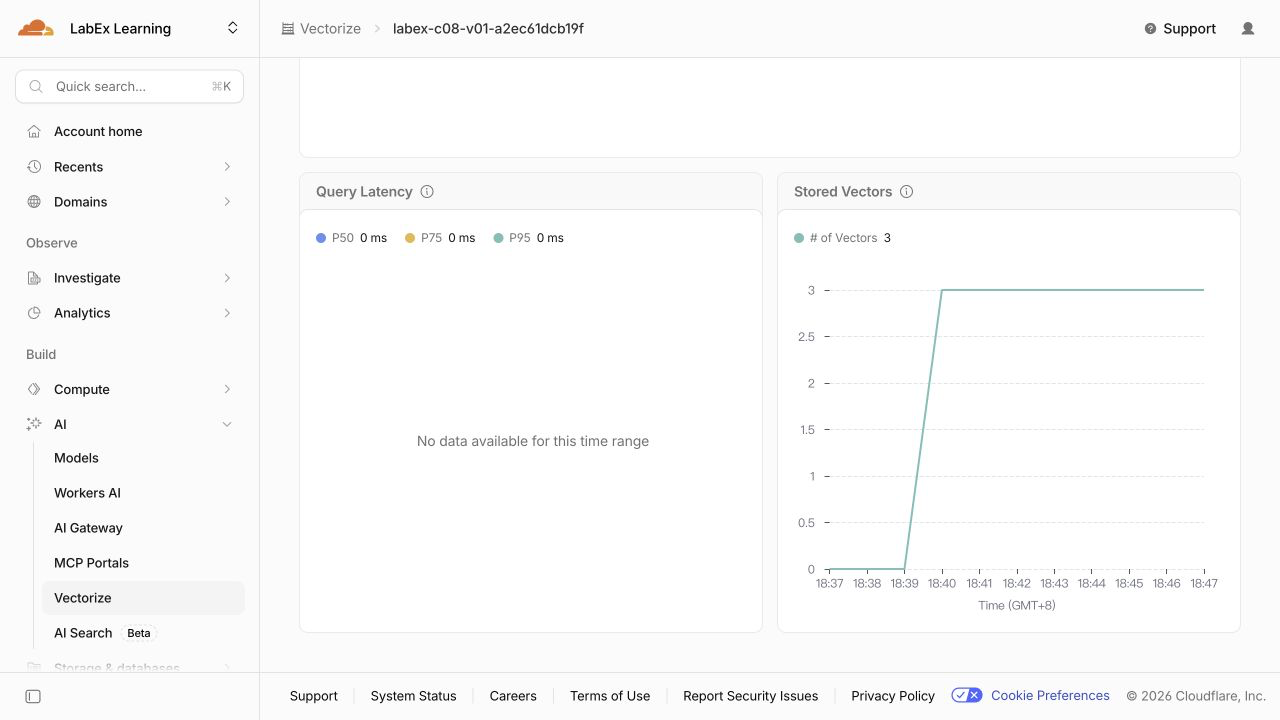
현재 Dashboard 에는 개별 벡터 ID 나 메타데이터 인덱스 정의가 표시되지 않습니다. password-reset, upload-pdf, billing-receipt, category 및 published에 대해서는 앞에서 실행한 Wrangler 읽기 결과를 사용합니다. 개수만 표시되는 차트에서 이러한 세부 정보를 추론하지 마세요. Dashboard 페이지는 전체 구조를 파악하는 데 도움이 되며, 독립적인 확인 작업은 신뢰할 수 있는 API 읽기를 사용합니다.
여기에 표시된 스크린샷은 실습의 클라우드 수락 확인 후 수행한 하나의 임시 실행 예시입니다. 무작위 인덱스 이름과 타임스탬프는 달라집니다. 예시 값을 그대로 복사하지 말고 구성과 소유한 ID 가 일치하는지 확인합니다.
임시 인덱스 삭제 및 로그아웃
이 단계에서는 정확히 소유한 인덱스를 삭제하고, 인증된 조회로 삭제를 확인한 다음 VM 의 인증을 제거합니다.
인덱스와 해당 메타데이터 인덱스 및 벡터는 하나의 임시 리소스를 구성합니다. 아직 인증이 유효할 때 wrangler.jsonc에 저장된 정확한 이름을 삭제합니다.
npx wrangler vectorize delete "$RUN" --force
인증된 인벤토리 조회를 통해 인덱스가 없는지 확인합니다.
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
이 인벤토리 조회가 성공했다는 점이 중요합니다. 네트워크 오류나 인증 오류가 발생했다면 삭제가 완료되었다고 증명할 수 없습니다. VM 인증을 취소하기 전에 정리 평가를 실행합니다.
bash verify6-1.sh
마지막으로 VM 에서 Wrangler 로그인을 제거하고 구조화된 결과를 확인합니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn: false가 표시되어야 합니다. Dashboard 의 브라우저 로그인은 별도로 유지되므로 학습 계정에서 계속 사용할 수 있습니다.
요약
선택한 임베딩 모델과 동일한 384 차원 계약을 사용하는 Vectorize V2 인덱스를 생성하고, 코사인 거리를 선택했으며, 나중에 필터에서 사용할 메타데이터 필드 2 개를 준비했습니다. 식별 가능한 결정적 벡터를 생성하고 NDJSON 형식으로 삽입했습니다. 또한 수락된 비동기 변경과 처리되어 읽을 수 있게 된 변경을 구분하고, ID 로 저장된 레코드를 다시 읽었습니다.
호환되는 레코드를 유지하면서 잘못된 차원의 벡터가 거부되는 것도 확인했습니다. 마지막으로 Dashboard 에서 실제 리소스를 확인하고, 정확히 소유한 임시 인덱스를 삭제했으며, 인증된 조회로 삭제를 확인하고 새 VM 의 Wrangler 인증을 제거했습니다.
다음 실습에서는 upsert와 삭제를 사용해 변경되거나 더 이상 사용하지 않는 문서 때문에 인덱스가 오래된 상태로 남지 않도록 관리합니다.