소개
V03 에서는 질문을 임베딩으로 변환하고 관련성이 높은 도움말 문서를 검색했습니다. V04 에서는 이러한 결과가 서버에서 제어하는 고객 및 카테고리 범위를 벗어나지 않도록 제한했습니다. 검색만으로도 유용하지만, 많은 지원 애플리케이션에는 승인된 구절을 짧은 자연어 답변으로 변환하는 단계가 하나 더 필요합니다.
이 패턴을 **검색 증강 생성 (retrieval-augmented generation)**이라고 하며, 일반적으로 RAG라고 줄여 부릅니다. 애플리케이션은 먼저 근거를 검색하고, 검색된 레코드만으로 작은 컨텍스트를 구성한 뒤, 언어 모델에 해당 컨텍스트를 바탕으로 답변하도록 요청합니다. 검색 기능만으로 모델이 자동으로 진실한 답변을 제공하지는 않습니다. 애플리케이션은 어떤 소스를 사용할 수 있는지 계속 제어하고, 프롬프트에 포함되는 텍스트의 양을 제한하며, 소스의 식별자를 보존하고, 승인된 근거가 없으면 중단해야 합니다.
두 개의 Cloudflare 바인딩을 사용하는 일회용 Worker 를 구축합니다. DOCUMENTS는 Vectorize 인덱스를 검색하고, AI는 BGE Small 임베딩 모델과 Cloudflare 에서 호스팅하는 Llama 텍스트 생성 모델을 모두 실행합니다. Worker 는 코드에 제공된 코퍼스를 통해 반환된 벡터 ID 를 확인합니다. 벡터 메타데이터는 검색에 유용하지만, 정식 문서 본문으로 사용하지 않습니다.
엔드포인트는 생성된 답변과 함께 애플리케이션이 제어하는 sources 배열을 반환합니다. 선택한 네임스페이스와 카테고리에서 검색 결과가 없으면 텍스트 생성 모델을 호출하지 않고 고정된 no_evidence 응답을 반환합니다. 모델이 임의로 답변하도록 요청하는 것보다 이러한 명시적인 분기가 더 안전합니다.
이 과정을 바로 시작했다면 먼저 Connect LabEx to Your Cloudflare Account를 완료합니다. V01~V04 가 선수 과정입니다. 이 과정에서는 호환 가능한 인덱스, 비동기 mutation, 시맨틱 검색 및 서버가 제어하는 범위를 소개합니다.
이 실습에서는 앞선 Workers AI 과정에서 Workers Free 에서 이미 사용해 본 Cloudflare 호스팅 @cf/meta/llama-3.3-70b-instruct-fp8-fast 모델을 사용합니다. DeepSeek V4 Flash 도 Cloudflare 에서 호스팅하지만 현재 유료 액세스가 필요하므로 학습자에게 필수인 의존성이 아닙니다. 이 실습은 크기가 제한된 임베딩 및 생성 요청만 전송하므로 계정에서 공유 Workers AI 무료 할당량을 사용할 수 있는 동안에는 Workers Paid 가 필요하지 않습니다.
설치 과정에서 /home/labex/project/grounded-answer에 Node.js 22.22.0 과 프로젝트 로컬 Wrangler 4.132.0 을 설치합니다. 결정적 테스트와 독립적인 읽기 전용 검사를 제공하지만, Wrangler 인증, 인덱스 생성, Worker 배포, 추론 실행 또는 클라우드 데이터 시딩은 수행하지 않습니다.
RAG 리소스 인증 및 이름 지정
이 단계에서는 새 VM 을 인증하고, 학습 계정을 확인하며, 리소스를 생성하기 전에 Worker 와 Vectorize 인덱스 한 쌍을 정의합니다.
준비된 프로젝트 디렉터리로 이동한 뒤 고정된 도구 버전을 확인합니다.
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Node.js 버전은 v22.22.0, Wrangler 버전은 4.132.0이어야 합니다. 브라우저에서 Dashboard 에 로그인해도 이 VM 이 자동으로 인증되지는 않습니다. 계정 식별 정보, 일회용 Worker, Vectorize 및 Workers AI 에 필요한 권한으로 Wrangler 디바이스 플로우를 사용합니다.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
표시된 인증 링크를 열고 코드가 일치하는지 확인한 다음, 사용할 LabEx Learning 계정을 승인합니다. 코드, 비밀번호 또는 토큰을 다른 사람에게 보내지 마세요. JSON 결과에서 loggedIn: true를 확인하고 계정 이름과 ID 를 기록합니다.
임의의 접미사를 하나 생성합니다. 이후 정리 단계에서 정확한 리소스 쌍을 찾을 수 있도록 두 리소스 이름에 같은 접미사를 사용합니다.
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
wrangler.jsonc를 생성합니다. 여기 문서는 JSON 마커 사이의 블록을 파일에 기록합니다. $RUN과 $INDEX는 이 VM 에서 생성한 고유 이름으로 확장됩니다. whoami에서 확인한 ID 로 YOUR_ACCOUNT_ID를 바꿉니다.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
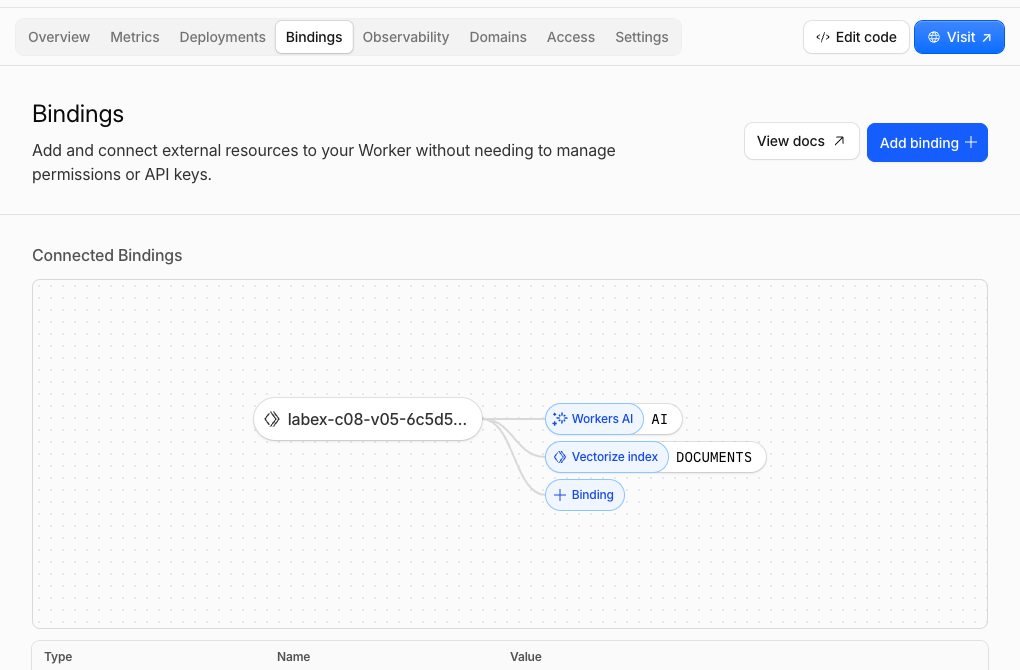
코드에서는 하나의 바인딩을 통해 두 모델을 호출하지만, AI는 하나의 바인딩입니다. DOCUMENTS는 연결된 인덱스를 가리킵니다. 이 파일은 사용할 리소스 이름을 지정할 뿐이며 아직 아무것도 생성하지 않습니다.
검색 후 생성하는 Worker 구축
이 단계에서는 전체 RAG 흐름을 구현하고, 클라우드 할당량을 사용하기 전에 결정적 인메모리 바인딩으로 각 동작을 검증합니다.
제공된 CORPUS는 ID 와 텍스트를 연결하는 정식 맵입니다. Vectorize 에는 임베딩과 검색 가능한 메타데이터가 저장됩니다. 쿼리 후 Worker 는 이 맵을 통해 확인되는 ID 만 허용합니다. 그런 다음 프롬프트에 최대 두 개의 구절만 포함합니다. 따라서 점수가 높다는 이유만으로 예상하지 못한 인덱스 레코드가 모델 컨텍스트에 들어가는 것을 막을 수 있습니다.
Worker 소스 파일을 생성합니다.
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
answer()의 처리 순서를 확인합니다. 서버가 소유한 범위를 검증하고, 질문을 임베딩한 다음, 사용할 수 있는 검색 결과를 최대 두 개까지 가져오고, 각 ID 를 CORPUS를 통해 확인한 뒤, 크기가 제한된 컨텍스트를 구성하고, 마지막으로 답변을 생성합니다. 공개 응답에서는 전체 컨텍스트 텍스트와 벡터 값은 제외하지만, 확인 가능한 소스 참조는 유지합니다.
결정적 테스트 모음을 실행합니다.
node --test test/worker.test.mjs
7 개의 테스트가 모두 통과해야 합니다. 가짜 바인딩은 알 수 없는 ID 와 검색 결과 없음 상태가 텍스트 생성 단계에 도달하지 않는지 검증합니다. 바인딩 타입을 생성하고 배포하지 않은 상태로 프로젝트를 번들링합니다.
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
생성된 타입에는 AI: Ai와 DOCUMENTS: VectorizeIndex가 포함되어야 합니다. dry run 은 파일들이 함께 번들링되는지만 확인하며, 클라우드 리소스를 생성하거나 어느 모델도 실행하지 않습니다.
준비된 인덱스 생성 및 배포
이 단계에서는 호환 가능한 Vectorize 인덱스를 생성하고, category를 필터링에 사용할 수 있도록 준비한 뒤, 준비 상태가 안정되면 Worker 를 배포합니다.
BGE Small 에서 사용하는 384 차원 코사인 인덱스를 생성합니다. --update-config=false는 이미 검토한 명시적 바인딩을 Wrangler 가 덮어쓰지 않도록 합니다.
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
category용 문자열 메타데이터 인덱스를 생성하고 반환된 mutation ID 를 저장합니다. set -o pipefail을 사용하면 tee가 출력 사본을 작성하더라도 Wrangler 명령이 실패할 때 파이프라인도 실패합니다.
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
승인된 mutation 은 대기 중인 작업입니다. 정확한 mutation 과 벡터 개수가 연속 세 번의 읽기에서 일치해야 통과하는 제한된 읽기 전용 대기 스크립트를 생성합니다.
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
별도의 목록 화면은 처리된 mutation 상태보다 늦게 갱신될 수 있습니다. 따라서 목록에도 해당 행이 표시될 때까지 잠시 기다립니다.
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
마지막으로 배포하고 공개 Worker URL 을 저장합니다.
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
아직 인덱스는 비어 있습니다. 배포는 바인딩을 연결할 뿐이며 임베딩이나 소스 레코드를 자동으로 생성하지 않습니다.
승인된 소스 코퍼스 시딩
이 단계에서는 제공된 세 문서의 실제 임베딩을 생성하고 모든 소스 ID 를 읽을 수 있을 때까지 기다립니다.
소스 텍스트는 CORPUS에 그대로 둡니다. 벡터 레코드에는 호환되는 임베딩과 검색에 필요한 작은 메타데이터만 포함합니다. 이렇게 분리하면 애플리케이션이 벡터 메타데이터에서 임의의 텍스트를 신뢰하는 대신 ID 를 승인된 문서 본문에 연결할 수 있습니다.
고정된 시드 엔드포인트를 한 번 호출합니다.
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
3 개의 레코드, 384 차원, cls 풀링 및 mutation UUID 가 반환되어야 합니다. 해당 상태가 처리될 때까지 기다린 다음, 별도의 목록 화면에서 세 ID 가 모두 보일 때까지 잠시 기다립니다.
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
이제 각 ID 가 검색 결과를 정확히 하나의 코퍼스 항목에 연결합니다. 인덱스에는 의도적으로 files 카테고리 문서가 없습니다. 따라서 유사도 임계값에 의존하지 않고도 근거 없음 분기를 확인할 수 있습니다.
근거 기반 답변과 근거 없음 답변 비교
이 단계에서는 하나의 지원되는 질문과, 승인된 카테고리에 소스가 없는 질문을 각각 전송합니다. 두 결과를 비교하면 RAG 의 제어 흐름을 확인할 수 있습니다.
blue 계정 범위에서 만료된 비밀번호를 재설정하는 방법을 질문합니다.
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
mode: grounded, generated: true, 비어 있지 않은 답변과 password-reset이 포함된 sources 배열이 반환되어야 합니다. 모델에 따라 답변 문구는 달라질 수 있습니다. 변하지 않는 검증 기준은 반환된 모든 ID, 제목 및 URL 이 제공된 코퍼스를 통해 확인되며 승인된 account 구절만 프롬프트에 들어갔다는 점입니다.
이제 같은 서버 소유 고객 범위를 유지하면서 파일 업로드에 관해 질문합니다. files는 허용된 카테고리이지만 이 코퍼스에는 해당 카테고리에 속하는 파일 문서가 없습니다.
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
mode: no_evidence, generated: false, 고정 메시지 I don't have enough approved evidence to answer that question. 및 sources: []가 반환되어야 합니다. Worker 는 검색을 위해 질문을 임베딩했지만, 승인된 컨텍스트가 없으므로 텍스트 생성을 건너뛰었습니다.
자체 네임스페이스를 지정하는 안전하지 않은 요청을 하나 시도합니다.
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
HTTP 400 과 scope_override_not_allowed가 반환되어야 합니다. RAG 는 V04 에서 학습한 인증 경계를 대신하지 않습니다. 검색된 텍스트가 모델 컨텍스트가 되기 전에 검색 자체가 안전해야 합니다.
Workers & Pages → labex-c08-v05-... Worker → Bindings를 엽니다. AI가 Workers AI 를 가리키고 DOCUMENTS가 연결된 Vectorize 인덱스를 가리키는지 확인합니다. 이 화면에서 코드의 두 서비스 이름이 실제 관리형 리소스에 연결되어 있는지 확인할 수 있습니다.
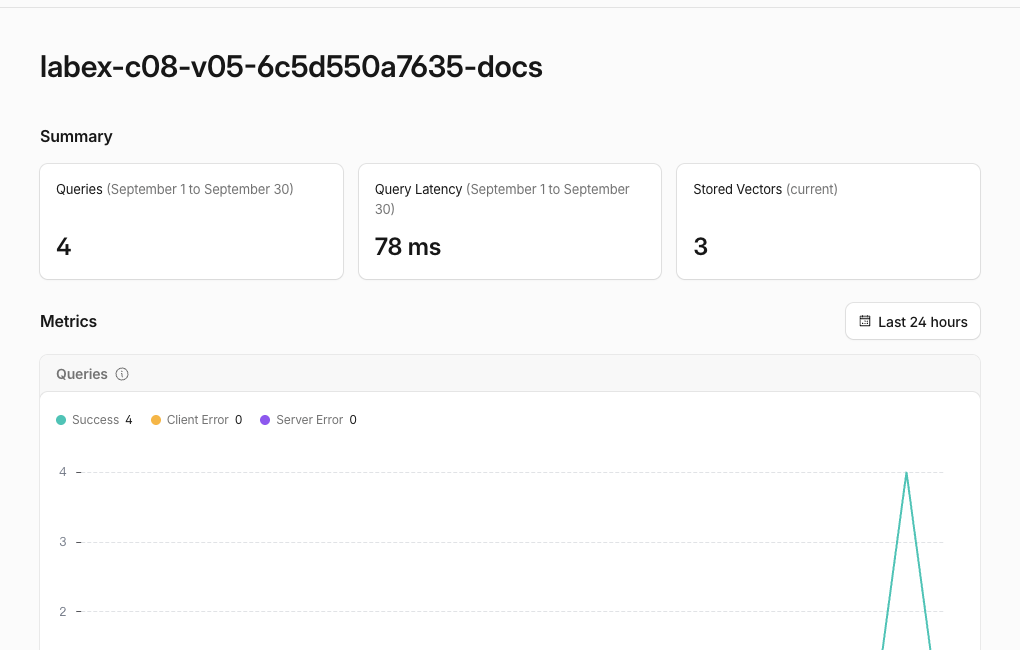
그런 다음 AI → Vectorize → 일치하는 -docs 인덱스를 엽니다. 현재 개수는 결국 3 개의 벡터를 표시해야 하며, 쿼리 활동에는 근거 기반 검색과 근거 없음 검색이 반영되어야 합니다. Dashboard 지표는 늦게 갱신될 수 있으므로 인증된 ID 조회와 엔드포인트 응답을 기준으로 판단합니다.
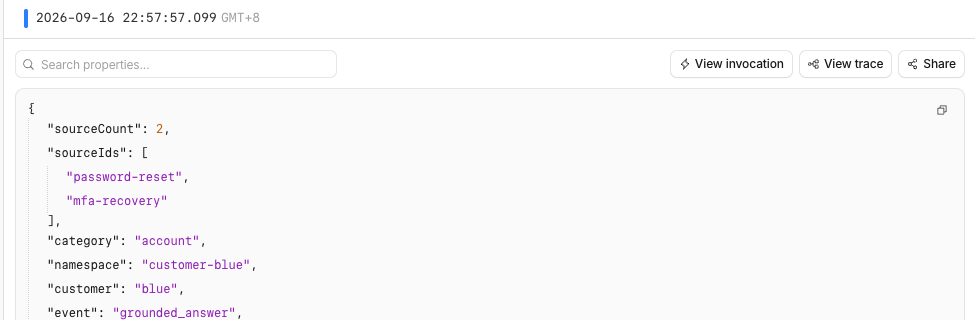
Workers Logs 를 사용할 수 있다면 Observability → Logs를 열고 grounded_answer와 grounded_no_evidence 항목을 확인합니다. 로그에는 카테고리, 소스 ID 및 개수가 포함되지만 질문, 답변, 구절 텍스트, 세션 레이블 및 벡터 값은 기록하지 않습니다. 따라서 프롬프트를 로그에 복사하지 않고도 운영자가 제어 흐름을 파악하는 데 필요한 정보를 얻을 수 있습니다.
근거 기반 답변 리소스 삭제
이 단계에서는 일회용 Worker 와 Vectorize 인덱스를 삭제한 다음, Wrangler 인증이 유지되는 동안 해당 리소스가 사라졌는지 확인합니다.
이전 터미널 세션의 변수에 의존하지 않도록 wrangler.jsonc에서 정확한 두 이름을 다시 가져옵니다.
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
두 값이 모두 고유한 labex-c08-v05-... 접두사를 사용하는지 확인합니다. 배포된 코드가 바인딩을 계속 참조하지 않도록 Worker 를 먼저 삭제한 다음, 연결된 인덱스만 삭제합니다.
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
인증된 인덱스 목록을 성공적으로 저장하고 정확한 이름의 리소스가 없는지 확인합니다.
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
로그아웃하기 전에 이 검사를 완료합니다. 네트워크 오류나 인증 오류는 확인 결과가 아닙니다. 평가에서는 계정 읽기 작업이 성공하고 정확한 이름의 리소스가 없는지 독립적으로 확인합니다.
학습 VM 에서 로그아웃
이 단계에서는 이 VM 의 임시 Wrangler 인증을 제거합니다. 클라우드 리소스는 이미 삭제되었고 인증된 정리 검사를 통과한 상태입니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn: false가 반환되어야 합니다. Cloudflare Dashboard 의 브라우저 세션은 별개이며 학습 계정에서 계속 사용할 수 있습니다.
요약
작은 검색 증강 생성 엔드포인트를 구축했습니다. 서버가 제어하는 범위로 Vectorize 검색을 제한하고, 반환된 ID 를 승인된 코퍼스를 통해 확인했으며, 최대 두 개의 구절만 모델 컨텍스트로 사용했습니다. 또한 애플리케이션은 모델이 생성한 문구가 달라지더라도 안정적인 소스 참조를 함께 반환했습니다.
또한 승인된 검색 결과가 비어 있으면 텍스트 생성 없이 고정된 근거 없음 분기로 처리되는지 확인했습니다. 클라이언트가 범위를 덮어쓰는 요청은 검색 전에 거부했고, Worker, Vectorize 및 개인정보를 제한한 관측성 간의 관계를 확인했습니다. 인증이 유지되는 동안 두 일회용 리소스를 삭제한 뒤 로그아웃했습니다. 과정의 챌린지에서는 동일한 범위 경계를 위반하는 고장 난 엔드포인트를 수정합니다.