소개
의존 서비스가 느려지면 지원 API 가 도움이 되지 않는 예외를 반환합니다. 이 실습에서는 해당 증상을 재현하고 요청 ID 와 연관시킨 다음, 호출자에게 제한 시간 내에 의미 있는 장애 응답을 반환하도록 핸들러를 수정합니다. 정상적인 요청은 계속 성공하는지도 확인합니다. 그런 다음 실제 클라우드 응답과 별도의 실시간 로그 스트림을 검증합니다.
먼저 새 VM 에서 자신의 학습 계정으로 시작합니다. 사전 요구 사항은 일반적인 Wrangler 배포, 서비스 바인딩 및 로컬 테스트입니다. 이전 Worker 나 VM 은 재사용하지 않습니다. 설정 과정에서 Node.js 22.22.0, Wrangler 4.131.1 및 Miniflare 4.20260730.0 을 설치하고, 오류가 있는 호출자와 테스트용 업스트림을 제공합니다. 업스트림은 테스트 데이터, 제어된 503 응답 또는 2.5 초 지연을 반환합니다. 데이터베이스, 구매한 도메인 또는 고부하 실험은 필요하지 않습니다.
런타임 예외, 의도적으로 반환된 HTTP 504, 실행 제한 초과 장애는 서로 다른 관찰 결과입니다. 모든 5xx 응답을 플랫폼 장애로 간주하지 않고 각 증거 유형을 확인합니다.
타임아웃 재현 및 연관
이 단계에서는 느린 의존 서비스로 인해 발생하는 예외를 로컬에서 재현합니다. 호출자와 제공된 업스트림 코드를 확인합니다. 호출자에는 400ms 제한 시간이 있지만 거부된 fetch 를 처리하는 catch 가 없습니다. 업스트림의 slow 모드는 2.5 초 동안 대기합니다.
cd /home/labex/project/failure-diagnostics
cat src/index.js
cat upstream/index.js
고유한 리소스 이름을 생성합니다. 따옴표로 감싸지 않은 첫 번째 EOF 는 해당 변수를 두 구성 파일에 확장합니다. UPSTREAM 서비스 바인딩은 테스트용 업스트림을 비공개로 유지합니다. 요청 URL 의 호스트 이름이 공개 서비스를 선택하는 것은 아닙니다.
WORKER_NAME="labex-diagnose-$(node -p "require('node:crypto').randomBytes(6).toString('hex')")"
cat > wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [{"binding": "UPSTREAM", "service": "$WORKER_NAME-upstream"}]
}
EOF
cat > upstream/wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME-upstream",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
EOF
두 구성을 하나의 로컬 개발 프로세스에서 실행합니다. 백그라운드 작업을 사용하면 터미널을 계속 사용할 수 있습니다. > 및 2>&1은 출력과 오류를 dev.log에 기록합니다. 요청을 보내기 전에 Ready 가 표시될 때까지 기다립니다.
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
-H를 사용해 간단한 테스트용 요청 ID 를 추가합니다. 핸들러는 제한된 ID 형식만 허용하며, 형식이 다르면 ID 를 새로 생성합니다. --max-time은 curl 클라이언트의 최대 시간을 제한합니다. 이는 핸들러의 제한 시간과 별개입니다.
curl -i --max-time 6 -H "X-Request-ID: healthy-one" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-one" "http://127.0.0.1:8080/api/check?mode=slow"
cat dev.log
정상 요청은 테스트용 업스트림 데이터와 함께 200 을 반환합니다. slow 모드는 로컬 500 오류를 반환해야 하며, 로그에는 slow-one에 대한 request_started 레코드 다음에 처리되지 않은 타임아웃 예외가 표시되어야 합니다. 정확한 로컬 오류 페이지와 스택은 환경에 따라 다를 수 있습니다. 이 결과는 제한 시간 때문에 요청이 거부된다는 것을 보여 주지만, 유용한 오류 응답이 존재한다는 뜻은 아닙니다. 호출자를 수정하기 전에 검증을 실행합니다.
장애 응답 및 진단 정보 수정
이 단계에서는 제한 시간으로 발생한 업스트림 장애를 처리하고, 헤더나 자격 증명을 기록하지 않으면서 유용한 진단 정보를 유지합니다. 현재 작업의 실제 작업 번호를 확인한 뒤 중지합니다.
jobs
kill %1
아래의 완성된 수정 핸들러로 호출자를 교체합니다. 따옴표로 감싼 구분자는 JavaScript 를 그대로 보존합니다. 504 는 호출자가 설정한 의존 서비스 제한 시간이 초과되었음을 나타냅니다. 502 는 업스트림 응답 또는 프로토콜에 문제가 있음을 나타냅니다. 성공한 호출에서는 업스트림 결과를 그대로 유지합니다. elapsed_ms는 CPU 사용 시간이 아니라 실제 경과 시간입니다. 로그와 응답은 동일한 요청 ID 를 사용하므로 시스템에서 하나의 요청 흐름을 추적할 수 있습니다.
cat > src/index.js <<'JS'
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === '/health') return Response.json({status: 'ok'});
    if (url.pathname !== '/api/check') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'GET') return Response.json({error: 'method_not_allowed'}, {status: 405});
    const mode = url.searchParams.get('mode') || 'healthy';
    if (!['healthy', 'slow', 'fail'].includes(mode)) {
      return Response.json({error: 'invalid_mode'}, {status: 400});
    }
    const suppliedId = request.headers.get('X-Request-ID') || '';
    const requestId = /^[a-z0-9-]{1,64}$/.test(suppliedId) ? suppliedId : crypto.randomUUID();
    const headers = {'X-Request-ID': requestId, 'Cache-Control': 'no-store'};
    const started = Date.now();
    console.log(JSON.stringify({event: 'request_started', request_id: requestId, mode}));
    const upstreamUrl = new URL('https://diagnostic.internal/check');
    upstreamUrl.searchParams.set('mode', mode);
    upstreamUrl.searchParams.set('probe', requestId);
    const signal = AbortSignal.timeout(400);
    const failure = (event, status, detail = {}) => {
      console.error(JSON.stringify({event, request_id: requestId, mode, status,
        elapsed_ms: Date.now() - started, ...detail}));
      return Response.json({error: event, requestId}, {status, headers});
    };
    try {
      const response = await env.UPSTREAM.fetch(upstreamUrl, {signal});
      if (!response.ok) return failure('upstream_status', 502, {upstream_status: response.status});
      const data = await response.json();
      if (data.service !== 'labex-diagnostic-fixture' || data.status !== 'ok' || data.probe !== requestId) {
        return failure('upstream_protocol', 502);
      }
      console.log(JSON.stringify({event: 'request_complete', request_id: requestId,
        mode, status: 200, elapsed_ms: Date.now() - started}));
      return Response.json({status: 'ok', requestId, upstream: data}, {headers});
    } catch {
      return signal.aborted ? failure('upstream_timeout', 504) : failure('upstream_exception', 502);
    }
  }
};
JS
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Ready 가 표시되면 세 가지 모드와 영향을 받지 않은 health 경로를 비교합니다. 각 장애 요청은 즉시 종료되어야 합니다. slow 모드에서 더 오래 기다리는 것은 수정이 아닙니다.
curl -i --max-time 6 -H "X-Request-ID: healthy-two" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-two" "http://127.0.0.1:8080/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: fail-two" "http://127.0.0.1:8080/api/check?mode=fail"
curl -i http://127.0.0.1:8080/health
cat dev.log
healthy/slow/fail 모드의 결과는 각각 200/504/502여야 합니다. 각 응답의 JSON 과 X-Request-ID 헤더에는 해당 요청 ID 가 포함됩니다. 로그에서는 request_started가 request_complete, upstream_timeout 또는 upstream_status 중 하나와 연결되어야 합니다. 마지막 범주는 업스트림의 503 을 호출자의 502 와 별도로 기록합니다. 핸들러가 정상적으로 실행을 끝냈다면 장애를 처리한 요청은 HTTP 상태가 504 또는 502 여도 성공적인 런타임 결과가 될 수 있습니다.
제공된 실행 제한 예시와 비교합니다.
cat evidence/execution-limit.json
이 파일은 명시적으로 합성된 교육용 증거이며, 사용자의 Worker 에서 수집한 결과가 아닙니다. exceededCpu 결과는 실행 제한 초과 장애를 나타냅니다. 런타임이 실행을 중지한 뒤에는 애플리케이션의 catch 가 실행된다고 보장할 수 없습니다. 이 실습의 비동기 업스트림을 기다리는 것은 CPU 시간을 소비하는 것과 동일하지 않습니다. 제한을 고려하기 전에 비용이 큰 계산이나 요청 작업을 조사합니다. 이 예시를 흉내 내기 위해 제한 시간을 제거하거나 부하를 생성하지 마십시오. 공식 오류 참조 문서에서는 예외 및 제한 범주를 설명하고, 런타임 결과 문서에서는 결과와 HTTP 상태의 차이를 설명합니다.
검증을 실행합니다. 검증은 자체 테스트용 업스트림과 요청 ID 를 사용하는 격리된 런타임을 시작하고, 정상 및 장애 응답 계약을 확인하며, 합성 Authorization 헤더가 애플리케이션 로그에 나타나지 않는지 확인합니다. 학습자 로그 파일은 독립적인 증거가 아닙니다.
실시간 요청, 로그 및 메트릭 검증
이 단계에서는 학습 계정에서 수정된 동작을 확인합니다. 로컬 개발을 중지한 뒤, 앞에서 학습한 것과 동일한 범위의 디바이스 인증 흐름으로 이 새 VM 을 인증합니다.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
출력된 링크를 열고 코드를 입력한 다음 브라우저에서 사용할 학습 계정을 승인합니다. 일반 Wrangler 출력에 표시되는 실제 계정 이름과 ID 를 확인합니다.
npx wrangler whoami --json
YOUR_ACCOUNT_ID를 실제 ID 로 바꿉니다. 다음 일반 Node 명령은 두 프로젝트 구성에 모두 ID 를 저장하므로 각 배포가 소유 계정을 명확히 지정합니다.
node -e 'const fs=require("node:fs");for(const p of ["wrangler.jsonc","upstream/wrangler.jsonc"]){const c=JSON.parse(fs.readFileSync(p));c.account_id="YOUR_ACCOUNT_ID";fs.writeFileSync(p,JSON.stringify(c,null,2)+"\n");}'
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler deploy -c upstream/wrangler.jsonc
npx wrangler deploy
테스트용 업스트림에는 공개 엔드포인트가 없습니다. 아래에 호출자의 실제 workers.dev URL 을 복사합니다. 계정에서 처음 서브도메인을 등록해야 한다면 계속하기 전에 Deploy Your First Cloudflare Worker 에서 안내한 절차를 사용합니다.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
읽기 쉬운 실시간 스트림을 시작합니다. 요청을 보내기 전에 events.log에 Connected 가 표시될 때까지 기다립니다. 파일이 존재하는 것만으로는 준비가 완료된 것이 아닙니다.
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
cat events.log
curl -i --max-time 6 -H "X-Request-ID: cloud-healthy" "$APP_URL/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: cloud-slow" "$APP_URL/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: cloud-fail" "$APP_URL/api/check?mode=fail"
cat events.log
실시간 애플리케이션 로그에서 예상되는 200/504/502 응답과 일치하는 ID 를 찾습니다. 이벤트가 아직 도착하지 않았다면 몇 초 후 같은 로그를 다시 확인합니다. 이벤트를 인위적으로 만들기 위해 애플리케이션을 수정하지 마십시오. 스트림이 종료되었다면 중지하고 tail-errors.log를 확인합니다. 읽기 쉬운 출력에서 catch 로 처리된 504 호출이 Ok 로 표시될 수 있습니다. 이는 런타임 실행이 완료되었다는 뜻이지, 업스트림이 정상이라는 뜻은 아닙니다.
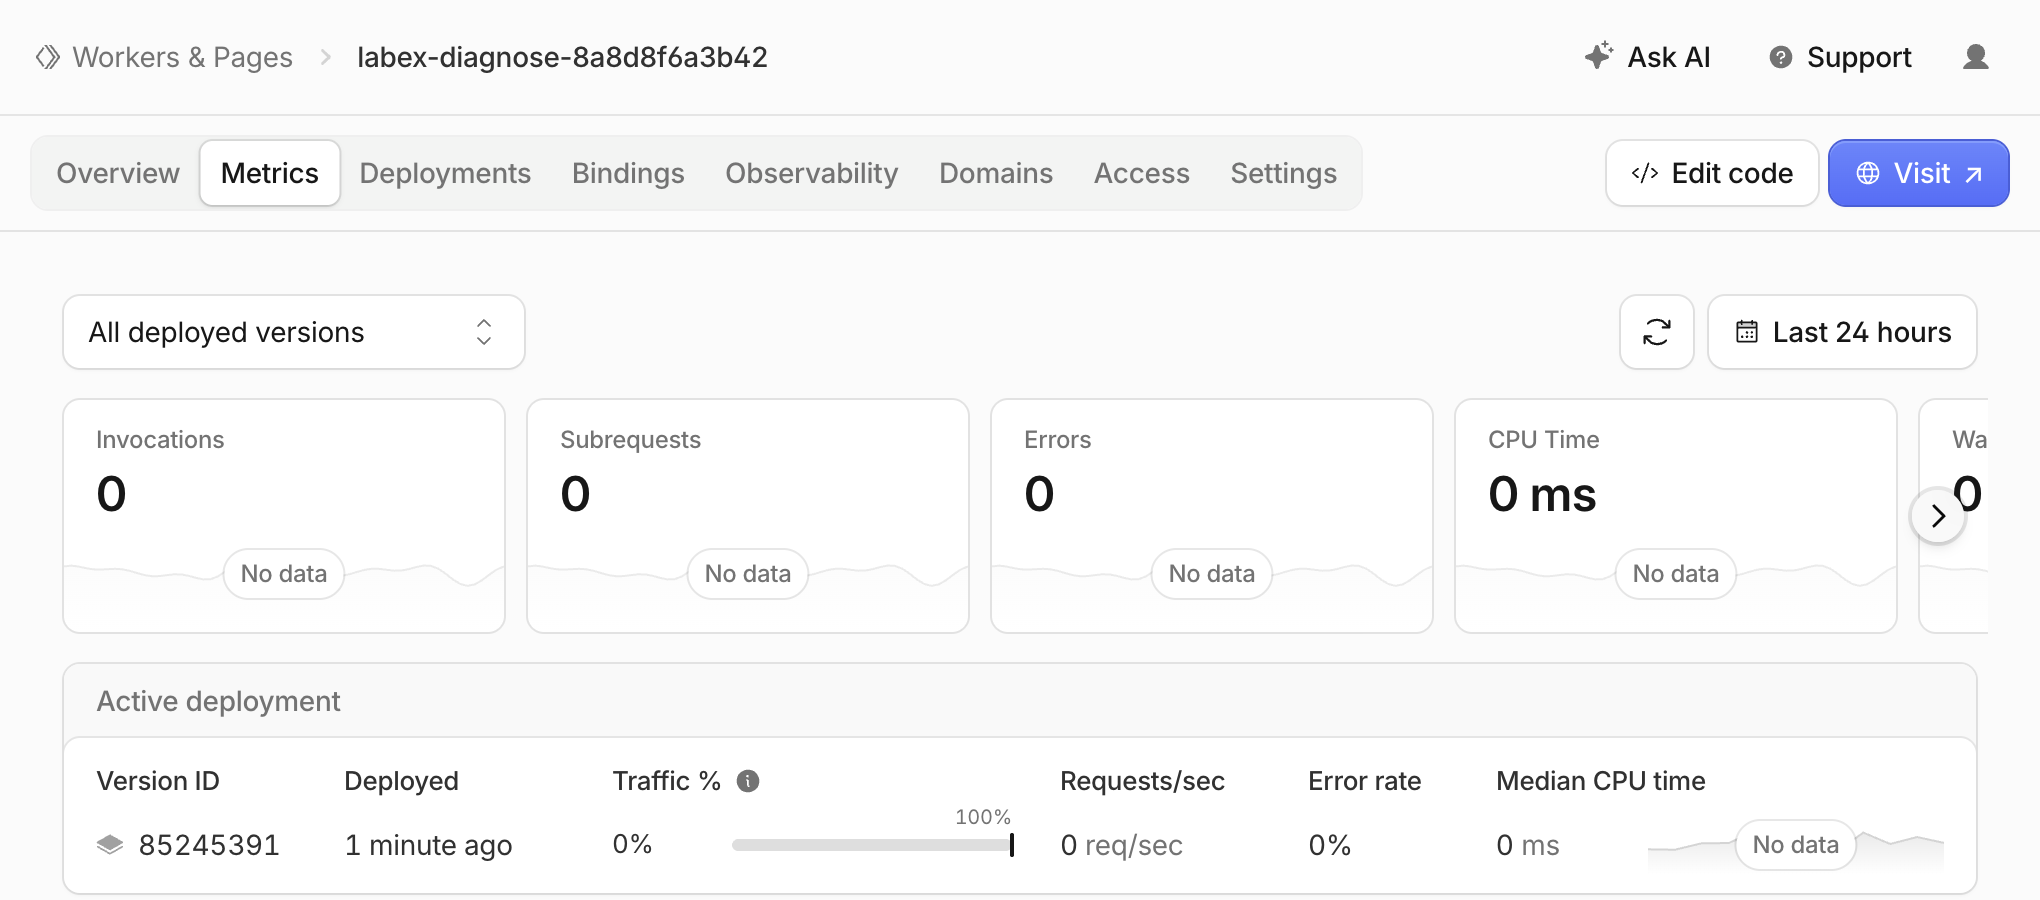
Dashboard 에서 선택한 계정의 정확한 호출자를 열고, 해당 호출자의 UPSTREAM 바인딩이 이 테스트용 업스트림을 대상으로 하는지 확인한 다음 Metrics 를 확인합니다. 제공되는 차트는 요청과 호출 오류를 집계하며 짧은 테스트 결과가 반영되기까지 시간이 걸릴 수 있습니다. 즉시 0 이 아닌 총계가 표시되어야 한다고 가정하지 말고 실제로 보이는 내용을 기록합니다. 개별 요청의 증거에는 실시간 로그와 HTTP 응답을 사용합니다. 처리된 504 는 HTTP 응답 상태 데이터에 나타날 수 있지만 처리되지 않은 런타임 예외로 집계되지 않을 수 있습니다. 메트릭 참조 문서에서는 집계 및 호출 범주를 설명합니다.
Compute → Workers & Pages에서 정확한 호출자를 열고 Metrics를 선택합니다. Worker breadcrumb, 배포된 버전 필터 및 요청이 발생한 시간을 포함하는 시간 범위를 확인합니다. 새로 고침 버튼은 시간 범위 선택기 옆에 있습니다. 아래 스크린샷은 합성된 정상, 지연 및 업스트림 장애 요청 직후에 촬영되었으며, 카드에는 여전히 No data가 표시되었습니다. 이는 분석 데이터가 지연된 상황을 보여 주는 유효한 관찰 결과이지, 요청이 실행되지 않았거나 수정이 실패했다는 증거가 아닙니다. 이름, 버전 ID 및 총계는 환경에 따라 다릅니다. 스크린샷과 일치시키기 위해 추가 부하를 생성하지 마십시오.
인증된 상태에서 검증을 실행합니다. 검증은 소유권과 바인딩 상태를 조회하고, 독립적인 새 요청을 보내며, 별도의 실시간 스트림을 수집합니다. 약 1 분 정도 기다립니다. 스트림을 사용할 수 없거나 불완전하다면 결과를 확정할 수 없습니다. 연결 준비 상태를 확인하고 다시 시도합니다. 로그가 없다는 이유만으로 성공으로 처리하지 마십시오. 검증이 통과하면 현재 작업 번호를 확인한 뒤 학습용 tail 을 중지합니다.
jobs
kill %1
진단용 Worker 삭제
이 단계에서는 인증을 유지한 상태에서 이 실습의 호출자와 테스트용 업스트림만 삭제합니다. 두 이름과 해당 계정을 검토한 다음 호출자를 먼저 삭제합니다.
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c upstream/wrangler.jsonc
각 이름 확인 프롬프트에서 y 키를 한 번 누릅니다. 고정된 CLI 는 Worker 삭제 후 기존 KV 정리 인증 진단 메시지를 표시할 수 있습니다. 이 메시지 때문에 권한을 추가로 부여하지 말고, 임의의 오류가 삭제 실패를 증명한다고 가정하지 마십시오. Dashboard 를 새로 고친 뒤 검증을 실행합니다. 인증된 인벤토리에서 두 이름이 모두 사라져야 삭제가 성공한 것입니다. 계정, 서브도메인 및 관련 없는 리소스는 유지합니다.
VM 연결 해제
이 단계에서는 리소스 삭제를 확인한 뒤 VM 연결을 해제합니다. 터미널을 닫거나 로그아웃하는 것만으로는 클라우드 리소스가 삭제되지 않습니다.
npx wrangler logout
npx wrangler whoami --json
loggedIn=false가 표시되어야 합니다. 인증되지 않은 상태이므로 명령이 0 이 아닌 종료 코드를 반환할 수 있습니다. 최종 검사를 실행합니다. 브라우저 로그인과 학습 계정은 이후 새 실습에서 다시 사용할 수 있습니다.
요약
처리되지 않은 타임아웃을 재현하고, 제한된 의존 서비스 장애를 수정했으며, 응답과 구조화된 로그에서 요청 ID 를 연관시켰습니다. 정상 동작은 그대로 유지했습니다. 애플리케이션 HTTP 장애를 런타임 결과 및 합성 CPU 제한 증거와 구분하고, 실제 클라우드 동작을 확인한 다음 두 Worker 를 삭제하고 연결을 해제했습니다.