Introducción
Northline Library permite descubrir libros, consultar disponibilidad y previsualizar una reserva. Su portada puede parecer sana aunque un lector no pueda buscar. Tu tarea es supervisar ese resultado del cliente y avisar solo cuando el fallo persista.
Basta con conocer la terminal. Están preparados la biblioteca, Prometheus (muestras y reglas), Blackbox Exporter (sondas HTTP reales), Alertmanager (entrega de avisos) y un buzón local. Editarás dos archivos YAML cortos; no necesitas programar, instalar herramientas, tener correo ni enviar mensajes fuera. Todo funciona en una instancia de práctica con libros ficticios y reservas de solo lectura.
Usa Library para las acciones del lector, Workstation para comandos y Monitoring para observaciones reales y webhooks recibidos. El sitio y los nombres de la interfaz siguen en inglés. Cada unidad comienza de forma independiente.
Supervisar la búsqueda del lector
En este paso seleccionarás una sonda del cliente. Empieza en Library: primero utilizarás el servicio normal y después elegirás una comprobación de lo que necesita el lector.
Recorrer la experiencia del lector
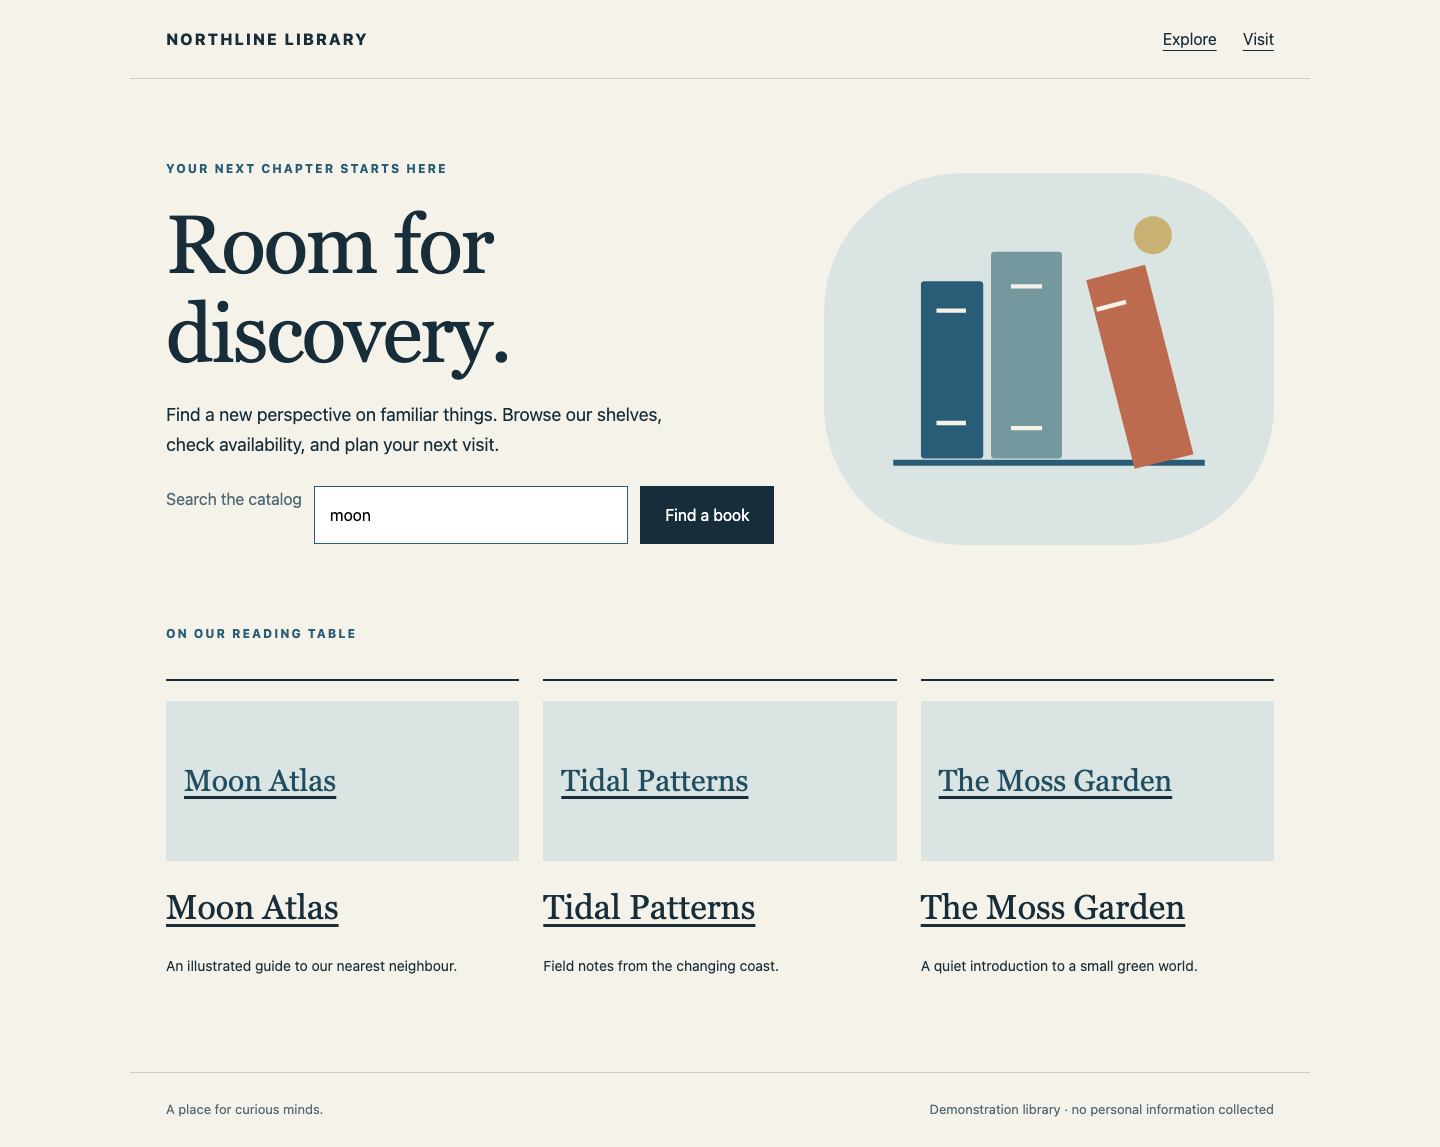
Deja moon en Search the catalog y selecciona Find a book. Los resultados deben incluir Moon Atlas, Available y su ubicación. Abre Moon Atlas y después Check reservation: la vista de solo lectura muestra Ready to collect: Moon Atlas. No se reserva nada. Selecciona Back to book, luego NORTHLINE LIBRARY. Abre Visit, lee el horario y vuelve con el enlace de la marca.
Entender la sonda
Cambia a Workstation, ya situado en /home/labex/project/library-watch. Una ruta nombra un archivo o directorio; esta ruta absoluta parte de la raíz del sistema. pwd muestra tu ubicación, ls enumera nombres y cat imprime un archivo:
pwd
ls
cat prometheus.yml
Tienes prometheus.yml, alerts.yml y watch.sh. Una configuración describe cómo debe comportarse un programa. YAML utiliza sangría con espacios, pares key: value y un guion para cada elemento de lista; conserva los espacios mostrados. No necesitas editor: sustituirás esta pequeña configuración mediante un bloque completo.
HTTP es el protocolo de petición y respuesta del navegador. Una URL incluye dirección, puerto que identifica un servicio y ruta. En Workstation, 127.0.0.1 significa esta instancia. El puerto 8081 sirve la biblioteca; /search?q=moon busca con el parámetro q igual a moon. Mantén las comillas de la URL en los comandos para que el shell la trate como un argumento.
El job library preparado solo comprueba la portada. Un job es un grupo con nombre de destinos de muestreo. El exportador del puerto 9115 realiza una petición real y devuelve probe_success: 1 si tiene éxito y 0 si falla. Su módulo search exige el contenido Moon Atlas y Available, además de HTTP 200. Prometheus recoge el resultado cada 2 segundos. La métrica independiente up solo indica si Prometheus pudo recoger datos del exportador; no demuestra que el lector tuviera éxito.
Seleccionar la ruta del cliente
cat > prometheus.yml sustituye el archivo. <<'YAML' inicia un here-document literal: pega el bloque entero, incluido el YAML final en su propia línea. global define los tiempos, rule_files nombra las reglas y alerting conecta con el servicio de entrega preparado. Conserva esos ajustes y cambia el módulo y el destino a la búsqueda. La etiqueta journey: search identifica su alcance.
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload ejecuta la herramienta suministrada: comprueba la sintaxis antes de solicitar la recarga a Prometheus. No modifica la biblioteca ni inventa observaciones.
bash watch.sh reload
Espera Configuration accepted. Tras unos 4 segundos, cambia a Monitoring. Business probes debe mostrar search: healthy. Si la recarga informa de un error YAML, vuelve a Workstation, reemplaza el archivo con el bloque completo y recarga. Si no hay muestras disponibles, espera y repite; unavailable nunca significa healthy. No apuntes al propio Monitoring.
Comparar accesibilidad y éxito
Cambia a Workstation. fault search seconds 6 hace fallar solo la búsqueda durante 6 segundos reales y la restaura automáticamente. No fija estados de alerta. curl envía peticiones HTTP; -sS oculta el progreso y muestra errores de conexión. Ejecuta:
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
El cuerpo dice Search is taking a break. El servidor sigue devolviendo HTTP 200 deliberadamente: una comprobación exclusiva del estado perdería este fallo. Cambia inmediatamente a Monitoring: en un intervalo de muestreo, búsqueda debe pasar a failed y volver a healthy tras recuperarse. Si no ves la breve ventana, repite los mismos 6 segundos. Todavía no hay alerta configurada. Espera al estado sano antes de comprobar el paso.
Alertar solo cuando el fallo persiste
En este paso configurarás una alerta del cliente que espera lo suficiente para ignorar el fallo breve anterior. Empieza en Workstation.
Leer la condición
Prometheus evalúa reglas cada 2 segundos. probe_success{job="library",journey="search"} == 0 selecciona muestras fallidas de búsqueda del job library. Las llaves contienen filtros de etiquetas; == 0 selecciona fallo, no éxito. Elegir solo up supervisaría la recogida de datos, no al lector. Sin etiquetas podrían incluirse servicios ajenos.
for: 20s exige que la condición siga activa 20 segundos. pending indica que existe, pero aún está esperando; firing, que duró lo necesario; inactive, que no está presente. Los 20 segundos son breves para este ejercicio, no una recomendación universal de producción. La ausencia de datos se muestra como unavailable en Monitoring: no demuestra salud ni constituye una muestra de fallo del negocio.
alert nombra la regla. severity es una etiqueta de enrutamiento y annotations.summary describe la consecuencia para el cliente. Escribe la regla completa:
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
Espera Configuration accepted. Si falla la validación, corrige espacios o puntuación y recarga; la última configuración válida sigue activa hasta que se acepte la nueva.
Cambia a Monitoring. Con búsqueda sana, debe aparecer CustomerJourneyFailed: inactive (20 seconds). El buzón local todavía debe estar vacío.
Demostrar que un fallo breve no molesta
Cambia a Workstation y repite el mismo fallo breve:
bash watch.sh fault search seconds 6
Cambia inmediatamente a Monitoring. Búsqueda falla y la regla puede mostrar pending brevemente. Tras recuperarse automáticamente, la sonda y la regla vuelven a healthy/inactive. El buzón permanece vacío. Permite unos 12 segundos para el ciclo completo. Si antes ejecutaste un fallo largo, los avisos anteriores permanecen: compara los nuevos eventos en vez de borrar evidencias.
Una regla firing y un aviso entregado son hechos distintos. Alertmanager recibe alertas firing, las agrupa, espera 1 segundo para un grupo nuevo y entrega al buzón webhook local. Muestreo, evaluación y entrega añaden un pequeño retraso cada uno. No elimines for ni bajes todos los umbrales porque el aviso no sea instantáneo.
Recibir el fallo y su recuperación
En este paso provocarás un fallo persistente y observarás la entrega real. Empieza en Workstation.
Observar un fallo persistente
El siguiente fallo dura 60 segundos reales para poder ver todos los estados. Solo falla la búsqueda; la portada sigue funcionando.
bash watch.sh fault search seconds 60
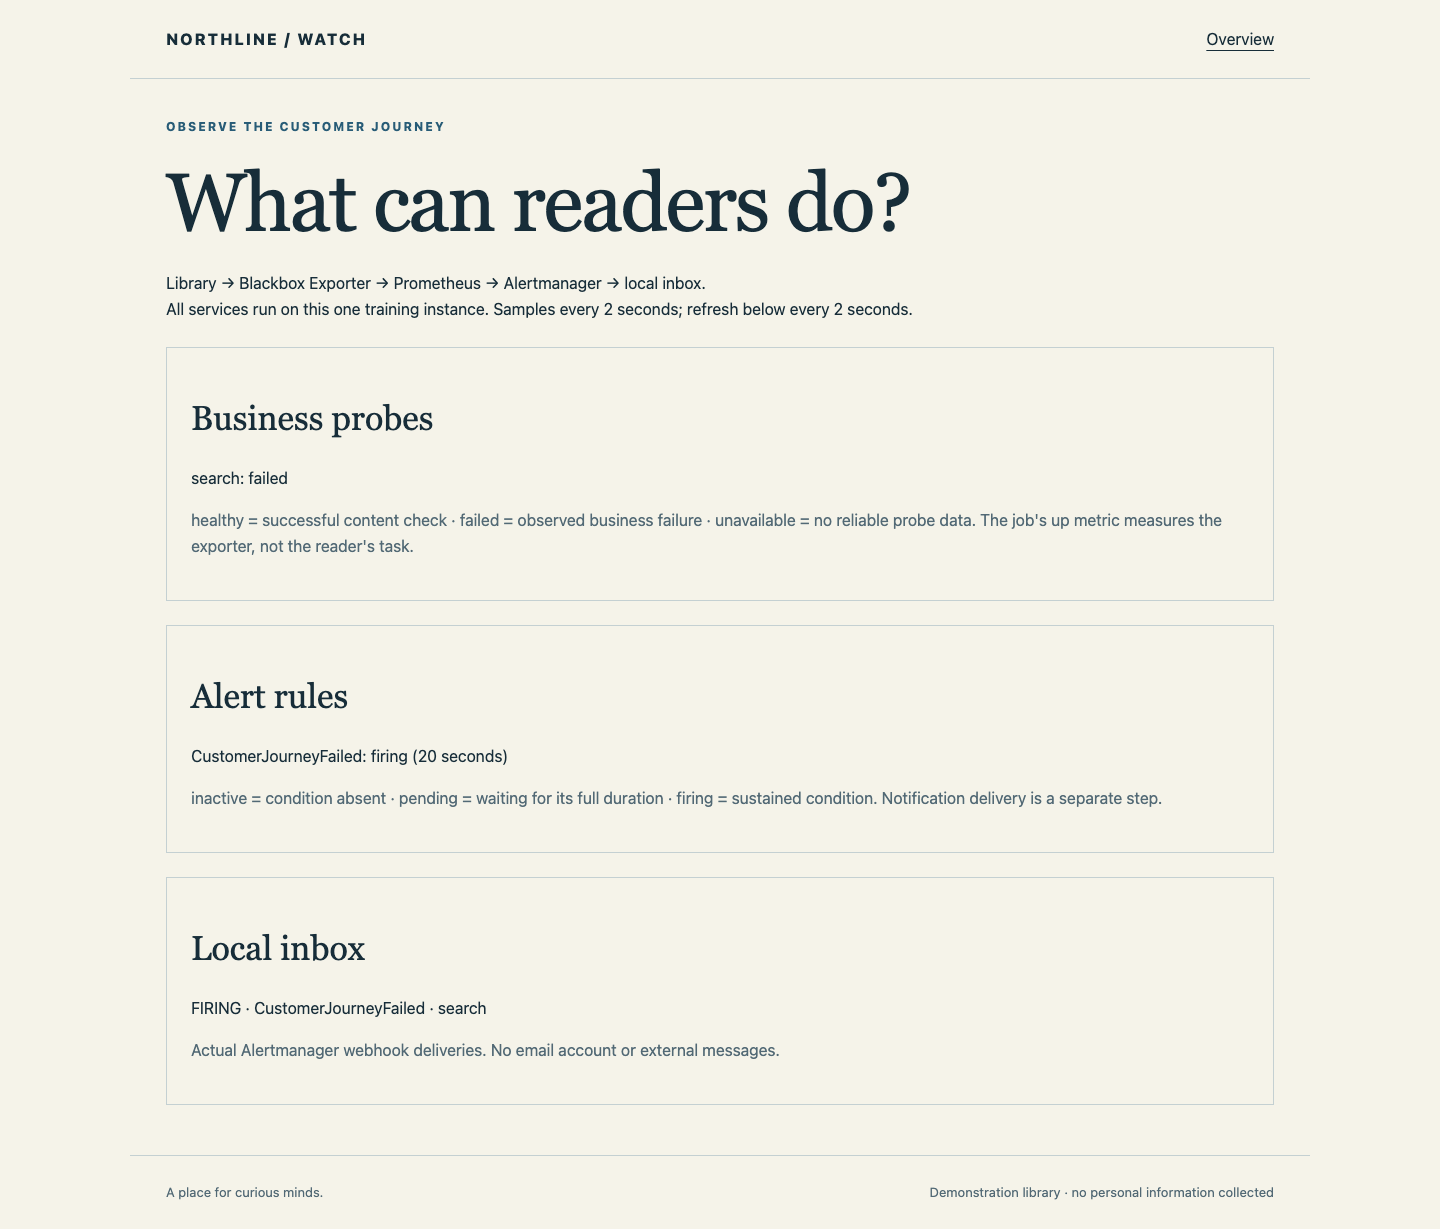
Cambia a Library. Vuelve a la portada con la marca: parece normal. Busca moon de nuevo. El mensaje demuestra que el lector no puede usar el catálogo. Cambia a Monitoring. Búsqueda aparece failed y la regla empieza pending. Unos 20 segundos después de la primera muestra fallida pasa a firing; el buzón debe añadir FIRING · CustomerJourneyFailed · search. Permite hasta 35 segundos desde el inicio para recogida, evaluación y entrega. Son observaciones reales, no una animación de progreso.
Si el buzón sigue vacío tras 35 segundos, cambia a Workstation y usa el comando de estado de solo lectura:
bash watch.sh status
Mira checks y alerts: unavailable indica ausencia de recogida; pending, que no ha transcurrido el plazo; firing sin evento en el buzón apunta a la entrega. Relee la configuración y recarga si la corriges. Puedes repetir un fallo de 60 segundos ya vencido. No fabriques avisos ni detengas la monitorización.
Recuperar y confirmar la resolución
Cambia a Workstation. Cero segundos restaura la búsqueda inmediatamente aunque no haya vencido el temporizador:
bash watch.sh fault search seconds 0
Cambia a Library y repite desde la portada la búsqueda moon. Deben volver Moon Atlas y Available. Abre de nuevo el libro y la vista de reserva; Visit también debe seguir funcionando.
Cambia a Monitoring. En unos 10 segundos, búsqueda vuelve a healthy, la alerta a inactive y el buzón añade RESOLVED · CustomerJourneyFailed · search. El aviso firing original permanece; resolved significa que terminó este fallo, no que la biblioteca nunca volverá a fallar.
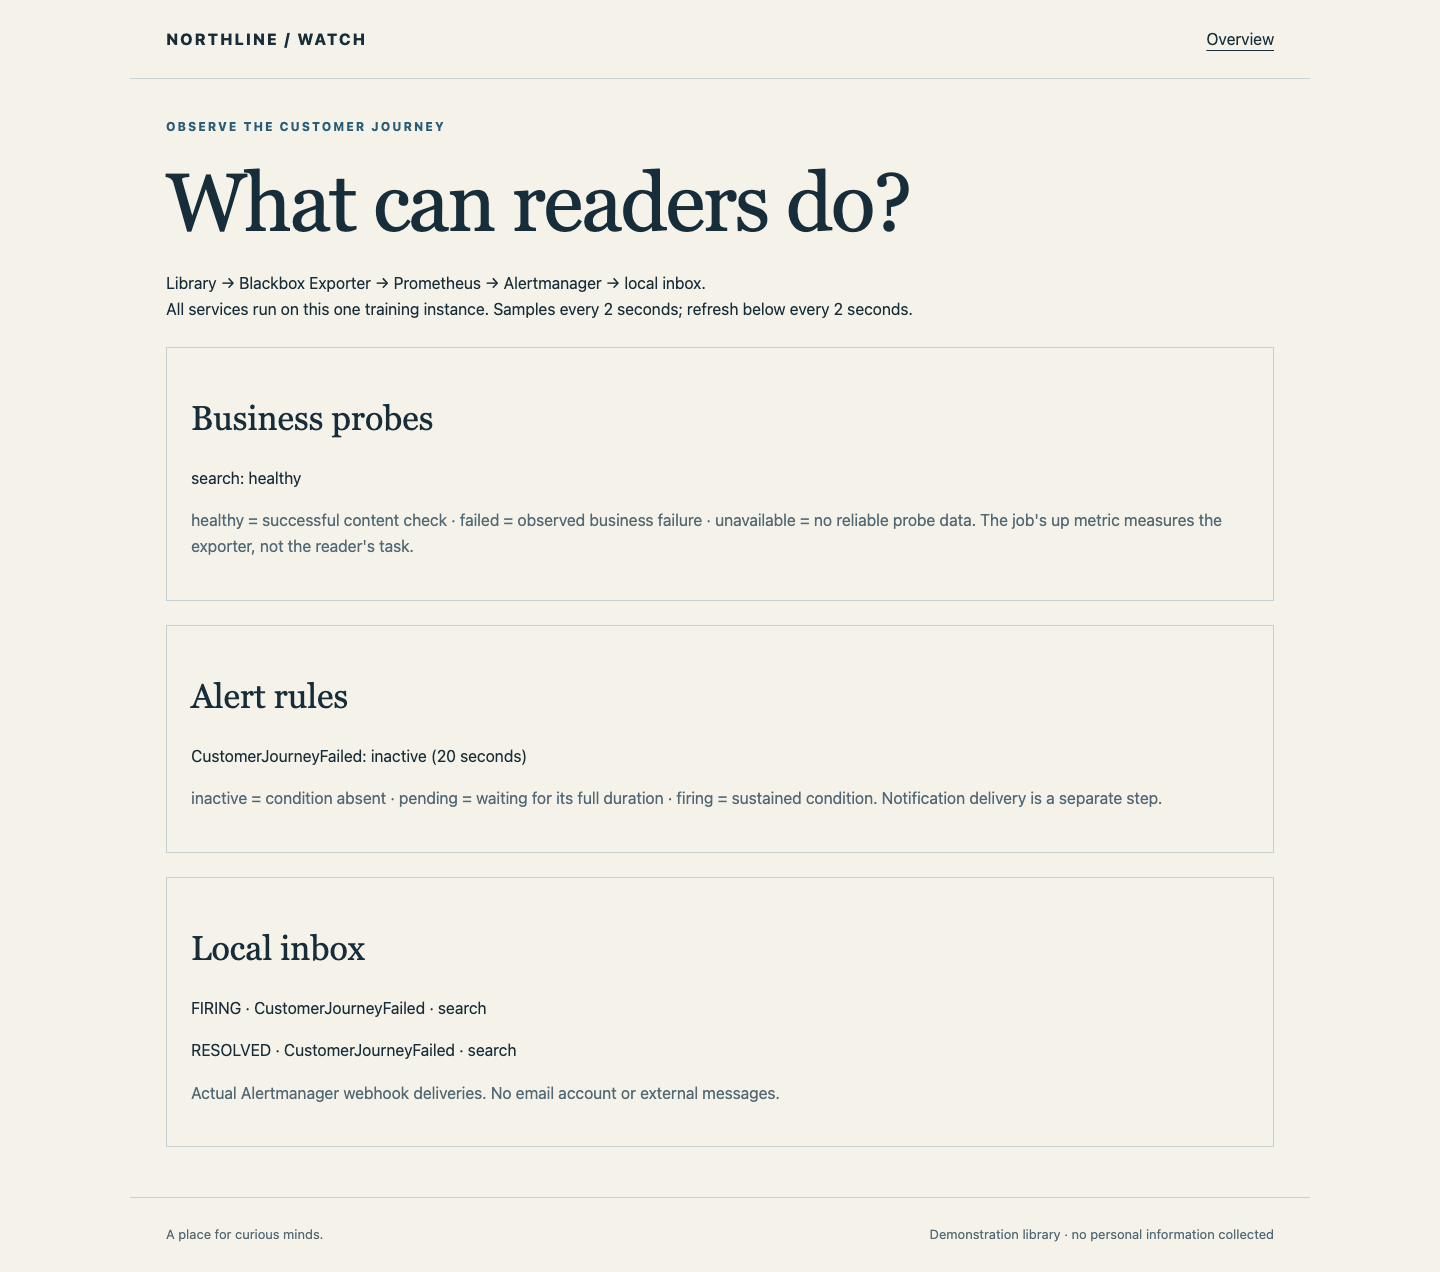
El paso comprueba la pareja real firing/resolved y la biblioteca utilizable actual. También prueba tu regla cargada con muestras aisladas sanas, breves, persistentes, recuperadas, ausentes y de fallos ajenos. La evaluación no provoca fallos, repara el servicio ni cambia la configuración. Deja la biblioteca sana y la regla preparada para fallos futuros.
Resumen
Seleccionaste una búsqueda real del cliente y una sonda que comprueba contenido, delimitaste la alerta con etiquetas, ignoraste un fallo breve y recibiste webhooks reales de fallo y recuperación. Distinguiste un exportador operativo de un servicio útil y la falta de datos del éxito. El desafío independiente aplica el método a reservas, excluyendo otro servicio averiado.