Introducción
Un endpoint de IA depende de más elementos que su código JavaScript. Un usuario puede enviar datos no válidos, el modelo seleccionado puede rechazar una solicitud, una cuenta puede alcanzar una cuota o un límite de velocidad, la capacidad puede no estar disponible temporalmente o el código de la aplicación puede fallar. Cada situación requiere una respuesta distinta. Tratar todos estos casos como «la IA falló» dificulta la operación de la aplicación y puede provocar reintentos innecesarios.
En este laboratorio, creará POST /draft-reply. Un modelo Llama alojado en Cloudflare redactará una respuesta breve de soporte. El Worker rechazará las entradas no válidas antes de ejecutar la inferencia, reconocerá los errores documentados del modelo y de los límites, reintentará un fallo transitorio como máximo una vez, validará la respuesta del modelo y notificará por separado los defectos de la aplicación. Un reintento limitado significa que el número máximo de intentos adicionales se fija de antemano; el proceso no puede repetirse hasta agotar la asignación gratuita de la cuenta.
Demostrará la mayoría de las rutas de fallo mediante fixtures deterministas. Un fixture es un sustituto controlado que devuelve un resultado o error elegido, de modo que pueda probar el comportamiento de cuotas y caídas del servicio sin consumir cuota deliberadamente ni provocar una interrupción real. Solo una solicitud local breve y una solicitud después del despliegue utilizarán el modelo real.
Este es el sexto laboratorio guiado del curso. Si ha llegado directamente, complete primero Conectar LabEx con su cuenta de Cloudflare para aprender a usar la terminal de la máquina virtual, autorizar Wrangler, confirmar su cuenta de aprendizaje y configurar su ID de cuenta.
El modelo seleccionado @cf/meta/llama-3.3-70b-instruct-fp8-fast está disponible mediante la asignación estándar de Workers AI. Actualmente, Workers Free incluye 10.000 Neurons al día. Este laboratorio no requiere Workers Paid mientras quede asignación gratuita. El ejercicio visible y la comprobación independiente realizan una solicitud breve correcta localmente y otra después del despliegue. La inferencia local sigue llegando a Cloudflare y consume uso de la cuenta, por lo que no debe repetir continuamente un fallo en una solicitud real.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 en el proyecto, ubicado en /home/labex/project/resilient-ai-reply. También proporciona fixtures deterministas y comprobaciones independientes. La configuración no autoriza Wrangler, no crea el código fuente del Worker, no invoca un modelo, no realiza el despliegue ni crea recursos en la nube.
Autorizar la máquina virtual y configurar el Worker resistente
En este paso, autorizará esta máquina virtual nueva y configurará un Worker desechable. Iniciar sesión en Cloudflare desde un navegador no autoriza automáticamente a Wrangler dentro de una máquina virtual de LabEx nueva.
Acceda al proyecto preparado y confirme la versión fijada de la CLI:
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
Ejecute el flujo de autorización del dispositivo:
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
Abra en el navegador la URL de autorización que se muestra, confirme la cuenta de aprendizaje correcta y apruebe los permisos indicados. Este ámbito de compatibilidad con KV es necesario para que esta versión de Wrangler elimine un Worker; el laboratorio no crea ni modifica datos de KV.
Confirme la autorización mediante una salida estructurada:
npx wrangler whoami --json
Compruebe que aparezca "loggedIn": true, confirme el nombre de la cuenta y copie el ID real de esa cuenta en la siguiente configuración. Genere un nombre único y cree wrangler.jsonc:
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
El binding AI proporciona al código del Worker una interfaz env.AI asociada a la cuenta. remote: true también hace que las solicitudes locales de Wrangler utilicen el servicio real de Workers AI y cuenten para la asignación compartida.
Separar las categorías de fallos
En este paso, convertirá varias causas de fallo muy distintas en un contrato público pequeño antes de escribir el código de recuperación.
Un estado HTTP informa al cliente del tipo de resultado obtenido. No debe exponer mensajes sin procesar del proveedor, datos de la cuenta ni trazas de pila. Este laboratorio utiliza cinco límites:
400 invalid_request: la entrada del usuario falta o supera el tamaño permitido, por lo que la inferencia no comienza.502 model_incompatibleoincompatible_model_response: el modelo seleccionado o la estructura devuelta no coincide con el contrato de la aplicación. Repetir la misma solicitud no resolverá la incompatibilidad.503 model_quota_exhaustedomodel_rate_limited: el límite de la cuenta o del modelo indica que debe detenerse. Un reintento automático inmediato consumiría otra solicitud y aumentaría la carga.503 model_temporarily_unavailable: un tiempo de espera o una falta temporal de capacidad se produjo dos veces. La respuesta incluyeRetry-Afterpara que el cliente pueda esperar antes de realizar otra solicitud.500 application_failure: la inferencia del modelo devolvió datos utilizables, pero falló el paso de formato de la propia aplicación.
Cloudflare documenta el código interno 3036 para una asignación gratuita diaria agotada, 3040 para una capacidad temporalmente no disponible, 3007 para un tiempo de espera y 5035 para un modelo que requiere Workers Paid. La aplicación convierte las señales conocidas en errores públicos estables y registra únicamente la categoría, el número de intentos y el ID de traza.
Genere las declaraciones de TypeScript e inspeccione el binding de AI:
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
La declaración generada demuestra que env.AI está disponible para el Worker. No demuestra que una llamada al modelo vaya a tener éxito; la autorización, la cuota, la compatibilidad del modelo y el estado del servicio son condiciones de ejecución.
Crear una recuperación limitada
En este paso, implementará la clasificación, el límite de un reintento y los límites separados para la respuesta del modelo y la aplicación.
Cree el punto de entrada del Worker:
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
El bucle de reintento permite dos intentos en total: la llamada inicial y una llamada adicional únicamente para una categoría transitoria conocida. Los fallos de cuota, límite de velocidad y compatibilidad se detienen de inmediato. Observe también que la llamada al modelo, la validación de la respuesta y el formato de la aplicación están separados. Esto permite distinguir un problema del proveedor de un defecto de la aplicación.
La respuesta pública nunca incluye la excepción sin procesar. Los registros omiten el mensaje de soporte y la respuesta generada; conservan únicamente los metadatos del ciclo de vida necesarios para investigar la categoría del fallo.
Demostrar la matriz de fallos sin consumir cuota
En este paso, probará cada categoría de fallo mediante fixtures controlados antes de realizar una solicitud real al modelo.
Ejecute la suite determinista:
node --test test/worker.test.mjs
Los nueve casos utilizan fixtures en lugar de inferencia real. Confirme que una entrada no válida realiza cero llamadas al modelo, que los errores de cuota y límite de velocidad realizan una llamada, que una falta temporal de capacidad realiza como máximo dos llamadas, que una salida con formato incorrecto se convierte en un fallo de compatibilidad y que un defecto de formato se convierte en un fallo de la aplicación.
Ahora genere el bundle exacto del Worker:
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
La ejecución de prueba comprueba que Wrangler pueda empaquetar el módulo y debería mostrar el binding AI. No realiza el despliegue ni llama al modelo.
Probar una inferencia correcta e inspeccionar las evidencias
En este paso, realizará una solicitud local correcta y otra después del despliegue. Después, relacionará sus resultados con las evidencias de solo lectura del Dashboard de Cloudflare.
Inicie Wrangler en segundo plano y espere a que esté disponible la ruta de estado que no utiliza AI. El bucle limitado evita esperar indefinidamente:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
La respuesta debe contener un reply no vacío, el modelo exacto, un ID de traza y attempts igual a 1 en el caso correcto habitual. Un valor de 2 significa que un fallo temporal se recuperó dentro del límite establecido.
Ejecute la comprobación local independiente, detenga el proceso guardado y realice el despliegue:
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Copie la URL exacta de workers.dev que aparece en la salida del despliegue y pruebe el endpoint público:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
El mensaje vacío debe devolver HTTP 400 antes de la inferencia. Esto demuestra la protección de entrada sin consumir otra solicitud al modelo.
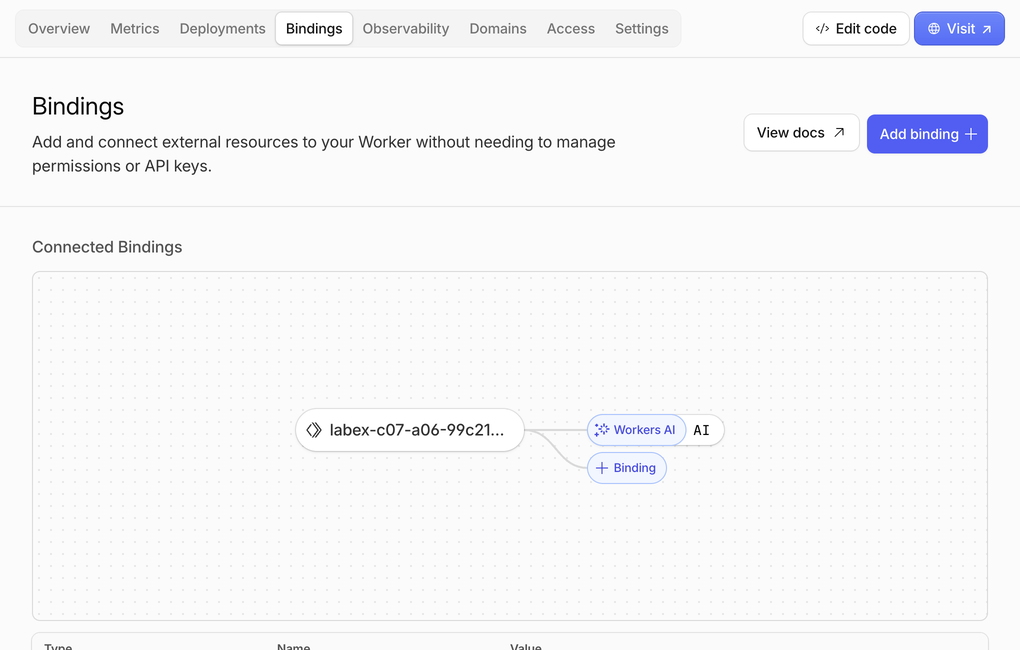
Abra Workers & Pages, seleccione el nombre exacto del Worker e inspeccione Bindings. Un binding es la conexión con nombre que permite al código del Worker acceder a otro servicio de Cloudflare sin almacenar una clave de API. Confirme una conexión de Workers AI llamada AI. El nombre de Worker del ejemplo corresponde a la ejecución de prueba; el suyo tendrá un sufijo aleatorio diferente.
A continuación, abra Observability. La ejecución de ejemplo produjo seis eventos correctos y cero errores. Los recuentos pueden variar porque una solicitud puede crear tanto un registro de invocación como un registro de aplicación, y los registros guardados pueden llegar después de la respuesta.
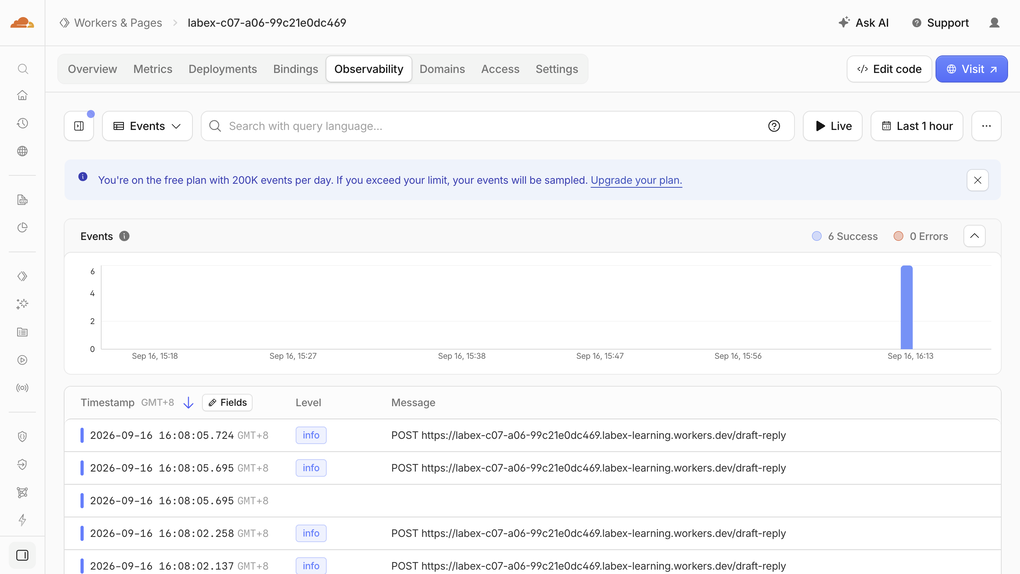
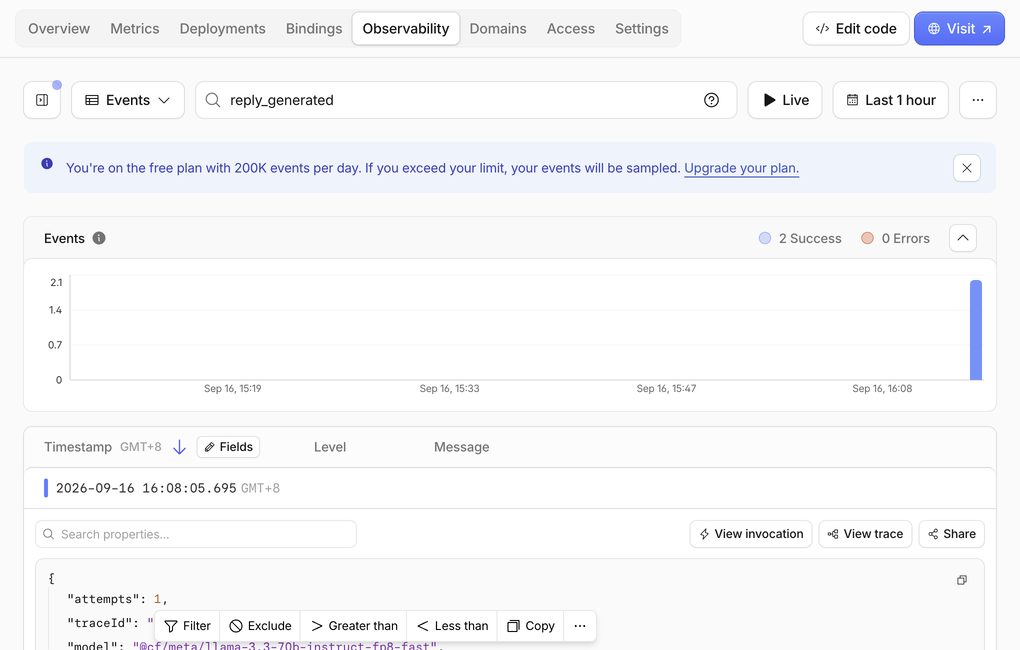
El aviso azul del plan Free que aparece aquí describe la asignación de eventos de Workers Logs, no el uso de inferencia de AI. Busque reply_generated y expanda uno de los resultados. El ejemplo centrado muestra dos coincidencias correctas y los campos deliberadamente limitados de la aplicación: un intento, un ID de traza y el modelo exacto. El evento completo también contiene event: "reply_generated", pero la aplicación no registra el mensaje de soporte, la respuesta generada ni el error sin procesar del proveedor.
Por último, abra AI > Workers AI y mantenga seleccionada la pestaña Neurons. Un Neuron es la unidad de Cloudflare para el cálculo de IA. La cuenta compartida del ejemplo mostraba 428.59/10k Neurons utilizados ese día: 427.82 atribuidos al modelo Llama y 0.77 a un laboratorio anterior de embeddings. Estos totales incluyen otros ejercicios del curso y pueden actualizarse con retraso; no representan el coste de una sola solicitud.
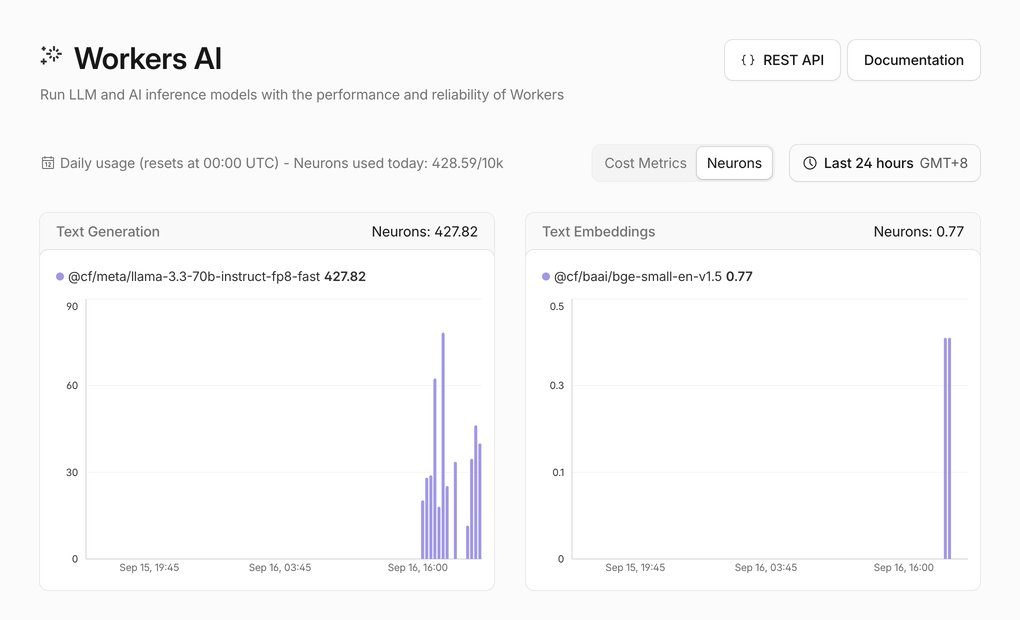
Confirme únicamente que el uso se mantiene dentro de la asignación diaria disponible. Las vistas del Dashboard ayudan a relacionar la configuración, el tráfico y el uso con el resultado de la línea de comandos, pero la respuesta en tiempo de ejecución y las comprobaciones independientes siguen siendo la referencia principal. No repita la inferencia solo para hacer que cambie un gráfico.
Eliminar el Worker y cerrar sesión
En este paso, eliminará el endpoint desechable mientras la autorización siga disponible y después quitará esa autorización de la máquina virtual.
Elimine únicamente el Worker desechable cuyo nombre está registrado en wrangler.jsonc:
npx wrangler delete --force
Confirme que ya no existe mientras Wrangler continúa autorizado:
./.labex/verify.py deleted
Ahora elimine la autorización almacenada de esta máquina virtual:
npx wrangler logout
npx wrangler whoami --json
Compruebe que aparezca "loggedIn": false y ejecute después la comprobación final:
./.labex/verify.py logout
Eliminar un Worker elimina el recurso en la nube; cerrar sesión elimina la autorización de esta máquina virtual. Son dos acciones de limpieza independientes.
Resumen
Ha creado un endpoint de Workers AI que:
- rechaza las entradas no válidas antes de la inferencia;
- mantiene diferenciados los fallos de compatibilidad, cuota, límite de velocidad, transitorios y de la aplicación;
- reintenta como máximo una vez un fallo transitorio conocido;
- valida la salida del modelo antes de aplicar el formato de la aplicación;
- devuelve errores públicos estables sin filtrar detalles sin procesar del proveedor;
- registra metadatos del ciclo de vida con límites de privacidad;
- demuestra el comportamiento ante fallos mediante fixtures deterministas sin desperdiciar cuota;
- confirma una inferencia correcta local y después del despliegue en Workers Free; y
- elimina el Worker desechable y cierra la sesión de la máquina virtual.
La práctica operativa importante no consiste en «reintentar cualquier error de IA». Consiste en identificar el límite correspondiente, reintentar solo una condición realmente transitoria dentro de un límite fijo y proporcionar al cliente una respuesta útil.