Introducción
Una búsqueda por palabras clave busca las mismas palabras. Una búsqueda semántica intenta encontrar texto con el mismo significado. Por ejemplo, “No puedo iniciar sesión” debería quedar cerca de un artículo sobre cómo restablecer una contraseña, aunque las frases no compartan todas las palabras.
Un modelo de embeddings convierte el texto en un vector: una lista ordenada de números que representa características que el modelo aprendió del lenguaje. Los textos con significados relacionados suelen apuntar en direcciones similares. En este laboratorio comparará esas direcciones mediante la similitud coseno, un cálculo que devuelve una puntuación mayor para los vectores más alineados. Una puntuación solo es útil para comparar vectores generados con el mismo modelo, la misma cantidad de dimensiones y la misma opción de pooling; no representa un porcentaje universal de veracidad.
Creará POST /search. El Worker genera el embedding de una consulta junto con tres pequeños artículos de ayuda mediante @cf/baai/bge-small-en-v1.5, alojado en Cloudflare. El modelo produce 384 números por texto. La aplicación valida cada vector antes de compararlo, rechaza valores incompatibles o no finitos y devuelve los identificadores de los artículos ordenados, sin exponer los vectores.
Este es el cuarto laboratorio del curso. Si accedió directamente, complete primero Conectar LabEx con su cuenta de Cloudflare para aprender a usar el terminal de la VM, autorizar Wrangler, confirmar su cuenta de aprendizaje y configurar su ID de cuenta.
Actualmente, las cuentas de Workers Free reciben una asignación diaria compartida de 10.000 Neurons. Este modelo cuesta aproximadamente 1.841 Neurons por millón de tokens de entrada, y este laboratorio utiliza solo unas pocas frases sintéticas cortas, por lo que no se requiere Workers Paid mientras quede asignación gratuita. La inferencia local sigue conectándose con Cloudflare y consume uso de la cuenta. Si el modelo o la asignación no están disponibles, deténgase en lugar de repetir la operación varias veces.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 local para el proyecto en /home/labex/project/search-embeddings. También proporciona pruebas deterministas y comprobaciones independientes. La configuración no autoriza Wrangler, no invoca un modelo, no implementa un Worker ni crea recursos en la nube.
Autorizar la VM y configurar el Worker de embeddings
En este paso autorizará esta VM nueva y configurará un Worker desechable. El inicio de sesión en el Dashboard pertenece a su navegador; Wrangler en esta VM necesita su propia autorización limitada.
Acceda al proyecto preparado y confirme la versión fijada de la CLI:
cd /home/labex/project/search-embeddings
npx wrangler --version
Debe aparecer 4.132.0. Solicite los permisos limitados que utilizan los laboratorios anteriores de Workers AI. El permiso de KV permite comprobar la dependencia de limpieza de Wrangler 4.132.0; este laboratorio no crea datos de KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra el enlace que aparece, introduzca el código actual, revise la cuenta y los permisos, y autorice su cuenta de aprendizaje. Después, consulte los datos de identidad estructurados:
npx wrangler whoami --json
Confirme loggedIn: true y genere un nombre único para el Worker:
RUN="labex-c07-a04-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Reemplace YOUR_ACCOUNT_ID por el ID real de la cuenta que desea utilizar:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
env.AI es un binding en el mismo proceso, no una clave de API del modelo incluida en el código fuente. remote: true significa que el desarrollo local sigue llamando al modelo asociado a la cuenta.
Comprender el contrato de los vectores
En este paso relacionará la configuración del modelo con los números que la aplicación debe validar.
Genere los tipos del entorno y confirme el binding de la plataforma:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Busque AI: Ai. El modelo BGE Small seleccionado devuelve un vector de 384 dimensiones por cada texto de entrada. Dimensión significa cantidad de posiciones, por lo que un lote de cuatro textos debe tener la forma [4, 384]. Cada posición debe ser un número finito: no puede ser NaN, infinito positivo ni infinito negativo.
Este laboratorio solicita explícitamente el pooling cls. El pooling es la forma en que el modelo condensa la información de los tokens en un solo vector. Los vectores creados con pooling cls y mean no son compatibles, aunque ambos tengan 384 posiciones. Por eso, la aplicación registra esta opción junto con el modelo y las dimensiones.
Revise los datos de prueba deterministas proporcionados:
grep -nE 'incompatible|non-finite|cosine similarity' test/worker.test.mjs
Estos datos permiten repetir las pruebas de error sin gastar Neurons. También evitan exigir una puntuación exacta de similitud en tiempo real, ya que esta puede cambiar según el comportamiento del modelo.
Crear el endpoint de similitud validada
En este paso implementará la solicitud de embeddings, la validación de vectores y la comparación local mediante similitud coseno. El Worker devuelve identificadores de documentos y puntuaciones, no los 1.536 números sin procesar de los cuatro vectores.
Cree el punto de entrada:
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const DIMENSIONS = 384;
const POOLING = "cls";
const MAX_QUERY = 300;
const DOCUMENTS = [
  { id: "password-reset", text: "Reset a forgotten password and regain account access." },
  { id: "upload-pdf", text: "Troubleshoot a PDF document that will not upload." },
  { id: "billing-receipt", text: "Download a receipt for a completed payment." }
];

export function validateEmbeddingBatch(result, expectedCount) {
  if (!Array.isArray(result?.shape) || result.shape[0] !== expectedCount || result.shape[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding shape");
  }
  if (!Array.isArray(result.data) || result.data.length !== expectedCount) {
    throw new Error("incompatible embedding count");
  }
  for (const vector of result.data) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return result.data;
}

export function cosineSimilarity(left, right) {
  if (left.length !== right.length || left.length === 0) throw new Error("incompatible vectors");
  let dot = 0, leftNorm = 0, rightNorm = 0;
  for (let index = 0; index < left.length; index += 1) {
    dot += left[index] * right[index];
    leftNorm += left[index] ** 2;
    rightNorm += right[index] ** 2;
  }
  if (leftNorm === 0 || rightNorm === 0) throw new Error("zero-length direction");
  return dot / (Math.sqrt(leftNorm) * Math.sqrt(rightNorm));
}

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuery(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const query = typeof body?.query === "string" ? body.query.trim() : "";
  if (!query) return { error: json({ error: "invalid_query" }, 400) };
  if (query.length > MAX_QUERY) return { error: json({ error: "query_too_large" }, 413) };
  return { query };
}

async function search(request, env) {
  const parsed = await readQuery(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let result;
  try {
    result = await env.AI.run(MODEL, { text: [parsed.query, ...DOCUMENTS.map((item) => item.text)], pooling: POOLING });
  } catch {
    console.error(JSON.stringify({ event: "embedding_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let vectors;
  try { vectors = validateEmbeddingBatch(result, DOCUMENTS.length + 1); }
  catch {
    console.error(JSON.stringify({ event: "embedding_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_embeddings", requestId }, 502);
  }
  const [queryVector, ...documentVectors] = vectors;
  const matches = DOCUMENTS.map((document, index) => ({ id: document.id, score: cosineSimilarity(queryVector, documentVectors[index]) }))
    .sort((left, right) => right.score - left.score);
  console.log(JSON.stringify({ event: "embedding_compared", requestId, model: MODEL, dimensions: DIMENSIONS, count: vectors.length, pooling: POOLING }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, matches, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/search") return search(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
La validación se ejecuta antes de calcular la similitud. Evita el truncamiento silencioso, las comparaciones sin sentido entre dimensiones distintas y las puntuaciones NaN. Los registros conservan los metadatos del ciclo de vida, pero omiten la consulta, el texto de los artículos y los vectores.
Ejecute las cinco pruebas deterministas y, después, cree el bundle sin implementarlo:
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
Las pruebas demuestran el funcionamiento de las operaciones matemáticas locales y del rechazo de datos. La ejecución de prueba confirma que el Worker y la configuración del binding se empaquetan correctamente.
Ejecutar un lote real de embeddings
En este paso ejecutará el controlador localmente mientras su binding de AI realiza una solicitud remota real de embeddings.
Inicie Wrangler en segundo plano y espere la ruta de comprobación que no usa AI:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
Envíe una consulta sintética breve:
curl --silent --show-error http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
Debe recibir model, dimensions: 384, pooling: "cls", tres identificadores ordenados y puntuaciones finitas. No exija puntuaciones exactas. El orden es una evidencia basada en esta consulta, no una garantía permanente del modelo.
Rechace una consulta vacía antes de ejecutar la inferencia:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' --data '{"query":""}'
Debe recibir {"error":"invalid_query"} y HTTP 400.
Implementar e inspeccionar las evidencias de los embeddings
En este paso implementará el mismo endpoint y relacionará las evidencias de ejecución con el Cloudflare Dashboard.
Detenga únicamente el proceso de desarrollo guardado y realice la implementación:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Guarde la URL exacta que muestra Wrangler y envíe una consulta pública:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/search" \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
Confirme que la respuesta registra el modelo, 384 dimensiones y el pooling cls, y que ordena exactamente los tres identificadores proporcionados con puntuaciones finitas.
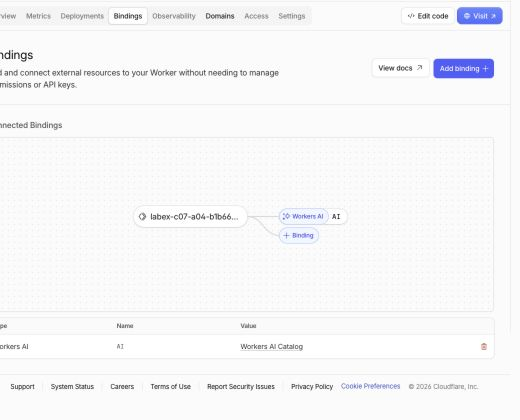
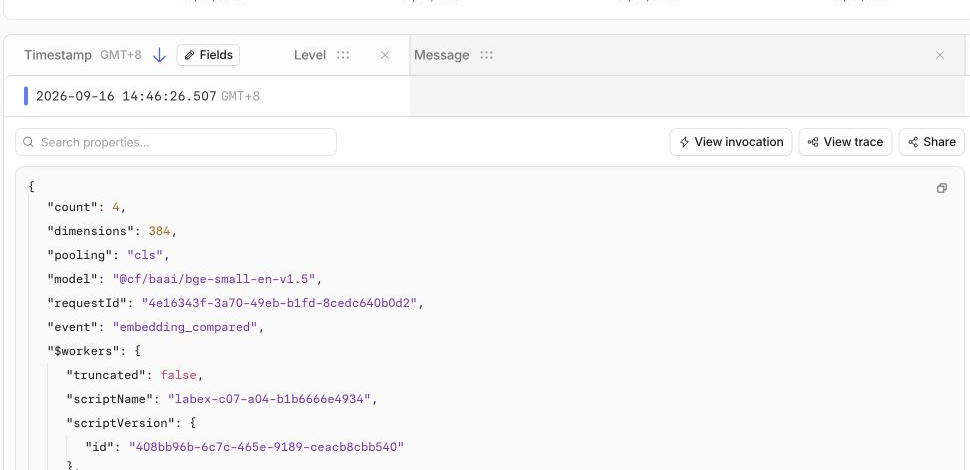
Abra Workers & Pages → Overview → su Worker labex-c07-a04-.... En Bindings, inspeccione el binding AI. En Observability → Logs, busque embedding_compared y expanda el evento. Confirme el modelo exacto, dimensions: 384, count: 4, pooling: cls y un ID de solicitud. La consulta, los documentos y los vectores deben estar ausentes.
La página Bindings hace visible la conexión: el Worker tiene un binding de Workers AI llamado AI. Un binding es el identificador seguro que utiliza el código como env.AI; no debe pegar una clave de API en el archivo fuente.
La vista general de Observability muestra solicitudes /search correctas y ningún error en esta ejecución desechable. Los totales exactos pueden variar porque cada solicitud de prueba se convierte en un evento.
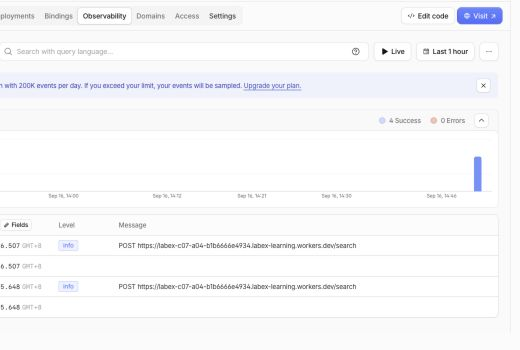
Expanda un evento embedding_compared. Este ejemplo centrado registra únicamente datos operativos útiles: se compararon cuatro textos, cada vector tenía 384 dimensiones, se utilizó el pooling cls y el modelo era @cf/baai/bge-small-en-v1.5. Deliberadamente, no registra la consulta del estudiante, el texto del documento ni cientos de números de los vectores.
Después, abra Workers AI. Busque el modelo BGE Small en el uso de hoy y confirme que esta ejecución limitada se mantiene dentro de la asignación gratuita compartida de 10.000 Neurons. Los datos del Dashboard pueden tardar en aparecer; espere brevemente en lugar de repetir la inferencia para forzar la actualización del gráfico.
En la cuenta Free utilizada durante la prueba, el modelo de embeddings consumió solo 0.29 Neurons, mientras que el uso total fue de 295.6 / 10k. El total mayor incluye otras pruebas del curso realizadas el mismo día, por lo que debe considerar estas cifras un ejemplo, no un resultado obligatorio. El punto de comprobación importante es que aparezca la fila de BGE Small y que el total diario permanezca por debajo de la asignación Free.
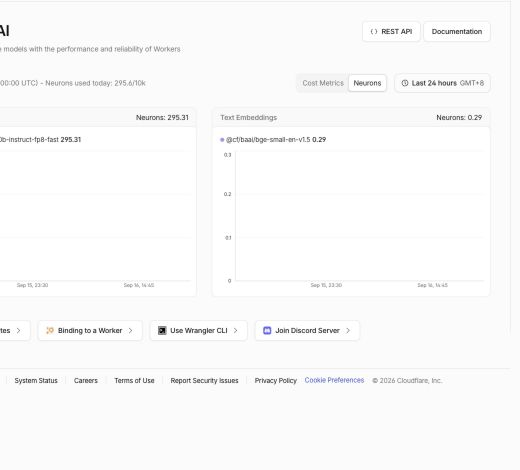
Los gráficos del Dashboard son una comprobación visual útil, pero la respuesta JSON y el script de verificación independiente siguen siendo las evidencias autoritativas de que el Worker implementado funciona correctamente.
Eliminar el Worker y cerrar la sesión
En este paso eliminará el endpoint desechable y, después, retirará la autorización de esta VM. El uso de Workers AI forma parte del historial de la cuenta, por lo que eliminar el Worker no borra ese registro de uso.
Elimine el Worker exacto indicado en wrangler.jsonc:
npx wrangler delete
Confirme únicamente cuando Wrangler muestre el nombre único de este laboratorio, labex-c07-a04-.... Espere Successfully deleted y, mientras todavía tenga autorización, ejecute la comprobación independiente de ausencia en la nube:
python3 .labex/verify.py deleted
Solo después de que muestre PASS: deleted, cierre la sesión y consulte el estado estructurado:
npx wrangler logout
npx wrangler whoami --json
Debe aparecer loggedIn: false. Cerrar una pestaña del navegador o no encontrar un archivo local no demostraría que se limpió el recurso en la nube.
Resumen
Generó embeddings de 384 dimensiones con un modelo alojado en Cloudflare, registró las opciones de compatibilidad, validó cada vector, comparó la dirección semántica mediante similitud coseno y rechazó datos incompatibles antes de ordenarlos. También verificó el binding activo y los registros limitados por privacidad, y después eliminó el Worker desechable y la autorización de la VM.