Introducción
Una aplicación normalmente sigue reglas escritas directamente en su código. La inferencia de inteligencia artificial (AI) añade un tipo de operación diferente: la aplicación envía datos de entrada a un modelo entrenado y el modelo genera un resultado. La instrucción y el contexto que se envían al modelo se denominan prompt. El texto generado puede variar entre solicitudes, por lo que una aplicación fiable controla la entrada y comprueba el resultado en lugar de esperar una frase exacta.
Cloudflare Workers AI permite que un Worker ejecute modelos de AI compatibles mediante la plataforma de Cloudflare. Un Worker es código de aplicación que responde a solicitudes en la red de Cloudflare. Un enlace de AI es la conexión configurada que hace que Workers AI esté disponible para ese código como env.AI; así se evita incluir en el proyecto una clave de API independiente del proveedor.
En este laboratorio, una aplicación de soporte necesita un resumen breve de un ticket antes de que un agente abra la descripción completa. Configurará un enlace de AI, implementará un endpoint POST /summaries, rechazará las entradas no adecuadas antes de consumir inferencia, probará el mismo Worker localmente, lo desplegará e inspeccionará la actividad real del Worker y de AI en el Cloudflare Dashboard. El laboratorio usa @cf/meta/llama-3.3-70b-instruct-fp8-fast, un modelo alojado en Cloudflare y disponible mediante la asignación gratuita estándar de Workers AI. No se evalúa la redacción de la respuesta, sino el contrato de la aplicación.
Antes de comenzar este curso, complete Connect LabEx to Your Cloudflare Account. En ese laboratorio aprenderá a usar el terminal de la VM de LabEx, la autorización del dispositivo, la confirmación de la cuenta y el guardado del ID real de la cuenta. También debe saber cómo un Worker pequeño de JavaScript gestiona una solicitud HTTP. No se requieren conocimientos de aprendizaje automático.
Actualmente, Workers AI proporciona a las cuentas Workers Free una asignación diaria compartida de 10.000 Neurons, la unidad de Cloudflare para medir el cómputo del modelo. Este laboratorio mantiene pequeños los prompts y la salida, y no requiere un plan de pago, pero el resto de la actividad de la misma cuenta utiliza la misma asignación. Revise las páginas actuales de Llama 3.3 y de precios de Workers AI antes de comenzar. Si la asignación diaria ya se ha utilizado, la inferencia fallará hasta que se restablezca el límite; no realice llamadas repetidas para intentar evitarlo. El desarrollo local de Workers AI también utiliza el modelo en la nube y consume parte de la asignación: no es una simulación sin conexión.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 local del proyecto en /home/labex/project/ticket-summary. También proporciona pruebas deterministas que imitan la respuesta de AI sin realizar llamadas al modelo. La configuración no realiza ningún inicio de sesión, cambio de plan, despliegue ni ejecución de inferencia. Mantenga esta VM abierta hasta eliminar el Worker temporal y verificar el cierre de sesión.
Autorizar la VM y seleccionar una cuenta
En este paso, conectará esta VM nueva de LabEx a su cuenta de aprendizaje de Cloudflare y creará una configuración única para el Worker. Una sesión del navegador en el Dashboard no autoriza automáticamente los comandos del terminal en la VM.
Entre en el proyecto preparado y confirme la versión fijada de Wrangler:
cd /home/labex/project/ticket-summary
npx wrangler --version
Debe aparecer 4.132.0. Inicie la autorización del dispositivo con solo los permisos que necesita este laboratorio. workers_scripts:write permite desplegar, leer y eliminar el Worker temporal. ai:write permite que el Worker invoque Workers AI. Wrangler 4.132.0 también comprueba las referencias a enlaces de KV al eliminar un Worker, por lo que workers_kv:write permite completar esa comprobación de limpieza aunque este laboratorio no cree ningún espacio de nombres de KV. Los permisos de lectura de la cuenta y del usuario le permiten confirmar que está utilizando la cuenta correcta.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra en el navegador el enlace que se muestra, introduzca el código actual del dispositivo, revise los permisos y seleccione su cuenta de aprendizaje. También puede aparecer Background Access, porque Wrangler debe seguir funcionando después del proceso del navegador. Autorice solo después de comprobar que la cuenta y la lista de permisos corresponden a este laboratorio. Después, vuelva al terminal y espere a que aparezca el mensaje de éxito.
npx wrangler whoami --json
Confirme loggedIn: true y, a continuación, lea name e id de la cuenta que desea utilizar, aunque solo aparezca una cuenta. El nombre ayuda a evitar el uso de una cuenta incorrecta; el ID es el valor estable que Wrangler guarda en la configuración.
Genere un nombre único para el Worker. openssl rand -hex 6 crea 12 caracteres hexadecimales aleatorios y $(...) los inserta en la variable del shell.
RUN="labex-c07-a01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Copie el ID de la cuenta seleccionada en la configuración siguiente reemplazando YOUR_ACCOUNT_ID. Un documento aquí escribe las líneas situadas entre los dos marcadores JSON en wrangler.jsonc. El marcador sin comillas permite expandir $RUN, mientras que la barra inversa mantiene literal la clave $schema.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
compatibility_date fija el comportamiento del entorno de ejecución que prueba este laboratorio. observability conserva las invocaciones y los registros de la aplicación para el punto de comprobación posterior en el Dashboard. Escribir el archivo no despliega un Worker ni realiza una llamada al modelo.
Inspeccionar el enlace de Workers AI
En este paso, convertirá la configuración en una descripción tipada del entorno del Worker y conectará el nombre del enlace con el código que escribirá a continuación.
Un enlace es una capacidad con nombre que proporciona el entorno de ejecución de Workers. El nombre AI en wrangler.jsonc significa que el Worker utilizará env.AI para ejecutar modelos. No hay ningún token de API en el código fuente: Cloudflare conecta el Worker desplegado con la cuenta seleccionada. La configuración remote: true es importante durante wrangler dev, porque la inferencia del modelo siempre se realiza en Cloudflare, incluso cuando el propio controlador de solicitudes se ejecuta desde esta VM.
Genere la descripción de tipos del entorno a partir de la configuración del proyecto:
npx wrangler types
Wrangler crea worker-configuration.d.ts. Busque la entrada Env generada en lugar de leer el archivo completo:
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
La salida incluye un enlace de AI similar a este:
interface __BaseEnv_Env {
    AI: Ai;
}
Wrangler coloca los enlaces generados en una interfaz base y después la amplía con Env. La línea AI: Ai es la comprobación de coherencia útil: si cambia el nombre del enlace en la configuración y olvida actualizar el código, el despliegue podría completarse, pero fallaría durante la ejecución. Regenere los tipos cada vez que cambien los enlaces. Más adelante, una ejecución completa de prueba de despliegue validará conjuntamente esta configuración y el paquete del Worker.
Crear un endpoint de resumen con límites
En este paso, implementará el límite de entrada de la solicitud y la llamada al modelo. Un modelo de lenguaje es bueno para generar una explicación concisa, pero no debe decidir si una solicitud arbitraria es segura para procesar. El código normal de la aplicación debe rechazar el tipo de contenido incorrecto, el JSON mal formado, los detalles ausentes y las entradas demasiado grandes antes de ejecutar la inferencia.
El endpoint enviará dos mensajes al modelo. Un mensaje del sistema define el papel del modelo y la restricción de la respuesta. Un mensaje del usuario contiene el ticket sintético. Los modelos leen y generan tokens, pequeñas partes de texto que pueden ser una palabra, parte de una palabra o un signo de puntuación. max_tokens limita la salida generada, mientras que la aplicación limita por separado el número de caracteres recibidos. Son controles diferentes: uno limita lo que envía y el otro limita lo que el modelo puede generar. temperature controla la variación que puede utilizar el modelo; el valor bajo de este ejemplo favorece un resumen estable, pero no garantiza una redacción idéntica.
Cree el punto de entrada del Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_DETAILS = 2000;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readTicket(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 4096) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const subject = typeof body?.subject === "string" ? body.subject.trim() : "";
  const details = typeof body?.details === "string" ? body.details.trim() : "";
  if (!details) {
    return { error: json({ error: "invalid_ticket" }, 400) };
  }
  if (subject.length > 120 || details.length > MAX_DETAILS) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }
  return { ticket: { subject, details } };
}

async function summarize(request, env) {
  const requestId = crypto.randomUUID();
  const parsed = await readTicket(request);
  if (parsed.error) return parsed.error;

  try {
    const result = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Summarize this support ticket in one plain sentence. Do not invent facts."
        },
        {
          role: "user",
          content: `Subject: ${parsed.ticket.subject || "(none)"}\nDetails: ${parsed.ticket.details}`
        }
      ],
      max_tokens: 120,
      temperature: 0.2
    });

    const summary = result.response?.trim();
    if (!summary) throw new Error("empty model response");

    console.log(JSON.stringify({
      event: "ticket_summarized",
      requestId,
      model: MODEL,
      inputCharacters: parsed.ticket.details.length,
      totalTokens: result.usage?.total_tokens ?? null
    }));

    return json({ summary, model: MODEL, requestId });
  } catch (error) {
    console.error(JSON.stringify({
      event: "ticket_summary_failed",
      requestId,
      model: MODEL,
      reason: error instanceof Error ? error.message : "unknown"
    }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/summaries") {
      return summarize(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Cada solicitud recibe un ID de solicitud aleatorio que aparece tanto en la respuesta como en el registro, de modo que puede rastrearse una solicitud sin registrar su ticket. El código registra ese ID, el modelo elegido y varios recuentos, pero no el texto del ticket. Esto hace que la observabilidad —los registros que ayudan a entender lo que hizo el Worker— sea útil sin copiar el contenido del cliente en los datos de supervisión. También valida la cadena response que devuelve este modelo concreto en lugar de suponer que todos los modelos de Workers AI devuelven el mismo objeto.
Ejecute las pruebas deterministas proporcionadas. Estas sustituyen env.AI por un accesorio pequeño, por lo que no consumen uso del modelo:
node --test test/worker.test.mjs
Espere cuatro pruebas aprobadas. Después, pida a Wrangler que compile el Worker sin desplegarlo:
npx wrangler deploy --dry-run
Las pruebas demuestran los contratos de entrada y salida con datos controlados del modelo. La ejecución en seco demuestra que Wrangler puede empaquetar el Worker real. Ninguna de las dos comprueba que el modelo esté disponible actualmente ni que la cuenta conserve la asignación diaria gratuita; comprobará eso a continuación con una solicitud real.
Ejecutar una inferencia local
En este paso, ejecutará el controlador de solicitudes desde la VM mientras su enlace AI llama al modelo real alojado en Cloudflare. Esto se denomina desarrollo local, pero solo el proceso del Worker es local: la inferencia es remota y se contabiliza.
Inicie Wrangler en el puerto 8787 en segundo plano. > guarda los registros en un archivo, 2>&1 envía los errores al mismo archivo y & devuelve el prompt del terminal mientras el servidor continúa ejecutándose. Guardar $! registra el ID del proceso para limpiarlo después.
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Espere hasta que responda la ruta de comprobación de estado:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
La respuesta de estado debe ser {"status":"ok"} y no llama al modelo. Ahora envíe un ticket sintético pequeño. --data convierte la solicitud en una solicitud POST, mientras que la cabecera indica al Worker que debe analizar JSON.
curl --silent --show-error http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Invoice upload fails","details":"After signing in, the customer selects a PDF invoice. The upload stops before completion and no confirmation appears."}' | jq
Espere un summary no vacío, el ID exacto del modelo y un requestId específico de esta ejecución. La frase puede diferir de este ejemplo:
{
  "summary": "The customer cannot complete a PDF invoice upload after signing in.",
  "model": "@cf/meta/llama-3.3-70b-instruct-fp8-fast",
  "requestId": "..."
}
Demuestre que el código normal rechaza las entradas no válidas antes de ejecutar la inferencia:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"details":""}'
Espere {"error":"invalid_ticket"} y HTTP 400. La aplicación no envía esta solicitud al modelo. Si la solicitud válida devuelve model_unavailable, inspeccione .labex/dev.log; una asignación gratuita agotada, la falta de capacidad del modelo o un error de autorización no demuestran que el contrato del endpoint haya pasado.
Desplegar e inspeccionar el Worker de AI
En este paso, detendrá el proceso local, desplegará el mismo código en Cloudflare y relacionará las pruebas obtenidas desde la línea de comandos con el estado visible en el Dashboard.
Detenga únicamente el proceso de desarrollo guardado y espere a que termine:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Despliegue el Worker:
npx wrangler deploy
Wrangler mostrará la URL pública de workers.dev. Guarde esa URL exacta reemplazando el valor de ejemplo siguiente:
WORKER_URL="https://YOUR_WORKER_URL"
Envíe un ticket sintético nuevo al endpoint desplegado:
curl --silent --show-error "$WORKER_URL/summaries" \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Password reset loop","details":"The customer opens the reset email, chooses a new password, and returns to the sign-in page, but the old password remains active."}' | jq
La frase generada puede variar, pero model debe identificar Llama 3.3 y requestId debe estar presente. Esto demuestra que el Worker público alcanzó su enlace de AI configurado.
Abra el Cloudflare Dashboard y vaya a Workers & Pages → Overview → su Worker labex-c07-a01-... → Settings → Bindings. Busque el enlace de Workers AI llamado AI. Esta es la conexión visible entre wrangler.jsonc y env.AI en el código.
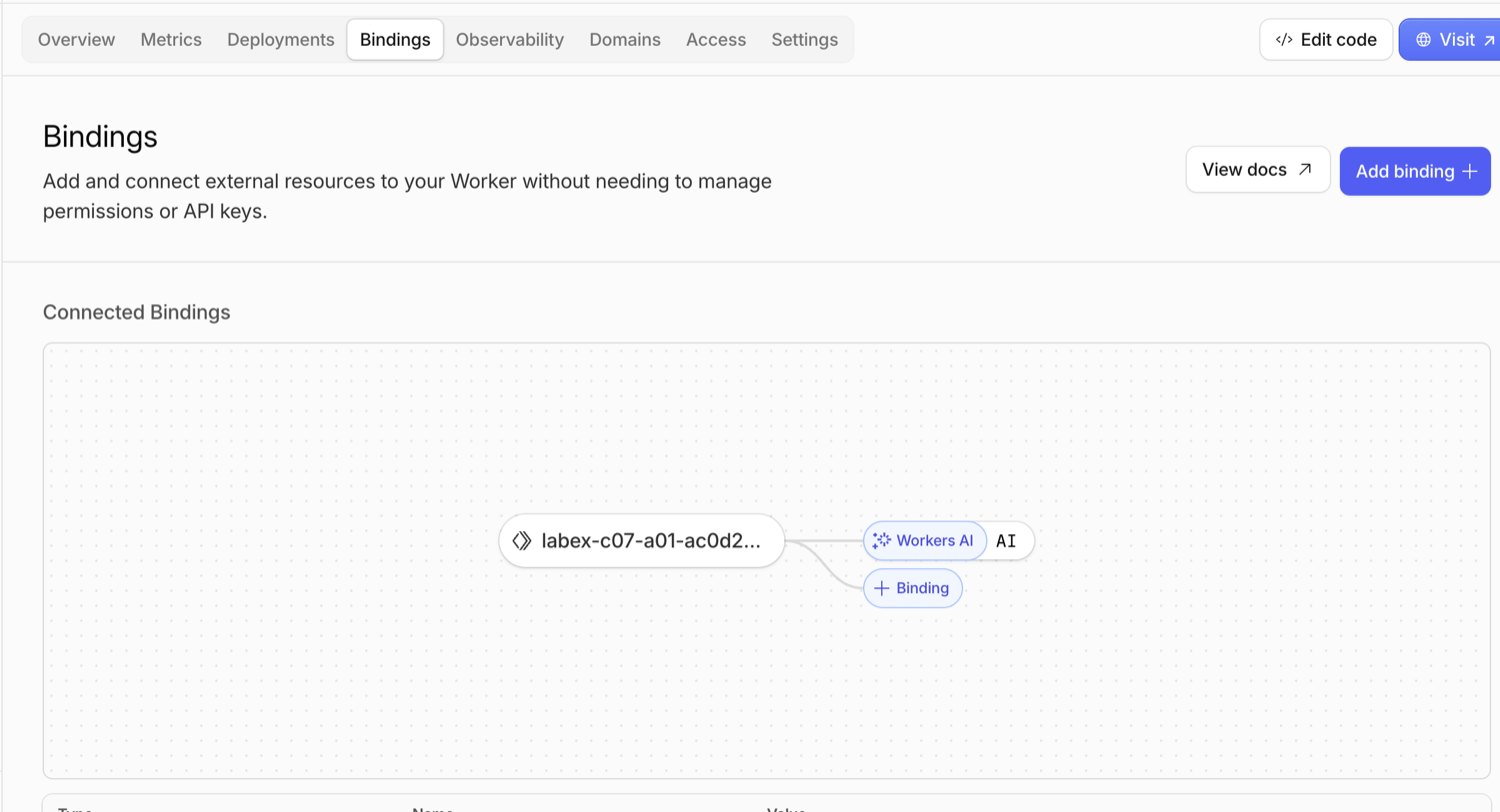
El ejemplo muestra el nombre de enlace AI, que coincide con el nombre utilizado por env.AI. El nombre de su Worker temporal será diferente.
A continuación, abra Observability → Logs para el mismo Worker. Busque una invocación correcta reciente y amplíe el registro estructurado ticket_summarized. Compare su ID de solicitud con el de la respuesta desplegada. El registro debe mostrar el modelo y los recuentos, pero no el texto del ticket. Si los registros guardados todavía no han llegado, utilice Real-time logs, envíe otra solicitud sintética pequeña e inspeccione esa invocación.
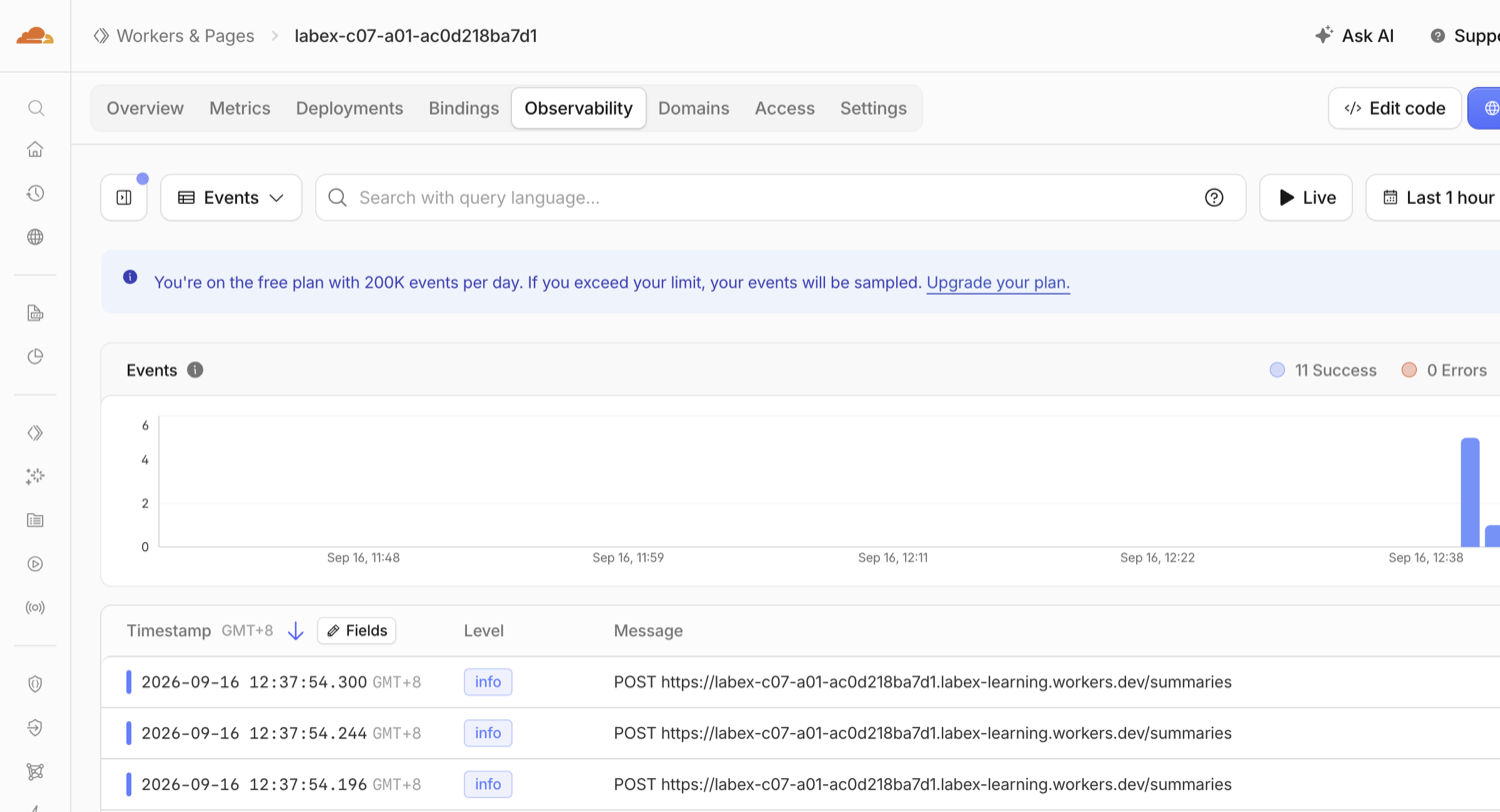
La vista general confirma primero que las solicitudes llegaron al Worker sin errores. Al abrir una solicitud se muestra el evento estructurado de la aplicación:
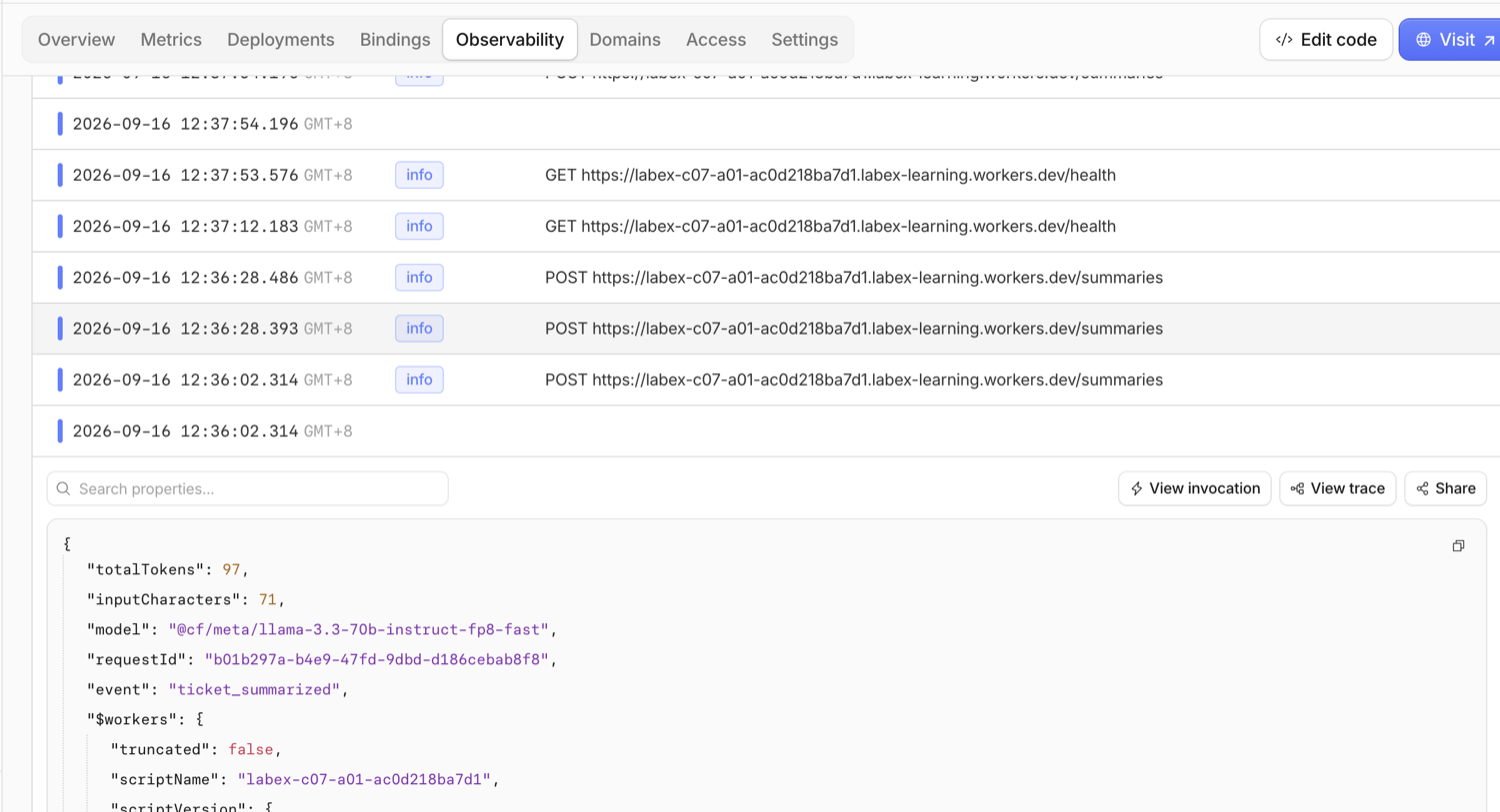
Observe que el registro contiene datos operativos como el modelo, el recuento de tokens y el ID de solicitud, pero no el asunto ni los detalles del ticket de soporte. Este es el límite de privacidad creado por el código de registro que escribió.
Por último, abra Workers AI desde la navegación de Developer Platform e inspeccione la vista de uso. Busque actividad reciente del modelo o uso de Neurons asociado a esta prueba acotada. Los datos de uso pueden llegar después de la solicitud; un gráfico vacío inmediatamente después no permite sacar conclusiones y no debe “solucionarse” generando llamadas de inferencia repetidas.
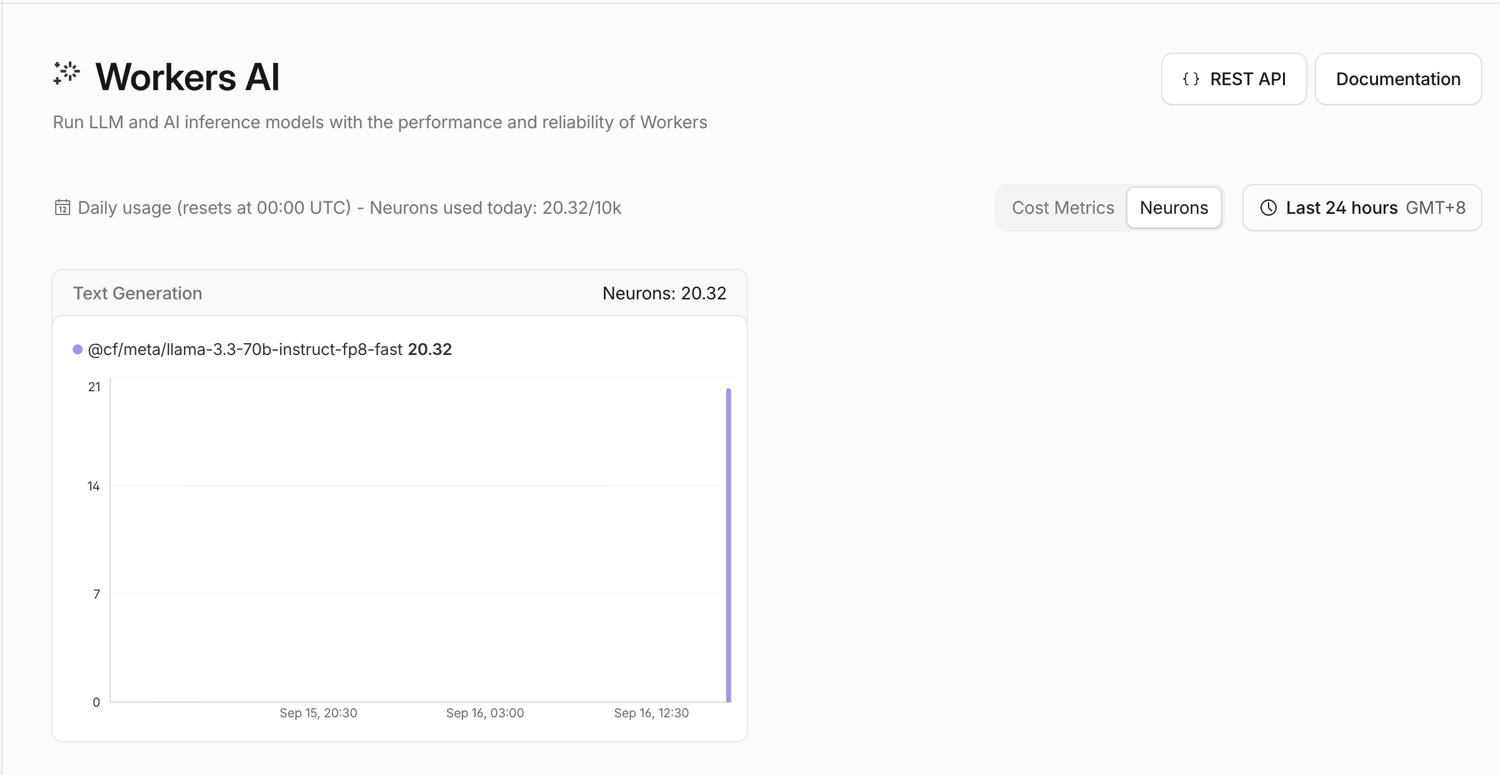
Aquí, 20.32/10k significa que esta ejecución de aceptación consumió solo una pequeña parte de la asignación diaria Free de esa cuenta. El total incluye cualquier otra actividad de Workers AI de su cuenta de aprendizaje, por lo que no coincidirá con la captura de pantalla.
Las capturas de pantalla del Dashboard de este laboratorio muestran valores de ejemplo de una ejecución de aceptación temporal. El nombre de su Worker, el ID de solicitud, las marcas de tiempo, los recuentos de tokens y los totales de uso serán diferentes.
Eliminar el Worker y cerrar sesión
En este paso, eliminará la aplicación temporal en la nube y después revocará la sesión de Wrangler de esta VM. Eliminar el Worker detiene su endpoint público. No cambia su plan de Workers ni borra los registros de uso de la cuenta.
Elimine el Worker cuyo nombre aparece en wrangler.jsonc:
npx wrangler delete
Confirme la eliminación cuando Wrangler muestre el nombre único de este laboratorio. No elimine ninguna otra aplicación. En el Dashboard, vuelva a Workers & Pages → Overview y confirme que el Worker exacto labex-c07-a01-... ya no aparece. Los registros históricos o el uso pueden permanecer después de eliminar el script.
Wrangler comprueba si otro Worker depende de este antes de finalizar. Por eso el inicio de sesión anterior incluía permisos de limpieza de KV aunque su aplicación no utilizara KV; una eliminación correcta debe devolverle al prompt sin un error de autenticación.
Ejecute la comprobación de eliminación mientras la VM todavía está autorizada:
python3 .labex/verify.py deleted
Solo después de que muestre PASS: deleted, elimine la autorización almacenada:
npx wrangler logout
npx wrangler whoami --json
La salida final debe indicar loggedIn: false. Un error de red no demuestra que se haya cerrado la sesión.
Resumen
Conectó un Worker a un modelo alojado en Cloudflare mediante un enlace de AI, limitó la entrada y la salida generada, probó el comportamiento determinista antes de consumir uso del modelo, ejecutó inferencia real de forma local y después del despliegue, y relacionó la respuesta con las pruebas de enlaces, registros y uso del Dashboard. También eliminó el Worker temporal y cerró de forma segura la sesión de la VM nueva.