Introducción
La comparación de personas asignadas del taller da a la página B una tasa de inscripción mayor. ¿Podría la asignación aleatoria producir grupos de aspecto diferente aunque la página asignada no cambiara el resultado de nadie? Un pequeño intercambio manual concreta la pregunta antes de generar una distribución de diferencias realmente aleatorias.
Este entorno independiente ya contiene las funciones correctas para construir resultados por persona y comparar tasas, enseñadas en el laboratorio anterior, además de sus propios datos originales. Necesitas esas ideas, funciones de Python, arrays básicos de NumPy y Matplotlib introductorio. No se necesitan archivos de una VM anterior ni conocimientos de inferencia estadística. Guardarás 399 reasignaciones exploratorias y su gráfico real; aquí no calcularás un valor p ni elegirás un ganador. Todos los registros son ejemplos didácticos sintéticos originales. Los 55 minutos son una estimación del autor que incluye lectura y correcciones habituales.
Intercambia personas sin cambiar los tamaños de grupo
En este paso calcularás una diferencia de seis personas, intercambiarás dos pertenencias de grupo y verás por qué la comparación puede cambiar.
Empieza en WebIDE, abre Terminal → New Terminal y entra en el directorio de esta unidad:
cd /home/labex/project/signup-experiment
cat lee archivos sin modificarlos. Revisa las fichas del ejemplo y las dos funciones preparadas:
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
Las seis fichas tienen resultados binarios [1, 0, 0] en A y [1, 1, 0] en B. Cada 1 o 0 pertenece a una persona asignada; las filas de eventos repetidas no son observaciones adicionales. En A se inscribió 1/3, en B 2/3, y B−A es aproximadamente +33.33 puntos porcentuales.
Ahora imagina intercambiar el grupo de la segunda persona de A (resultado 0) y el de la primera de B (resultado 1). A pasa a ser [1, 1, 0], B pasa a [0, 1, 0] y la diferencia se acerca a −33.33 puntos porcentuales. Sigue habiendo tres personas en cada grupo y tres resultados positivos en total. Cambiaste la asignación, no los resultados individuales ni el tamaño de la muestra.
Escribe la función de diferencia. np.mean calcula la media de los valores binarios de un array de NumPy. Resta la media de A a la de B y multiplica la diferencia por 100 para obtener puntos porcentuales. La función provisional sample_null se completará después; definirla no la ejecuta.
El > del shell sustituye el archivo. El here-document entre comillas <<'PY' copia el bloque completo hasta el PY final, sin expansión del shell. También puedes guardar el mismo contenido con File → Save en WebIDE.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
La etapa contrast del ejecutor proporciona las fichas originales y exactamente el intercambio descrito, llama dos veces a tu función y guarda ambos resultados reales:
python3 run.py contrast
El lector muestra el archivo guardado sin reconstruirlo:
python3 show_results.py contrast
Espera un original_pp próximo a +33.33 y un swapped_pp próximo a −33.33. Ninguno predice qué le ocurriría a una persona real en otra página. Muestran cómo la composición del grupo puede cambiar una comparación mientras los mismos seis resultados permanecen fijos.
Puedes editar resample.py y, más adelante, plot.py, o añadir archivos auxiliares normales de Python junto a ellos. Conserva los CSV originales, las opciones, el diccionario, el ejecutor y el lector. Si estás en otro directorio, usa pwd y ls y repite el cd anterior. Vuelve a copiar un bloque completo de función para corregir una edición; setup se niega a sobrescribir un directorio de trabajo existente.
Genera reasignaciones reales
En este paso volverás a mezclar repetidamente los resultados de todos los visitantes en grupos de sus tamaños originales y guardarás cada diferencia obtenida.
Continúa en la misma terminal de WebIDE, en /home/labex/project/signup-experiment. La muestra fija completa tiene 12 personas asignadas, seis por grupo. La función preparada de resultados usa las ventanas completas de siete días. Lee las entradas completas reales si quieres localizar de nuevo a las personas sin eventos y los casos de frontera:
cat assignments.csv
cat events.csv
Bajo la hipótesis nula de ausencia de efecto de este ejercicio, la página asignada no cambia el resultado binario de ninguna persona. Por tanto, reasignar esos resultados individuales fijos entre ambos grupos muestra la variación esperada solo por la asignación. La hipótesis depende del diseño aleatorizado que representan estos registros sintéticos. Mezclar un registro observacional cualquiera de un sitio web no crearía un experimento aleatorizado.
np.concatenate([a, b]) reúne los dos arrays. np.random.default_rng(seed) crea un generador seudoaleatorio con un estado inicial reproducible. Su método permutation devuelve una copia mezclada y deja intacto el original reunido. El segmento shuffled[:len(a)] toma la primera parte del tamaño de A; shuffled[len(a):] toma la parte restante del tamaño de B. Cada extracción usa una vez a cada persona y conserva ambos tamaños de grupo. No mezcles las filas de eventos originales que repiten personas.
Sustituye el archivo por las dos funciones completas. El bucle for realiza el número solicitado de extracciones; append conserva cada diferencia calculada. Devolver un array conserva toda la muestra, no solo su promedio o una extracción favorable.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
El ejecutor llama a estas funciones con la muestra completa por persona y guarda sus recuentos de grupo reales, la diferencia observada y las 399 diferencias mezcladas. --seed proporciona el estado inicial reproducible; los dos guiones indican una opción con nombre.
python3 run.py sample --seed 17
python3 show_results.py sample
Los datos completos siguen teniendo 1 de 6 personas inscritas en A y 5 de 6 en B, con una diferencia observada cercana a +66.67 puntos porcentuales. null_count debe ser 399. El lector solo muestra las ocho primeras extracciones como null_preview para limitar la salida; el array completo se guarda en output/sample.json.
Genera otra muestra ordinaria para comprobar por qué una semilla no es una respuesta definitiva:
python3 run.py sample --seed 42
python3 show_results.py sample
Esto sustituye la muestra guardada por la ejecución real con semilla 42. La secuencia suele cambiar, mientras los resultados individuales originales, los tamaños de grupo y la comparación observada permanecen iguales. Repetir la misma semilla debe reproducir la misma secuencia. Se permite cualquier semilla no negativa reproducible y cualquier implementación equivalente de muestreo independiente; no se exige la secuencia del autor. No sigas ejecutando para encontrar una muestra que parezca favorecer una página. El análisis exacto posterior usa todas las asignaciones, no la muestra exploratoria de mejor aspecto.
Cada estadístico mezclado está entre −100 y +100 puntos porcentuales, aunque no todos los números de ese intervalo son alcanzables. Para el ejemplo inicial de seis personas, las 20 asignaciones distintas de tres contra tres producen recuentos 1, 9, 9, 1 en las diferencias −100, −100/3, +100/3, +100. La muestra completa de 12 personas tiene 924 asignaciones: sus recuentos son 1, 36, 225, 400, 225, 36, 1 en −100, −200/3, −100/3, 0, +100/3, +200/3, +100. El siguiente laboratorio calcula estos valores exactamente en vez de pedirte que memorices los recuentos.
En esta tarea exploratoria de entrenamiento, la frecuencia muestral de cada diferencia alcanzable puede desviarse de su frecuencia exacta de referencia como máximo 0.15 en proporción absoluta. Por ejemplo, 0.40 y 0.46 difieren en 0.06. Es una tolerancia de aceptación del entrenamiento deliberadamente amplia, no un intervalo de confianza, un umbral de significación, una garantía comercial ni un criterio para elegir la semilla. Permite muestras ordinarias y métodos independientes sin exigir arrays idénticos. En un ejemplo válido con todos los resultados a cero, cada diferencia reasignada es cero; no se exige una dispersión distinta de cero.
El contrato de la función se aplica a los arrays binarios proporcionados y a las mismas variaciones acotadas del curso: al menos dos personas en cada grupo y 14 como máximo en total. Las comprobaciones usan entradas y semillas aisladas, incluidos otros tamaños de grupo, diferencias negativas y nulas y resultados degenerados. Nunca sustituyen la muestra existente. No se pide ni se evalúa un valor p obtenido por muestreo.
Grafica las diferencias de asignación guardadas
En este paso mostrarás el recuento muestral real de cada diferencia y marcarás la posición de la comparación observada, que no cambia.
Continúa en la misma terminal de WebIDE, en /home/labex/project/signup-experiment. np.unique(..., return_counts=True) devuelve las diferencias guardadas distintas y sus recuentos. Es un gráfico de recuentos discretos: su eje vertical indica cuántas de las 399 reasignaciones produjeron cada diferencia. No es un intervalo de confianza del efecto.
La función de dibujo recibe tu resultado guardado y una ruta de salida. El PNG debe tener al menos 500 × 250 píxeles para seguir siendo legible. figsize=(9, 4.5) establece el tamaño de la figura en pulgadas. DPI (puntos por pulgada) determina la resolución rasterizada guardada: 140 píxeles por pulgada dan aproximadamente 9 × 140 por 4.5 × 140, es decir, 1260 × 630 píxeles. subplots de Matplotlib crea una figura y sus ejes. bar dibuja los recuentos y axvline marca la diferencia observada sin fingir que es otro recuento de asignaciones. Una etiqueta y una leyenda visible identifican la marca. Los límites horizontales fijos de −110 a +110 dejan espacio para todas las diferencias posibles entre tasas binarias, aunque algún extremo no aparezca en esta muestra finita. El eje vertical comienza en cero; tight_layout deja sitio para las etiquetas antes de que savefig escriba un PNG real.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Lee la muestra ya guardada y dibújala con tu función:
python3 run.py plot-sample
En el explorador de archivos de WebIDE, despliega signup-experiment/output y abre sample.png. Lee las dos etiquetas de los ejes. La mayoría de los recuentos deberían concentrarse alrededor de una diferencia próxima a cero; la marca roja observada sigue cerca de +66.67 puntos porcentuales. Un valor ausente de la muestra tiene recuento cero, no representa a una persona omitida. Los datos guardados siguen representando las 399 extracciones y las 12 personas originales.
La imagen de referencia siguiente usa el ejemplo NumPy con semilla 42 que acabas de ejecutar. Otro muestreador o semilla permitido puede cambiar las alturas; tu archivo debe mostrar tus extracciones reales.
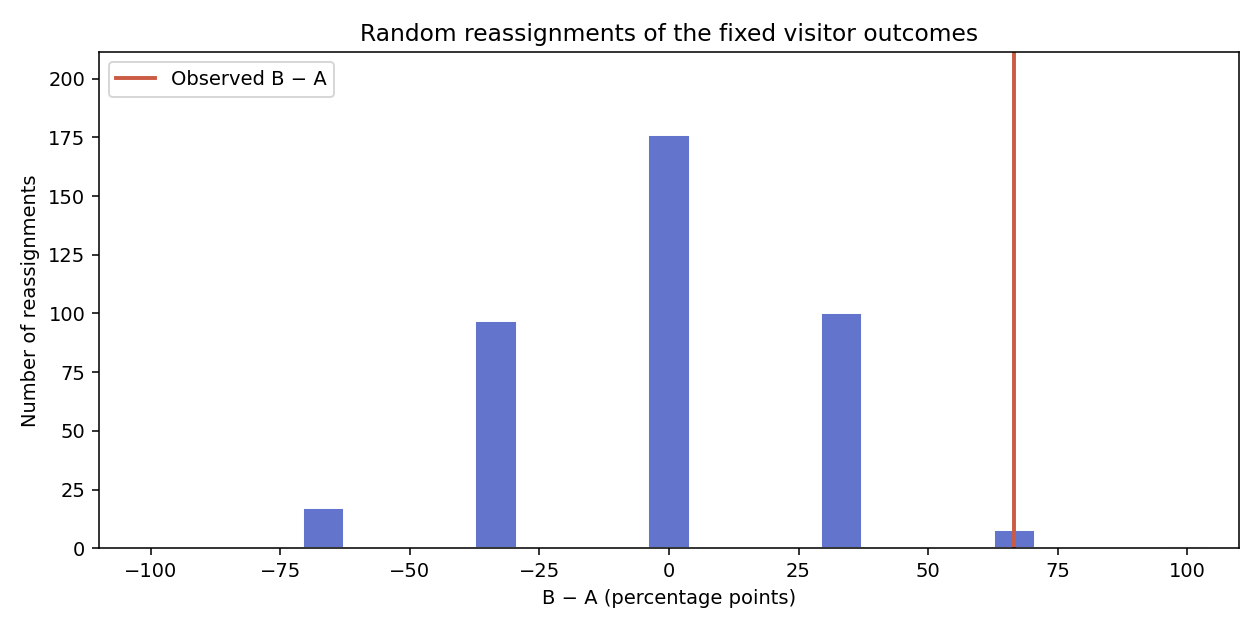
El PNG guardado debe poder reproducirse con tu función actual y la muestra guardada. Puedes usar barras legibles, una línea de recuentos o puntos de recuento en las diferencias reales, con una línea o un punto visible etiquetado Observed en la diferencia observada. Mantén todas las diferencias posibles y la marca observada dentro de los ejes, conserva la base de recuento cero y etiqueta ambos ejes. Ocultar una marca, recortar los datos, copiar una imagen ajena o representar densidad y etiquetarla como recuentos no completa la tarea.
Si falta el PNG, confirma primero que python3 show_results.py sample puede leer una muestra guardada y después repite el comando de dibujo. El lector no genera archivos ausentes. En el próximo laboratorio compararás una distribución exacta de asignaciones con el resultado observado y aprenderás qué permite concluir esa evidencia y qué no.
Resumen
Intercambiaste manualmente dos pertenencias de grupo, generaste 399 reasignaciones reales de visitantes con tamaños de grupo fijos y graficaste sus diferencias guardadas junto a la comparación observada. Una semilla reproducible permite repetir una ejecución; no elige una respuesta ni una página ganadora. Ya tienes la intuición necesaria para leer la evidencia exacta del siguiente laboratorio.