Introducción
Un gráfico exploratorio de reasignaciones muestra cómo unos resultados individuales fijos pueden producir comparaciones de grupo diferentes. Este laboratorio da el siguiente paso: cuenta todas las asignaciones distintas de esta muestra fija pequeña, define un valor p bilateral preciso y registra qué respalda la evidencia.
Las funciones correctas para construir resultados por persona y compararlos ya están preparadas en este entorno independiente. Necesitas las ideas de los laboratorios anteriores sobre ventanas individuales, diferencias en puntos porcentuales y reasignaciones de tamaño fijo, además de Python, NumPy y Matplotlib básicos. No necesitas archivos de otra VM ni conocimientos previos de valores p. Los registros son ejemplos didácticos sintéticos originales, no un experimento comercial real; ni una diferencia observada grande ni un valor p pequeño garantizan resultados en producción. Los 55 minutos son una estimación del autor que incluye lectura y correcciones habituales.
Cuenta todas las asignaciones distintas
En este paso sustituirás una muestra aleatoria finita por la distribución completa de asignaciones y calcularás su valor p bilateral con una definición explícita.
Empieza en WebIDE, abre Terminal → New Terminal y entra en el directorio de trabajo:
cd /home/labex/project/signup-experiment
Lee las definiciones originales y las opciones antes de mirar el resultado de la prueba:
cat data-dictionary.md
cat config.json
El análisis usa una única muestra fija con todo el seguimiento terminado y un resultado binario de inscripción por persona. La interpretación posterior usa el alpha = 0.05 ya seleccionado. Alpha es un umbral de comparación convencional para este ejercicio, no una probabilidad del 95% de que funcione una página. No se eligió después de buscar un resultado favorable. No cambies los datos, el instante de análisis, el umbral ni la población después de ver la comparación.
Bajo la hipótesis nula de ausencia de efecto de la página, el resultado de cada persona sería el mismo cualquiera que fuera la página asignada. El diseño aleatorizado representado permite entonces redistribuir esos resultados fijos conservando ambos tamaños de grupo. Esta inferencia no se aplica automáticamente a un registro observacional arbitrario no aleatorizado.
Una distribución exacta de asignaciones incluye todas las maneras distintas de colocar a las personas en los dos grupos. El orden dentro de un grupo no crea otra asignación para un estadístico basado en medias. math.comb(n, k) de Python cuenta las formas de seleccionar k personas entre n. Aquí, elegir las seis personas de A entre 12 también determina las seis de B.
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
Hay 924 asignaciones para este experimento y como máximo 3432 en cualquier ejemplo proporcionado por el curso. La enumeración exacta es práctica a este tamaño deliberadamente pequeño; no promete enumerar muestras arbitrariamente grandes de producción.
Para el estadístico B−A en puntos porcentuales, este curso sigue la convención precisa two-sided de SciPy:
Primero calcula la proporción de diferencias de asignación exactas menores o iguales que la diferencia observada. Calcula por separado la proporción de diferencias mayores o iguales que ella. Duplica la menor de las dos proporciones y limita el resultado a 1.
Los valores iguales pertenecen a las dos colas respectivas. Esta es una definición concreta de valor p bilateral; no todas las definiciones coinciden. Contar abs(null) >= abs(observed) no siempre es equivalente en una distribución discreta asimétrica. Por ejemplo, A tiene dos personas sin inscripciones y B cinco personas con dos inscripciones, con una diferencia observada de +40 puntos. Sus 21 asignaciones dan −100 una vez, −30 diez veces y +40 diez veces. El valor p definido es 2 * 10 / 21 = 20/21; la proporción de cola absoluta sería 11/21. No se puede cambiar silenciosamente ni la agrupación ni la definición para obtener un número menor.
Usa la interfaz preparada permutation_test de SciPy. permutation_type="independent" redistribuye observaciones entre grupos independientes conservando sus tamaños; no trata a los visitantes como mediciones emparejadas. vectorized=False indica que el estadístico recibe arrays unidimensionales normales. n_resamples=np.inf solicita toda la distribución finita en lugar de 399 extracciones aleatorias. alternative="two-sided" selecciona la convención anterior. Esta enumeración exacta no necesita una semilla aleatoria.
La selección de DataFrame .loc[mask, "signed_up"] toma esa columna para las personas coincidentes; .to_numpy() convierte sus valores en un array unidimensional de NumPy. La función interna statistic usa la misma fórmula de diferencia que el laboratorio anterior y se define por completo aquí, de modo que esta unidad no depende de resample.py de otra VM.
result.statistic, result.pvalue y result.null_distribution son los valores calculados reales. Conserva sus números sin redondear; .tolist() convierte el array en una lista compatible con JSON sin quitar las diferencias repetidas de asignaciones distintas.
El > del shell sustituye un archivo; el here-document entre comillas <<'PY' copia el bloque completo hasta el PY final sin expansión del shell. También puedes editar el archivo en WebIDE y usar File → Save.
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
La etapa distribution del ejecutor llama a tu análisis y guarda sus resultados reales sin pedir todavía una función de interpretación:
python3 run.py distribution
El lector muestra datos existentes y omite el array largo únicamente en la presentación de la terminal:
python3 show_results.py exact
Espera 12 personas, una inscripción entre las seis personas de A y cinco entre las seis de B, una diferencia observada próxima a +66.67 puntos, null_count de 924 y p cercano a 0.08009. La distribución completa permanece en output/analysis.json. El campo de interpretación se añadirá en el siguiente paso.
Puedes editar inference.py y plot.py o añadir archivos auxiliares normales de Python junto a ellos. Conserva los CSV originales, las opciones, el diccionario, el ejecutor y el lector. Los archivos preparados outcomes.py y compare.py implementan funciones ya enseñadas; se aceptan equivalentes si conservan los contratos públicos de DataFrame/objeto y los resultados válidos. Las comprobaciones aisladas cubren otros tamaños acotados de grupo, direcciones contrarias, diferencias nulas y resultados todos a cero. Un valor p fijo o una distribución fija no son un análisis reutilizable.
Ante un error habitual de ruta o nombre, usa pwd y ls, repite el cd inicial y vuelve a copiar el bloque completo. Setup no es una herramienta para recuperar una edición: se niega deliberadamente a sobrescribir un directorio de trabajo existente.
Separa la evidencia de la certeza
En este paso añadirás una regla de interpretación transparente que pueda indicar cualquiera de las direcciones o evidencia insuficiente.
Continúa en la misma terminal de WebIDE, en /home/labex/project/signup-experiment. Un valor p describe una comparación bajo la hipótesis nula y el diseño de asignación elegidos. No es la probabilidad de que la hipótesis nula sea verdadera, ni de que no exista un efecto de la página, ni una garantía para el próximo taller.
Aquí, los aproximadamente +66.67 puntos observados parecen una diferencia grande, pero el valor p exacto es aproximadamente 0.08009. Con esta muestra fija pequeña y el alpha 0.05 preseleccionado, el ejercicio comunica evidencia no concluyente. Eso no demuestra que las páginas sean idénticas. Significa que esta prueba y esta muestra no aportan el nivel de evidencia seleccionado contra la hipótesis nula.
Usa estas etiquetas de salida explícitas:
evidence_for_bcuando p <= alpha y la diferencia sea positiva;evidence_for_acuando p <= alpha y la diferencia sea negativa;inconclusiveen los demás casos, incluida una diferencia nula.
La igualdad con el umbral pertenece a la rama de evidencia: p == alpha satisface <=. No redondees p antes de comparar. Son etiquetas de un análisis acotado, no una decisión automática de despliegue comercial. Otro experimento válido puede respaldar A o ninguna página; no se exige que ninguna etiqueta favorezca B.
El >> del shell añade contenido al archivo existente en lugar de sustituirlo. El bloque completo siguiente agrega conclude debajo de analyze; pégalo una sola vez. Si editas en WebIDE, añade la función al final y guarda. El and de Python exige ambas condiciones antes de que una rama devuelva su etiqueta.
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
Ejecuta de nuevo el análisis exacto mediante la etapa de interpretación. Esto sustituye deliberadamente el archivo de resultados por un análisis actual completo que también incluye la etiqueta:
python3 run.py exact
python3 show_results.py exact
Para esta muestra completa, el resultado debe indicar inconclusive. La diferencia observada, el valor p bruto y las 924 diferencias de asignación siguen iguales. No elimines personas, selecciones una fecha, reasignes los grupos reales ni sustituyas el resultado por una muestra aleatoria exploratoria para obtener una etiqueta preferida. Todo el seguimiento requerido de siete días ha terminado; cambiar una regla de parada o añadir datos queda fuera de este ejercicio.
Guarda una vista legible de la evidencia exacta
En este paso graficarás la distribución completa de asignaciones guardada e identificarás la comparación observada sin ocultar su contexto.
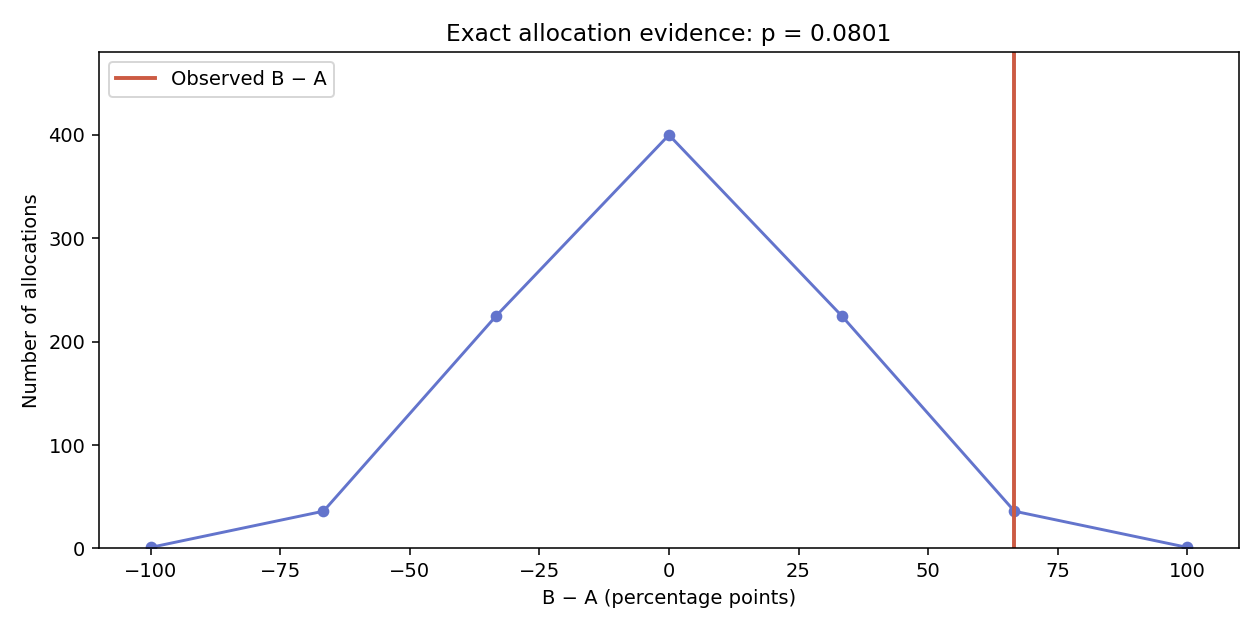
Continúa en la misma terminal de WebIDE, en /home/labex/project/signup-experiment. Este gráfico usa la distribución exacta de result["analysis"], no la muestra exploratoria de otra unidad. np.unique(..., return_counts=True) cuenta cuántas asignaciones distintas producen cada diferencia; sus alturas deben sumar 924 con los datos actuales. Los valores repetidos tienen significado y no deben eliminarse de la distribución subyacente.
Algunos recuentos exactos de las colas son de una sola asignación. Los marcadores visibles mantienen esos recuentos poco frecuentes legibles por encima de la base cero. La línea de conexión ayuda a seguir los puntos discretos; no significa que toda diferencia entre ellos sea alcanzable.
La coordenada horizontal es la diferencia B−A en puntos porcentuales y la vertical es el recuento de asignaciones. La marca visible Observed sitúa la comparación real. Un valor p redondeado en el título solo facilita la presentación; el número guardado y la interpretación usan el valor sin redondear. Deben quedar visibles todo el rango posible de diferencias y la base de recuento cero, incluidos los ceros legítimos y los valores extremos.
Guarda un PNG de al menos 500 × 250 píxeles. Como antes, una figura de 9 × 4.5 pulgadas guardada a DPI 140 tiene unos 1260 × 630 píxeles; su resolución deja sitio para ejes legibles y marcadores de recuentos poco frecuentes.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Genera el PNG a partir del análisis realmente guardado:
python3 run.py plot-exact
En el explorador de archivos de WebIDE, despliega signup-experiment/output y abre evidence.png. Busca la distribución alrededor de cero y la marca observada cerca de +66.67. Lee output/analysis.json mediante el lector junto a la figura: las 12 personas, ambos denominadores asignados, la diferencia bruta, el p exacto, alpha y la etiqueta inconclusive forman juntos la evidencia. Un gráfico por sí solo no prueba que el análisis sea correcto.
La referencia siguiente es el gráfico guardado real de este conjunto guiado con el código proporcionado. Los puntos incluyen los recuentos poco frecuentes de ambas colas; la línea solo conecta diferencias alcanzables. Léelo junto al resultado numérico guardado.
Puedes usar barras legibles, una línea de recuentos o puntos de recuento en las diferencias reales. La comparación observada necesita una línea o punto visible con etiqueta Observed, y ambos ejes deben tener etiquetas significativas. Conserva todo el rango de valores posibles, la marca observada y la base cero visibles. El PNG debe decodificarse y reproducirse a partir de los datos reales guardados y la función actual; no se aceptan trazos invisibles, marcas fuera de los ejes, gráficos recortados ni imágenes ajenas. Si falta el PNG, confirma primero el resultado exacto guardado con python3 show_results.py exact y repite después el comando de dibujo; el lector no lo repara.
Has analizado una muestra sintética de experimento aleatorizado bajo una hipótesis y una convención declaradas. No has medido un resultado comercial real, demostrado que las páginas sean idénticas ni establecido que un efecto observado vaya a mantenerse en producción.
Resumen
Enumeraste una distribución exacta acotada de asignaciones, usaste un valor p bilateral definido con colas inclusivas, aplicaste un umbral preseleccionado sin redondear y guardaste el gráfico real de evidencia. Una diferencia grande puede seguir siendo no concluyente con una muestra pequeña; la evidencia no concluyente no demuestra igualdad entre páginas. El desafío independiente transfiere ahora este mismo flujo a otra asignación e historial de eventos.