Introducción
Una editora de Commonlight necesita un catálogo fotográfico utilizable, empezando por una pequeña muestra de una página. Harás peticiones HTTP reales para obtener JSON, seleccionarás registros por sus campos y guardarás un CSV. Commonlight es una API de demostración local original: sus registros y créditos son ficticios, y las imágenes de muestra son ilustraciones sintéticas, no fotografías documentales ni contenido de un servicio fotográfico externo.
Debes conocer funciones, colecciones (como listas y diccionarios), bucles, excepciones y salida básica a archivos en Python. Aquí se presentan HTTP, URL, JSON y CSV. En WebIDE, elige Terminal → New Terminal (en pantallas estrechas, el menú Terminal puede estar dentro de More). Ejecuta allí todos los comandos de terminal. Usa Web 8080 para el sitio preparado. Edita únicamente client.py y storage.py; utiliza la biblioteca estándar y funciones auxiliares definidas dentro de esos archivos, sin módulos ni recursos auxiliares adicionales. Entrega los CSV como archivos normales reales del espacio de trabajo, no como enlaces simbólicos; conserva catalog.py y /opt/commonlight sin cambios. Los 40 minutos de lectura y práctica son una estimación del autor, no un tiempo medido con principiantes.
Solicitar y comprender una página del catálogo
En este paso, relaciona tres registros de la API con tres tarjetas visibles y después implementa la función de petición. Cambia a Web 8080. La vista previa Harbor walks contiene Morning, market, Blue hour y Window light. Indica expresamente que muestra una página, no toda la colección. Las imágenes aportan contexto; este curso exporta metadatos en lugar de descargar imágenes.
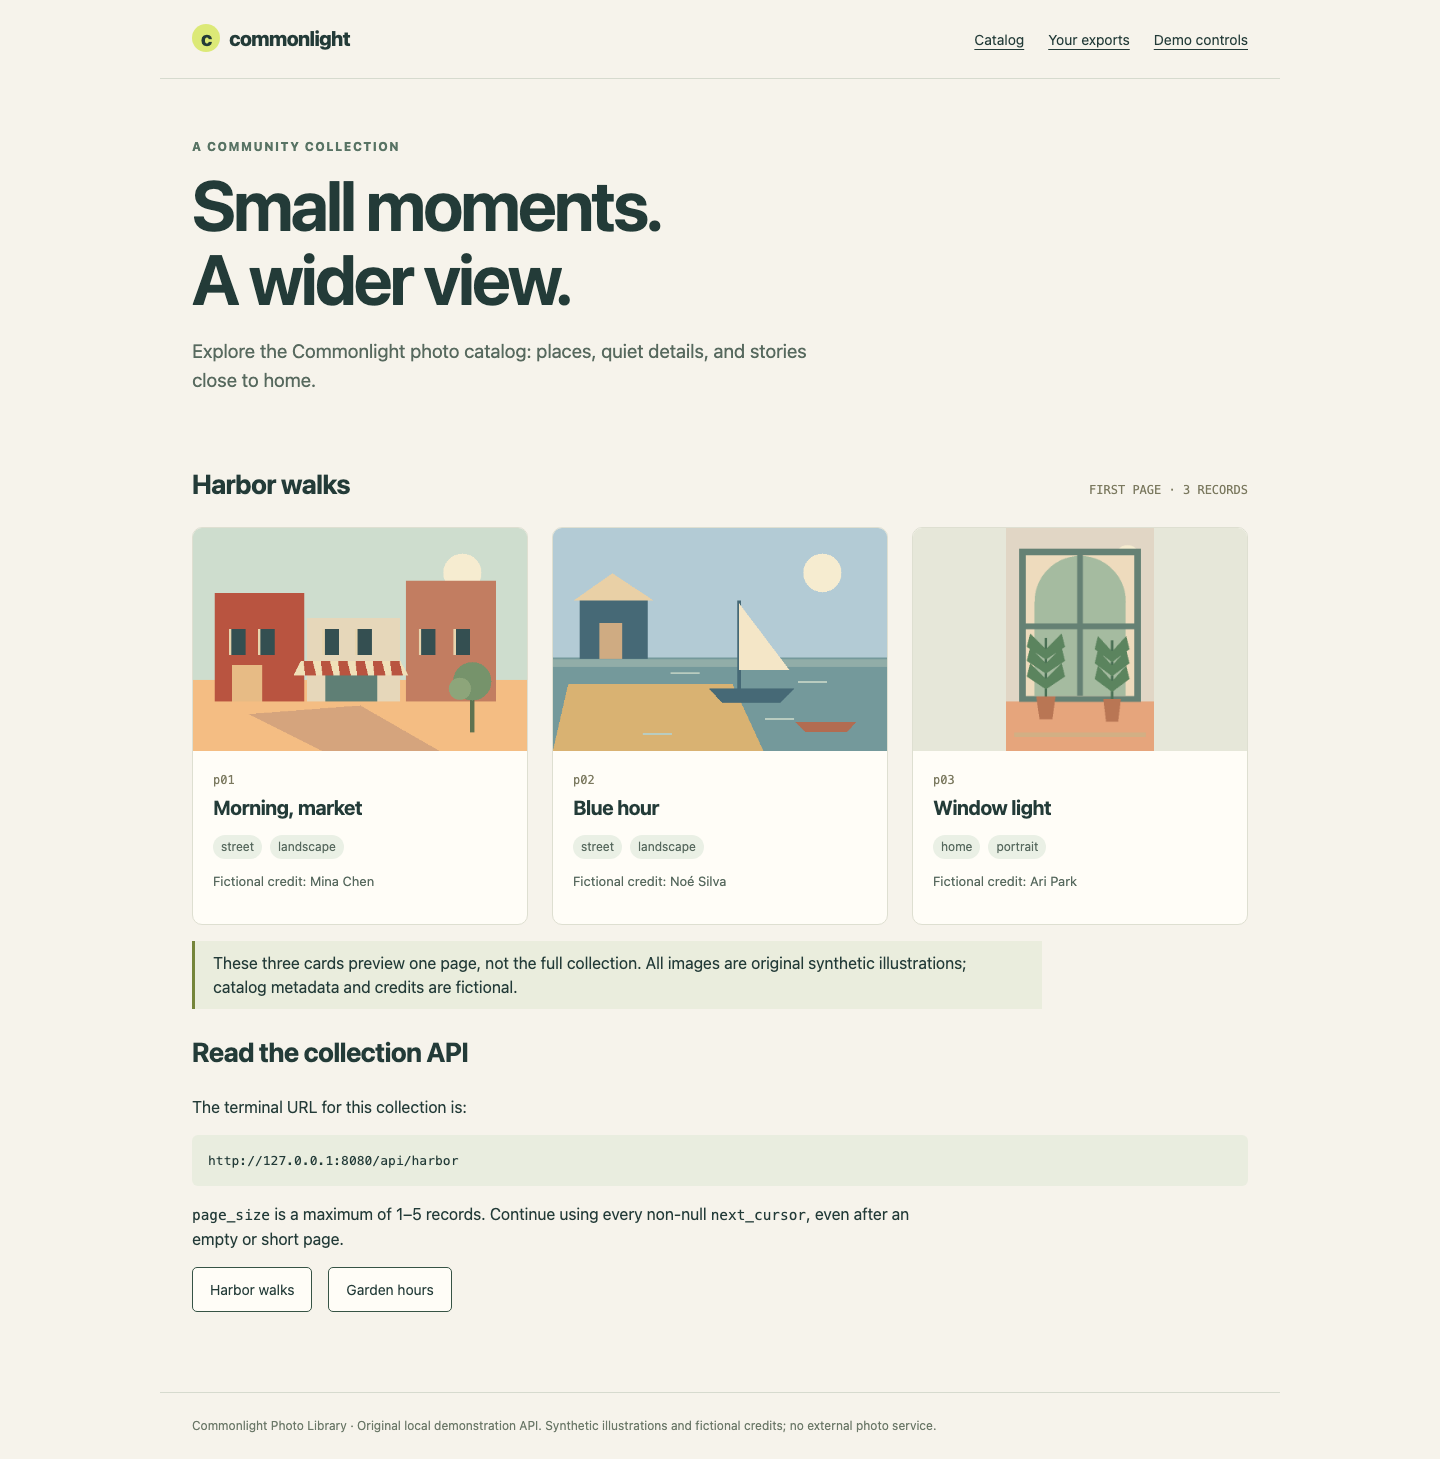
Relaciona los ID situados debajo de las ilustraciones con la respuesta que vas a solicitar.
Vuelve a WebIDE y a su terminal. cd cambia el directorio de trabajo; python3 ejecuta Python. Usa esta ruta exacta:
cd /home/labex/project
HTTP es el protocolo de petición y respuesta que utiliza esta API local. Una URL identifica su dirección: http es el protocolo, 127.0.0.1 es este mismo entorno, 8080 es el puerto del servicio y /api/harbor selecciona una colección. Después de ?, la consulta page_size=3 solicita como máximo tres registros. Esta dirección se usa en la terminal; Web 8080 abre la dirección de navegador que la plataforma proporciona para el mismo servicio.
El siguiente here-document ejecuta un pequeño programa de Python. <<'PY' pasa las líneas literales hasta el delimitador final PY a la entrada estándar de Python; copia ambas líneas delimitadoras. urlopen envía una petición HTTP real. timeout=3 limita operaciones bloqueantes como conectarse o esperar en un socket, no la duración de cualquier tarea completa. with cierra la respuesta al terminar. JSON es texto estructurado; json.load decodifica la respuesta en datos de Python.
python3 - <<'PY'
import json
from urllib.request import urlopen
with urlopen('http://127.0.0.1:8080/api/harbor?page_size=3', timeout=3) as response:
    print('HTTP status:', response.status)
    page = json.load(response)
for photo in page['items']:
    print(photo['photo_id'], photo['title'])
print('More pages:', page['next_cursor'] is not None)
PY
HTTP status: 200
p01 Morning, market
p02 Blue hour
p03 Window light
More pages: True
El estado 200 significa que la petición tuvo éxito. El objeto JSON exterior se convierte en un diccionario. Su valor items es una lista de diccionarios de registros, no la respuesta completa. El valor JSON null se convierte en None de Python. Aquí next_cursor todavía es una cadena, por lo que existen más páginas. Esta unidad exporta deliberadamente una página; la siguiente completa el recorrido.
Cada registro tiene photo_id, title, category, orientation y credit. Un ID estable identifica el registro; el título es una etiqueta de presentación que distintas fotos pueden compartir. Puedes leer el contrato preparado en /opt/commonlight/api-contract.md. cat muestra un archivo de texto:
cat /opt/commonlight/api-contract.md
Añade funciones reutilizables de petición y selección. urlencode codifica un diccionario como cadena de consulta. Un cursor es un token opaco de continuación: cópialo exactamente, sin adivinar un número ni interpretar sus caracteres. El argumento opcional cursor=None hace que la primera petición omita ese parámetro. Las páginas posteriores pueden contener caracteres como +, / y =, que necesitan codificación. Mantén la URL y el tamaño de página durante un mismo recorrido.
La selección compara exactamente la categoría y la orientación, distinguiendo mayúsculas y minúsculas. Si no hay coincidencias, una lista vacía es válida. En la comprensión de lista, for photo in photos visita cada registro; if conserva solo los que cumplen el filtro; and exige que ambas comparaciones sean verdaderas. El resultado es una lista nueva que no modifica los registros recibidos.
El siguiente bloque usa cat con > para sustituir client.py por el texto literal de Python. Ejecuta todo el bloque, incluido el PY final. También puedes abrir el archivo en WebIDE, sustituir su contenido y guardarlo con Ctrl+S (Cmd+S en macOS). Este bloque solo cambia ese archivo.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    return request_page(endpoint, page_size)['items']
PY
La interfaz de comandos preparada llama a estas funciones. Por ahora, collect es expresamente una implementación inicial de una sola página. La comprobación prueba la petición contra otra fuente HTTP local real, de modo que debe utilizar la URL recibida en lugar de una respuesta de catálogo fija. No crea tu CSV por ti.
Si un comando indica que no puede abrir un archivo Python, muestra el directorio actual con pwd y los nombres de archivo con ls, vuelve a /home/labex/project mediante el cd anterior, corrige el nombre y reinténtalo. No necesitas restablecer la VM.
Filtrar una página y guardar un CSV real
En este paso, selecciona las fotos callejeras horizontales de la primera página y abre un CSV con sus valores de campo reales. CSV significa valores separados por comas, pero una coma dentro de un título pertenece a un único campo. Un escritor CSV adecuado lo entrecomilla; concatenar cadenas o dividir por cada coma rompe esa relación. UTF-8 conserva nombres como Noé y texto no latino. newline='' permite que el módulo csv gestione los finales de línea del CSV.
FIELDS define los cinco nombres de encabezado. Cada uno aparece una sola vez; una solución equivalente puede cambiar el orden de registros y columnas. DictWriter asigna cada valor del diccionario a su columna con nombre. writeheader escribe el encabezado y writerows los registros seleccionados, incluido un archivo solo con encabezado cuando la selección está vacía. El modo de apertura w sustituye el contenido del archivo. Esta primera unidad guarda una muestra de página; después aprenderás a publicar con seguridad una exportación completa de varias páginas.
En la terminal de WebIDE, sustituye solo storage.py:
cat > storage.py <<'PY'
"""Single-page CSV writer; safe publication is taught in the second guided lab."""
import csv

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    with open(output, 'w', encoding='utf-8', newline='') as stream:
        writer = csv.DictWriter(stream, fieldnames=FIELDS)
        writer.writeheader()
        writer.writerows(photos)
PY
El programa preparado catalog.py acepta cinco argumentos posicionales: URL de la colección, categoría, orientación, tamaño máximo de página y nombre del archivo de salida. --first-page selecciona expresamente el modo de muestra. street y landscape son los dos filtros exactos. Las comillas del shell mantienen juntas una URL o un nombre de archivo con caracteres especiales.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Saved 2 photos to page.csv
Lee el resultado con DictReader, que reconstruye los campos entrecomillados. Así se lee el archivo realmente guardado, no la API:
python3 - <<'PY'
import csv
with open('page.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'], '|', photo['credit'])
PY
p01 | Morning, market | Mina Chen
p02 | Blue hour | Noé Silva
p03 no aparece porque es una foto vertical de la categoría de hogar. La coma del primer título y el crédito con acento siguen unidos a sus registros.
Observa ahora un rechazo HTTP intencionado. La API permite tamaños de página de 1–5, por lo que 9 devuelve 400, no una colección vacía obtenida correctamente. Ejecuta el bloque; se espera que falle el primer comando. $? es el estado de salida del comando inmediatamente anterior, y printf lo muestra antes de que otro comando lo sustituya.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 9 rejected.csv --first-page
printf 'Exit status: %s\n' "$?"
HTTP request refused: 400. No complete export published.
Exit status: 1
HTTPError representa este rechazo HTTP; un fallo de conexión se informa por separado como Connection failed. Ninguno equivale a un resultado válido sin coincidencias. La interfaz preparada captura la excepción para explicarla y termina con un estado distinto de cero. Para recuperarte, vuelve a un tamaño permitido; no cambies el servicio:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Cambia a Web 8080, elige Your exports y luego page.csv. La tabla debe mostrar los dos registros reales anteriores. Elige Download CSV y abre el archivo descargado como texto o con un lector CSV. La descarga contiene los bytes del archivo guardado; la página no obtiene registros que falten desde la fuente. Vuelve a Catalog mediante la navegación de la página y después a WebIDE para la comprobación. Has creado una muestra reutilizable de una página, y el token de continuación no nulo sigue indicando que no es el catálogo completo.
Resumen
Enviaste peticiones HTTP reales, separaste la envoltura de una página JSON de sus registros, seleccionaste valores exactos y escribiste un CSV UTF-8 correctamente entrecomillado. Un rechazo HTTP, un fallo de conexión y un resultado vacío válido tienen significados distintos. La muestra de dos registros es útil; la siguiente unidad sigue los cursores restantes para completar la exportación.