Introducción
Una vista previa de tres tarjetas sirve para explorar, pero la editora necesita todos los registros coincidentes. Completa el cliente de esta misma API local de demostración para seguir los tokens de continuación, conservar la identidad entre páginas y publicar el CSV solo cuando todo el lote tenga éxito. Una página vacía o corta puede tener más páginas después.
Esta unidad se prepara de forma independiente con las funciones de petición y selección del primer laboratorio guiado. Necesitas ese laboratorio o conocimientos equivalentes de HTTP/JSON/CSV. En WebIDE, utiliza Terminal → New Terminal; usa Web 8080 para la fuente, tus exportaciones guardadas y los controles públicos Demo controls. Edita solo client.py y storage.py; utiliza la biblioteca estándar y funciones auxiliares definidas dentro de ellos, sin módulos ni recursos auxiliares adicionales. Entrega los CSV como archivos normales reales del espacio de trabajo, no enlaces simbólicos. Conserva catalog.py, /opt/commonlight, las ilustraciones sintéticas y los registros ficticios de origen. El autor estima 55 minutos de lectura y práctica; no es un tiempo medido con principiantes.
Seguir el protocolo hasta el final
En este paso, recoge todas las páginas, incluida una vacía y otra con pocos datos, conservando cada ID una sola vez. En la terminal de WebIDE, entra en el espacio de trabajo preparado de forma independiente:
cd /home/labex/project
La función de petición ya procesa JSON, cursores codificados y un tiempo de espera de tres segundos para operaciones bloqueantes. Examina las reglas preparadas con cat:
cat client.py
El collect actual devuelve solo una página. Un page_size de 3 significa un máximo de tres registros, no que todas las páginas deban contener tres. Predice esta secuencia pequeña: primero tres registros, después ninguno pero otro cursor, y luego un registro con otro cursor. La página vacía no añade datos, pero no demuestra que el recorrido haya terminado. Ejecuta la secuencia utilizando únicamente los cursores devueltos:
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
Solo next_cursor is None termina correctamente un lote. No te detengas porque items esté vacío, una página sea corta o haya pasado un número de páginas supuesto.
El mismo ID fotográfico puede reaparecer en otras páginas con valores idénticos. Un diccionario con clave photo_id conserva la relación entre identidad y todos los campos. setdefault(key, value) inserta el valor solo si falta la clave. Así conserva una copia; un título repetido no es un ID duplicado. Las revisiones contradictorias quedan fuera de este contrato de demostración. Deben conservarse los dos ID distintos llamados Blue hour.
Un conjunto almacena valores únicos. set() crea un conjunto vacío, cursor in seen_cursors pregunta si el token ya existe y seen_cursors.add(cursor) registra uno nuevo. Este conjunto recuerda los tokens de continuación ya vistos. Tras comprobar el final nulo legítimo, rechaza un token repetido en lugar de repetir indefinidamente o aceptar un ciclo como final. raise ValueError detiene la recogida antes de guardar un resultado incompleto. Los catálogos normales preparados son finitos; no hay un límite fijo de páginas ni reintentos o reanudación automáticos.
Sustituye client.py por el módulo completo siguiente. Como antes, > sustituye el archivo y el here-document entrecomillado mantiene el contenido literal. La petición y el filtro no cambian; la parte nueva es collect.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
Ejecuta la recogida completa. Omite --first-page, ya que esa opción produce deliberadamente solo una muestra.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
Examina las identidades guardadas en vez de confiar solo en una cantidad:
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
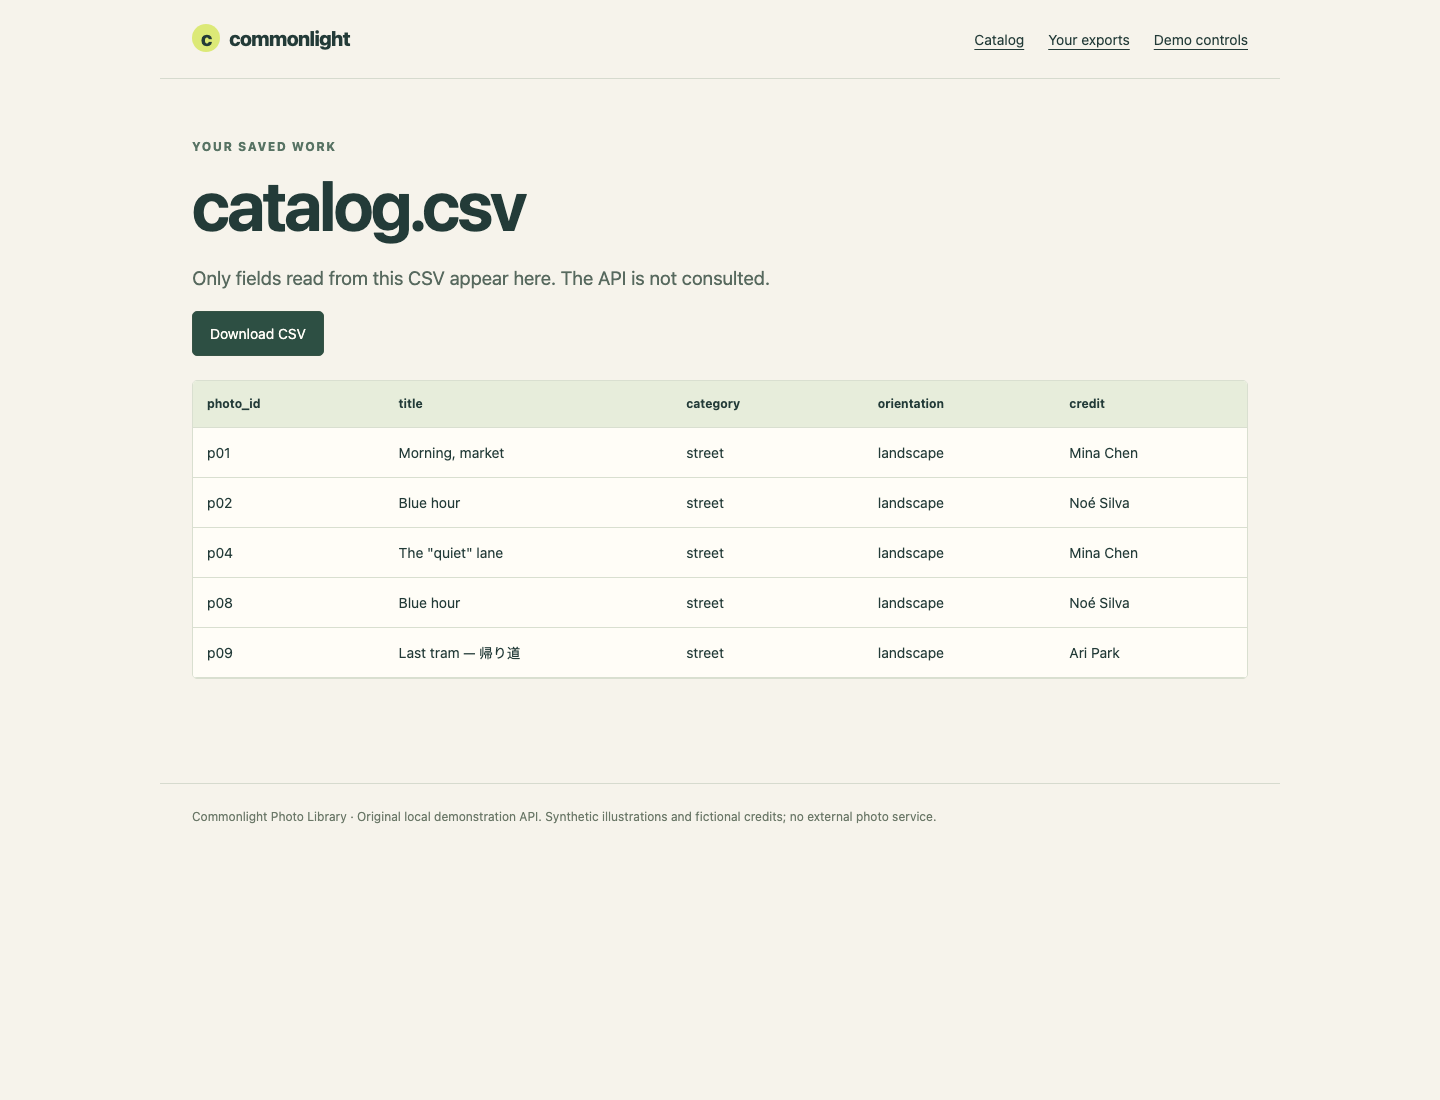
El registro final p09 está presente, p02 aparece una vez y p08 conserva el mismo título con un ID distinto. Comprueba esos mismos valores en Web 8080 → Your exports → catalog.csv. La tabla lee solo tu CSV; un archivo incompleto seguirá incompleto allí. Vuelve a WebIDE para la comprobación. Si utilizaste un nombre o directorio incorrecto, recupérate con pwd, ls y el cd anterior antes de reintentarlo.
Publicar solo una exportación completa
En este paso, protege la última exportación correcta si falla una petición posterior, aparece un ciclo del protocolo o falla la escritura. La recogida ya termina antes de guardar. El escritor también necesita un límite de éxito completo: abrir la ruta final con w puede truncar un archivo correcto antes de terminar la nueva escritura.
Path(output) convierte el nombre recibido en un objeto de ruta. .parent es el directorio que lo contiene y .name el nombre final. NamedTemporaryFile crea un nombre nuevo y único, sin apropiarse de un vecino predecible como catalog.csv.tmp. dir=output.parent lo mantiene en el directorio de destino para que la sustitución permanezca en el mismo sistema de archivos. delete=False conserva el archivo tras cerrarlo para poder sustituirlo; stream.name proporciona el nombre asignado, que guardamos como Path. El bloque finally se ejecuta tanto después del éxito como de una excepción. exists() comprueba si queda esa ruta temporal; unlink() elimina únicamente ese archivo recién creado si aún existe. Después de sustituir correctamente, la ruta temporal ya desapareció y no se elimina nada. Las excepciones siguen propagándose a la interfaz de comandos y provocan una salida distinta de cero. Path.replace publica el archivo terminado después de que el bloque with lo cierre. Una sustitución POSIX exitosa es atómica, pero no garantiza durabilidad ante cortes eléctricos, transacciones entre varios archivos ni coordinación de escritores concurrentes. Nunca debemos sobrescribir ni borrar un vecino .tmp existente y ajeno.
En la terminal de WebIDE, sustituye storage.py. Los cinco campos CSV deben aparecer exactamente una vez en el encabezado; las implementaciones equivalentes pueden usar otras formas válidas de entrecomillado y otro orden de filas o columnas.
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
Ejecuta un lote normal antes de simular problemas. sha256sum imprime una huella del contenido y el nombre del archivo. Recuérdala o mantén visible la salida: el siguiente lote fallido debe dejarla intacta. Una escritura fallida también debe conservar el último archivo completo; la comprobación lo prueba en un entorno aislado sin cambiar tu espacio de trabajo.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
Cambia a Web 8080. Elige Demo controls y después Enable middle-page failure. Confirma Middle-page failure ON.
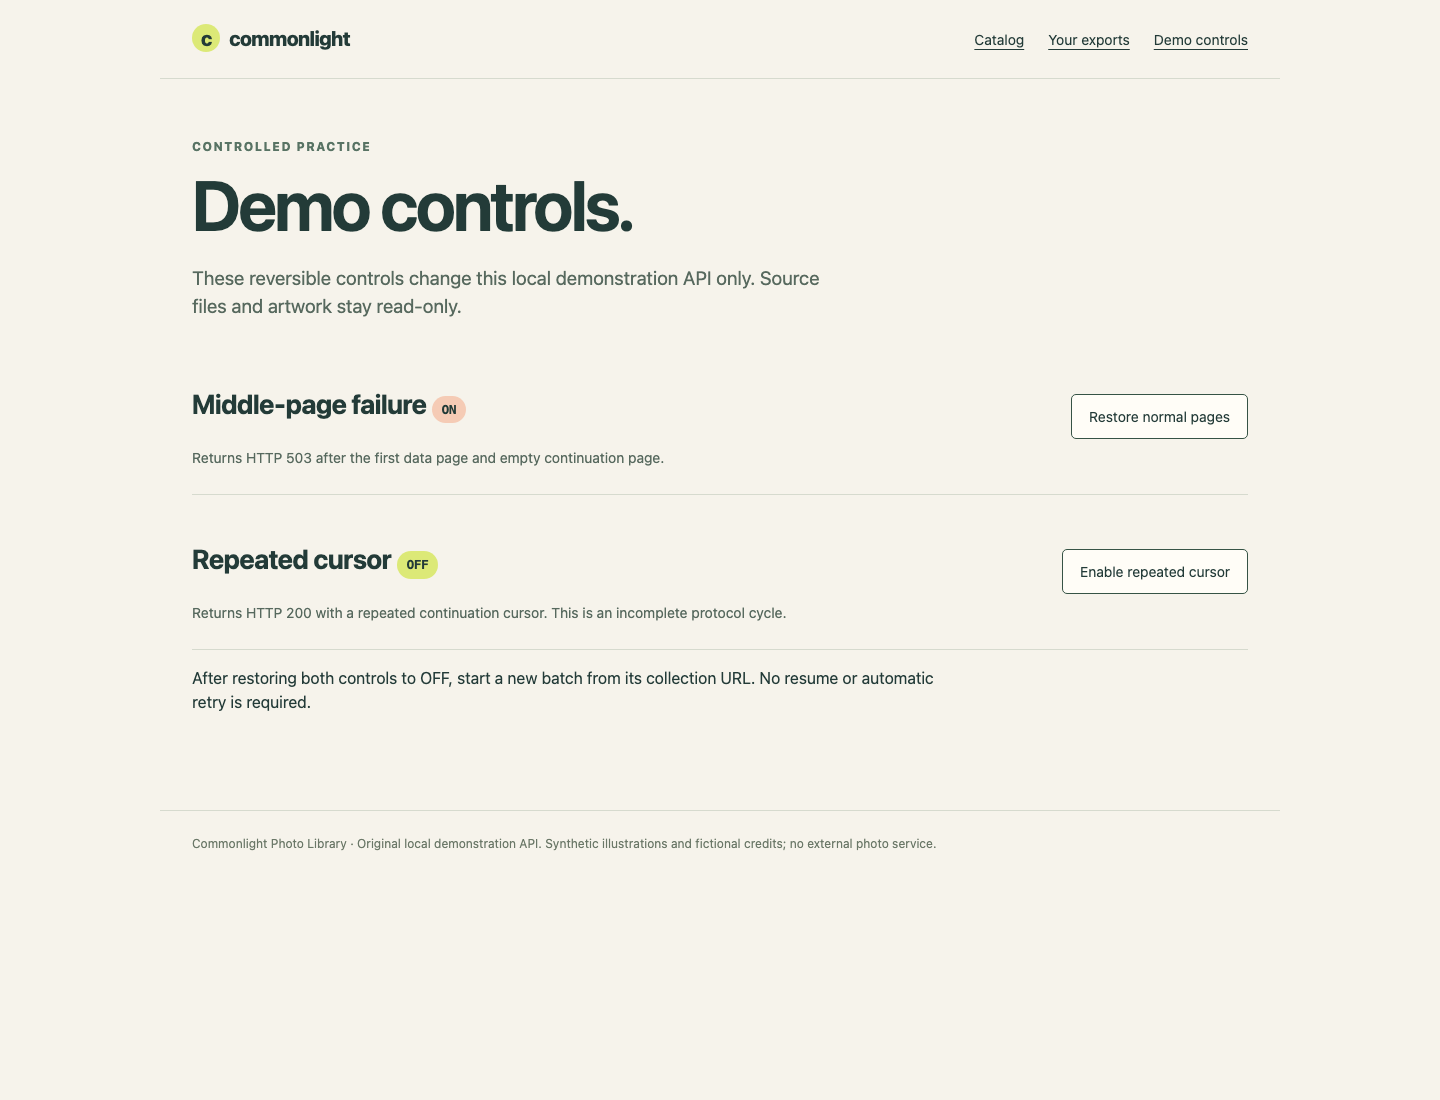
Usa la tarjeta correspondiente al fallo que activaste. Este cambio reversible está expresamente permitido y afecta solo a la memoria de la API de demostración; los archivos de origen siguen siendo de solo lectura. Vuelve a WebIDE y ejecuta este fallo intencionado. printf captura inmediatamente $?:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
Aquí HTTP 503 significa que la API de demostración rechazó una petición de página intermedia. No es un fallo de conexión ni un resultado vacío correcto. La huella debe coincidir con la anterior y la exportación de cinco filas debe seguir disponible. Una salida distinta de cero no basta si el programa ya ha dañado el archivo.
En Web 8080 → Demo controls, elige Restore normal pages para el fallo de página intermedia y confirma OFF. Vuelve a WebIDE y comienza otro lote finito desde la URL de la colección; no reutilices un cursor antiguo:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Después cambia a Web 8080 → Demo controls y elige Enable repeated cursor. Confirma Repeated cursor ON y el control de fallo en OFF. Vuelve a WebIDE:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
Estas respuestas tienen HTTP 200, pero el cursor repetido es un error del protocolo, no el final. La protección con el conjunto evita un bucle infinito y la publicación. En Web 8080 → Demo controls, elige Restore normal pages dentro de la tarjeta Repeated cursor y confirma OFF; ambos controles deben estar ahora en OFF. Vuelve a WebIDE, repite el comando correcto y prueba después un filtro válido sin coincidencias con otro nombre de salida:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
El segundo resultado es correcto y solo contiene el encabezado; no equivale a los dos errores anteriores. En Web 8080 → Your exports, abre empty.csv y comprueba sus cinco encabezados sin filas de datos; abre después catalog.csv y elige Download CSV. El archivo real de cinco registros guardados es tu entrega. Vuelve a WebIDE para la comprobación. Conserva el programa y los archivos preparados: la comprobación lee el resultado real y ejecuta copias sin modificar en pruebas HTTP reales aisladas, con diferentes URL, filtros, tamaños y fallos de escritura.
Resumen
Seguiste tokens opacos hasta el final nulo explícito, conservaste identidades distintas aunque compartieran título y rechazaste un ciclo del protocolo. Publicaste un CSV UTF-8 completo mediante un archivo temporal único y preservaste el resultado correcto anterior después de los fallos. El mismo programa puede aceptar otra colección y selección recibidas.