Introducción
El estudio ya dispone de un límite de predicción honesto. ¿Mejora un pequeño modelo de regresión la estimación de materiales frente a una mediana de asistencia anterior? Ajustarás un Pipeline corto, compararás ambos métodos en los mismos talleres etiquetados y guardarás una imagen real de comparación junto con predicciones futuras.
Necesitas funciones de Python, selección y uniones de pandas, conceptos básicos de regresión y entrenamiento/prueba en Scikit-learn y Matplotlib introductorio. El Guided Lab anterior explica el plazo de siete días y la imputación aprendida solo del entrenamiento. Este laboratorio prepara todos los archivos de forma independiente, incluida la separación por ID y fecha ya completada; no necesitas archivos de la VM anterior. Todos los datos son material sintético original para enseñar. Los 60 minutos son una estimación del autor.
Ajustar un Pipeline pequeño con talleres anteriores
En este paso reemplazarás un tentador modelo posterior al evento por un predictor reutilizable de siete días.
Empieza en WebIDE → Terminal → New Terminal. cd cambia el directorio de trabajo de este terminal. El ejecutable preparado ./python inicia el entorno del curso; ./ selecciona el lanzador de este directorio en lugar del intérprete del sistema.
cd /home/labex/project/workshop-attendance
cat muestra archivos sin editarlos; varios argumentos de nombre muestran los archivos uno tras otro.
cat season.json history.csv labels.csv future.csv
Cada fila histórica representa un taller identificado por session_id. labels.csv asocia actual_attendance mediante esa clave, en un orden independiente. Las únicas características numéricas permitidas son booked_7d, una instantánea guardada exactamente siete días antes del evento, y duration_minutes, ya anunciada en ese plazo. Las celdas numéricas vacías representan información ausente; cada característica permitida tiene una observación de entrenamiento no vacía. Los ID y las fechas sirven para asociar y separar, no como entradas del modelo. final_bookings y scanned_entries se producen durante el evento y filtran información no disponible siete días antes.
La separación completada congela el entrenamiento el 1 de abril de 2026 a las 00:00 UTC y reserva los eventos históricos a partir del 12 de abril para evaluar. Las etiquetas de entrenamiento se conocen al acabar el día de cada evento anterior; el último evento de entrenamiento aquí es el 8 de marzo. La primera predicción reservada ocurre el 5 de abril, utilizando la instantánea de siete días de ese evento con el modelo ya congelado. No se afirma que la entrada del 5 de abril estuviera disponible el día 1. Los archivos de instantáneas posteriores reproducen las fechas de predicción correspondientes. future.csv no tiene etiquetas reales; sus eventos de mayo reciben predicciones, no errores medidos. No hay filas históricas en el intervalo configurado. El curso no incluye reajustes continuos ni características de entrenamiento totalmente vacías.
cat split.py
Observa su merge basado en claves, los límites interpretados como fechas y la ordenación cronológica. Es la separación completada en la lección anterior, suministrada aquí para que el laboratorio sea independiente. Consérvala, junto con todos los CSV/JSON de entrada, python, run.py, coursekit.py, show_results.py y los archivos starter-*.py. Edita solamente model.py, chart.py y tus artefactos output/. El model.py inicial usa escaneos: unos resultados históricos aparentemente perfectos no corregirían esa elección inválida de información.
Un Pipeline encadena preprocesamiento y modelo. Durante fit, el imputador aprende medias de las características de entrenamiento proporcionadas y después la regresión aprende de la matriz rellenada. Durante predict, el mismo imputador solo transforma entradas posteriores. Nunca vuelve a ajustarse con el conjunto reservado o futuro. LinearRegression ajusta un intercepto y coeficientes por mínimos cuadrados ordinarios; mantenemos este modelo pequeño en lugar de ajustar muchas alternativas.
Escribe las dos funciones reutilizables. FEATURES es exactamente ['booked_7d', 'duration_minutes']. fit_model devuelve el estimador ajustado y la mediana del objetivo de entrenamiento. predict_events selecciona las mismas características permitidas para cada tabla. La función provisional evaluate se completará en el próximo paso; la fase fit no la llama.
El > del shell reemplaza el archivo. <<'PY' comienza un documento integrado entre comillas: pega hasta la última línea que contiene solo PY; el shell guarda literalmente el Python incluido. Otra opción es editar model.py en WebIDE Explorer y seleccionar File → Save.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
La vista previa guardada debe asociar W-88 con una predicción bruta cercana a 32.718, asistencia real 46 y referencia 24.5; W-09 debe tener una predicción cercana a 62.236, valor real 74 y la misma referencia. Una salida de regresión puede ser fraccionaria aunque un taller real admita un número entero de personas.
./python show_results.py fit
Son predicciones anteriores al resumen de errores. Se ajustaron sin las etiquetas posteriores. Cambiar esas etiquetas debe cambiar los errores finales, no las predicciones ajustadas. Una característica cuyo coeficiente aprendido sea cero puede legítimamente no influir; cambiar una entrada arbitraria no necesariamente cambia una predicción.
Comparar errores continuos en el mismo conjunto reservado
En este paso calcularás errores absolutos a partir de etiquetas reales reservadas y compararás sus medias en personas.
Continúa en WebIDE, en /home/labex/project/workshop-attendance. Un error absoluto es la magnitud de actual - predicted. np.abs lo calcula elemento a elemento; np.mean promedia el array resultante. Para una referencia justa, resta la misma mediana temprana del objetivo a cada una de las mismas etiquetas reales reservadas. Nunca compares conjuntos de eventos diferentes ni sustituyas un resultado real por una predicción.
Utiliza las predicciones continuas sin redondear para todos los errores y MAE. Redondear primero a una cantidad de personas mostrada cambia la evaluación. El programa auxiliar mostrará el MAE con tres decimales en consola, pero guardará el valor numérico sin redondear en JSON.
Reemplaza model.py por esta versión completa. Conserva la lógica de ajuste y predicción y completa la función antes vacía evaluate. Esta devuelve los arrays de errores por evento y sus medias; el programa auxiliar conserva los ID de esas mismas filas reservadas al escribir output/holdout.csv. Los vectores de errores siguen el orden de posiciones de los arrays reales/predichos recibidos. Se aceptan valores equivalentes de tipo array, incluidas Series de pandas, en ese orden; sus etiquetas numéricas de índice no son ID de talleres.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
Resumen esperado en consola:
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
Para W-88, el error del modelo es de unas 13.282 personas y el de referencia es 21.5. Para W-09, son aproximadamente 11.764 y 49.5. Las medias sin redondear son aproximadamente 12.5230751656 y exactamente 35.5 personas. La referencia del ejercicio anterior era 18; la mediana de entrenamiento de esta temporada es 24,5 porque utiliza otra muestra temprana.
Aquí el modelo pequeño presenta menor error en estos dos eventos reservados. Es evidencia sobre esta pequeña muestra sintética, no una prueba de fiabilidad futura ni de un efecto causado por las reservas. Si un modelo correcto tiene un MAE mayor, la conclusión honesta es que no mejoró esta comparación. La evaluación nunca exige superar la referencia, y las características constantes o sin información son legítimas.
Entregar el gráfico y los pronósticos sin etiquetas
En este paso harás legible la comparación reservada y exportarás estimaciones futuras sin inventar resultados reales.
Continúa en WebIDE, en /home/labex/project/workshop-attendance. El gráfico debe representar un valor por ID reservado para cada serie Actual, Model y Baseline, utilizando los valores brutos en personas de la tabla comparativa. Sirven líneas o puntos; las etiquetas y los ID aclaran su significado. El PNG debe ser legible, tener al menos 600 por 300 píxeles y reproducir el mismo gráfico visible al repetirlo con los mismos datos. El estilo puede variar. La evaluación comprueba los valores realmente dibujados y la imagen guardada, no un manifiesto que declare el gráfico correcto. Todos los puntos de negocio deben quedar dentro de los límites visibles de los ejes, y ninguna serie requerida puede estar oculta o ser totalmente transparente. Se permiten puntos exactamente en un límite; los colores y rangos pueden variar.
El backend Agg de Matplotlib escribe imágenes sin abrir una ventana de escritorio. subplots crea figura y ejes; plot dibuja cada serie asociada por ID. Los marcadores siguientes distinguen círculos reales huecos, rombos del modelo y cruces discontinuas de referencia, incluso cuando coinciden la asistencia real y la referencia. tight_layout deja espacio para etiquetas, savefig escribe el PNG real y close libera la figura.
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
Primero practica un error de escritura inofensivo. El siguiente comando utiliza intencionalmente un nombre de fase inválido y termina con un error de argumentos; no modifica los resultados guardados.
./python run.py delvier
El mensaje enumera las opciones permitidas. Corrige la escritura y ejecuta la fase de entrega. Si aparece un error de archivo inexistente, utiliza pwd y ls, vuelve con el cd inicial y prueba el nombre de archivo correcto.
./python run.py deliver
./python show_results.py deliver
El lector carga CSV/JSON guardados y decodifica el PNG real; nunca rellena resultados desde las entradas. En Explorer de WebIDE, despliega output y abre comparison.png. El modelo debe quedar por debajo de ambos puntos reales; la referencia permanece en 24,5. Los distintos marcadores permiten distinguir series iguales. Inspecciona holdout.csv junto a la imagen para asociar cada punto con su ID y su error real.
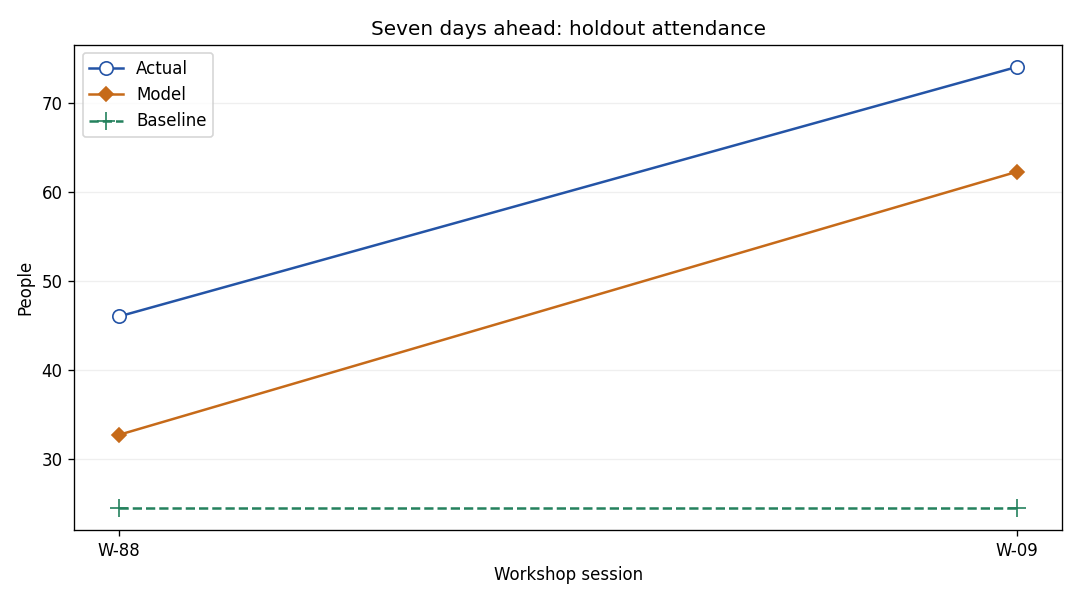
El ejemplo proporcionado muestra asistencias reales 46 y 74 para W-88 y W-09, predicciones próximas a 32,718 y 62,236 y referencia discontinua en 24,5. La distancia vertical entre un punto real y su predicción representa el error absoluto del evento. El estilo puede variar; los ID y valores subyacentes deben coincidir.
forecast.csv contiene únicamente session_id, model_prediction bruto y display_people. F-6 tiene una predicción cercana a 19.119 y cantidad mostrada 19; F-101, predicción cercana a 25.245 y cantidad 25. Solo para mostrar, el programa auxiliar limita las estimaciones negativas a cero y redondea las mitades hacia arriba mediante floor(max(raw, 0) + 0.5). Es una regla práctica de presentación, no un cambio del modelo evaluado. La predicción bruta se conserva aunque sea negativa o fraccionaria.
No se fabrican asistencias reales futuras ni MAE futuros. Un modelo puede congelarse antes de que llegue una instantánea posterior: en el plazo de siete días de cada evento de mayo se reutilizan el modelo existente y las características conocidas guardadas de ese evento. Las muestras sintéticas pequeñas, las instantáneas ausentes y los cambios de comportamiento limitan las conclusiones. El Challenge independiente cambia temporada y fechas manteniendo este flujo. Se aceptan implementaciones numéricas equivalentes, otros órdenes de salida y estilos de líneas/puntos con tolerancia numérica 1e-8 y relaciones correctas por ID.
Resumen
Entrenaste un Pipeline pequeño de imputación y regresión con talleres anteriores, comparaste sus errores reservados sin redondear con una referencia de mediana de entrenamiento y guardaste un gráfico asociado por ID. También exportaste estimaciones futuras manteniendo sus resultados desconocidos fuera de la evaluación. Un MAE reservado menor puede respaldar esta comparación limitada; un resultado peor es igual de válido si se calcula honestamente.