



Introducción
EARLY CRUMB necesita una lista que la persona que prepara las bolsas del sábado pueda usar de verdad. Un pedido pagado puede cancelarse y uno válido puede requerir varios artículos distintos. Tu trabajo es conservar los pedidos correctos y cada cantidad, y entregar etiquetas individuales.
Este laboratorio nuevo proporciona todos los registros originales y un archivo ordenado de IDs pagados. No necesita archivos de una VM anterior. Basta con un manejo básico de la terminal; la selección, ordenación y unión se explican cuando las utilizas. No escribes una aplicación ni un script de propósito general.
Utiliza Workstation para los archivos y Pickup Preview para leer registros, abrir la lista real, ver etiquetas y descargar la entrega. La vista solo lee tu archivo: no elimina cancelaciones ni repara cantidades.
Excluir los pedidos cancelados
En este paso crearás el conjunto de IDs pagados y no cancelados. Empieza en Pickup Preview.
Entender primero la decisión de preparación
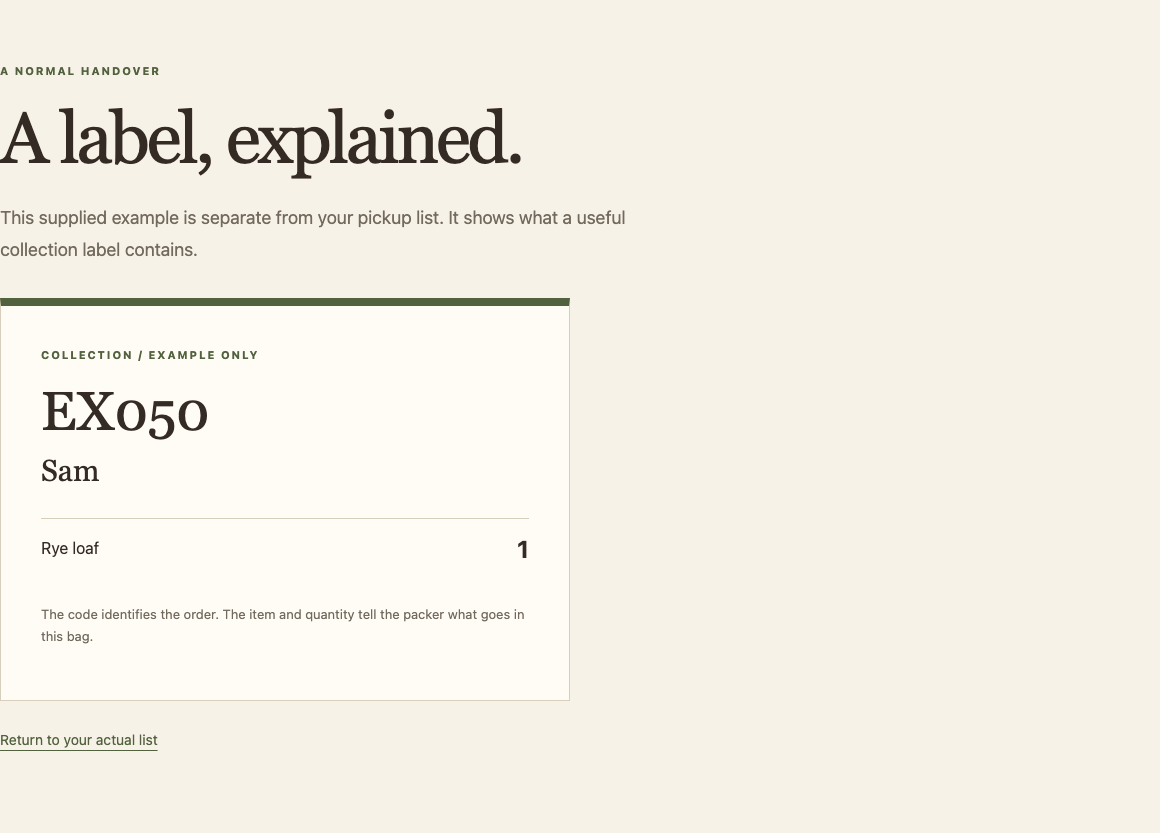
Abre Sample label para ver cómo un ID, un cliente y una cantidad forman una etiqueta útil. Después abre Records. P101 es de Alex y requiere dos panes de centeno y una galleta de avena. P102 también es de Alex, pero está sin pagar. P103 está pagado y aparece en cancellations.tsv: no debe recibir una bolsa.
Pagos y cancelaciones responden a preguntas distintas. En esta recogida, un pedido es elegible solo si su estado exacto es paid y su ID no figura en las cancelaciones.
Examinar el espacio independiente
Cambia a Workstation. pwd muestra el directorio actual y cat imprime un archivo:
pwd
/home/labex/project/pickup
cat paid-order-ids.txt
P101
P103
P104
P105
Este archivo ordenado se proporciona en el laboratorio. Contiene los IDs cuyo estado es exactamente paid, incluido P103. Lee la otra entrada de la decisión:
cat source/cancellations.tsv
order_id
P103
Mantén intacto source/. Puedes recrear los archivos bajo work/ y el resultado pickup-list.tsv. Si cambias de directorio, cd /home/labex/project/pickup te devuelve aquí.
Comparar dos conjuntos ordenados
Un conjunto es aquí una lista de IDs distintos. comm compara dos archivos ordenados. Su primera columna contiene IDs exclusivos de la primera entrada; la segunda, los exclusivos de la segunda; y la tercera, los comunes. -23 oculta las columnas 2 y 3 y deja los IDs de la primera entrada ausentes en la segunda. Eso equivale a IDs pagados menos IDs cancelados.
LC_ALL=C mantiene coherentes la ordenación y la comparación en esta terminal. tail -n +2 retira el encabezado; sort -u ordena y elimina líneas idénticas de IDs. Una tubería pasa la salida al siguiente comando. > guarda en otro archivo de trabajo y lo reemplaza al reintentar; nunca uses la ruta de entrada como destino.
export LC_ALL=C
sort -u paid-order-ids.txt > work/paid.sorted.txt
tail -n +2 source/cancellations.tsv | sort -u > work/cancelled-order-ids.txt
comm -23 work/paid.sorted.txt work/cancelled-order-ids.txt > work/eligible-order-ids.txt
cat work/eligible-order-ids.txt
P101
P104
P105
P103 desaparece y los demás pedidos pagados permanecen. Si aparece una advertencia de entrada sin ordenar, recrea ambos conjuntos con la configuración anterior. No borres pedidos de las fuentes ni interpretes un pago ausente como autorización para preparar.
Construir la lista de artículos y abrir etiquetas reales
En este paso conservarás cada producto y cantidad de los IDs elegibles y usarás la entrega real. Empieza en Workstation.
Relacionar los IDs con todas las líneas de artículos
Un ID puede aparecer en varias filas de orders.tsv. P101 necesita tanto rye como oat. Tres IDs elegibles no significan tres piezas de pan. Conserva cada fila original y su cantidad.
Lee la tabla:
cat source/orders.tsv
Los cuatro campos son order_id, customer, item, quantity, separados por tabulaciones. La primera línea es el encabezado. tail -n +2 elimina solo ese encabezado. TAB=$(printf '\t') guarda una tabulación en una variable del shell. -t "$TAB" indica a sort y join que la usen; las comillas dobles la mantienen como un solo argumento. sort -k1,1 -k3,3 ordena primero por ID y después por artículo, conservando los cuatro campos. No sustituyas la tabla de artículos por un sort -u aplicado únicamente al ID.
TAB=$(printf '\t')
tail -n +2 source/orders.tsv > work/orders.rows
sort -t "$TAB" -k1,1 -k3,3 work/orders.rows > work/orders.sorted.tsv
join relaciona los primeros campos de entradas ordenadas. La primera contiene IDs elegibles y la segunda todas las filas de artículos. Su comportamiento predeterminado, que conserva solo coincidencias, sirve aquí: mantiene pedidos elegibles y produce cada fila coincidente de artículos. El ID aparece una vez, seguido del cliente, artículo y cantidad.
join -t "$TAB" work/eligible-order-ids.txt work/orders.sorted.tsv > work/pickup.rows
cat work/pickup.rows
P101 Alex oat 1
P101 Alex rye 2
P104 Noor oat 2
P105 Jules oat 1
P105 Jules rye 1
Los huecos anteriores son tabulaciones. Hay cinco líneas de artículos para tres pedidos. Comprueba los dos productos de P101 y sus cantidades antes de publicar el archivo.
Dar un formato claro al receptor
El lector necesita el mismo encabezado de cuatro campos. printf interpreta \t como tabulación y \n como salto de línea. > inicia un destino nuevo; >> añade sin borrar el encabezado. Repetir ambos comandos reemplaza limpiamente la entrega anterior, en lugar de añadir filas duplicadas.
printf 'order_id\tcustomer\titem\tquantity\n' > pickup-list.tsv
cat work/pickup.rows >> pickup-list.tsv
cat pickup-list.tsv
Usar la entrega, no solo el total
Cambia a Pickup Preview y abre Pickup list. Recarga si ya estaba abierta. Debes ver 3 collection bags · 5 item lines · 7 pieces. Los totales ayudan a detectar errores, pero no prueban que cada persona tenga el contenido correcto.
Abre la etiqueta P101 de Alex. Debe mostrar Oat cookie 1 y Rye loaf 2. Sigue All collection bags, abre P104 y confirma Oat cookie 2 para Noor; P105 entrega Oat cookie 1 y Rye loaf 1 a Jules. P102, P103 y P106 no deben tener bolsa. El nombre del cliente por sí solo no demuestra estas relaciones.
Usa Print label para abrir el diálogo de impresión si el navegador lo permite y cancélalo después de ver la vista previa. No necesitas impresora física. Regresa a la lista y selecciona Download the actual list. Descarga el TSV que creaste, no una referencia calculada de antemano.
Si la vista explica un error de formato, revisa encabezado y tabulaciones en Workstation, regenera y recarga. Si hay cantidades incorrectas, compara work/pickup.rows con la fuente de pedidos. El lector no arregla tu trabajo silenciosamente.
Incluir un pedido tardío sin duplicar las bolsas anteriores
En este paso reconstruirás la entrega desde una instantánea revisada completa. Empieza en Workstation con los mismos ajustes del shell.
Entender la nueva entrada
Los archivos originales bajo source/ siguen intactos. source/late/ contiene una instantánea posterior completa de las tres tablas, no unas pocas líneas para añadir al resultado. El nuevo pedido pagado P107 pertenece a Aya y necesita dos galletas de avena. La cancelación anterior sigue vigente.
cat source/late/orders.tsv
cat source/late/payments.tsv
El paid-order-ids.txt proporcionado describe la instantánea original. Para incluir el nuevo pedido, calcula otro conjunto pagado desde la tabla posterior. grep $'\tpaid$' selecciona una tabulación y el estado completo al final de la línea, sin incluir unpaid; cut -f1 conserva el ID. sort -u prepara el conjunto para compararlo. Mantén LC_ALL=C y TAB de los pasos anteriores; restáuralos aquí si reconectaste la terminal.
export LC_ALL=C
TAB=$(printf '\t')
tail -n +2 source/late/payments.tsv | grep $'\tpaid$' | cut -f1 | sort -u > work/paid.sorted.txt
tail -n +2 source/late/cancellations.tsv | sort -u > work/cancelled-order-ids.txt
comm -23 work/paid.sorted.txt work/cancelled-order-ids.txt > work/eligible-order-ids.txt
Aplicaste la misma regla a otra instantánea completa. Reconstruye ahora la entrada de artículos y el destino:
tail -n +2 source/late/orders.tsv > work/orders.rows
sort -t "$TAB" -k1,1 -k3,3 work/orders.rows > work/orders.sorted.tsv
join -t "$TAB" work/eligible-order-ids.txt work/orders.sorted.tsv > work/pickup.rows
printf 'order_id\tcustomer\titem\tquantity\n' > pickup-list.tsv
cat work/pickup.rows >> pickup-list.tsv
cat pickup-list.tsv
Ahora debe haber seis filas de artículos: las cinco anteriores más P107/Aya/oat/2. El encabezado aparece una sola vez. Reconstruir desde la instantánea completa significa no añadir de nuevo todas las filas antiguas.
Comprobar la entrega nueva real
Cambia a Pickup Preview, abre Pickup list y recarga. Espera 4 collection bags · 6 item lines · 9 pieces. Abre P107 y confirma las dos Oat cookie de Aya. Vuelve a abrir P101 y comprueba que sus dos filas siguen siendo correctas. P103 cancelado y P102 sin pagar continúan sin etiqueta.
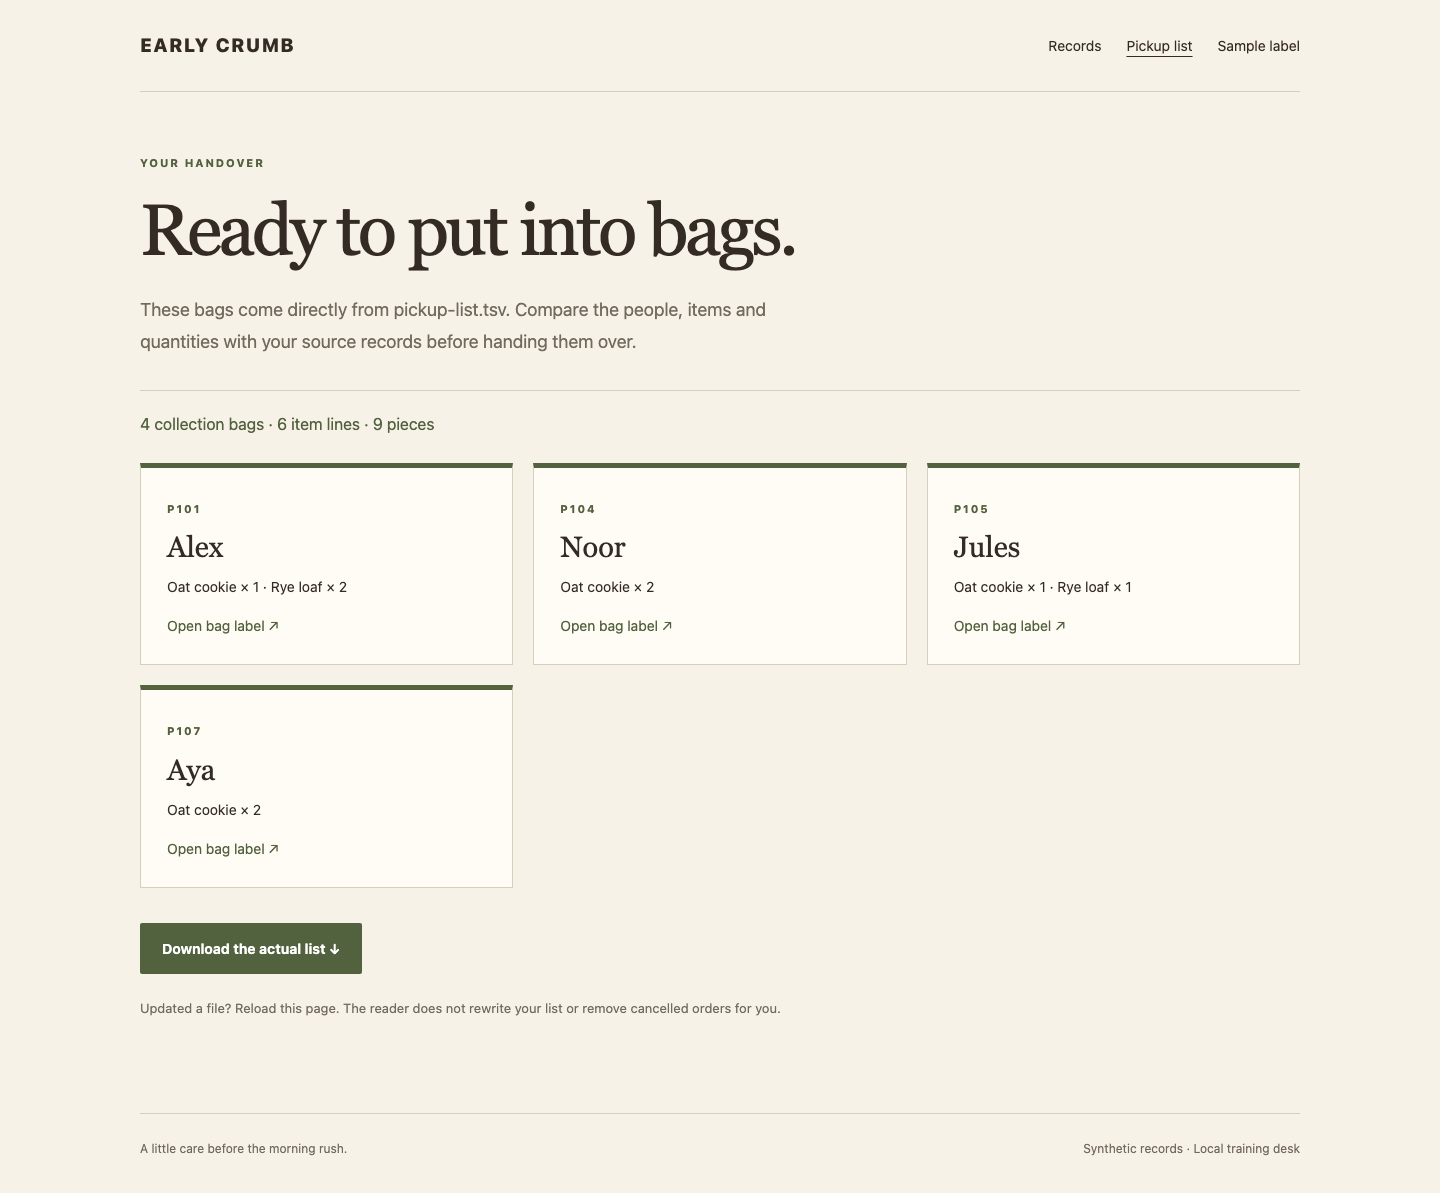
Descarga otra vez la lista real y compara el contenido con la entrega revisada. Records conserva deliberadamente la instantánea original como contexto; las entradas posteriores son los archivos leídos en source/late/. Una página antigua no demuestra que los comandos hayan fallado: recarga antes de comparar.
Si los totales se duplicaron, vuelve a los dos comandos de escritura: > debe crear un encabezado nuevo antes de que >> añada las filas actuales. Si falta P107, comprueba que pagos y artículos proceden de source/late/. Corrige los archivos de trabajo y regenera; no escribas el total esperado como sustituto de las filas reales.
Resumen
Comparaste conjuntos ordenados de IDs, relacionaste los pedidos elegibles con todas sus filas de artículos y creaste una lista de recogida y etiquetas reales. Reconstruiste el mismo proceso con una instantánea posterior completa sin duplicar las bolsas anteriores. El desafío independiente de talleres usa los mismos métodos con otras relaciones de elegibilidad y materiales.


