



Introducción
EARLY CRUMB prepara la recogida de pan del sábado. Los pedidos, pagos y cancelaciones se registran por separado. Dos clientes tienen el mismo nombre y un pedido puede incluir varios productos. Una entrega útil empieza por conectar los registros correctos, sin adivinar por los nombres.
En este laboratorio prepararás las tablas de pedidos y pagos, relacionarás cada ID con su estado de pago y crearás la lista de IDs pagados. Las cancelaciones se tratarán en el siguiente laboratorio independiente. Basta con conocer el uso básico de la terminal; las tabulaciones, campos, ordenación y comandos se explican antes de usarlos. Todas las personas y registros son ficticios.
Utiliza Workstation para los comandos y Pickup Preview para el mostrador preparado. La vista muestra los registros originales y una etiqueta de ejemplo. No calcula tus respuestas ni crea tus archivos.
Preparar las tablas para relacionarlas
En este paso prepararás registros sin encabezado y una lista ordenada de IDs sin perder líneas de artículos. Empieza en Pickup Preview.
Entender la entrega
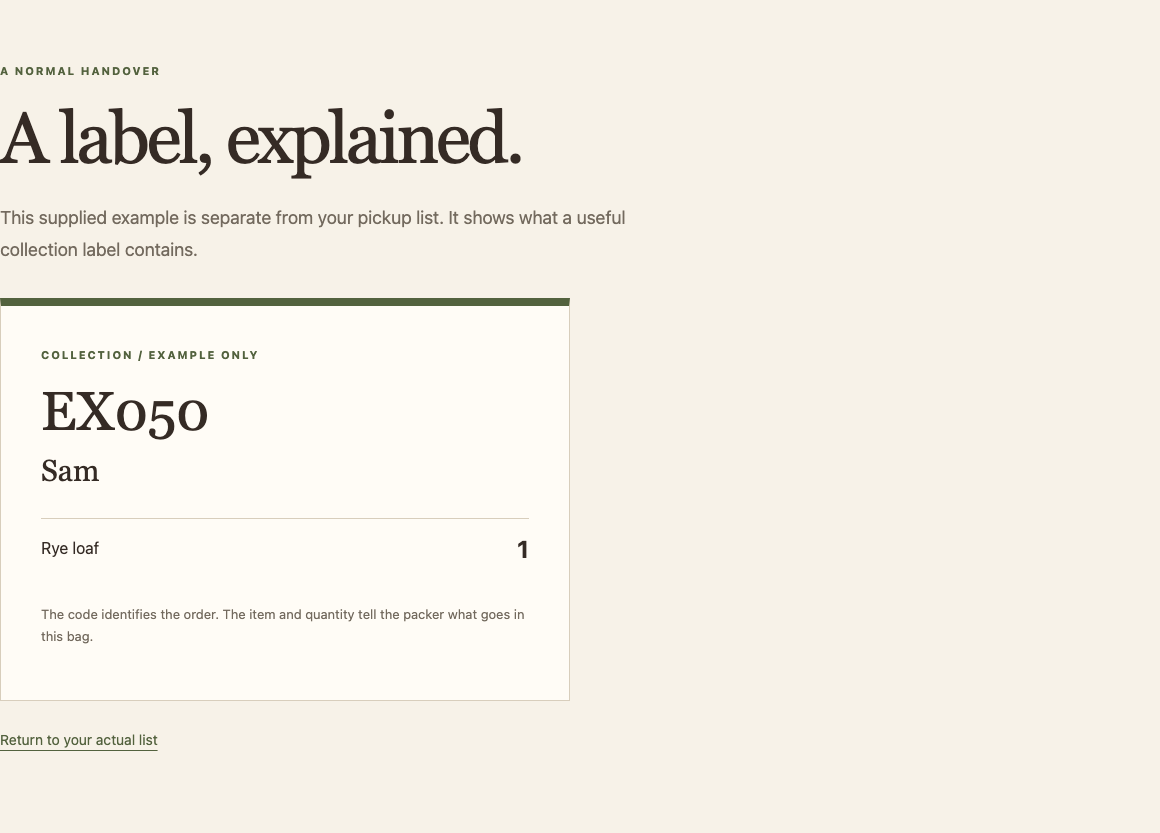
Abre Sample label. EX050 pertenece a Sam y contiene un pan de centeno. Es un ejemplo separado, no tu lista terminada. El código identifica una bolsa; el nombre ayuda al cliente a reconocerla; cada artículo y cantidad indica al preparador qué debe incluir.
Abre Records. La clave de artículos relaciona rye con Rye loaf y oat con Oat cookie. Busca P101 en orders.tsv: Alex pidió dos panes de centeno y una galleta de avena. P102 también corresponde a Alex, pero es otro pedido con estado unpaid. Relacionarlos por nombre asignaría la bolsa equivocada al pedido equivocado. Usa order_id.
Leer los archivos preparados
Cambia a Workstation, que empieza en /home/labex/project/pickup. pwd muestra el directorio actual; ls enumera sus entradas:
pwd
/home/labex/project/pickup
ls
Deberías ver source y work. Los registros originales se mantienen intactos; work/ contiene archivos intermedios que puedes recrear. Una ruta como source/orders.tsv es relativa a este directorio. Si sales de él, vuelve con:
cd /home/labex/project/pickup
cat muestra un archivo. Lee ambas tablas:
cat source/orders.tsv
cat source/payments.tsv
TSV significa valores separados por tabulaciones. Cada línea es un registro; una tabulación separa los campos. La primera línea es el encabezado. Los cuatro campos de pedidos son ID, cliente, artículo y cantidad. Un pedido puede tener varias líneas de artículos. Pagos tiene dos campos: ID y estado exacto paid o unpaid. Existe como máximo un pago por pedido. El formato proporcionado no permite tabulaciones ni saltos de línea dentro de un valor.
P106 aparece en pedidos pero no tiene fila de pago. Que falte información no significa que esté pagado. Mantendrás esa ausencia visible al relacionar.
Separar encabezados y registros
tail -n +2 muestra desde la línea 2. > guarda la salida en un archivo y reemplaza el destino si ya existe, sin modificar la fuente. Nunca uses la misma ruta como entrada y destino con >: el shell vaciaría el archivo antes de que el programa lo lea.
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
Examina las líneas de artículos:
cat work/orders.rows
P101 y P105 aparecen dos veces cada uno porque incluyen dos productos. Conserva esas filas. Un ID repetido no implica automáticamente datos duplicados.
Preparar las claves de relación
Una clave es el campo que conecta registros. cut -f1 selecciona el primer campo separado por tabulaciones. Una tubería | pasa la salida al comando siguiente. sort -u ordena líneas y conserva una sola copia de cada línea idéntica. Aquí se aplica solo a la lista de IDs, no a la tabla de artículos.
La ordenación y la relación deben usar el mismo orden. LC_ALL=C selecciona un orden de bytes predecible y export permite que los siguientes comandos lo utilicen. Esta configuración pertenece a la terminal actual; vuelve a establecerla si abres otra.
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
Para la tabla de pagos de dos campos, ordena por el primero sin perder el estado. TAB es una variable del shell con una tabulación: printf '\t' la imprime y $(...) captura la salida. Las comillas de "$TAB" la pasan como un único argumento separador. -t define el separador; -k1,1 selecciona solo el primer campo como clave.
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
Espera P101 a P105 en orden, cada uno con su estado original. P106 no ha adquirido una fila de pago. Ya tienes seis IDs distintos y los cinco pagos preparados. Si hay un encabezado o estado incorrecto, recrea solo el intermedio afectado desde su fuente; no cambies la fuente para ajustarla.
Relacionar cada pedido con su estado de pago
En este paso unirás las dos entradas preparadas manteniendo visibles los pedidos sin pago. Empieza en Workstation, con la misma terminal del paso 1.
Saber qué debe significar la relación
P101 debe corresponder a paid, P102 a unpaid y P106 al valor explícito missing. Los nombres no intervienen. En este punto, un pedido pagado aún puede estar cancelado: relacionar pagos no decide por sí solo la lista final.
join conecta por defecto los primeros campos de entradas ordenadas. Una unión interna normal omite IDs sin coincidencia. Aquí también necesitamos ver esos registros:
-t "$TAB"usa el separador de tabulación creado en el paso 1.-a 1conserva además registros sin correspondencia de la primera entrada, la lista completa de IDs.-e missingpone la palabramissingdonde falta un campo de salida.-o 1.1,2.2produce el campo 1 de la entrada 1, el ID, y después el campo 2 de la entrada 2, el estado.1y2designan archivos de entrada, no números de fila.
Ejecuta el comando completo en una sola línea. Escribe un resultado con dos campos:
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
Los espacios visibles representan tabulaciones, no los caracteres literales barra invertida y t. Debes ver seis filas. P106 permanece porque la entrada izquierda contiene todos los IDs y -a 1 conserva los que no coinciden.
Leer el resultado antes de filtrarlo
P101 y P102 corresponden a Alex en la fuente, pero sus estados son diferentes. P103 también está pagado; una cancelación puede excluirlo después. P106 no tiene pago, por lo que missing impide que desaparezca silenciosamente de la comparación.
Si join indica una entrada sin ordenar, vuelve al paso 1 y recrea ambas entradas ordenadas con el mismo LC_ALL=C. No ocultes el aviso ni elimines un pedido incómodo. Si reconectaste la terminal, restaura el directorio y los dos ajustes del shell del paso 1 antes de reintentar.
Que el comando termine correctamente no basta: compara estas tres filas importantes con sus fuentes. Ahora tienes una relación de pagos completa para tomar la siguiente decisión.
Seleccionar pedidos pagados sin perder su identidad
En este paso crearás el archivo de IDs pagados y verás exactamente lo guardado. Empieza en Workstation.
Reconocer el estado completo
Tanto paid como unpaid contienen las letras paid. Una búsqueda imprecisa incluiría P102 por error. Necesitamos una tabulación seguida del estado completo al final de la línea.
grep selecciona líneas coincidentes. En $'\tpaid$', la notación exterior $'...' convierte \t en una tabulación; el último $ dentro de la expresión significa final de línea. Por tanto, el campo debe ser exactamente paid, no simplemente el final de unpaid. cut -f1 conserva después los IDs. La salida ya está ordenada porque la tabla relacionada está ordenada.
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 está sin pagar y P106 carece de registro, así que ninguno pertenece aquí. Conserva P103 en esta fase: el archivo representa pedidos pagados, no el conjunto final que se preparará. Quitar P103 antes de considerar cancelaciones mezclaría dos decisiones y daría un significado engañoso al intermedio.
Leer la selección guardada
Cambia a Pickup Preview. Selecciona Payment IDs en la navegación. Esta página muestra paid-order-ids.txt; no calcula la respuesta de pagos. Debes ver los cuatro IDs guardados. Sigue Compare with source records y contrasta los pagos correspondientes.
Pickup list puede seguir diciendo que no hay lista para preparar. Es normal: has creado una selección de pagos, no la lista final de artículos. El siguiente laboratorio independiente la usa para excluir cancelaciones y conservar cada cantidad elegible.
Si el archivo está vacío o incluye P102, examina work/payment-match.tsv y el patrón de estado exacto, y repite el filtro. Puedes corregir y regenerar el resultado sin cambiar ninguna fuente.
Resumen
Preparaste registros tabulados, los ordenaste por una clave común, relacionaste pagos conservando los registros ausentes y seleccionaste estados pagados exactos. Diferenciaste la identidad del pedido de los nombres de clientes y las líneas de artículos. El siguiente laboratorio independiente convierte esta selección en una entrega útil para la recogida.


