Introducción
Meridian Museum ayuda a encontrar objetos por su material y su historia. Su página principal puede responder antes de que la búsqueda esté disponible. Cada contenedor de búsqueda nuevo importa los doce registros proporcionados en un índice de palabras en memoria. La fuente entrega los registros a un ritmo deliberado para que puedas observar la carga; un contenedor de reemplazo construye su propio índice desde el principio.
Impedirás que los Pods que siguen cargando reciban tráfico del Service de visitantes, concederás tiempo suficiente al arranque y actualizarás el importador mientras las réplicas existentes siguen ofreciendo resultados correctos. Necesitas manejo básico del terminal y conocer las imágenes y los contenedores en ejecución. Aquí se introducen los objetos de Kubernetes, los parches YAML y las sondas. El clúster, la imagen del museo en caché y el sitio completo están preparados; no necesitas instalar programas, crear cuentas externas ni programar la aplicación.
Usa Museum para el recorrido del visitante y Workstation para los comandos. Trabaja solo en el espacio de nombres meridian y en el directorio proporcionado. Es un clúster didáctico de un solo nodo; no ofrece alta disponibilidad ni garantiza que ninguna petición falle. Cada laboratorio comienza de forma independiente.
Admitir visitantes solo en Pods que pueden buscar
En este paso distinguirás un proceso en ejecución de un índice utilizable y añadirás disponibilidad para la tarea real del visitante. Empieza en Museum.
Probar el recorrido normal del visitante
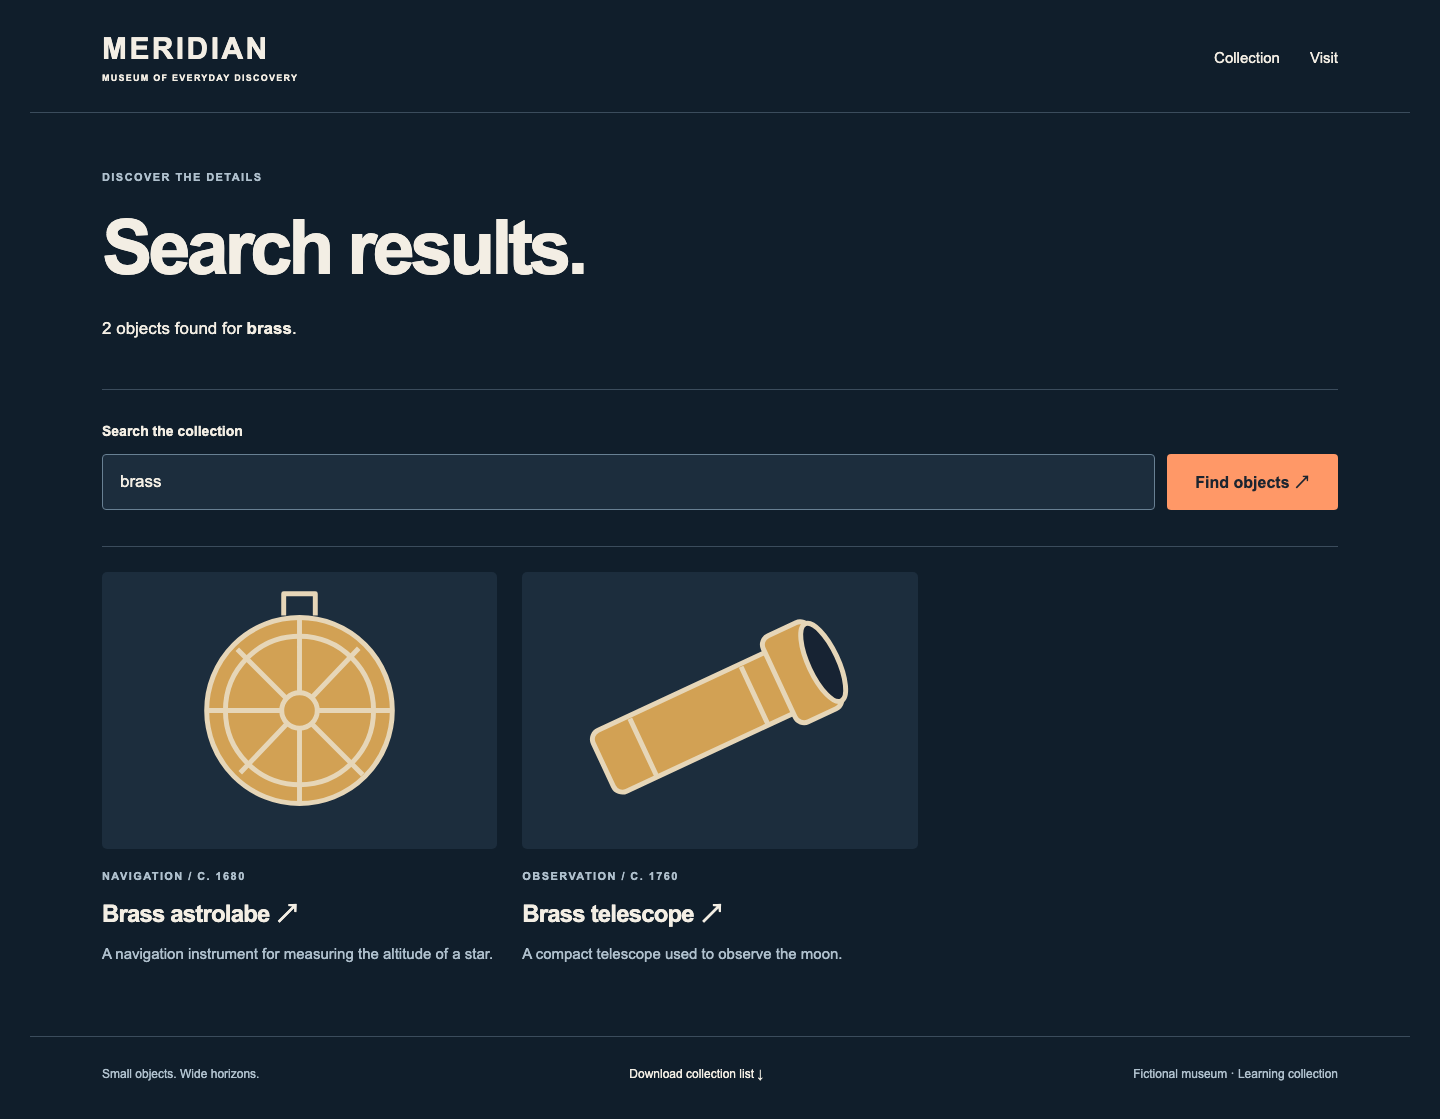
Escribe brass en Search the collection y selecciona Find objects ↗. Los resultados deben incluir Brass astrolabe y Brass telescope, con 2 objects found. Abre Brass astrolabe: aparecen su historia, ilustración y ubicación Gallery 1. Selecciona See it at the museum ↗, lee los horarios y la entrada sin desnivel, y elige Download collection list ↓. Abre el CSV descargado: contiene doce objetos, incluidos ambos instrumentos de latón. Vuelve al inicio con MERIDIAN. Tus cambios deben conservar estas funciones.
Conocer los tres objetos de Kubernetes
Cambia a Workstation. pwd muestra el directorio actual y ls enumera sus archivos:
pwd
ls
El directorio es /home/labex/project/museum. Un Pod ejecuta el contenedor del museo. Un Deployment mantiene dos réplicas de Pod y las sustituye cuando cambia su plantilla de contenedor. Un Service proporciona una dirección estable y dirige las peticiones a los Pods seleccionados que están listos. Las etiquetas conectan los objetos: el Service selecciona Pods con la etiqueta app: search. Un espacio de nombres agrupa los objetos del curso; todos los comandos siguientes indican meridian explícitamente.
kubectl solicita al clúster leer o modificar objetos. get los enumera y -n elige el espacio de nombres. cat muestra un archivo de texto para leer el candidato preparado:
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML usa key: value, espacios para la sangría y - para los elementos de una lista. Bajo spec.template, el contenedor utiliza la imagen en caché meridian-museum:1. imagePullPolicy: Never exige usarla sin descargarla de un registro. IMPORT_INTERVAL: "2" separa las importaciones de registros dos segundos: doce registros requieren unos 24 segundos. Las réplicas iniciales usaban un intervalo corto para que primero pudieras probar una búsqueda normal.
La actualización gradual preparada conserva replicas: 2, permite un candidato adicional (maxSurge: 1) y no admite réplicas existentes indisponibles (maxUnavailable: 0). Esto depende de una evaluación honesta de disponibilidad: sin una sonda, un proceso puede considerarse apto antes de que funcione la búsqueda. Conserva estos ajustes, las imágenes, etiquetas y el Service.
Observar tráfico prematuro en el servicio de práctica
El navegador usa HTTP, un protocolo de petición y respuesta. El estado 200 indica una respuesta correcta; 503 significa que el servidor no puede atender temporalmente esa petición. Una página principal funcional no demuestra que una petición diferente, como la búsqueda, vaya a funcionar.
Este museo no tiene clientes reales. Demostrarás intencionadamente la actualización insegura antes de mejorarla. cp copia el candidato al archivo editable search.yaml. apply -f envía el YAML de ese archivo; el cambio de plantilla inicia una actualización. python3 ejecuta el observador de solo lectura; --seconds 30 toma muestras del Service real durante 30 segundos y comprueba que la búsqueda devuelve ambos objetos de latón. Ejecuta juntos la actualización y el observador:
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
Espera algunas líneas HTTP=503 correct_search=false mientras los contenedores nuevos sin protección cargan. La cantidad varía. El inicio sigue funcionando; la respuesta 503 de búsqueda explica que se está preparando la colección. Es una respuesta real de un Pod que carga, no una animación programada de éxito o fallo.
rollout status espera la actualización de este Deployment; --timeout limita esa espera:
kubectl rollout status deployment/search -n meridian --timeout=90s
Puede informar de éxito aunque ninguna sonda readiness protegiera el período de carga anterior. Espera resultados normales para brass antes de continuar. Si aparece un error de conexión en lugar de un estado HTTP, lee la tabla de Pods y reintenta; un servidor ausente es distinto de uno que devuelve 503.
Añadir una comprobación de disponibilidad del negocio
Una sonda readiness decide si este Pod debe recibir tráfico del Service. El fallo retira su elegibilidad, pero no reinicia el contenedor. En esta imagen, /health/process siempre informa del proceso HTTP; /ready/search solo devuelve 200 cuando los doce registros están indexados y la búsqueda conocida de brass funciona. El inicio también devuelve 200 durante la importación, así que ni ese inicio ni el endpoint del proceso son adecuados aquí.
patch modifica campos concretos. --patch-file lee tu archivo; --type=strategic fusiona el contenedor llamado search conservando los demás ajustes. La sonda envía HTTP al puerto de este Pod llamado http, comprueba cada dos segundos y lo marca como no listo tras un fallo. Escribe el pequeño parche. cat > readiness.yaml reemplaza el archivo. <<'YAML' abre un here-document literal: pega todo el bloque, incluido el cierre YAML solo en su línea. Conserva los espacios:
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
Las búsquedas correctas deben seguir pasando por las réplicas existentes mientras la nueva importa.
Un EndpointSlice registra las direcciones reales de los Pods y su disponibilidad para el Service. -l filtra por su etiqueta service-name; -o jsonpath selecciona solo las direcciones y los campos ready de la respuesta estructurada. La expresión proporcionada recorre los registros de endpoints e imprime esos campos; solo lee el estado. Inspecciona los Pods y las direcciones del Service:
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
Durante la importación puedes ver un Pod nuevo 0/1 Running y una dirección con ready=false. Los endpoints existentes listos continúan sirviendo búsquedas. Cuando acaba la carga, el candidato queda listo y continúa la sustitución. Si no ves ese estado breve, los siguientes pasos ofrecen una ventana más larga.
Termina con exactamente dos Pods 1/1 Running. Un Pod antiguo puede seguir brevemente en Terminating después del éxito del rollout; espera y repite get pods hasta que desaparezca. En Museum, repite la búsqueda de brass y el detalle del astrolabio. Si hay un error YAML, corrige el parche y aplícalo otra vez. Si escribiste mal la ruta, sustituye únicamente esa ruta en el mismo parche y reaplícalo. No borres otros espacios de nombres ni acortes la importación para ocultar errores.
Dar al importador suficiente tiempo de arranque
En este paso distinguirás la espera de disponibilidad de un fallo de arranque y calcularás el presupuesto a partir de la importación real. Empieza en Workstation.
Una sonda startup limita el tiempo de inicialización de un contenedor nuevo. Mientras no tenga éxito, Kubernetes pospone las comprobaciones readiness. Si los fallos de arranque alcanzan el umbral, kubelet reinicia el contenedor. Esta sonda es opcional; un presupuesto insuficiente puede impedir que una aplicación funcional llegue a estar lista. No sustituye readiness después de un arranque correcto.
Observar un presupuesto insuficiente
startup-short.yaml es un ejemplo didáctico proporcionado. Un fallo de startup solicita un reinicio, pero la terminación puede retrasar el aumento visible del contador. La siguiente espera del cliente dura 60 segundos para observar esa diferencia. Lee el ejemplo antes de aplicarlo:
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
Se espera que el comando rollout falle con error: timed out waiting for the condition. Su estado de salida real es distinto de cero. Continúa en este terminal interactivo. El ejemplo comprueba cada dos segundos y admite solo dos fallos: una ventana aproximada de cuatro segundos, insuficiente para una importación de 24 segundos.
Lee la evidencia real. logs muestra la salida de la aplicación; --prefix identifica cada Pod y --tail=4 limita cada registro a sus últimas cuatro líneas. Un selector solicita todos los Pods de búsqueda. get events lee observaciones del clúster; --field-selector reason=Unhealthy las limita a comprobaciones de salud fallidas:
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
El Pod nuevo sigue sin estar listo y su RESTARTS debe aumentar. Puede mostrar CrashLoopBackOff, que significa que Kubernetes está retrasando otro intento. Si la tabla aún muestra cero aunque haya fallos de startup, espera y repite get pods antes de cambiar el presupuesto: es una observación puntual y terminar lleva tiempo. Cada reinicio descarta el índice en memoria del contenedor; su sustituto importa de nuevo los registros.
Una línea tardía index_complete de un contenedor cuya comprobación de arranque ya falló no cancela el reinicio pendiente ni lo convierte en backend listo del Service. Lee juntos el contador y los eventos de fallo de startup. Los Pods anteriores permanecen 1/1 y siguen sirviendo sus índices completos.
Cambia a Museum y busca brass. Las réplicas existentes listas siguen devolviendo resultados correctos a través del Service. La actualización detenida no se ha revertido automáticamente: el Deployment sigue solicitando el candidato defectuoso. Conservar el servicio anterior no significa haber completado la actualización.
Calcular y aplicar un presupuesto útil
Cambia a Workstation. Doce registros a dos segundos requieren aproximadamente 24 segundos. Usa aquí 60 segundos: también cubren la próxima importación de 36 segundos y un margen didáctico de doce segundos. periodSeconds × failureThreshold es una aproximación de planificación, no una garantía de plazo; influyen la planificación, los tiempos de espera de las sondas y la carga real. En producción, mide el arranque y elige un margen deliberado.
Usa el mismo método de archivo de parche. Conserva la ruta real del negocio y el puerto con nombre:
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
Esto crea Pods de reemplazo con los ajustes corregidos. Cada uno debe acabar de cargar sin reiniciarse; la tabla final debe contener dos Pods 1/1 Running con RESTARTS 0. Espera a que desaparezcan los antiguos que terminan y repite la tabla si hace falta. Readiness sigue controlando el tráfico después de que startup tenga éxito.
Si la actualización continúa detenida, consulta los mismos registros y eventos, compara la ruta y el presupuesto del archivo, corrige y vuelve a aplicar. Borrar Pods no corrige la plantilla del Deployment: se recrearían con los mismos ajustes incorrectos. Distingue el presupuesto de sonda de 60 segundos de --timeout=120s, que solo limita la espera del cliente por el rollout.
Mantener la búsqueda disponible durante una actualización más lenta
En este paso aplicarás una importación más lenta y evaluarás la actualización con respuestas del Service y endpoints listos. Empieza en Workstation.
kubectl set env modifica una variable de entorno del contenedor en la plantilla del Deployment. Inicia Pods de reemplazo; no cambia el entorno de contenedores que ya se ejecutan. Configura tres segundos entre registros. Los doce requieren ahora aproximadamente 36 segundos, dentro del presupuesto de arranque de 60 segundos:
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
El Pod nuevo debería estar 0/1 Running durante la importación. Las direcciones existentes listas siguen devolviendo resultados correctos para brass. El observador usa el mismo Service NodePort al que accede Museum; nunca selecciona un Pod bueno concreto. En la ejecución observada, las peticiones protegidas siguieron siendo correctas. Una muestra finita no garantiza cero fallos en todas las condiciones reales de red, aplicación o clúster.
Espera a que termine toda la actualización e inspecciona el estado final:
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
Cuando desaparezca cualquier Pod antiguo Terminating, deben quedar exactamente dos Pods actuales listos, sin reinicios, y sus dos direcciones deben mostrar ready=true. Conservar una réplica anterior sana durante la importación es útil, pero el rollout final debe converger realmente a la nueva revisión.
Comprobar todo el servicio del visitante
Cambia a Museum. Vuelve al inicio con MERIDIAN y busca brass otra vez. Deben aparecer ambos instrumentos; abre el telescopio y sigue su enlace de visita. Busca volcano: la página debe indicar que no se encontraron objetos, en lugar de fallar. Abre Collection, visita un objeto que no sea de latón y descarga la lista desde Visit. Confirma los doce objetos y que se conservan ilustraciones y navegación.
Cambia a Workstation. curl solicita una URL; -sS oculta el progreso pero muestra errores de conexión. 127.0.0.1 es esta instancia de práctica y el puerto 30081 pertenece al Service real del museo. Las comillas mantienen la URL de consulta como un único argumento del shell:
curl -sS 'http://127.0.0.1:30081/search?q=brass'
Lee ambos títulos correctos en el HTML, no solo un estado HTTP satisfactorio. Si una comprobación se ejecuta mientras aún terminan Pods antiguos, espera y reintenta; no retires sondas ni reduzcas el tiempo de importación. Conserva el clúster, la imagen suministrada, el Service y los doce registros originales. El resultado combina disponibilidad real del negocio, tiempo suficiente de arranque y una actualización completa que preserva el museo.
Resumen
Conectaste readiness con un índice real, observaste cómo una sonda startup con tiempo insuficiente fallaba y reiniciaba el candidato, y calculaste un margen útil. Actualizaste el importador con intervalos controlados mientras las réplicas listas servían búsquedas; después comprobaste los Pods actuales, los endpoints del Service y el recorrido completo. Un proceso en ejecución, un backend listo y una actualización terminada son hechos distintos; esta práctica de un nodo no demuestra alta disponibilidad en producción ni cero fallos.